Kỹ thuật tiền xử lý dữ liệu thị giác máy tính đã gán nhãn#
Tiền xử lý dữ liệu biến đổi hình ảnh thô đã gán nhãn thành đầu vào sạch và nhất quán mà một model thị giác máy tính cần để huấn luyện tốt. Với Ultralytics YOLO26, các thao tác pixel cốt lõi — chuyển đổi RGB, scale về [0, 1] và thay đổi kích thước — chạy tự động trong pipeline huấn luyện, nên phần việc còn lại là phân chia dataset đúng cách, cân bằng các lớp và lựa chọn phương pháp tăng cường dữ liệu. Hướng dẫn này trình bày các kỹ thuật thiết yếu: thay đổi kích thước, chuẩn hóa, phân chia dataset, tăng cường dữ liệu và phân tích dữ liệu khám phá (EDA).
Xem: Cách sử dụng tiền xử lý và tăng cường dữ liệu để cải thiện độ chính xác của model trong các tình huống thực tế 🚀
Bước này được thực hiện sau khi bạn đã xác định mục tiêu dự án và thu thập, gán nhãn dữ liệu, đồng thời nằm ở giai đoạn đầu của quy trình dự án thị giác máy tính.
Vì sao tiền xử lý lại quan trọng#
Tiền xử lý đưa dữ liệu về định dạng giúp giảm tải tính toán và cải thiện hiệu suất model. Quá trình này giải quyết ba vấn đề phổ biến trong dữ liệu thô:
- Nhiễu: Các biến thiên không liên quan hoặc ngẫu nhiên trong dữ liệu.
- Không nhất quán: Sự khác biệt về kích thước, định dạng và chất lượng ảnh.
- Mất cân bằng: Phân phối lớp hoặc danh mục không đồng đều trong dataset.
Các kỹ thuật tiền xử lý#
Các kỹ thuật chính gồm resize, chuẩn hóa, chia dataset và tăng cường dữ liệu. Với YOLO26, hai kỹ thuật đầu tiên được thực hiện tự động, còn việc chia dataset và augmentation là những bước mà lựa chọn của bạn có ảnh hưởng lớn nhất.
Resize ảnh#
Nhiều model yêu cầu kích thước đầu vào nhất quán, vì vậy resize giúp đồng nhất kích thước ảnh và giảm độ phức tạp tính toán. Hai phương pháp nội suy phổ biến là:
- Nội suy song tuyến tính: Làm mượt giá trị pixel bằng cách tính trung bình có trọng số của bốn pixel gần nhất.
- Láng giềng gần nhất: Sao chép giá trị của pixel gần nhất mà không tính trung bình — nhanh hơn nhưng tạo ra ảnh có các khối rõ hơn.
Các thư viện như OpenCV và PIL (Pillow) cung cấp các hàm này, nhưng với YOLO26, bạn thường không cần resize thủ công. Tham số imgsz sẽ xử lý việc này. Trong quy trình sử dụng kích thước cố định dạng vuông, validation và inference đưa ảnh về dạng letterbox để phù hợp với đầu vào imgsz × imgsz, chẳng hạn như 640 × 640, giữ nguyên tỷ lệ khung hình và thêm padding màu xám (giá trị 114). Ảnh lớn hơn được thu nhỏ cho vừa, trong khi ảnh nhỏ hơn không được phóng to khi tắt scale-up. Trong quy trình huấn luyện mặc định, thay vào đó mosaic=1.0 ghép bốn ảnh lên một canvas lớn hơn rồi crop về imgsz; khi close_mosaic tắt mosaic ở các epoch cuối, ảnh được đưa về dạng letterbox rồi vẫn được biến đổi ngẫu nhiên thay vì giữ nguyên hoàn toàn. Batch hình chữ nhật (rect=True) và multi_scale sử dụng hình dạng đầu vào khác.
Chuẩn hóa giá trị pixel#
Chuẩn hóa đưa giá trị pixel về một phạm vi tiêu chuẩn, giúp model hội tụ nhanh hơn trong quá trình huấn luyện. Hai kỹ thuật phổ biến là:
- Min-Max Scaling: Đưa giá trị pixel về phạm vi từ 0 đến 1.
- Chuẩn hóa Z-Score: Scale giá trị pixel dựa trên giá trị trung bình và độ lệch chuẩn.
YOLO26 tự động xử lý chuẩn hóa như một phần của pipeline tiền xử lý: chuyển ảnh sang RGB và scale giá trị pixel về phạm vi [0, 1] bằng cách chia cho 255 (min-max scaling). Theo mặc định, YOLO không áp dụng chuẩn hóa trung bình/độ lệch chuẩn kiểu ImageNet (z-score), vì vậy không cần bước chuẩn hóa thủ công.
Chia dataset#
Chia dữ liệu thành các tập huấn luyện, validation và test cho phép bạn đánh giá model trên dữ liệu chưa từng thấy và đo lường khả năng khái quát hóa. Một cách chia phổ biến là 70% cho huấn luyện, 20% cho validation và 10% cho test. Các công cụ như scikit-learn hoặc TensorFlow giúp thực hiện việc này dễ dàng.
Hãy lưu ý những điểm sau khi chia dữ liệu:
- Duy trì phân phối lớp: Đảm bảo mỗi lớp được đại diện theo tỷ lệ tương ứng trong các tập huấn luyện, validation và test.
- Cân bằng lớp: Với dataset mất cân bằng, hãy cân nhắc tăng mẫu cho lớp thiểu số hoặc giảm mẫu cho lớp đa số — chỉ thực hiện trong tập huấn luyện.
Chia dataset trước khi áp dụng bất kỳ augmentation hay bước tiền xử lý nào khác, và chỉ áp dụng các phép biến đổi đó cho tập huấn luyện. Tăng cường dữ liệu trước khi chia khiến thông tin từ ảnh validation hoặc test ảnh hưởng đến quá trình huấn luyện, tạo ra điểm số cao gây hiểu lầm nhưng giảm mạnh trên dữ liệu thực tế.
Tăng cường dataset#
Tăng cường dữ liệu giúp tăng kích thước dataset một cách nhân tạo bằng cách tạo các phiên bản đã biến đổi từ ảnh hiện có. Phương pháp này giúp giảm overfit và cải thiện khả năng khái quát hóa, với một số lợi ích:
- Model mạnh mẽ hơn: Các biến thể về ánh sáng, hướng và tỷ lệ giúp model chống chịu tốt hơn trước những biến dạng trong thực tế.
- Tiết kiệm chi phí: Mở rộng tập huấn luyện mà không cần thu thập và gán nhãn dữ liệu mới.
- Tận dụng dữ liệu tốt hơn: Mỗi ảnh được gán nhãn tạo ra nhiều biến thể huấn luyện.
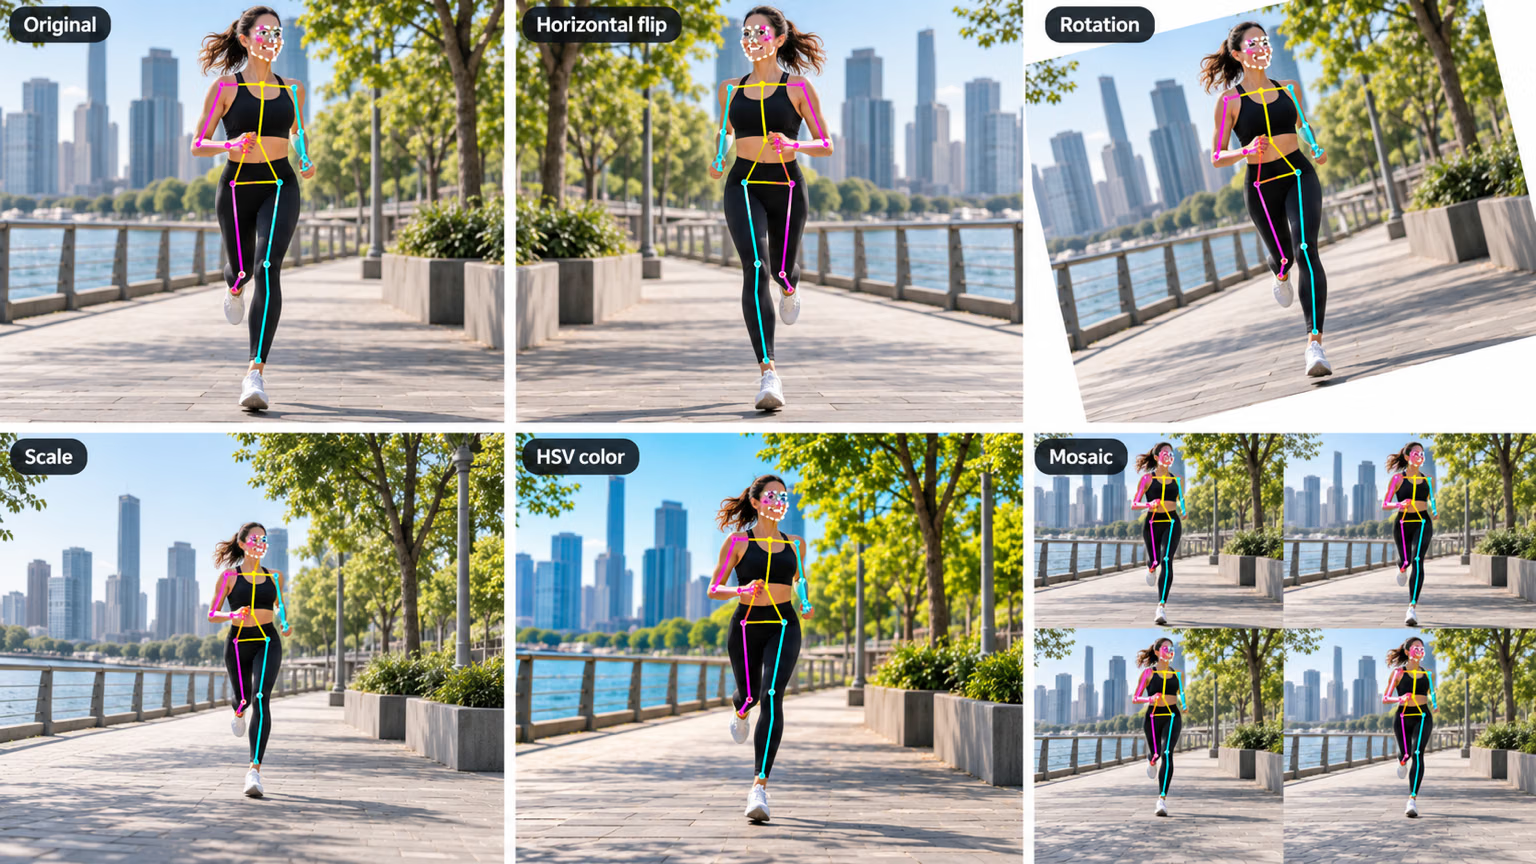
Với YOLO26, cường độ augmentation được kiểm soát bằng các tham số huấn luyện truyền vào model.train() hoặc các flag CLI tương ứng, không phải bằng cách chỉnh sửa YAML của dataset, vốn định nghĩa metadata của dataset như đường dẫn, tên lớp và các tập dữ liệu. Trường hợp ngoại lệ duy nhất là flip_idx: dataset pose khai báo trường này trong YAML của dataset để ánh xạ các cặp keypoint trái/phải; nếu thiếu trường này, YOLO sẽ tắt hoàn toàn fliplr và flipud. Các phép augmentation tích hợp gồm:
- Mosaic, MixUp và CutMix (
mosaic,mixup,cutmix): Kết hợp nhiều ảnh thành một mẫu huấn luyện. - Lật ảnh (
fliplr,flipud): Lật ảnh theo chiều ngang hoặc chiều dọc. - Biến đổi hình học (
degrees,translate,scale,shear,perspective): Xoay, dịch chuyển, phóng to và làm biến dạng ảnh. - Biến đổi màu HSV (
hsv_h,hsv_s,hsv_v): Thay đổi sắc độ, độ bão hòa và độ sáng. - Copy-paste (
copy_paste): Dán thêm các bản sao của đối tượng đã phân đoạn; theo mặc định, các đối tượng được lật trong cùng ảnh, hoặc lấy từ ảnh khác bằngcopy_paste_mode=mixup. - Hoán đổi kênh (
bgr): Hoán đổi thứ tự kênh RGB thành BGR. - Biến đổi phân loại (
auto_augment,erasing): Áp dụng chính sách augmentation tự động và xóa ngẫu nhiên khi huấn luyện model phân loại.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# Cấu hình augmentation bằng các tham số huấn luyện, không phải YAML của dataset
model.train(data="coco8.yaml", epochs=10, hsv_h=0.015, fliplr=0.5, mosaic=1.0, degrees=10.0)
Để xem danh sách đầy đủ các tham số augmentation và giá trị mặc định, hãy tham khảo tài liệu cài đặt augmentation và hướng dẫn tăng cường dữ liệu YOLO chuyên biệt. Nếu đã cài gói albumentations, YOLO cũng tự động bật các phép augmentation tích hợp dựa trên Albumentations.
Nghiên cứu tình huống: Tiền xử lý để phát hiện phương tiện#
Hãy xem xét một dự án dùng YOLO26 để phát hiện và phân loại phương tiện trong ảnh giao thông, bắt đầu với các ảnh được gán nhãn bounding box và nhãn lớp. Sau đây là cách thực hiện từng quyết định tiền xử lý:
- Resize: Không cần thao tác thủ công — YOLO26 resize về
imgsztrong quá trình huấn luyện. - Chuẩn hóa: Không cần thao tác thủ công — YOLO26 tự động scale giá trị pixel về
[0, 1]. - Chia dữ liệu: Chia dataset thành 70% cho huấn luyện, 20% cho validation và 10% cho test, đồng thời duy trì phân phối lớp nhất quán giữa các tập.
- Augmentation: Thiết lập các tham số huấn luyện phù hợp với cảnh giao thông — chẳng hạn
fliplrđể đảm bảo tính bất biến theo hướng,hsv_vcho điều kiện ánh sáng ngày/đêm vàmosaiccho mật độ đối tượng đa dạng.
Sau khi hoàn tất các quyết định này, dataset đã sẵn sàng cho Phân tích dữ liệu khám phá (EDA).
Phân tích dữ liệu khám phá (EDA)#
EDA sử dụng thống kê và trực quan hóa để phát hiện các mẫu và phân phối trong dữ liệu, giúp bạn nhận ra những vấn đề như mất cân bằng lớp hoặc outlier trước khi huấn luyện.
Các kỹ thuật EDA thống kê#
EDA thống kê bắt đầu với các metric cơ bản — giá trị trung bình, trung vị, độ lệch chuẩn và phạm vi — được tính trên các thuộc tính như phân phối cường độ pixel. Những metric này cung cấp cái nhìn tổng quan nhanh về chất lượng dataset và sớm cho thấy các điểm bất thường.
Các kỹ thuật EDA trực quan#
Trực quan hóa cho thấy những mẫu mà thống kê tóm tắt có thể bỏ sót, chẳng hạn như mất cân bằng lớp và outlier. Các công cụ phổ biến gồm:
- Histogram và biểu đồ hộp: Thể hiện phân phối giá trị pixel và đánh dấu outlier trong cường độ hoặc phân phối đặc trưng.
- Biểu đồ thanh: Cho thấy tình trạng mất cân bằng lớp bằng cách so sánh số lượng mẫu của từng lớp.
- Biểu đồ phân tán: Khám phá mối quan hệ giữa các đặc trưng ảnh hoặc nhãn.
- Heatmap: Trực quan hóa phân phối cường độ pixel hoặc phân bố không gian của nhãn trên các ảnh.
Ultralytics Platform dành cho EDA#
Để thực hiện EDA mà không cần viết code, hãy tải dataset lên Ultralytics Platform. Tab Charts của dataset tự động tạo các biểu đồ EDA chính: phân phối tập dữ liệu, số lượng của các lớp hàng đầu, histogram chiều rộng/chiều cao ảnh và heatmap 2D về vị trí nhãn cùng kích thước ảnh. Tab Images cho phép duyệt dữ liệu ở chế độ lưới, thu gọn hoặc bảng, kèm lớp phủ nhãn, giúp dễ dàng phát hiện các mẫu bị gán nhãn sai hoặc lớp mất cân bằng mà không cần viết code.
Kết luận#
Dữ liệu được chia, chuẩn hóa và tăng cường đúng cách giúp giảm nhiễu và cải thiện khả năng khái quát hóa, biến tập hợp ảnh thô thành một tập huấn luyện đáng tin cậy. Sau khi tiền xử lý dataset, bước tiếp theo là huấn luyện model. Nếu có thắc mắc trong quá trình thực hiện, hãy hỏi cộng đồng tại kho lưu trữ Ultralytics trên GitHub hoặc máy chủ Ultralytics trên Discord.
Câu hỏi thường gặp#
Tiền xử lý đảm bảo dữ liệu sạch, nhất quán và ở định dạng tối ưu cho huấn luyện. Bằng cách xử lý nhiễu, sự không nhất quán và mất cân bằng lớp trong dữ liệu thô, các bước như resize, chuẩn hóa, tăng cường dữ liệu và chia dataset giúp giảm tải tính toán, đồng thời cải thiện hiệu suất model. Xem các bước thực hiện một dự án thị giác máy tính để biết bước này nằm ở đâu trong quy trình tổng thể.
Cấu hình augmentation bằng các tham số huấn luyện thay vì YAML của dataset. Truyền các tham số như
fliplr,mosaic,hsv_hvàdegreesvàomodel.train()(hoặc dùng các flag CLI tương ứng) để thiết lập xác suất và cường độ của từng phép biến đổi. Các tham số này được liệt kê trong tài liệu cài đặt augmentation và giải thích trong hướng dẫn tăng cường dữ liệu YOLO. Dataset pose là trường hợp ngoại lệ: ánh xạ keypointflip_idxcủa chúng nằm trong YAML của dataset; nếu thiếu ánh xạ này, các phép lật sẽ bị tắt.Hai kỹ thuật phổ biến nhất là min-max scaling (scale lại pixel về phạm vi từ 0 đến 1) và chuẩn hóa z-score (scale lại dựa trên giá trị trung bình và độ lệch chuẩn). YOLO26 tự động áp dụng min-max scaling — chuyển ảnh sang RGB và chia giá trị pixel cho 255 — nên bạn không cần chuẩn hóa thủ công. Theo mặc định, YOLO26 không áp dụng chuẩn hóa z-score.
Một cách làm phổ biến là dành 70% cho huấn luyện, 20% cho validation và 10% cho test. Duy trì phân phối lớp đồng đều trong cả ba tập và tránh rò rỉ dữ liệu bằng cách chỉ áp dụng augmentation cho tập huấn luyện sau khi chia. Các công cụ như scikit-learn hoặc TensorFlow giúp chia dữ liệu hiệu quả. Xem hướng dẫn thu thập và gán nhãn dữ liệu để tìm hiểu các bước chuẩn bị dataset trước đó.
Có. Tham số
imgszkiểm soát kích thước đầu vào mục tiêu mà không cần thao tác thủ công. Trong quy trình sử dụng kích thước cố định dạng vuông, validation và inference đưa ảnh về dạng letterbox để phù hợp với kích thước được chỉ định, đồng thời giữ nguyên tỷ lệ khung hình; ảnh lớn hơn được thu nhỏ cho vừa, còn ảnh nhỏ hơn không được phóng to khi tắt scale-up. Trong quá trình huấn luyện, augmentation mosaic mặc định đạt kích thước mục tiêu bằng cách ghép bốn ảnh rồi crop. Batch hình chữ nhật (rect=True) vàmulti_scalesử dụng hình dạng đầu vào khác. Xem tài liệu huấn luyện model để biết chi tiết.