Tìm hiểu các bước chính trong một dự án thị giác máy tính#
Xây dựng một dự án thị giác máy tính đòi hỏi thực hiện theo trình tự các giai đoạn rõ ràng: xác định mục tiêu, thu thập và gán nhãn dữ liệu, huấn luyện và đánh giá model, rồi triển khai và duy trì model trong môi trường production. Hướng dẫn này trình bày từng bước theo đúng thứ tự và giải thích tầm quan trọng của từng bước, giúp bạn tự tin lập kế hoạch và triển khai dự án.
Thị giác máy tính là một phân ngành của trí tuệ nhân tạo (AI), giúp máy tính nhìn và hiểu thế giới như con người. Công nghệ này xử lý và phân tích hình ảnh hoặc video để trích xuất thông tin, nhận diện mẫu và đưa ra quyết định dựa trên dữ liệu đó.
Các kỹ thuật thị giác máy tính như phát hiện đối tượng, phân loại ảnh và phân đoạn instance có thể được ứng dụng trong nhiều ngành, từ lái xe tự hành đến chẩn đoán hình ảnh y khoa, nhằm khai thác những thông tin hữu ích.
Tổng quan về dự án thị giác máy tính#
Trước khi đi vào chi tiết từng bước trong một dự án thị giác máy tính, hãy cùng xem xét quy trình tổng thể. Nếu bắt đầu một dự án thị giác máy tính ngay hôm nay, bạn sẽ thực hiện các bước sau:
- Ưu tiên đầu tiên là tìm hiểu các yêu cầu của dự án.
- Tiếp theo, bạn thu thập và gán nhãn chính xác các hình ảnh dùng để huấn luyện model.
- Sau đó, bạn làm sạch và tăng cường dữ liệu để chuẩn bị cho việc huấn luyện model.
- Sau khi huấn luyện, hãy đánh giá kỹ lưỡng và kiểm thử model để đảm bảo model hoạt động ổn định trong các điều kiện khác nhau.
- Cuối cùng, bạn triển khai model vào thực tế và giám sát, bảo trì model dựa trên những thông tin và phản hồi mới.
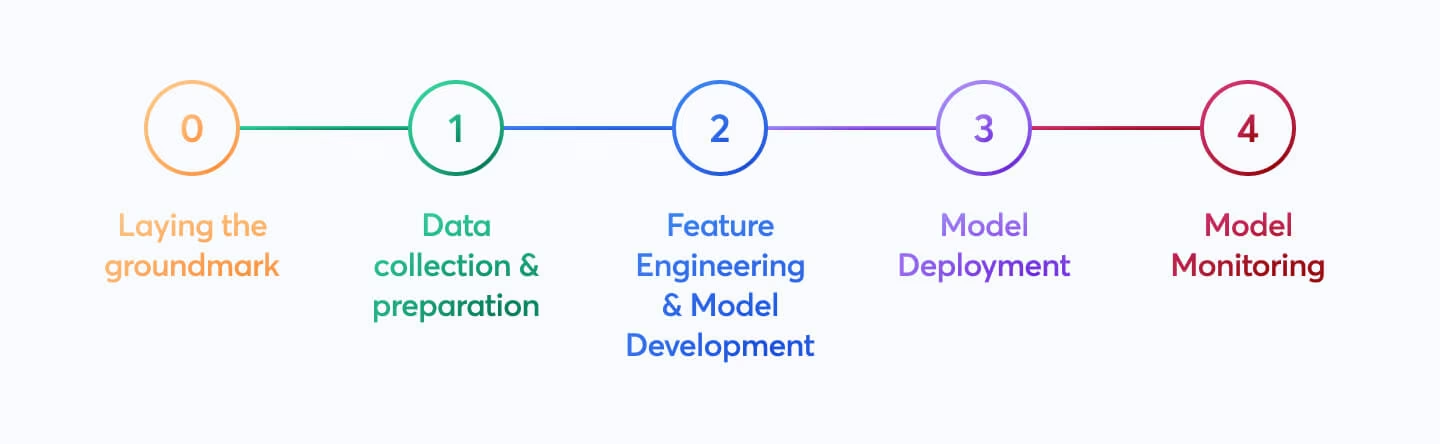
Giờ đã biết những gì cần thực hiện, hãy cùng đi sâu vào từng bước để thúc đẩy dự án của bạn.
Bước 1: Xác định mục tiêu dự án#
Bước đầu tiên trong mọi dự án thị giác máy tính là xác định rõ vấn đề bạn muốn giải quyết. Biết được mục tiêu cuối cùng giúp bạn bắt đầu xây dựng giải pháp. Điều này đặc biệt quan trọng với thị giác máy tính vì mục tiêu dự án sẽ trực tiếp quyết định tác vụ thị giác máy tính mà bạn cần tập trung.
Dưới đây là một số ví dụ về mục tiêu dự án và các tác vụ thị giác máy tính có thể dùng để đạt được những mục tiêu đó:
-
Mục tiêu: Phát triển một hệ thống có thể giám sát và quản lý lưu lượng của các loại phương tiện khác nhau trên đường cao tốc, qua đó cải thiện công tác quản lý giao thông và an toàn.
- Tác vụ thị giác máy tính: Phát hiện đối tượng là lựa chọn lý tưởng để giám sát giao thông vì có thể xác định vị trí và nhận diện nhiều phương tiện một cách hiệu quả. Tác vụ này đòi hỏi ít tài nguyên tính toán hơn phân đoạn ảnh, vốn cung cấp mức độ chi tiết không cần thiết cho trường hợp này, nhờ đó đảm bảo phân tích nhanh hơn theo thời gian thực.
-
Mục tiêu: Phát triển một công cụ hỗ trợ bác sĩ chẩn đoán hình ảnh bằng cách cung cấp đường viền chính xác ở cấp pixel của khối u trong ảnh chụp y khoa.
- Tác vụ thị giác máy tính: Phân đoạn ảnh phù hợp với chẩn đoán hình ảnh y khoa vì cung cấp đường biên khối u chính xác và chi tiết, yếu tố rất quan trọng để đánh giá kích thước, hình dạng và lập kế hoạch điều trị.
-
Mục tiêu: Tạo một hệ thống số để phân loại nhiều loại tài liệu (ví dụ: hóa đơn, biên lai, giấy tờ pháp lý), nhằm cải thiện hiệu quả tổ chức và khả năng truy xuất tài liệu.
- Tác vụ thị giác máy tính: Phân loại ảnh là lựa chọn lý tưởng trong trường hợp này vì xử lý từng tài liệu một mà không cần xét đến vị trí của tài liệu trong ảnh. Cách tiếp cận này giúp đơn giản hóa và tăng tốc quá trình phân loại.
Lựa chọn model và phương pháp huấn luyện phù hợp#
Sau khi hiểu rõ mục tiêu dự án và các tác vụ thị giác máy tính phù hợp, một phần thiết yếu trong việc xác định mục tiêu dự án là lựa chọn model và phương pháp huấn luyện phù hợp.
Tùy theo mục tiêu, bạn có thể chọn model trước hoặc sau khi biết những dữ liệu nào có thể thu thập ở Bước 2. Ví dụ, giả sử dự án của bạn phụ thuộc nhiều vào khả năng sẵn có của một số loại dữ liệu cụ thể. Khi đó, việc thu thập và phân tích dữ liệu trước rồi mới chọn model có thể thiết thực hơn. Ngược lại, nếu bạn hiểu rõ các yêu cầu đối với model, bạn có thể chọn model trước rồi thu thập dữ liệu phù hợp với các yêu cầu đó.
Việc lựa chọn huấn luyện từ đầu hay sử dụng transfer learning sẽ ảnh hưởng đến cách bạn chuẩn bị dữ liệu. Huấn luyện từ đầu đòi hỏi một dataset đa dạng để xây dựng hiểu biết của model từ nền tảng. Ngược lại, transfer learning cho phép bạn sử dụng model đã được huấn luyện trước và điều chỉnh model bằng một dataset nhỏ hơn, chuyên biệt hơn. Ngoài ra, việc chọn model cụ thể để huấn luyện sẽ quyết định cách bạn cần chuẩn bị dữ liệu, chẳng hạn như thay đổi kích thước ảnh hoặc thêm annotation theo các yêu cầu riêng của model.
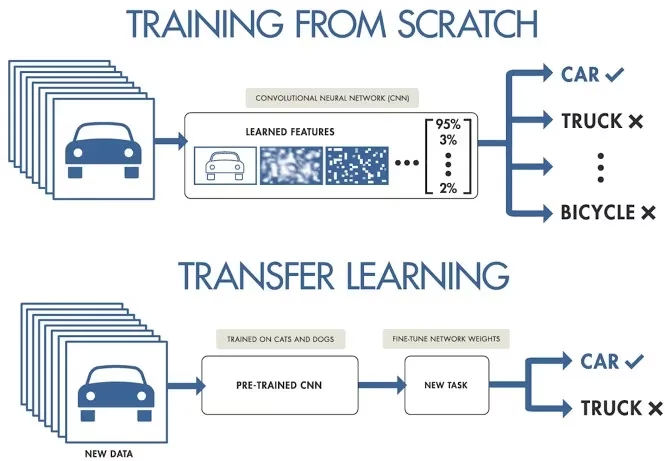
Hãy cân nhắc mục tiêu triển khai của model để đảm bảo khả năng tương thích và hiệu năng. Ví dụ, các model nhẹ rất phù hợp với điện toán biên nhờ hoạt động hiệu quả trên các thiết bị có tài nguyên hạn chế.
Để tìm hiểu thêm, hãy đọc hướng dẫn của chúng tôi về xác định mục tiêu dự án và lựa chọn model phù hợp.
Trước khi bắt tay vào thực hiện dự án thị giác máy tính, điều quan trọng là phải hiểu rõ những chi tiết này. Hãy kiểm tra lại xem bạn đã cân nhắc những điều sau đây trước khi chuyển sang Bước 2 chưa:
- Xác định rõ vấn đề bạn muốn giải quyết.
- Xác định mục tiêu cuối cùng của dự án.
- Xác định tác vụ thị giác máy tính cụ thể cần thực hiện (ví dụ: phát hiện đối tượng, phân loại ảnh, phân đoạn ảnh).
- Quyết định huấn luyện model từ đầu hay sử dụng transfer learning.
- Chọn model phù hợp với tác vụ và nhu cầu triển khai của bạn.
Bước 2: Thu thập và gán nhãn dữ liệu#
Chất lượng model thị giác máy tính phụ thuộc vào chất lượng dataset. Bạn có thể thu thập ảnh từ internet, tự chụp ảnh hoặc sử dụng các dataset có sẵn. Dưới đây là một số nguồn hữu ích để tải dataset chất lượng cao: Công cụ tìm kiếm Dataset của Google, Kho lưu trữ Machine Learning của UC Irvine và Dataset trên Kaggle.
Một số thư viện như Ultralytics cung cấp hỗ trợ tích hợp cho nhiều dataset, giúp bạn bắt đầu dễ dàng hơn với dữ liệu chất lượng cao. Các thư viện này thường có sẵn tiện ích để sử dụng liền mạch những dataset phổ biến, giúp bạn tiết kiệm đáng kể thời gian và công sức trong giai đoạn đầu của dự án.
Tuy nhiên, nếu chọn thu thập ảnh hoặc tự chụp ảnh, bạn sẽ cần gán nhãn dữ liệu. Gán nhãn dữ liệu là quá trình gắn nhãn cho dữ liệu để cung cấp thông tin cho model. Loại hình gán nhãn bạn cần thực hiện phụ thuộc vào kỹ thuật thị giác máy tính cụ thể. Dưới đây là một số ví dụ:
- Phân loại ảnh: Bạn sẽ gán nhãn toàn bộ ảnh bằng một lớp duy nhất.
- Phát hiện đối tượng: Bạn sẽ vẽ bounding box quanh từng đối tượng trong ảnh và gán nhãn cho từng box.
- Phân đoạn ảnh: Bạn sẽ gán nhãn từng pixel trong ảnh theo đối tượng mà pixel đó thuộc về, tạo ra đường biên đối tượng chi tiết.
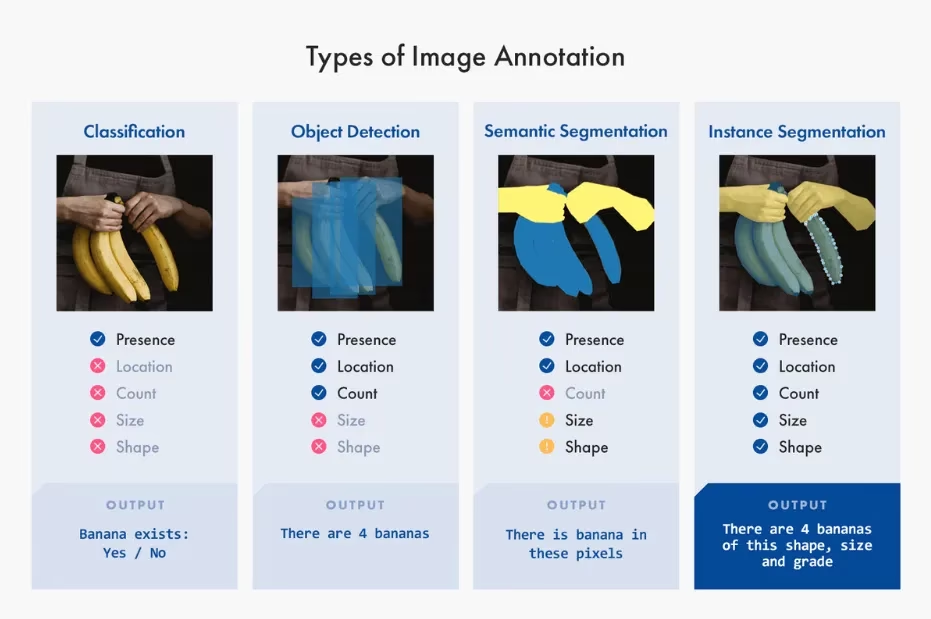
Thu thập và gán nhãn dữ liệu có thể là công việc thủ công tốn nhiều thời gian. Một công cụ gán nhãn chuyên dụng sẽ giúp đẩy nhanh quy trình: Ultralytics Platform cung cấp trình chỉnh sửa annotation tích hợp với tính năng gán nhãn thông minh dựa trên SAM cho dữ liệu phát hiện, phân đoạn và OBB, đồng thời lưu nhãn trực tiếp ở định dạng YOLO.
Bước 3: Tăng cường dữ liệu và chia dataset#
Sau khi thu thập và gán nhãn dữ liệu ảnh, trước tiên bạn cần chia dataset thành các tập huấn luyện, validation và kiểm thử, rồi mới thực hiện tăng cường dữ liệu. Chia dataset trước khi tăng cường là điều quan trọng để kiểm thử và validation model trên dữ liệu gốc, chưa bị biến đổi. Việc này giúp đánh giá chính xác khả năng tổng quát hóa của model trên dữ liệu mới chưa từng thấy.
Dưới đây là cách chia dữ liệu:
- Tập huấn luyện: Đây là phần lớn nhất trong dữ liệu của bạn, thường chiếm 70-80% tổng số, được dùng để huấn luyện model.
- Tập validation: Thường chiếm khoảng 10-15% dữ liệu; tập này được dùng để tinh chỉnh siêu tham số và validation model trong quá trình huấn luyện, giúp ngăn overfitting.
- Tập kiểm thử: 10-15% dữ liệu còn lại được dành làm tập kiểm thử. Tập này được dùng để đánh giá hiệu năng của model trên dữ liệu chưa từng thấy sau khi hoàn tất huấn luyện.
Sau khi chia dữ liệu, bạn có thể tăng cường dữ liệu bằng cách áp dụng các phép biến đổi như xoay, co giãn và lật ảnh để tăng kích thước dataset một cách nhân tạo. Tăng cường dữ liệu giúp model vững chắc hơn trước các biến thể và cải thiện hiệu năng trên những ảnh chưa từng thấy.
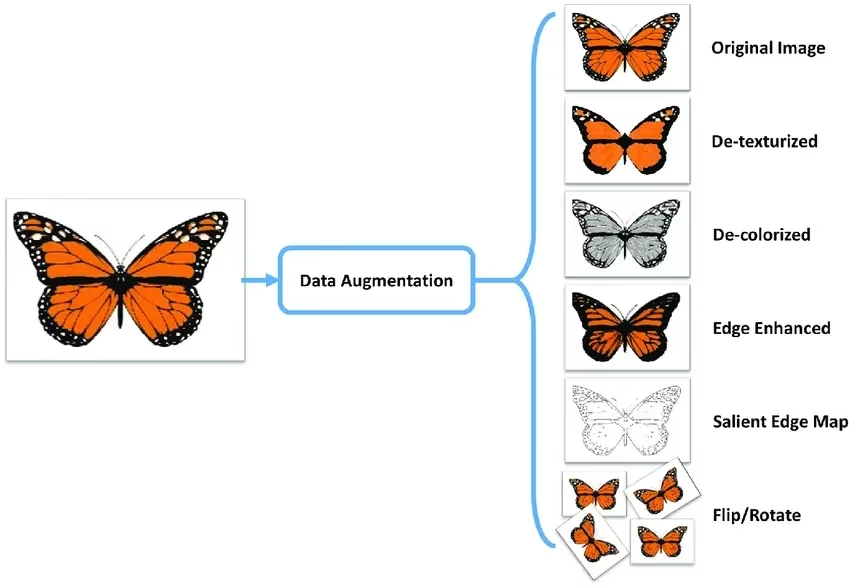
Các thư viện như OpenCV, Albumentations và TensorFlow cung cấp các hàm tăng cường linh hoạt để bạn sử dụng. Ngoài ra, một số thư viện như Ultralytics có các thiết lập tăng cường tích hợp ngay trong hàm huấn luyện model, giúp đơn giản hóa quy trình.
Để hiểu rõ hơn về dữ liệu, bạn có thể dùng các công cụ như Matplotlib hoặc Seaborn để trực quan hóa ảnh và phân tích phân phối cũng như đặc điểm của chúng. Trực quan hóa dữ liệu giúp xác định các mẫu, điểm bất thường và hiệu quả của những kỹ thuật tăng cường. Tab Charts trên Ultralytics Platform có thể hiển thị nhiều thông tin chuyên sâu này mà không cần viết code, bằng cách tự động tạo biểu đồ phân phối tập dữ liệu, số lượng lớp, histogram kích thước ảnh và heatmap vị trí annotation cho mọi dataset đã tải lên.
Bằng cách tìm hiểu, chia và tăng cường dữ liệu đúng cách, bạn có thể phát triển một model được huấn luyện, validation và kiểm thử kỹ lưỡng, hoạt động tốt trong các ứng dụng thực tế.
Bước 4: Huấn luyện model#
Khi dataset đã sẵn sàng cho việc huấn luyện, bạn có thể tập trung vào thiết lập môi trường cần thiết, quản lý dataset và huấn luyện model.
Trước tiên, bạn cần đảm bảo môi trường được cấu hình chính xác. Thông thường, việc này bao gồm:
- Cài đặt các thư viện và framework thiết yếu như TensorFlow, PyTorch hoặc Ultralytics.
- Nếu sử dụng GPU, cài đặt các thư viện như CUDA và cuDNN sẽ giúp bật tăng tốc GPU và rút ngắn thời gian huấn luyện.
Sau đó, bạn có thể tải dataset huấn luyện và validation vào môi trường. Chuẩn hóa và tiền xử lý dữ liệu bằng cách thay đổi kích thước, chuyển đổi định dạng hoặc tăng cường dữ liệu. Sau khi chọn model, hãy cấu hình các layer và chỉ định siêu tham số. Biên dịch model bằng cách thiết lập hàm loss, optimizer và các metric hiệu năng.
Các thư viện như Ultralytics giúp đơn giản hóa quá trình huấn luyện. Bạn có thể bắt đầu huấn luyện bằng cách đưa dữ liệu vào model chỉ với một lượng code tối thiểu. Những thư viện này tự động xử lý việc điều chỉnh trọng số, lan truyền ngược và validation. Chúng cũng cung cấp công cụ để dễ dàng theo dõi tiến độ và điều chỉnh siêu tham số. Sau khi huấn luyện, hãy lưu model và trọng số chỉ bằng vài lệnh.
Điều quan trọng cần nhớ là quản lý dataset đúng cách rất cần thiết để huấn luyện hiệu quả. Sử dụng quản lý phiên bản cho dataset để theo dõi thay đổi và đảm bảo khả năng tái lập. Các công cụ như DVC (Quản lý phiên bản dữ liệu) có thể giúp quản lý dataset lớn.
Bước 5: Đánh giá và tinh chỉnh model#
Điều quan trọng là đánh giá hiệu năng model bằng nhiều metric khác nhau và tinh chỉnh model để cải thiện độ chính xác. Đánh giá giúp xác định những điểm model hoạt động tốt và những điểm cần cải thiện. Tinh chỉnh đảm bảo model được tối ưu hóa để đạt hiệu năng tốt nhất có thể.
- Metric hiệu năng: Sử dụng các metric như độ chính xác, precision, recall và F1-score để đánh giá hiệu năng model. Các metric này cung cấp thông tin chuyên sâu về mức độ chính xác trong dự đoán của model.
- Tinh chỉnh siêu tham số: Điều chỉnh siêu tham số để tối ưu hóa hiệu năng model. Các kỹ thuật như tìm kiếm lưới hoặc tìm kiếm ngẫu nhiên có thể giúp tìm ra giá trị siêu tham số tốt nhất.
- Tinh chỉnh: Thực hiện những điều chỉnh nhỏ đối với kiến trúc model hoặc quy trình huấn luyện để nâng cao hiệu năng. Việc này có thể bao gồm tinh chỉnh learning rate, batch size hoặc các tham số khác của model.
Để hiểu sâu hơn về các kỹ thuật đánh giá và tinh chỉnh model, hãy xem hướng dẫn chuyên sâu về đánh giá model của chúng tôi.
Bước 6: Kiểm thử model#
Kiểm thử model xác nhận model hoạt động tốt trên dữ liệu hoàn toàn chưa từng thấy, qua đó xác minh model đã sẵn sàng triển khai. Điểm khác biệt giữa kiểm thử model và đánh giá model là kiểm thử tập trung xác minh hiệu năng của model cuối cùng thay vì liên tục cải thiện model.
Điều quan trọng là kiểm thử kỹ lưỡng và gỡ lỗi mọi vấn đề phổ biến có thể phát sinh. Kiểm thử model trên một dataset kiểm thử riêng, không được sử dụng trong quá trình huấn luyện hoặc validation. Dataset này cần đại diện cho các tình huống thực tế để đảm bảo hiệu năng của model ổn định và đáng tin cậy.
Ngoài ra, hãy xử lý các vấn đề phổ biến như overfitting, underfitting và rò rỉ dữ liệu. Sử dụng các kỹ thuật như cross-validation và phát hiện bất thường để xác định và khắc phục những vấn đề này. Để tham khảo các chiến lược kiểm thử toàn diện, hãy xem hướng dẫn kiểm thử model của chúng tôi.
Bước 7: Triển khai model#
Sau khi model đã được kiểm thử kỹ lưỡng, đã đến lúc triển khai model. Triển khai model là quá trình đưa model vào sử dụng trong môi trường production. Dưới đây là các bước triển khai model thị giác máy tính:
- Thiết lập môi trường: Cấu hình hạ tầng cần thiết cho tùy chọn triển khai đã chọn, dù là trên cloud (AWS, Google Cloud, Azure) hay tại biên (thiết bị cục bộ, IoT).
- Xuất model: Xuất model sang định dạng phù hợp (ví dụ: ONNX, TensorRT, CoreML cho YOLO26) để đảm bảo tương thích với nền tảng triển khai.
- Triển khai model: Triển khai model bằng cách thiết lập API hoặc endpoint và tích hợp model với ứng dụng.
- Đảm bảo khả năng mở rộng: Triển khai bộ cân bằng tải, nhóm tự động mở rộng và công cụ giám sát để quản lý tài nguyên, xử lý lượng dữ liệu ngày càng tăng và các yêu cầu của người dùng.
Để biết hướng dẫn chi tiết hơn về chiến lược triển khai và các phương pháp tốt nhất, hãy xem hướng dẫn về phương pháp triển khai model của chúng tôi. Ultralytics Platform cũng cung cấp endpoint triển khai được quản lý, tự động mở rộng trên 42 khu vực toàn cầu và tự động xử lý thiết lập hạ tầng.
Bước 8: Giám sát, bảo trì và tài liệu hóa#
Sau khi triển khai model, điều quan trọng là liên tục giám sát hiệu năng, bảo trì model để xử lý mọi vấn đề và tài liệu hóa toàn bộ quy trình nhằm phục vụ tham khảo và cải tiến trong tương lai.
Các công cụ giám sát có thể giúp bạn theo dõi các chỉ số hiệu năng chính (KPI) và phát hiện điểm bất thường hoặc mức giảm độ chính xác. Giám sát model giúp bạn nhận biết hiện tượng drift của model, khi hiệu năng model giảm dần theo thời gian do dữ liệu đầu vào thay đổi. Định kỳ huấn luyện lại model bằng dữ liệu cập nhật để duy trì độ chính xác và tính phù hợp.
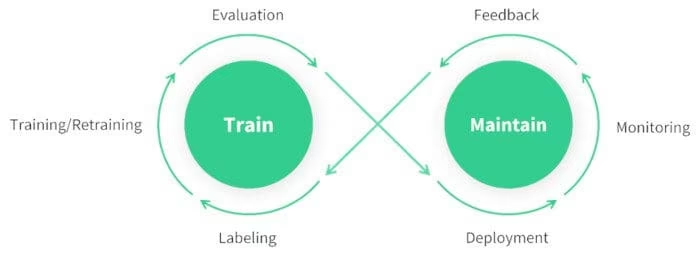
Bên cạnh giám sát và bảo trì, tài liệu hóa cũng rất quan trọng. Hãy ghi lại kỹ lưỡng toàn bộ quy trình, bao gồm kiến trúc model, quy trình huấn luyện, siêu tham số, các bước tiền xử lý dữ liệu và mọi thay đổi được thực hiện trong quá trình triển khai và bảo trì. Tài liệu tốt đảm bảo khả năng tái lập và giúp việc cập nhật hoặc khắc phục sự cố trong tương lai dễ dàng hơn. Bằng cách giám sát, bảo trì và tài liệu hóa model hiệu quả, bạn có thể đảm bảo model luôn chính xác, đáng tin cậy và dễ quản lý trong suốt vòng đời.
Kết nối với cộng đồng#
Kết nối với cộng đồng những người đam mê thị giác máy tính có thể giúp bạn tự tin xử lý mọi vấn đề gặp phải khi thực hiện dự án thị giác máy tính. Dưới đây là một số cách để học hỏi, khắc phục sự cố và kết nối hiệu quả.
Tài nguyên cộng đồng#
- GitHub Issues: Truy cập repository YOLO26 trên GitHub và dùng tab Issues để đặt câu hỏi, báo lỗi và đề xuất tính năng mới. Cộng đồng năng động cùng đội ngũ duy trì dự án luôn sẵn sàng hỗ trợ các vấn đề cụ thể.
- Máy chủ Ultralytics Discord: Tham gia máy chủ Ultralytics Discord để tương tác với những người dùng và developer khác, nhận hỗ trợ và chia sẻ thông tin chuyên sâu.
Tài liệu chính thức#
- Tài liệu Ultralytics YOLO26: Khám phá tài liệu YOLO26 chính thức để xem các hướng dẫn chi tiết cùng mẹo hữu ích về những tác vụ và dự án thị giác máy tính khác nhau.
Sử dụng những tài nguyên này sẽ giúp bạn vượt qua thử thách và cập nhật các xu hướng cũng như phương pháp tốt nhất mới nhất trong cộng đồng thị giác máy tính.
Các bước tiếp theo#
Giờ đây, bạn đã có lộ trình cho mọi giai đoạn của một dự án thị giác máy tính, từ xác định mục tiêu đến giám sát model đã triển khai. Hãy áp dụng lộ trình bằng cách huấn luyện model YOLO đầu tiên, hoặc tìm hiểu sâu hơn từng giai đoạn thông qua các hướng dẫn được liên kết ở trên. Để chạy toàn bộ pipeline mà không cần viết code, hãy khám phá Ultralytics Platform.
Câu hỏi thường gặp#
Việc chọn tác vụ thị giác máy tính phù hợp phụ thuộc vào mục tiêu cuối cùng của dự án. Chẳng hạn, nếu muốn giám sát giao thông, phát hiện đối tượng là lựa chọn phù hợp vì có thể định vị và nhận dạng nhiều loại phương tiện theo thời gian thực. Với chẩn đoán hình ảnh y khoa, phân đoạn ảnh là lựa chọn lý tưởng để xác định đường biên khối u chi tiết, hỗ trợ chẩn đoán và lập kế hoạch điều trị. Tìm hiểu thêm về các tác vụ cụ thể như phát hiện đối tượng, phân đoạn instance, phân đoạn semantic và phân loại ảnh.
Gán nhãn dữ liệu rất cần thiết để dạy model nhận biết các mẫu. Hình thức gán nhãn thay đổi tùy theo tác vụ:
- Phân loại ảnh: Gán nhãn toàn bộ ảnh thành một lớp duy nhất.
- Phát hiện đối tượng: Vẽ bounding box quanh các đối tượng.
- Phân đoạn ảnh: Gán nhãn từng pixel theo đối tượng mà pixel đó thuộc về.
Trình chỉnh sửa annotation tích hợp trong Ultralytics Platform có thể hỗ trợ quy trình này. Để biết thêm chi tiết, hãy tham khảo hướng dẫn thu thập và gán nhãn dữ liệu của chúng tôi.
Chia dataset trước khi tăng cường giúp validation hiệu năng model trên dữ liệu gốc, chưa bị biến đổi. Hãy làm theo các bước sau:
- Tập huấn luyện: 70-80% dữ liệu.
- Tập validation: 10-15% để tinh chỉnh siêu tham số.
- Tập kiểm thử: 10-15% còn lại để đánh giá cuối cùng.
Sau khi chia tập, hãy áp dụng các kỹ thuật tăng cường dữ liệu như xoay, co giãn và lật để tăng tính đa dạng của dataset. Các thư viện như Albumentations và OpenCV có thể hữu ích. Ultralytics cũng cung cấp các thiết lập tăng cường tích hợp để thuận tiện hơn.
Xuất model đã huấn luyện bằng phương thức
export, chọn định dạng phù hợp với mục tiêu triển khai. Ultralytics hỗ trợ nhiều định dạng, bao gồm ONNX, TensorRT và CoreML. Để xuất model YOLO26, hãy làm theo các bước sau:- Sử dụng phương thức
exportcùng tham số định dạng mong muốn. - Đảm bảo model đã xuất đáp ứng thông số kỹ thuật của môi trường triển khai (ví dụ: thiết bị biên, cloud).
Để biết thêm thông tin, hãy xem hướng dẫn xuất model.
- Sử dụng phương thức
Giám sát và bảo trì liên tục là yếu tố thiết yếu để model thành công về lâu dài. Triển khai các công cụ theo dõi Chỉ số hiệu năng chính (KPI) và phát hiện điểm bất thường. Thường xuyên huấn luyện lại model bằng dữ liệu cập nhật để hạn chế hiện tượng drift của model. Tài liệu hóa toàn bộ quy trình, bao gồm kiến trúc model, siêu tham số và các thay đổi, nhằm đảm bảo khả năng tái lập và thuận tiện cho việc cập nhật sau này. Tìm hiểu thêm trong hướng dẫn giám sát và bảo trì của chúng tôi.