Huấn luyện model
Ultralytics Platform cung cấp công cụ huấn luyện model YOLO, từ tổ chức thử nghiệm đến chạy tác vụ huấn luyện trên đám mây với luồng số liệu theo thời gian thực.
Xem: Bắt đầu với Ultralytics Platform - Huấn luyện
Tổng quan#
Phần Training giúp bạn:
- Tổ chức model thành project để dễ quản lý hơn
- Huấn luyện trên GPU đám mây chỉ với một cú nhấp
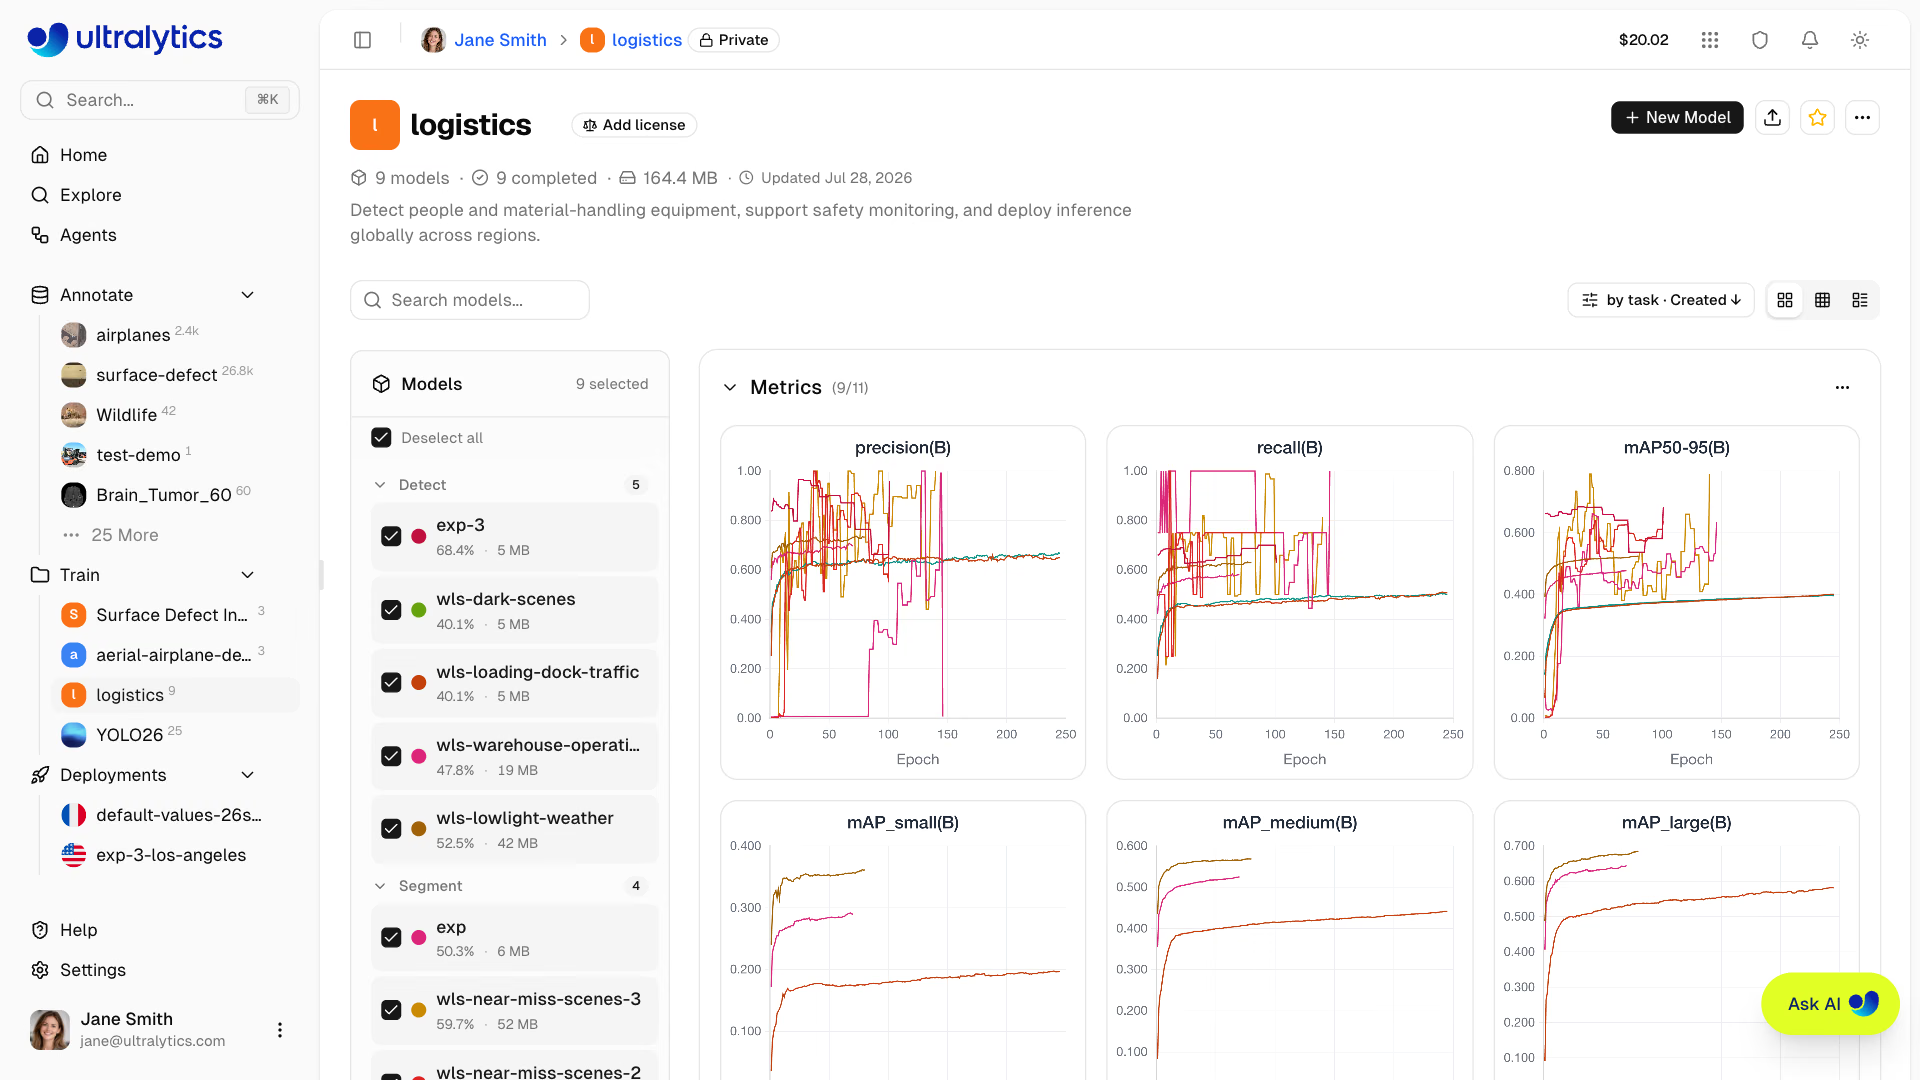
- Theo dõi metric theo thời gian thực trong quá trình huấn luyện
- So sánh hiệu suất model giữa các thử nghiệm
- Xuất sang 23 định dạng triển khai (xem các định dạng được hỗ trợ)
Workflow#
| Giai đoạn | Mô tả |
|---|---|
| Project | Tạo workspace để tổ chức các model có liên quan |
| Cấu hình | Chọn tập dữ liệu, model cơ sở và tham số huấn luyện |
| Huấn luyện | Chạy trên GPU đám mây hoặc phần cứng cục bộ của bạn |
| Theo dõi | Xem biểu đồ loss và metric theo thời gian thực |
| Export | Chuyển đổi sang 23 định dạng triển khai (chi tiết) |
Tùy chọn huấn luyện#
Ultralytics Platform hỗ trợ nhiều phương thức huấn luyện:
| Phương thức | Mô tả | Phù hợp nhất cho |
|---|---|---|
| Huấn luyện trên cloud | Huấn luyện trên GPU đám mây của Ultralytics | Không cần GPU cục bộ, có khả năng mở rộng |
| Huấn luyện cục bộ | Huấn luyện cục bộ, truyền metric đến nền tảng | Tận dụng phần cứng sẵn có, bảo mật quyền riêng tư |
| Huấn luyện bằng Colab | Sử dụng Google Colab tích hợp với nền tảng | Truy cập GPU miễn phí |
Khi bạn chọn GPU có giá thấp hơn RTX PRO 6000 và Ultralytics còn dung lượng được quản lý khả dụng, Platform sẽ chạy job của bạn trên RTX PRO 6000 nhưng vẫn tính phí theo mức giá mỗi giờ của GPU đã chọn. Các lần chạy có thể hoàn tất sớm hơn và tốn ít chi phí hơn so với chạy trên GPU đã chọn — việc nâng cấp không bao giờ làm tăng thời gian hoặc chi phí.
Các tùy chọn GPU#
GPU khả dụng để huấn luyện trên cloud của Ultralytics Cloud:
| GPU | Thế hệ | VRAM | Phù hợp nhất cho |
|---|---|---|---|
| RTX 2000 Ada | Ada | 16 GB | Dataset nhỏ, thử nghiệm |
| RTX A4500 | Ampere | 20 GB | Dataset nhỏ đến trung bình |
| RTX A5000 | Ampere | 24 GB | Dataset trung bình |
| RTX 4000 Ada | Ada | 20 GB | Dataset trung bình |
| RTX 3090 | Ampere | 24 GB | Huấn luyện tổng quát |
| RTX PRO 4000 | Blackwell | 24 GB | Blackwell tiết kiệm chi phí |
| L4 | Ada | 24 GB | Tối ưu cho suy luận |
| A40 | Ampere | 48 GB | Batch size lớn hơn |
| RTX A6000 | Ampere | 48 GB | Model lớn |
| RTX PRO 4500 | Blackwell | 32 GB | Tỷ lệ giá/hiệu năng tốt |
| L40 | Ada | 48 GB | Model lớn |
| RTX 4090 | Ada | 24 GB | Huấn luyện tổng quát |
| RTX PRO 5000 | Blackwell | 48 GB | Huấn luyện với batch lớn |
| RTX 6000 Ada | Ada | 48 GB | Huấn luyện với batch lớn |
| L40S | Ada | 48 GB | Huấn luyện với batch lớn |
| RTX 5090 | Blackwell | 32 GB | Thế hệ GPU tiêu dùng mới nhất |
| A100 PCIe | Ampere | 80 GB | Huấn luyện trong môi trường production |
| A100 SXM | Ampere | 80 GB | Huấn luyện trong môi trường production |
| RTX PRO 6000 | Blackwell | 96 GB | Mặc định được đề xuất |
| H100 PCIe | Hopper | 80 GB | Huấn luyện hiệu năng cao |
| H100 NVL | Hopper | 94 GB | Hiệu năng tối đa |
| H200 NVL | Hopper | 143 GB | Bộ nhớ tối đa |
| H100 SXM | Hopper | 80 GB | Huấn luyện nhanh nhất |
| H200 SXM | Hopper | 141 GB | Hiệu năng tối đa |
| B200 | Blackwell | 180 GB | Model lớn (Pro+) |
| B300 | Blackwell | 288 GB | Model lớn nhất (Pro+) |
Giá theo giờ hiện tại được hiển thị trong bộ chọn GPU của hộp thoại huấn luyện và trên trang giá.
GPU B200 và B300 yêu cầu gói Pro hoặc Enterprise. Tất cả GPU khác đều khả dụng trên mọi gói, bao gồm cả Free.
Tài khoản mới nhận được credit đăng ký để huấn luyện. Xem Billing để biết chi tiết.
Metric theo thời gian thực#
Trong tab Train của model, xem các chỉ số trực tiếp và kết quả validation hiện có:
| Tab phụ | Metric |
|---|---|
| Metric | Các chỉ số theo tác vụ (mAP50, mAP50-95, precision, recall cho detection), các hàm mất mát train/val, learning rate |
| Xác thực | Các biểu đồ validation đã ghi nhận và phân tích theo từng ảnh, nếu có |
| Console | Log huấn luyện trực tiếp có màu ANSI và tính năng tự động phát hiện lỗi |
| System | Mức sử dụng GPU, bộ nhớ và nhiệt độ GPU, CPU, RAM, mạng và I/O ổ đĩa |
Checkpoint tốt nhất (best.pt, epoch có fitness cao nhất) được tải lên Platform định kỳ trong khi các lần chạy huấn luyện đang diễn ra và một lần nữa khi lần chạy kết thúc, để việc tải xuống, xuất và triển khai luôn sử dụng epoch tốt nhất đã đạt được cho đến thời điểm đó. Các lần chạy bị hủy giữ lại checkpoint cuối cùng đã tải lên xong.
Bắt đầu nhanh#
Bắt đầu huấn luyện trên cloud trong chưa đầy một phút:
- Tạo project trong thanh bên
- Nhấp vào New Model
- Chọn model, tập dữ liệu và GPU
- Nhấp vào Start Training
Liên kết nhanh#
- Dự án: Sắp xếp model và thử nghiệm
- Models: Quản lý checkpoint đã huấn luyện
- Huấn luyện trên cloud: Huấn luyện trên GPU cloud
- AutoTrain: Sử dụng Ask AI để chạy thử nghiệm và so sánh model
Câu hỏi thường gặp#
Thời gian huấn luyện phụ thuộc vào:
- Kích thước tập dữ liệu (số lượng ảnh)
- Kích thước model (n, s, m, l, x)
- Số epoch
- Loại GPU được chọn
Bộ ước tính hiện tại dự đoán mất khoảng 6 phút với 1000 ảnh, YOLO26n, 100 epoch trên RTX PRO 6000 và khoảng 2 phút với 500 ảnh, YOLO26n, 50 epoch trên RTX 4090. Thời lượng thực tế có thể thay đổi; hãy dùng ước tính trực tiếp trong hộp thoại huấn luyện cho tập dữ liệu và cấu hình đã chọn.
Có. Giới hạn số job huấn luyện trên cloud chạy đồng thời tùy thuộc vào gói của bạn: Free cho phép 3, Pro cho phép 10 và Enterprise không giới hạn. Để huấn luyện song song nhiều hơn, hãy sử dụng tính năng huấn luyện từ xa trên nhiều máy.
Nếu quá trình huấn luyện thất bại:
- Model được đánh dấu là thất bại và phiên bản điện toán sẽ bị kết thúc
- Trang model hiển thị banner lỗi chứa lỗi đã ghi nhận, liên kết đến đầu ra console, cùng các tùy chọn Chẩn đoán bằng AI và Thử lại quá trình huấn luyện (vai trò Editor trở lên), mở lại hộp thoại huấn luyện với cùng cấu hình
- Lần chạy không báo hoạt động trong 4 giờ sẽ tự động được đánh dấu là thất bại và tài nguyên điện toán của lần chạy đó được giải phóng
- Nếu tài nguyên điện toán trên cloud đã khởi chạy, thời gian GPU đã sử dụng sẽ bị tính phí; lỗi xảy ra trước khi tài nguyên điện toán khởi chạy sẽ không phát sinh phí sử dụng GPU
Kịch bản GPU được đề xuất Hầu hết job huấn luyện RTX PRO 6000 Tập dữ liệu lớn hoặc batch size lớn H100 SXM hoặc H200 Ưu tiên tiết kiệm chi phí RTX 4090


Bình luận
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.