使用 Neural Magic 的 DeepSparse 部署 YOLOv5#
Neural Magic 于2025 年 1 月被 Red Hat 收购,并于 2025 年 6 月 2 日弃用了 DeepSparse、SparseML、SparseZoo 和 Sparsify 的社区版本。这些工具仍可运行,但不再获得更新或支持。如需使用持续维护的 CPU 加速方案,请参阅 OpenVINO 和 ONNX 集成。
欢迎使用软件交付式 AI。
本指南介绍如何使用 Neural Magic 的 DeepSparse 部署 YOLOv5。
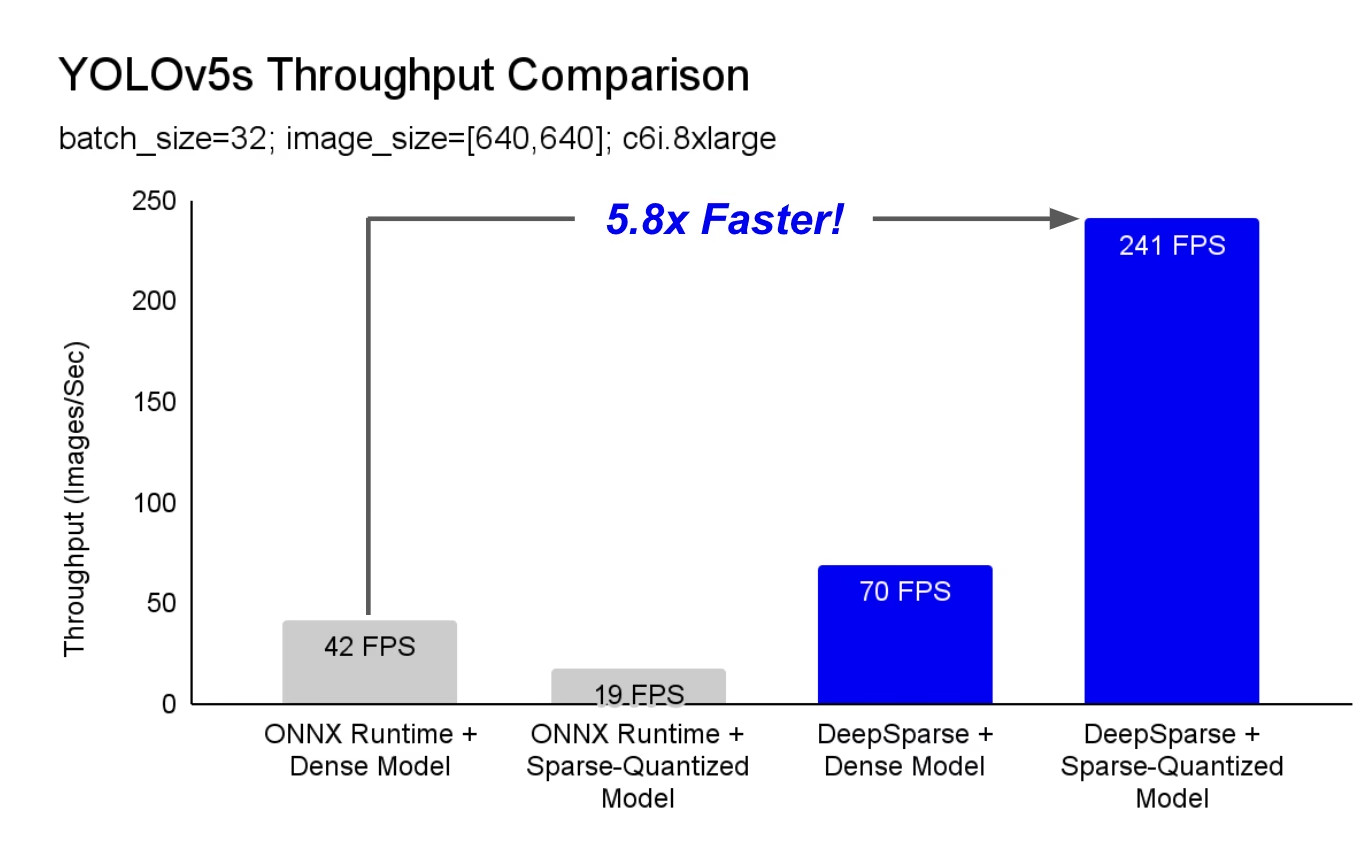
DeepSparse 是一款在 CPU 上性能出色的推理运行时。例如,与 ONNX Runtime 基准相比,DeepSparse 在同一台机器上运行 YOLOv5s,速度可提升 5.8 倍!
你的深度学习工作负载首次可以在不依赖硬件加速器的复杂配置和成本的情况下,满足生产环境的性能需求。简而言之,DeepSparse 兼具 GPU 的性能和软件的简便性:
- 灵活部署:可在云端、数据中心和边缘设备上保持一致运行,并支持从 Intel、AMD 到 ARM 的各种硬件供应商
- 无限扩展能力:可纵向扩展至数百个核心,通过标准 Kubernetes 横向扩展,或使用 Serverless 实现完全抽象的扩展
- 轻松集成:提供简洁的 API,便于将模型集成到应用中并在生产环境中监控模型
DeepSparse 如何实现 GPU 级性能?#
DeepSparse 利用模型稀疏性来提升运行速度。
通过剪枝和量化实现稀疏化是一种经过广泛研究的技术,它能将执行网络所需的模型大小和计算量降低数个数量级,同时保持较高的准确率。DeepSparse 能感知稀疏性,也就是说,它会跳过归零的参数,从而减少前向传播的计算量。由于稀疏计算受内存带宽限制,DeepSparse 会按网络深度执行计算,将问题拆分为 Tensor 列,即可放入缓存的纵向计算条带。
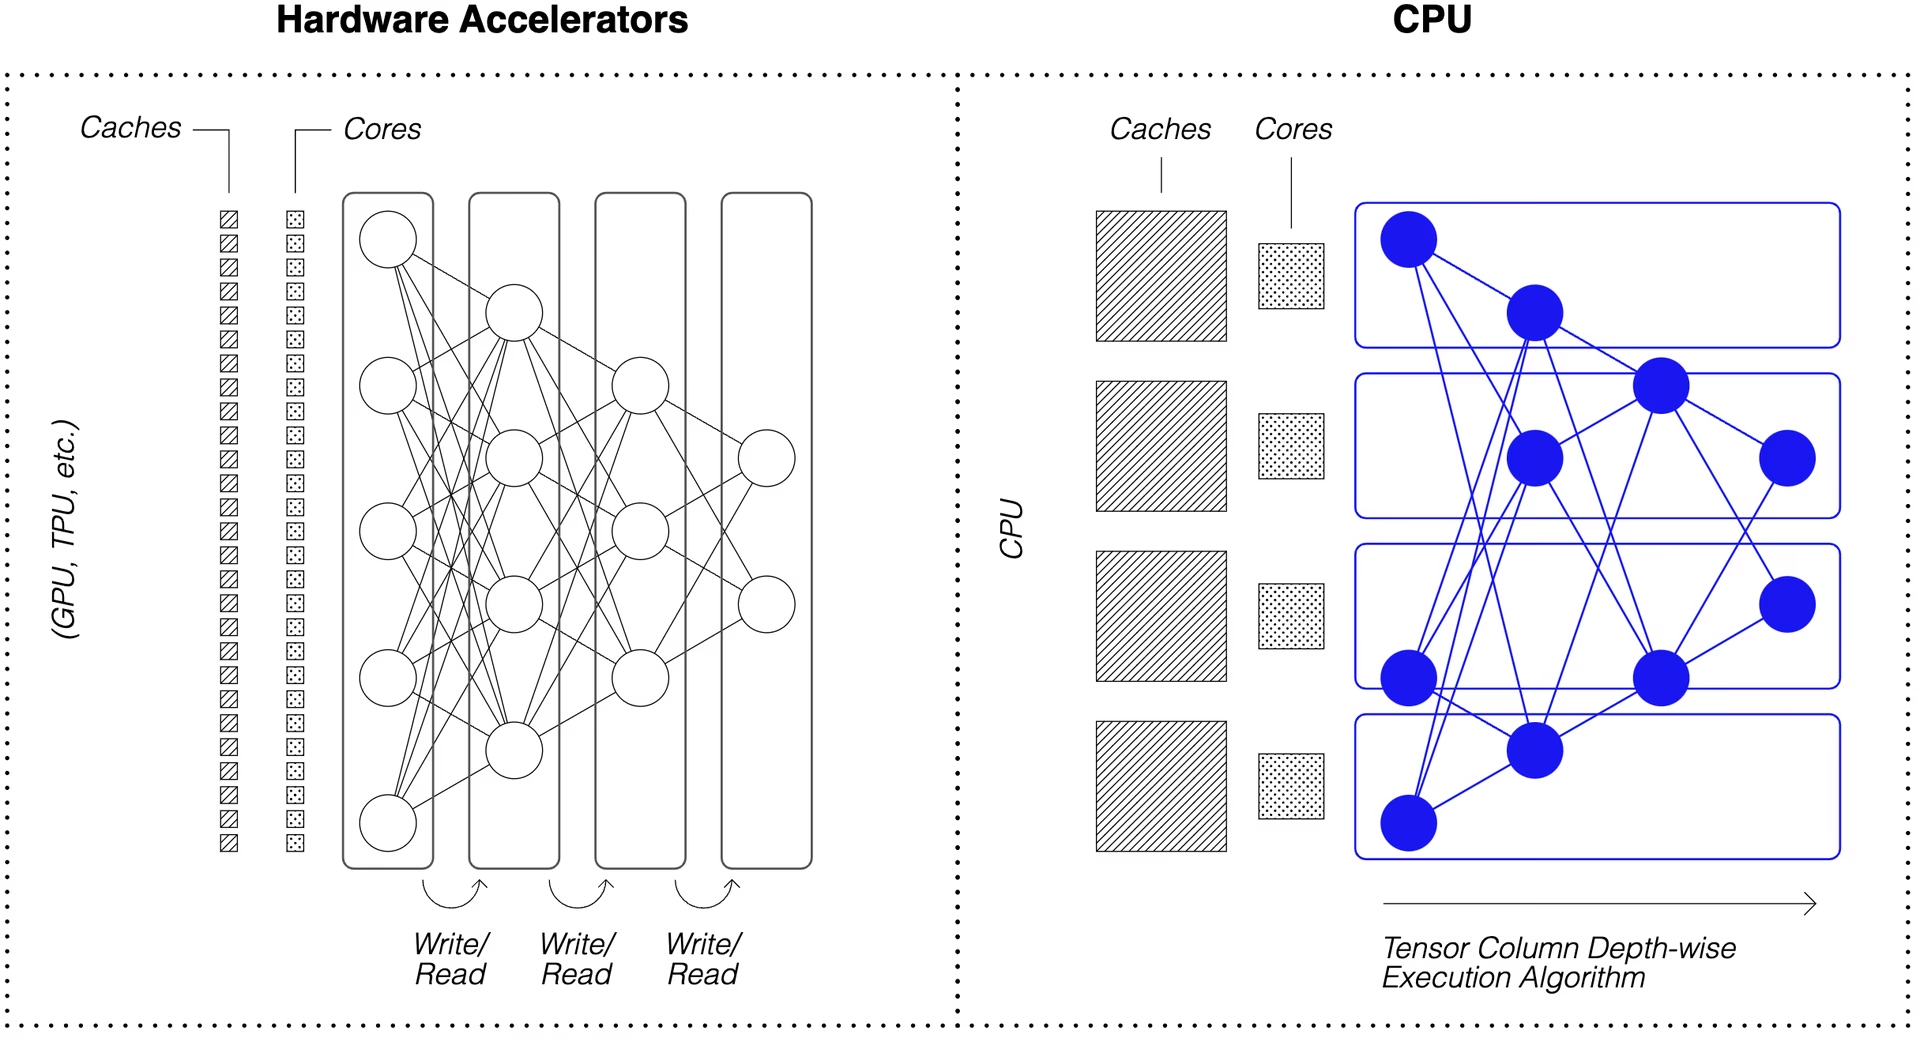
稀疏网络采用压缩计算并在缓存中按深度执行,使 DeepSparse 能够在 CPU 上实现 GPU 级性能!
如何创建使用我的数据训练的 YOLOv5 稀疏版本?#
Neural Magic 的开源模型仓库 SparseZoo 包含每种 YOLOv5 模型经过预稀疏化的检查点。借助与 Ultralytics 集成的 SparseML,你只需运行一条 CLI 命令,就能使用自己的数据微调稀疏检查点。
有关详情,请参阅 SparseML YOLOv5 集成。
DeepSparse 使用方法#
下面将通过一个示例,演示如何使用 DeepSparse 对 YOLOv5s 的稀疏版本进行基准测试和部署。
安装 DeepSparse#
运行以下命令安装 DeepSparse。我们建议你使用 Python 虚拟环境。
pip install "deepsparse[server,yolo,onnxruntime]"获取 ONNX 文件#
DeepSparse 接受 ONNX 格式的模型,可以通过以下任一方式传入:
- 用于标识 SparseZoo 中 ONNX 文件的 SparseZoo 存根
- 文件系统中 ONNX 模型的本地路径
以下示例使用标准密集型和剪枝量化型 YOLOv5s 检查点,并通过以下 SparseZoo 存根标识:
zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none部署模型#
DeepSparse 提供便捷的 API,便于将模型集成到应用中。
要尝试下面的部署示例,请下载一张示例图片,并使用以下命令将其保存为 basilica.jpg:
wget -O basilica.jpg https://raw.githubusercontent.com/neuralmagic/deepsparse/main/src/deepsparse/yolo/sample_images/basilica.jpgPython API#
Pipelines 会在运行时封装预处理和输出后处理,为将 DeepSparse 添加到应用中提供简洁的接口。DeepSparse-Ultralytics 集成包含开箱即用的 Pipeline,可接收原始图像并输出边界框。
创建一个 Pipeline 并运行推理:
from deepsparse import Pipeline

# 本地文件系统中的图像列表
images = ["basilica.jpg"]

# 创建 Pipeline
model_stub = "zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none"
yolo_pipeline = Pipeline.create(
    task="yolo",
    model_path=model_stub,
)

# 对图像运行推理,获取边界框和类别
pipeline_outputs = yolo_pipeline(images=images, iou_thres=0.6, conf_thres=0.001)
print(pipeline_outputs)
如果你在云端运行,可能会遇到 OpenCV 找不到 libGL.so.1 的错误。你可以安装缺失的库:
apt-get install libgl1或者使用完全避免 GUI 依赖的无头版 OpenCV:
pip install opencv-python-headlessHTTP 服务器#
DeepSparse Server 基于广受欢迎的 FastAPI Web 框架和 Uvicorn Web 服务器构建。只需运行一条 CLI 命令,你就能轻松使用 DeepSparse 设置模型服务端点。该服务器支持 DeepSparse 的任何 Pipeline,包括使用 YOLOv5 进行目标检测,让你可以向端点发送原始图像并接收边界框。
使用剪枝量化版 YOLOv5s 启动服务器:
deepsparse.server \
  --task yolo \
  --model_path zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
下面是一个使用 Python 的 requests 包发送请求的示例:
import json
from contextlib import ExitStack

import requests

# 用于推理的图像列表(客户端本地文件)
path = ["basilica.jpg"]

# 通过 HTTP 向 /predict/from_files 端点发送请求
url = "http://0.0.0.0:5543/predict/from_files"
with ExitStack() as stack:
    files = [("request", stack.enter_context(open(img, "rb"))) for img in path]
    resp = requests.post(url=url, files=files)

# 以 JSON 格式返回响应
annotations = json.loads(resp.text)  # 包含标注结果的字典
bounding_boxes = annotations["boxes"]
labels = annotations["labels"]
标注 CLI#
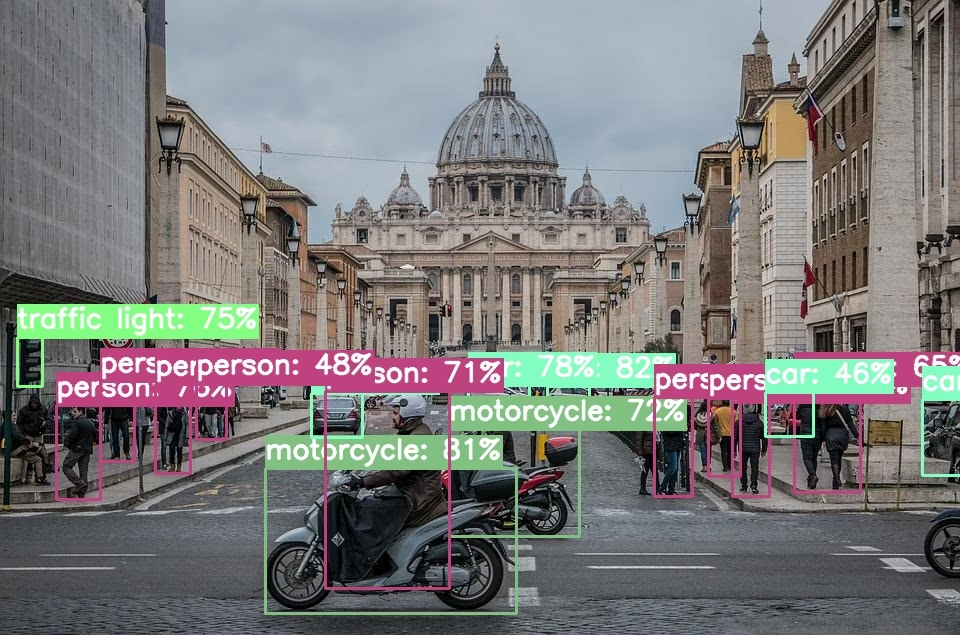
你还可以使用 annotate 命令,让引擎将带标注的照片保存到磁盘。试试 --source 0,为实时网络摄像头画面添加标注!
deepsparse.object_detection.annotate --model_filepath zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none --source basilica.jpg运行上述命令会创建一个 annotation-results 文件夹,并将标注后的图像保存在其中。
性能基准测试#
我们将使用 DeepSparse 的基准测试脚本,对比 DeepSparse 与 ONNX Runtime 在 YOLOv5s 上的吞吐量。
基准测试在 AWS c6i.8xlarge 实例(16 核)上运行。
批次大小为 32 时的性能对比#
ONNX Runtime 基线#
批次大小为 32 时,ONNX Runtime 使用标准稠密 YOLOv5s 可达到每秒 42 张图像:
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 32 -nstreams 1 -e onnxruntime

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 41.9025
DeepSparse 稠密模型性能#
DeepSparse 在经过优化的稀疏模型上性能最佳,但在标准稠密 YOLOv5s 上也表现出色。
批次大小为 32 时,DeepSparse 使用标准稠密 YOLOv5s 可达到每秒 70 张图像,性能比 ORT 提升 1.7 倍!
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 32 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 69.5546
DeepSparse 稀疏模型性能#
对模型应用稀疏化后,DeepSparse 相较于 ONNX Runtime 的性能优势会更加明显。
批次大小为 32 时,DeepSparse 使用剪枝量化 YOLOv5s 可达到每秒 241 张图像,性能比 ORT 提升 5.8 倍!
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none -s sync -b 32 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 241.2452
批次大小为 1 时的性能对比#
在对延迟敏感的批次大小为 1 的场景中,DeepSparse 同样能够比 ONNX Runtime 更快。
ONNX Runtime 基线#
批次大小为 1 时,ONNX Runtime 使用标准稠密 YOLOv5s 可达到每秒 48 张图像。
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 1 -nstreams 1 -e onnxruntime

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 48.0921
DeepSparse 稀疏模型性能#
批次大小为 1 时,DeepSparse 使用剪枝量化 YOLOv5s 可达到每秒 135 个项目,性能比 ONNX Runtime 提升 2.8 倍!
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none -s sync -b 1 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 134.9468
由于 c6i.8xlarge 实例支持 VNNI 指令,如果按 4 个权重为一组进行剪枝,DeepSparse 的吞吐量还能进一步提升。
批次大小为 1 时,DeepSparse 使用按 4 个权重为一组剪枝的量化 YOLOv5s 可达到每秒 180 个项目,性能比 ONNX Runtime 提升 3.7 倍!
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned35_quant-none-vnni -s sync -b 1 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned35_quant-none-vnni
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 179.7375
开始使用 DeepSparse#
用于研究或测试? DeepSparse Community 可免费用于研究和测试。请查看 DeepSparse README 开始使用。
如需了解更多关于使用 DeepSparse 部署 YOLOv5 的信息,请查看 DeepSparse YOLOv5 示例和 Ultralytics 关于 DeepSparse 集成的博客文章。
常见问题#
不需要。DeepSparse 是 CPU 运行时,上述基准测试是在一台 16 核 AWS
c6i.8xlarge实例上进行的,没有使用任何加速器。使用
python export.py --weights best.pt --include onnx将模型导出为 ONNX,并将文件路径作为model_path传入,而不是使用 SparseZoo 存根。运行时也能提升稠密模型的性能,而剪枝量化模型的收益最大。使用 SparseML 在自己的数据上微调一个预稀疏化的 SparseZoo 检查点;SparseML 会在训练过程中保留稀疏结构,然后将模型导出为 ONNX。
不再支持。社区版本已于 2025 年 6 月 2 日弃用,PyPI 上的软件包也已冻结。现有流水线仍可正常运行,但新的部署应考虑使用 OpenVINO 或 ONNX Runtime,这两者都在积极维护。