Ultralytics YOLOv5 架构#
YOLOv5(v6.0/6.1)是由 Ultralytics 开发的强大目标检测算法。本文将深入介绍 YOLOv5 架构、数据增强策略、训练方法和损失计算技术。全面了解这些内容,有助于你改进目标检测在监控、自动驾驶汽车和图像识别等领域的实际应用。
1. 模型结构#
YOLOv5 架构由三个主要部分组成:
- 骨干网络:这是网络的主体。YOLOv5 的骨干网络采用
CSPDarknet53结构,该结构是在先前版本使用的 Darknet 架构基础上修改而来。 - 颈部:该部分连接骨干网络和检测头。YOLOv5 使用
SPPF(空间金字塔池化 - 快速)和PANet(路径聚合网络)结构。 - 检测头:该部分负责生成最终输出。YOLOv5 使用
YOLOv3 Head来实现这一功能。
下图展示了模型结构。你可以在 models/yolov5l.yaml 中查看模型结构详情。
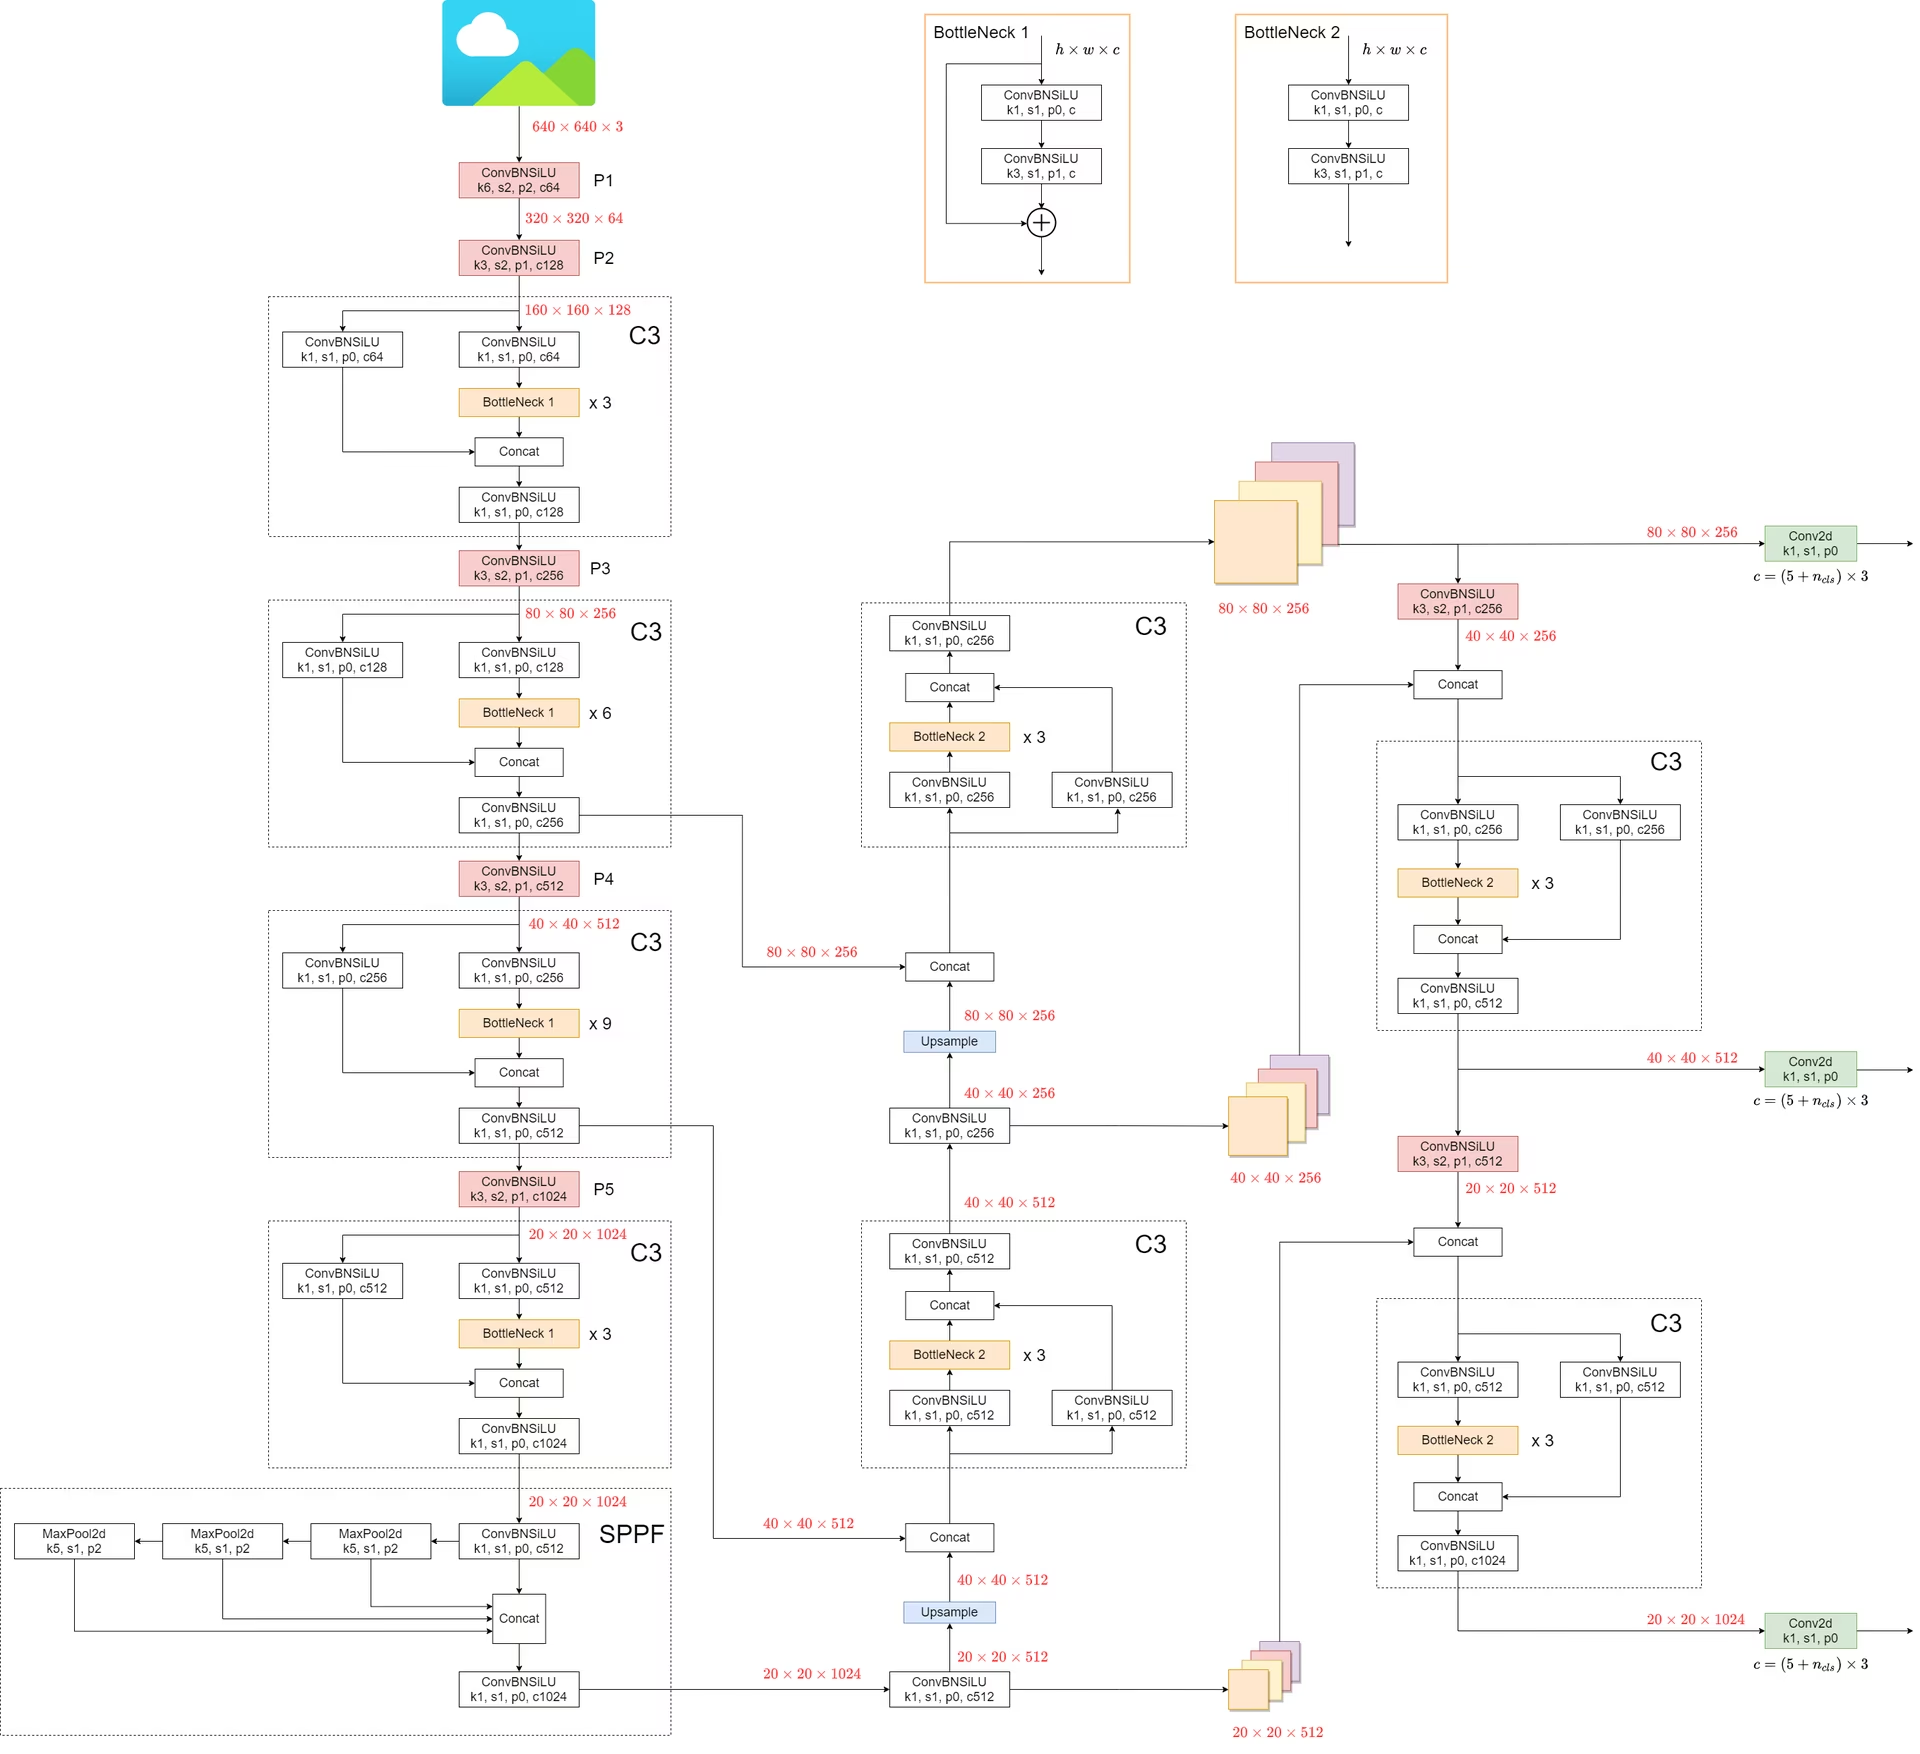
与前代版本相比,YOLOv5 引入了一些值得关注的改进:
- 早期版本中的
Focus结构被6x6 Conv2d结构取代。这一改动提升了效率 #4825。 SPP结构被SPPF取代。这一改动在保持输出不变的同时,使处理速度提升了一倍以上。
可以使用以下代码测试 SPP 和 SPPF 的速度:
SPP 与 SPPF 速度分析示例(点击打开)
import time

import torch
from torch import nn

class SPP(nn.Module):
    def __init__(self):
        """Initializes an SPP module with three different sizes of max pooling layers."""
        super().__init__()
        self.maxpool1 = nn.MaxPool2d(5, 1, padding=2)
        self.maxpool2 = nn.MaxPool2d(9, 1, padding=4)
        self.maxpool3 = nn.MaxPool2d(13, 1, padding=6)

    def forward(self, x):
        """Applies three max pooling layers on input `x` and concatenates results along channel dimension."""
        o1 = self.maxpool1(x)
        o2 = self.maxpool2(x)
        o3 = self.maxpool3(x)
        return torch.cat([x, o1, o2, o3], dim=1)

class SPPF(nn.Module):
    def __init__(self):
        """Initializes an SPPF module with a specific configuration of MaxPool2d layer."""
        super().__init__()
        self.maxpool = nn.MaxPool2d(5, 1, padding=2)

    def forward(self, x):
        """Applies sequential max pooling and concatenates results with input tensor."""
        o1 = self.maxpool(x)
        o2 = self.maxpool(o1)
        o3 = self.maxpool(o2)
        return torch.cat([x, o1, o2, o3], dim=1)

def main():
    """Compares outputs and performance of SPP and SPPF on a random tensor (8, 32, 16, 16)."""
    input_tensor = torch.rand(8, 32, 16, 16)
    spp = SPP()
    sppf = SPPF()
    output1 = spp(input_tensor)
    output2 = sppf(input_tensor)

    print(torch.equal(output1, output2))

    t_start = time.time()
    for _ in range(100):
        spp(input_tensor)
    print(f"SPP time: {time.time() - t_start}")

    t_start = time.time()
    for _ in range(100):
        sppf(input_tensor)
    print(f"SPPF time: {time.time() - t_start}")

if __name__ == "__main__":
    main()
结果:
True
SPP time: 0.5373051166534424
SPPF time: 0.20780706405639648
2. 数据增强技术#
YOLOv5 使用多种数据增强技术来提升模型的泛化能力并减少过拟合。这些技术包括:
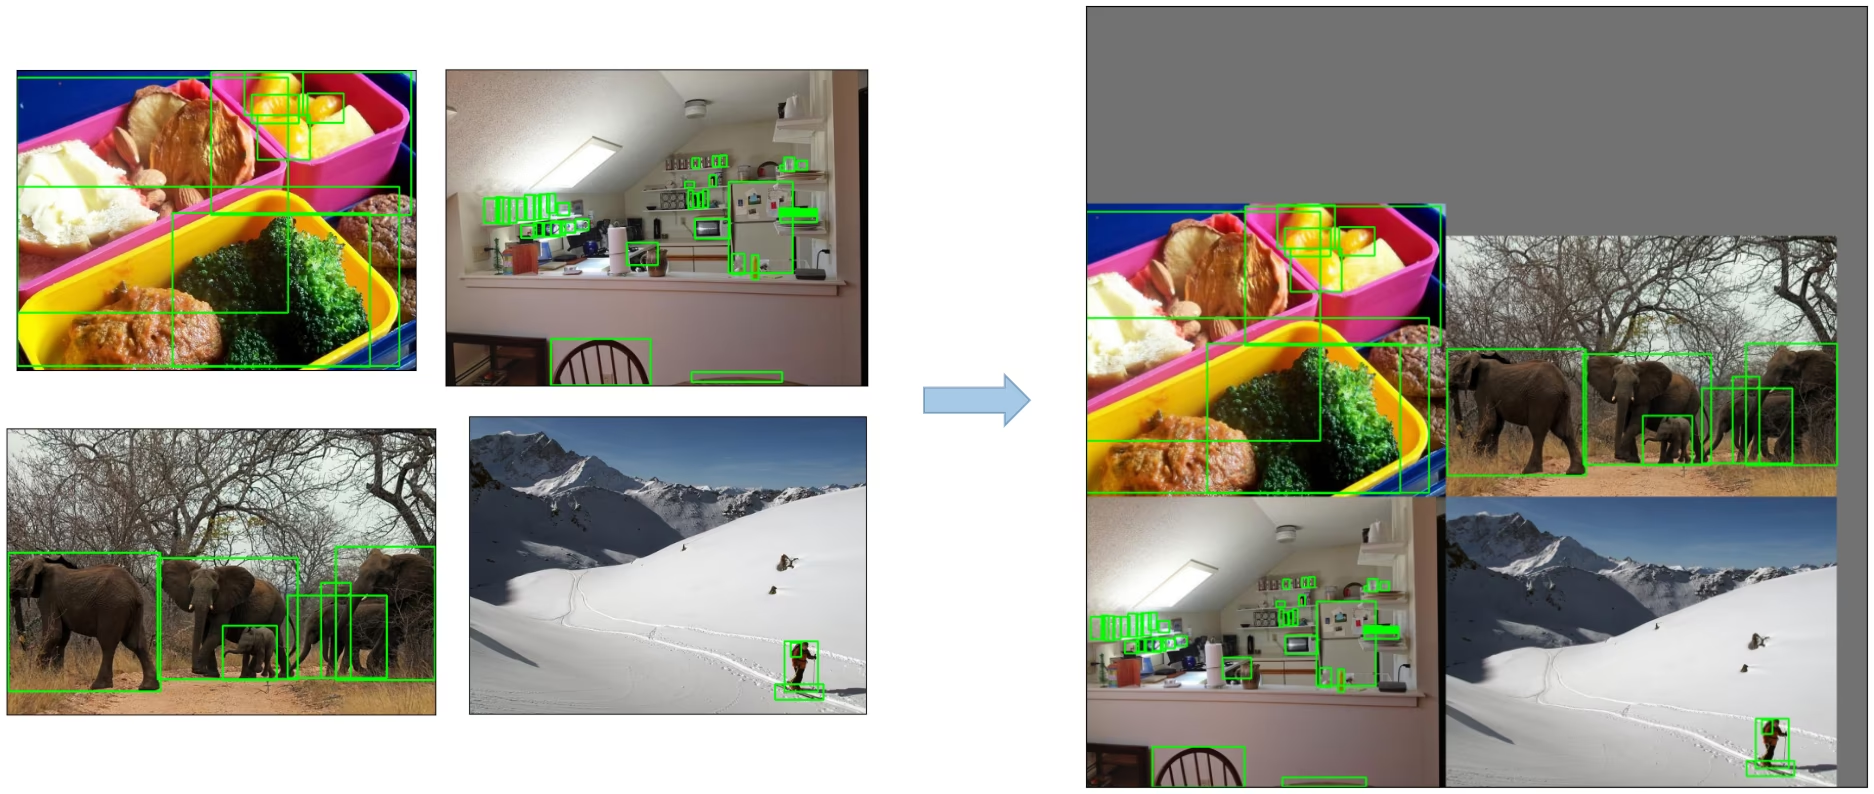
-
马赛克增强:一种图像处理技术,将四张训练图像合并为一张,以帮助目标检测模型更好地处理不同的目标尺度和位置变化。
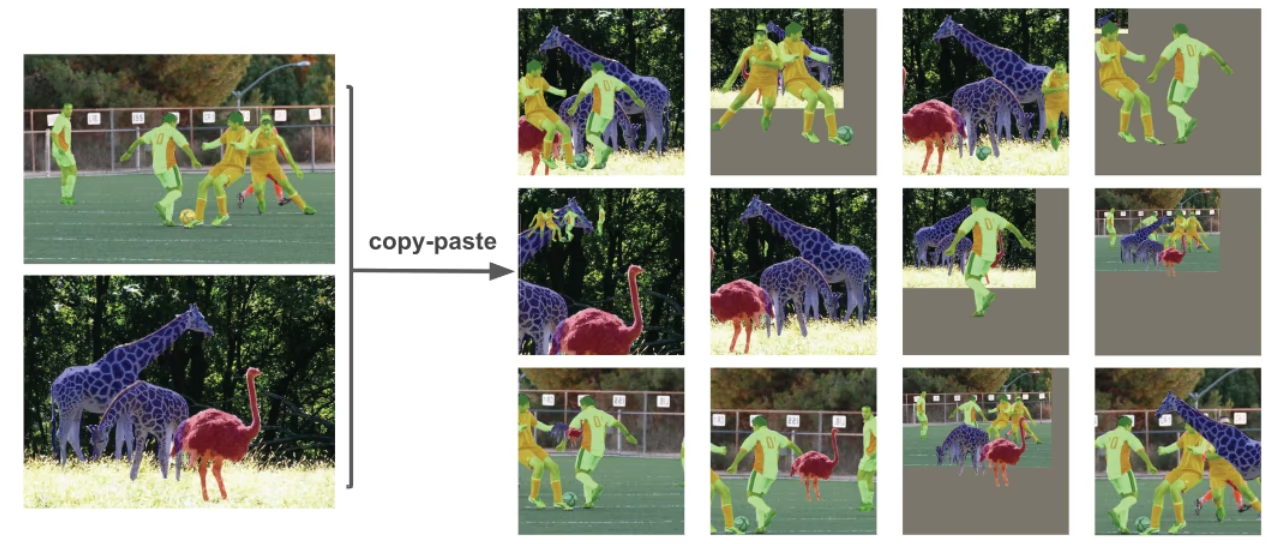
-
复制粘贴增强:一种创新的数据增强方法,从一张图像中复制随机图像块,并将其粘贴到另一张随机选取的图像上,从而生成新的训练样本。
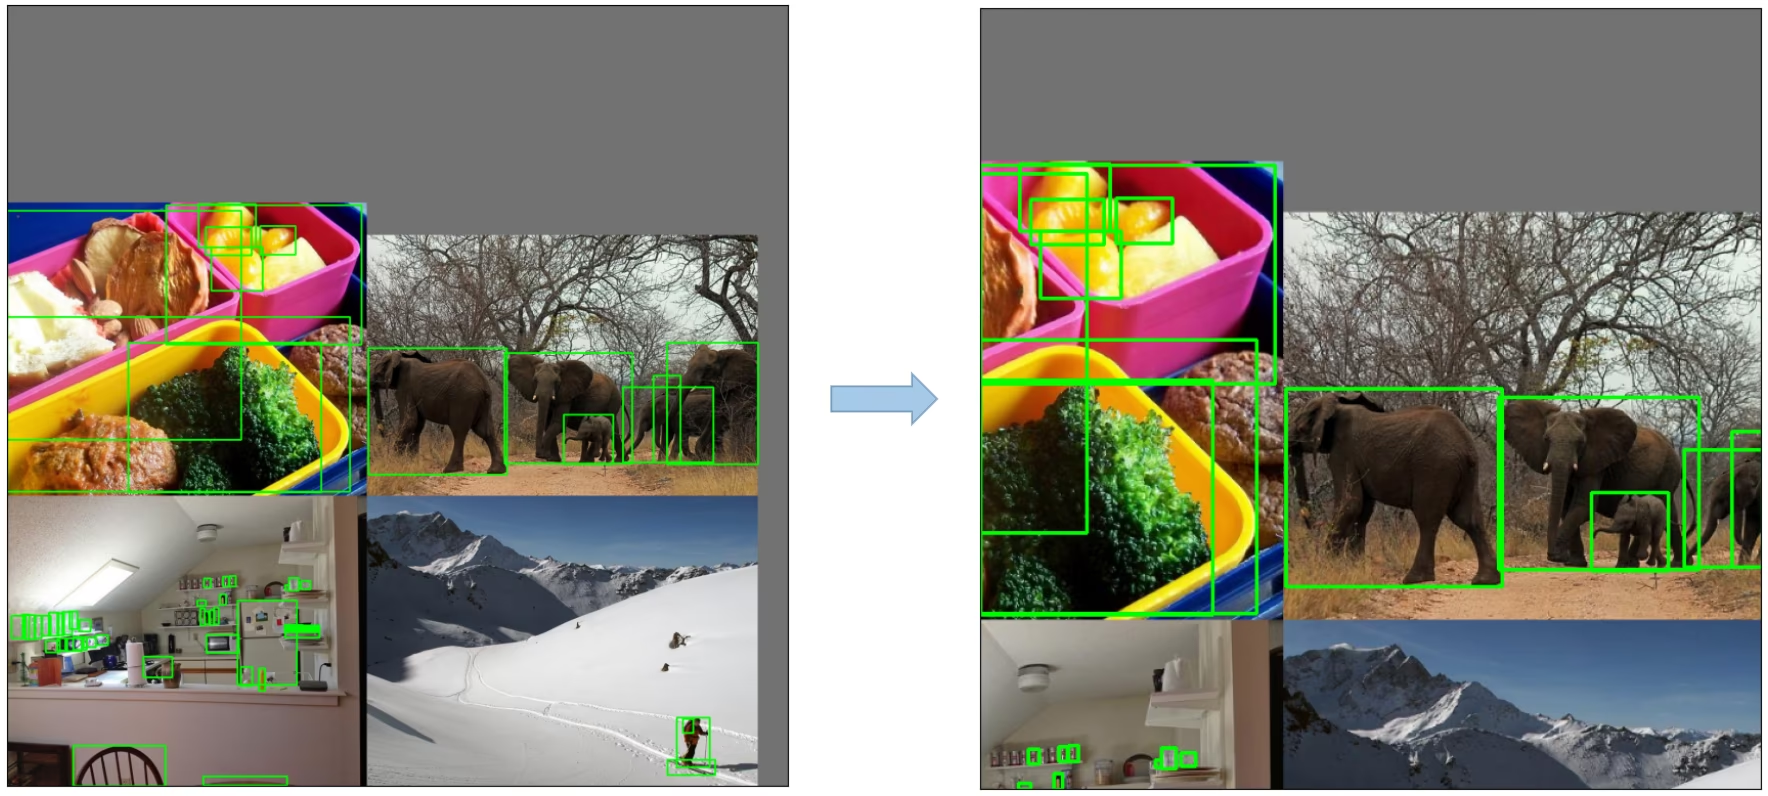
-
随机仿射变换:包括对图像进行随机旋转、缩放、平移和错切。
-
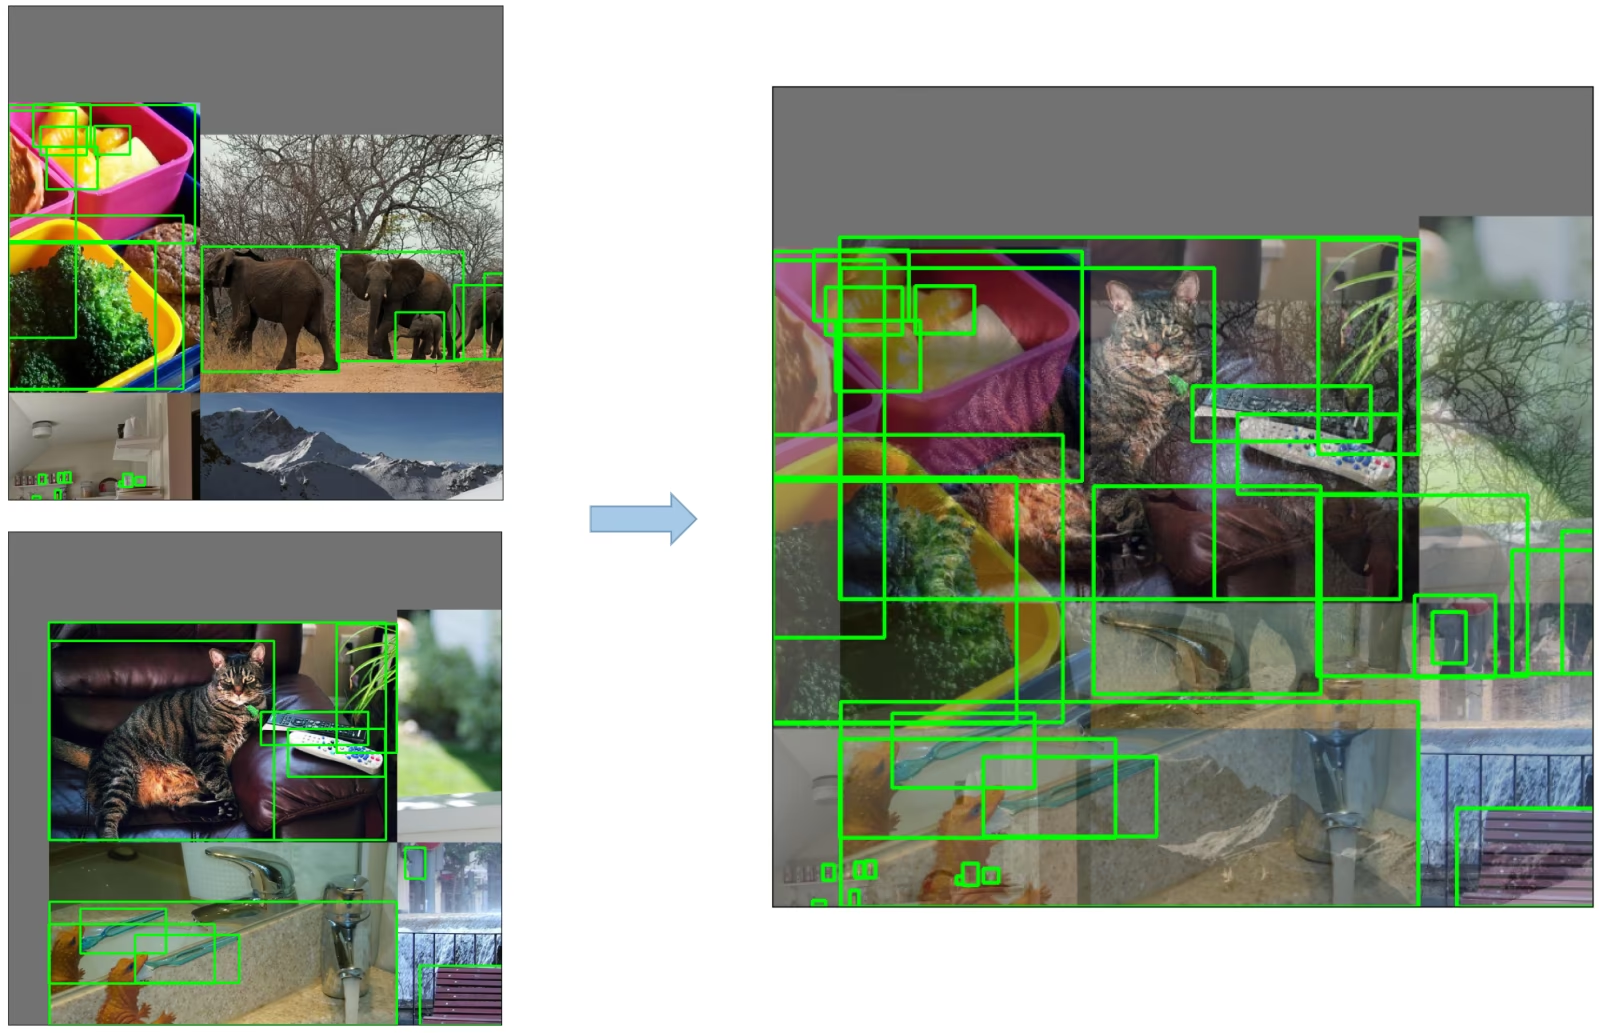
MixUp 增强:通过对两张图像及其对应标签进行线性组合来生成合成图像的方法。
-
Albumentations:一个功能强大的图像增强库,支持多种增强技术。了解更多关于使用 Albumentations 进行数据增强的信息。
-
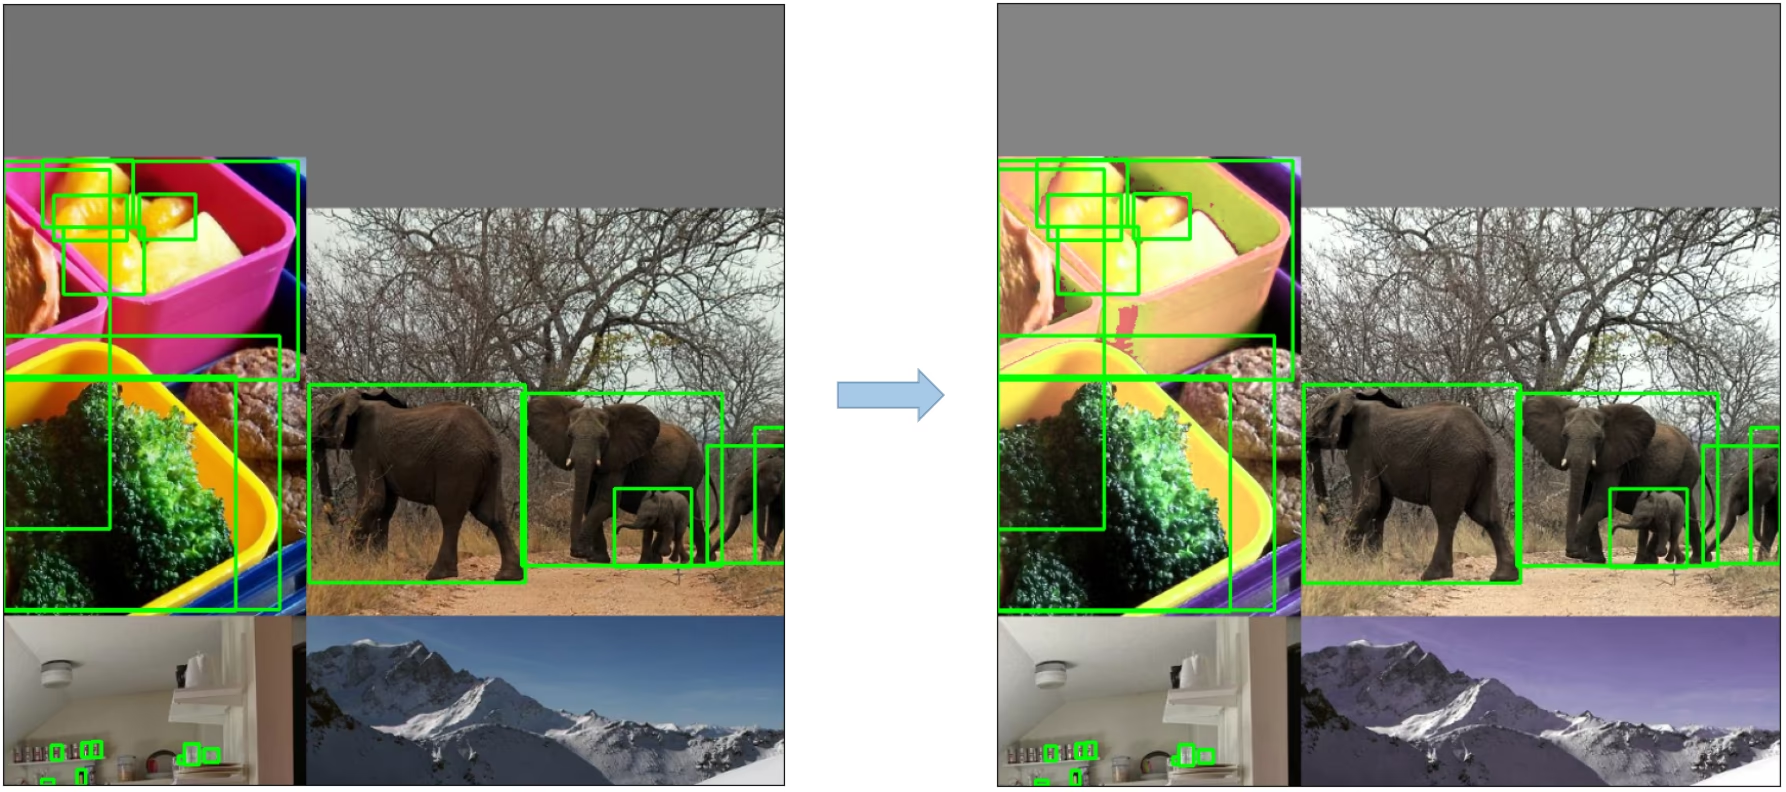
HSV 增强:随机调整图像的色相、饱和度和值。
-
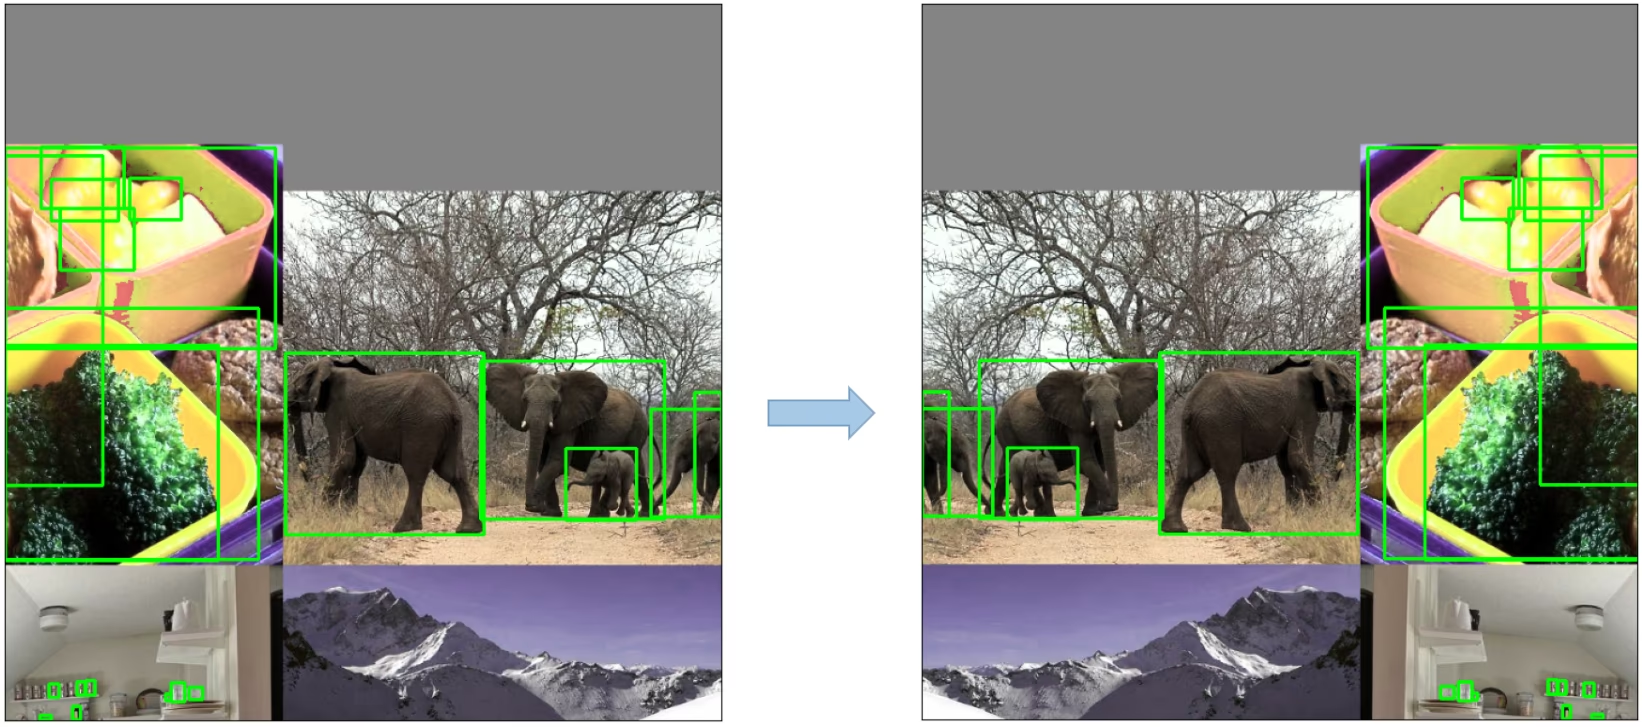
随机水平翻转:一种随机将图像沿水平方向翻转的数据增强方法。
3. 训练策略#
YOLOv5 使用多种先进的训练策略来提升模型性能,包括:
- 多尺度训练:在训练过程中,输入图像会在原始尺寸的 0.5 至 1.5 倍范围内随机缩放。
- AutoAnchor:此策略会优化先验锚框,使其符合自定义数据中真实框的统计特征。
- 预热和余弦 LR 调度器:一种调整学习率以提升模型性能的方法。
- 指数移动平均 (EMA):一种通过对过去各步骤的参数取平均来稳定训练过程并降低泛化误差的策略。
- 混合精度训练:一种使用半精度格式执行运算的方法,可减少内存占用并提升计算速度。
- 超参数演化:一种自动调节超参数以获得最佳性能的策略。请参阅超参数演化教程。
4. 其他功能#
4.1 计算损失#
YOLOv5 的损失由以下三个独立的损失项组合计算得出:
- 类别损失 (BCE Loss):二元交叉熵损失,用于衡量分类任务的误差。
- 目标性损失 (BCE Loss):另一种二元交叉熵损失,用于计算在特定网格单元中是否存在目标的检测误差。
- 位置损失 (CIoU Loss):完整 IoU 损失,用于衡量在网格单元内定位目标的误差。
整体损失函数如下所示:
4.2 平衡损失#
三个预测层(P3、P4、P5)的目标性损失采用不同权重。相应的平衡权重分别为 [4.0, 1.0, 0.4]。这种方法可确保不同尺度的预测对总损失做出适当贡献。
4.3 消除网格敏感性#
与早期 YOLO 版本相比,YOLOv5 架构对边界框预测策略做出了一些重要调整。在 YOLOv2 和 YOLOv3 中,边界框坐标是通过最后一层的激活值直接预测的。

不过,在 YOLOv5 中,边界框坐标预测公式经过了更新,以降低网格敏感性,并防止模型预测出无界的边界框尺寸。
修订后的边界框预测公式如下:
比较缩放前后的中心点偏移。中心点偏移范围从 (0, 1) 调整为 (-0.5, 1.5)。因此,偏移值可以轻松取到 0 或 1。

比较调整前后高度和宽度相对于锚框的缩放比例。原始的 yolo/darknet 边界框方程存在严重缺陷。宽度和高度完全不受限制,因为它们只是 out=exp(in),这很危险,可能导致梯度失控、训练不稳定、损失变为 NaN,最终使训练彻底失败。有关详情,请参阅此问题。

4.4 构建目标#
YOLOv5 中的目标构建流程对训练效率和模型准确率至关重要。该流程会将真实框分配给输出图中的相应网格单元,并与合适的锚框进行匹配。
此流程包括以下步骤:
- 计算真实框尺寸与每个锚框模板尺寸的比值。

- 如果计算出的比值在阈值范围内,就将真实框与相应的锚框匹配。

- 将匹配的锚框分配给相应的单元。请注意,由于中心点偏移经过修订,真实框可能会被分配给多个锚框:中心点偏移范围从 (0, 1) 调整为 (-0.5, 1.5),因此可以进行更多匹配。

通过这种方式,目标构建流程可确保训练期间每个真实目标都得到恰当分配和匹配,从而让 YOLOv5 更有效地学习目标检测任务。
结论#
YOLOv5 是实时目标检测发展历程中的重要进步。与早期 YOLO 版本相比,其架构设计、训练策略和工程改进带来了出色的性能和效率。
YOLOv5 的主要改进包括采用动态架构、大量数据增强技术和创新训练策略,以及对损失计算和目标构建流程进行重要调整。这些创新在保持 YOLO 模型标志性高速性能的同时,显著提升了目标检测的准确率和效率。
常见问题#
CSPDarknet53 主干网络负责提取特征,SPPF 和 PANet 颈部网络负责跨尺度融合特征,YOLOv3 风格的检测头则以 8、16 和 32 的步长预测边界框、目标性和类别。完整的层列表见
models/yolov5l.yaml。SPPF 将三个 5x5 最大池化操作串联起来,而不是并行执行 5x5、9x9 和 13x13 池化。输出在数学上完全相同,但运行速度是前者的两倍以上,正如上面的性能分析代码片段所示。
原始 YOLO 偏移值无法恰好达到 0 或 1,因此很难预测中心位于网格边界上的目标。将 sigmoid 缩放到 (-0.5, 1.5) 范围可消除这种网格敏感性,而对
2σ求平方会将宽度和高度的预测限制在锚框尺寸的 4 倍以内,从而避免无界指数函数导致的梯度失控。宽度和高度与边界框的比值在
anchor_t(默认值为 4.0)范围内的任何锚框都可匹配;扩展后的偏移范围还允许将边界框分配给相邻的两个网格单元。因此,单个目标可以产生多个正样本目标,从而加快收敛。