Ultralytics 平台#
Ultralytics Platform 是一个全面的端到端计算机视觉平台,可简化从数据准备到模型部署的整个 ML 工作流。该平台面向需要生产就绪的计算机视觉解决方案、又不希望面对基础设施复杂性的团队和个人。
什么是 Ultralytics Platform?#
Ultralytics Platform 将数据集管理与标注、实验跟踪、云端和远程训练、模型导出、专用推理端点以及部署监控整合到一个工作区中。该平台原生支持 YOLO26、YOLO11、YOLOv8 和 YOLOv5 模型。
工作流:上传 → 标注 → 训练 → 导出或部署#
该平台提供端到端工作流:
graph LR
    subgraph Data["📁 Data"]
        A[Upload]:::start --> B[Annotate]:::proc
    end
    subgraph Train["🚀 Train"]
        D[Configure]:::proc --> E[Train on GPU]:::proc
        E --> F[View Metrics]:::out
    end
    subgraph Deploy["🌐 Export or Deploy"]
        G[Export]:::proc
        H[Deploy Endpoint]:::proc --> I[Monitor]:::out
    end
    Data --> Train
    E --> G
    E --> H

    classDef start fill:#4CAF50,color:#fff
    classDef proc fill:#2196F3,color:#fff
classDef out fill:#9C27B0,color:#fff| 阶段 | 功能 |
|---|---|
| 上传 | 从你的计算机、URL、云存储或本地部署主机上传图像(50MB)、视频(1GB)和数据集文件(ZIP、TAR,包括 .tar.gz/.tgz、NDJSON) |
| 标注 | 针对 6 种任务类型的手动标注工具,外加支持 SAM 模型(适用于目标检测、图像分割、语义分割和定向边界框任务)或支持 YOLO 模型(适用于这些任务以及姿态估计)的智能标注(参见支持的任务类型) |
| 训练 | 云端 GPU(所有计划均提供 24 个,Pro/Enterprise 专属额外提供 2 个:B200、B300)、实时指标和项目组织功能 |
| 导出 | 20 种部署格式(ONNX、TensorRT、CoreML、LiteRT、Hailo、Ascend 等;参见支持的格式) |
| 部署 | 覆盖全球 42 个区域的专用端点,默认缩容至零(单个活动实例),并提供监控功能 |
你可以执行的操作:
- 上传图像、视频和数据集文件,创建训练数据集
- 使用交互式叠加层可视化标注,支持标注编辑器支持的 6 种 YOLO 任务类型(参见支持的任务类型)
- 在云端 GPU 上训练模型(所有计划均提供 24 个,Pro 或 Enterprise 提供 26 个,包括 B200 和 B300),并查看实时指标
- 导出为20 种部署格式(ONNX、TensorRT、CoreML、LiteRT、Hailo、Ascend 等)
- 通过一键式专用端点将模型部署到全球 42 个区域
- 构建连接模型、条件、数据集收集和 Slack 警报的智能体工作流
- 监控训练进度、部署运行状况和使用指标
- 通过集成连接云存储、标注工具和 Slack
- 通过向社区公开项目和数据集进行协作
多区域基础设施#
你的数据会保留在所在区域。Ultralytics Platform 在全球三个区域运营基础设施:
| 区域 | 标签 | 位置 | 最适用场景 |
|---|---|---|---|
| US | 美洲 | 美国爱荷华州 | 美洲用户,美洲地区速度最快 |
| EU | 欧洲、中东和非洲 | 欧洲比利时 | 欧洲用户,符合 GDPR |
| AP | 亚太地区 | 亚洲台灣 | 亚太地区用户,APAC 延迟最低 |
你可以在入门设置期间选择数据区域。数据集、模型和托管训练数据都会保留在该区域。 专用端点会单独部署到你从全球部署地图中选择的区域。
主要特性#
数据准备#
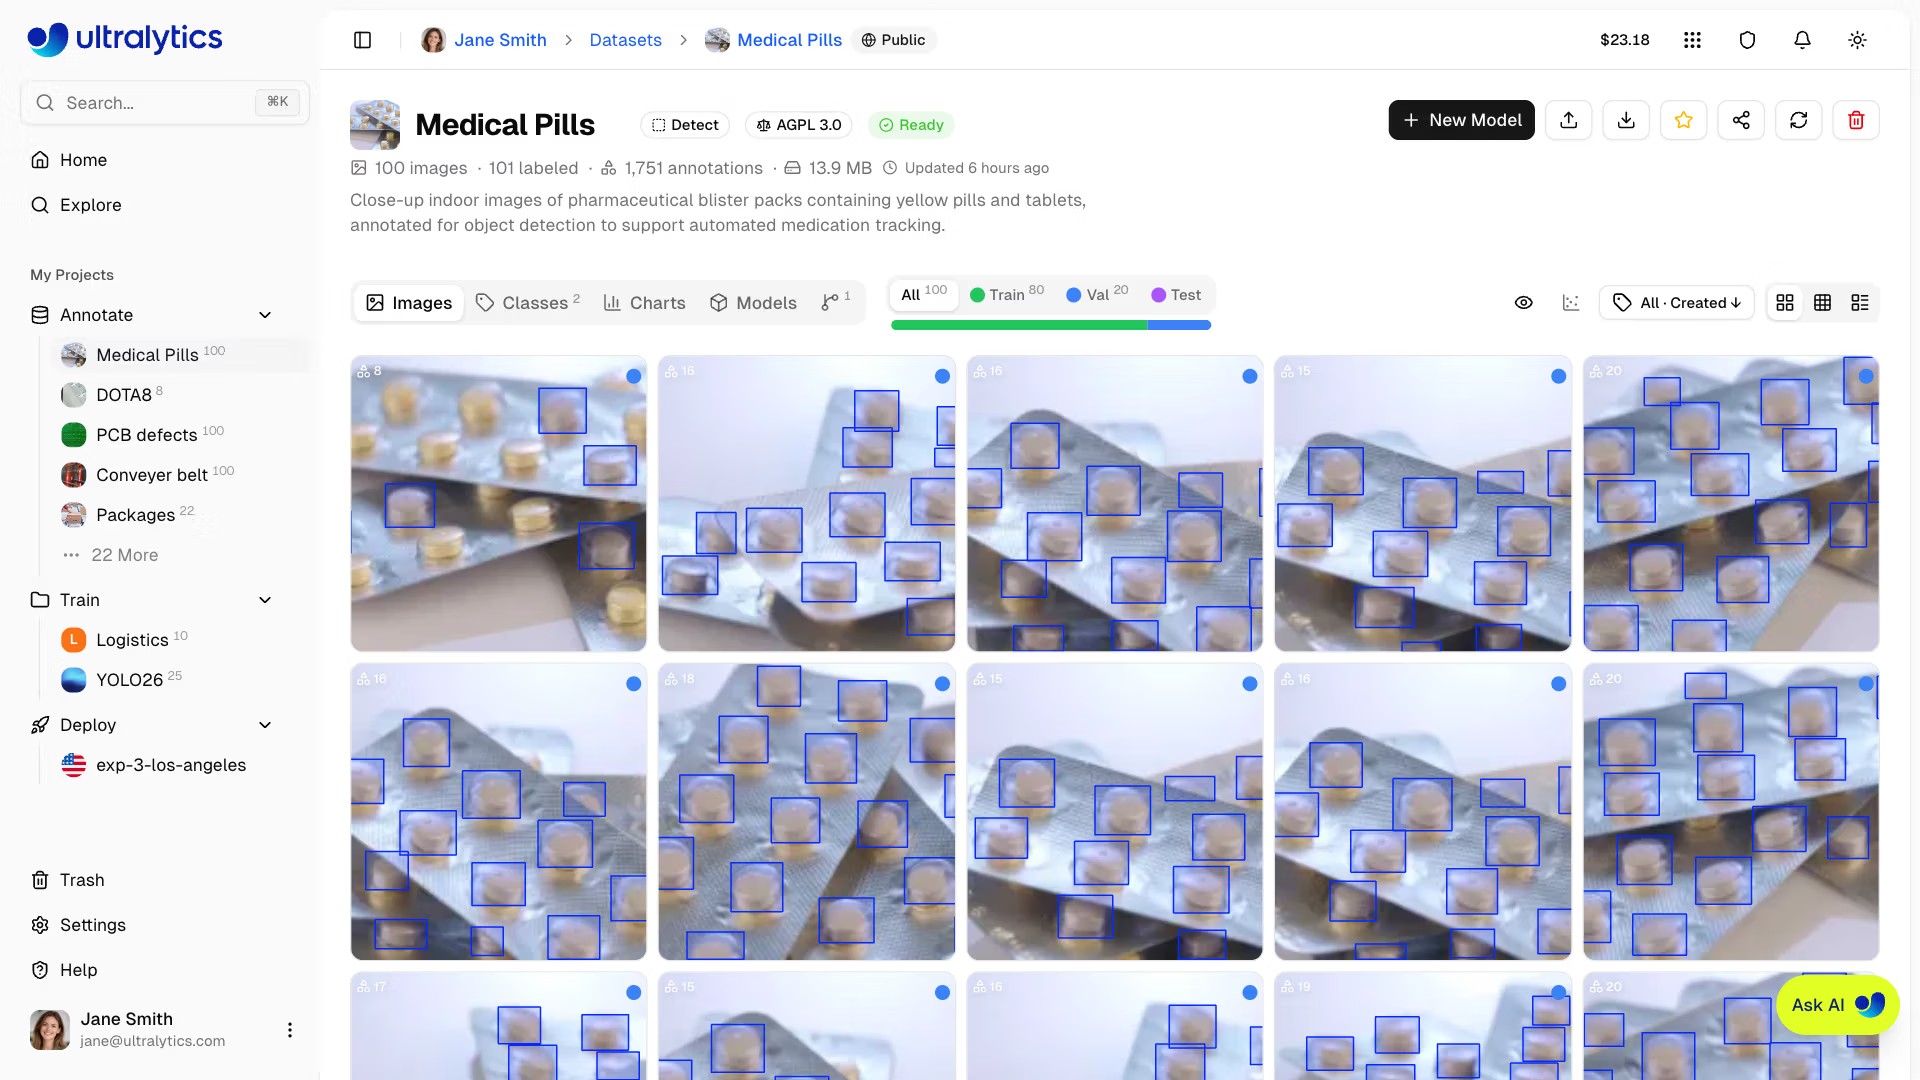
- 数据集管理:从本地文件、URL、已连接的云存储或本地部署主机创建数据集,并自动进行处理
- 标注编辑器:适用于 6 种 YOLO 任务类型的手动标注工具(检测、分割、语义分割、分类、姿态、OBB;参见支持的任务类型)
- 骨架模板:内置(人物、手部、狗、面部、方框)和自定义骨架模板,用于一键进行姿态标注
- 智能标注:从标注工具栏中使用 SAM 2.1(Tiny、Small、Base、Large)、SAM 3 或 SAM 3.1(默认)进行目标检测、图像分割、语义分割和定向边界框任务,或者使用预训练的 Ultralytics YOLO 模型和你自己微调的 YOLO 模型来完成这些任务及姿态估计
- 数据集版本控制:创建带有描述的编号 NDJSON 快照,然后下载或恢复任意版本,以实现可复现训练
- 统计信息:类别分布、划分分布、位置热力图和边界框尺寸分析
graph LR
    A[Upload Dataset/Images/Video]:::start --> B[Auto-Process]:::proc
    B --> C[Browse & Filter]:::proc
    C --> D{Annotate}:::decide
    D --> E[Manual Tools]:::proc
    D --> F[SAM Smart]:::proc
    D --> G[YOLO Auto-Label]:::proc
    E --> H[Train-Ready Dataset]:::out
    F --> H
    G --> H

    classDef start fill:#4CAF50,color:#fff
    classDef proc fill:#2196F3,color:#fff
    classDef decide fill:#FF9800,color:#fff
classDef out fill:#9C27B0,color:#fff模型训练#
- 云端训练:在云端 GPU 上训练(所有计划均提供 24 个,Pro 或 Enterprise 提供 26 个,包括 B200 和 B300),并查看实时指标和实时成本估算
- 远程训练:在任意位置训练,并将指标流式传输到 Ultralytics Platform
- 高级设置:在训练对话框的内置 YAML 编辑器中覆盖任意 Ultralytics 训练参数
- 项目组织:将相关模型分组、比较实验并跟踪活动
- 20 种导出格式:ONNX、TensorRT、CoreML、LiteRT、Hailo、Ascend 等(参见支持的格式)
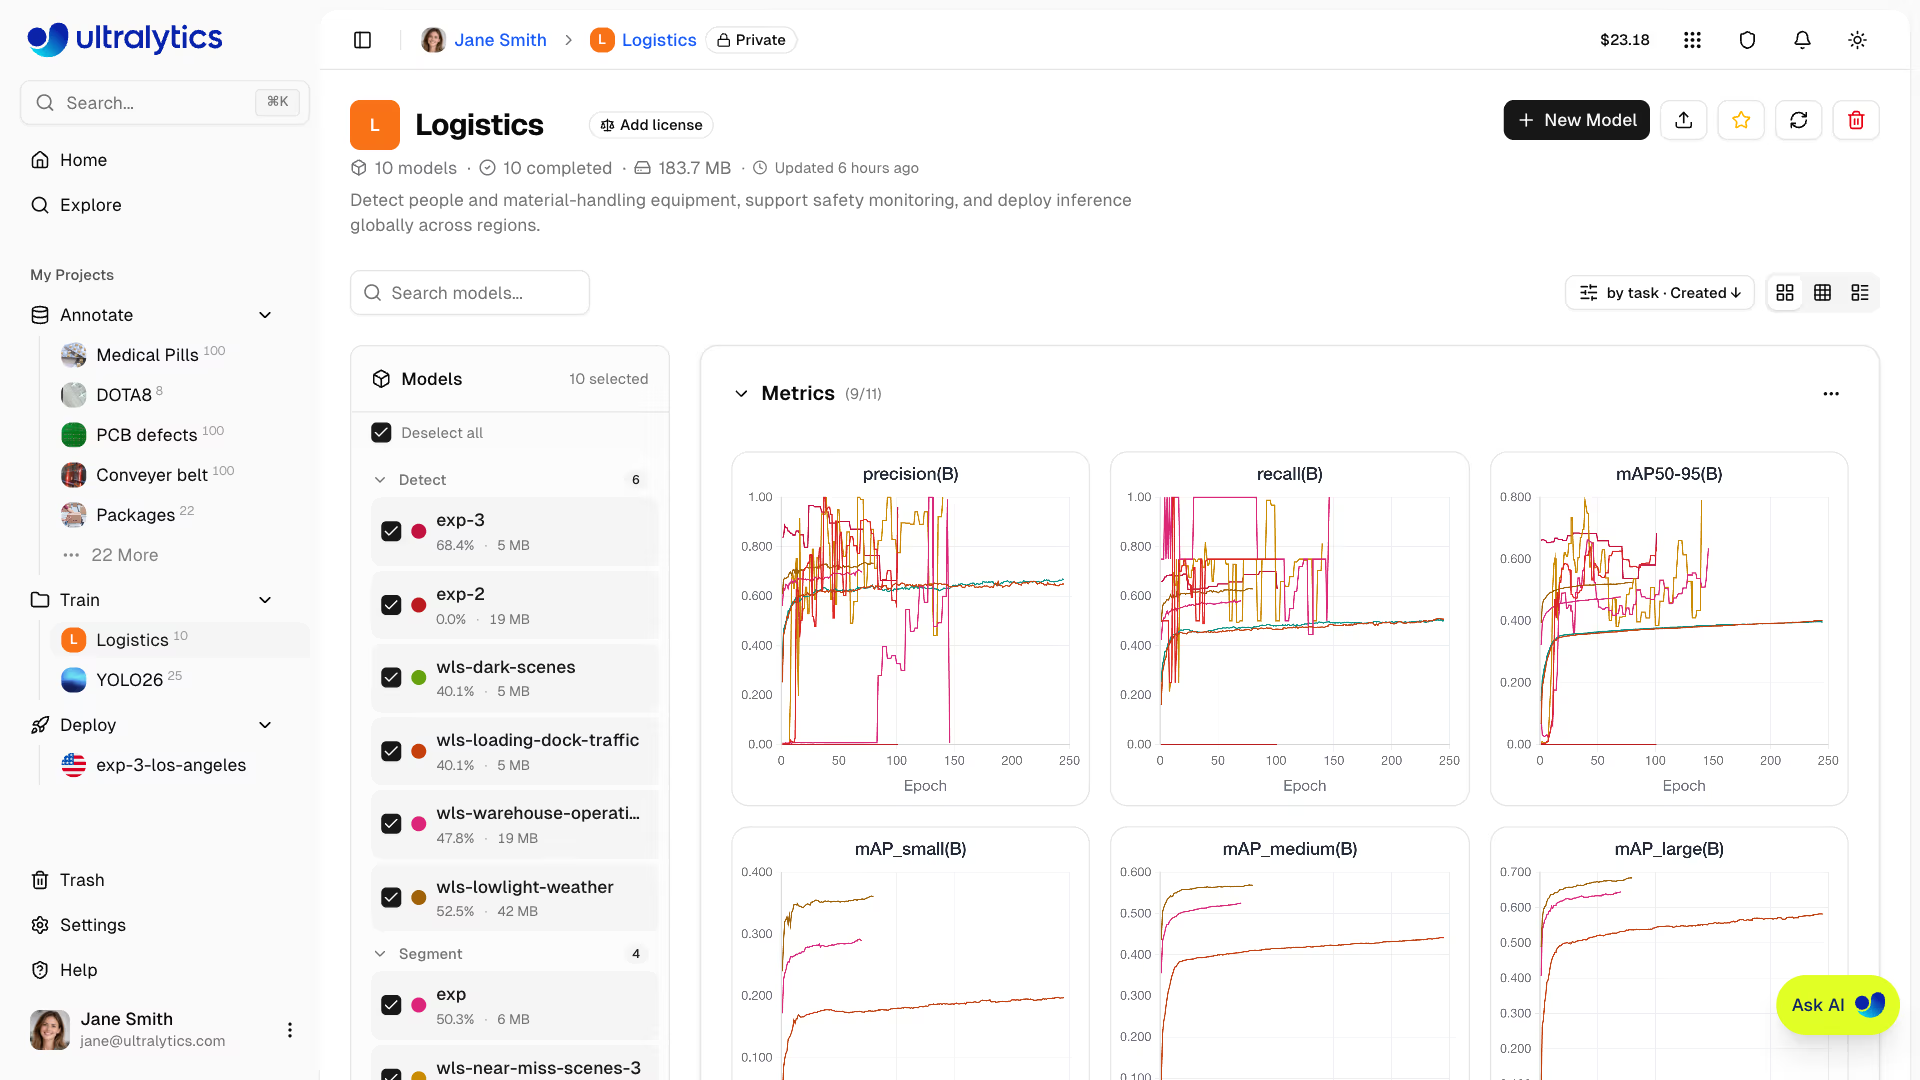
你可以通过网页界面(云端训练)或在你自己的机器上(远程训练)来训练模型:
- 进入你的项目
- 点击
New Model - 选择数据集、模型、GPU 和训练轮数
- 监控实时损失曲线和指标
部署#
- 推理测试:直接在浏览器中使用你自己的图像、网络摄像头拍摄内容或内置示例测试模型
- 专用端点:将模型部署到全球 42 个区域,默认缩容至零(单个活动实例)
- 监控:实时指标、请求日志和性能仪表板
graph LR
    A[Trained Model]:::start --> B{Action}:::decide
    B --> C[Browser Predict]:::proc
    B --> D[Export Format]:::proc
    B --> E[Deploy Endpoint]:::proc
    D --> F[ONNX / TensorRT / CoreML / LiteRT / ...]:::out
    E --> G[42 Global Regions]:::proc
    G --> H[API Endpoint URL]:::proc
    H --> I[Monitor & Scale]:::out

    classDef start fill:#4CAF50,color:#fff
    classDef proc fill:#2196F3,color:#fff
    classDef decide fill:#FF9800,color:#fff
classDef out fill:#9C27B0,color:#fff部署后,你可以使用任意语言调用端点。conf、iou 和 imgsz 是可选表单字段,默认值为
0.25、0.7 和 640:
import requests

url = "https://your-deployment-url.run.app/predict"
api_key = "YOUR_API_KEY"
args = {"conf": 0.25, "iou": 0.7, "imgsz": 640}

with open("image.jpg", "rb") as f:
    response = requests.post(
        url,
        headers={"Authorization": f"Bearer {api_key}"},
        data=args,
        files={"file": f},
    )

print(response.json())账户管理#
- 团队和组织:与团队成员协作、管理角色和邀请,并从账户菜单切换工作区
- API 密钥:用于远程训练和 API 访问的安全密钥管理
- 额度和账单:按量付费训练,价格透明,充值金额为 5 到 1,000 美元
- 活动源:跟踪所有账户事件和操作
- 回收站和恢复:支持 30 天软删除和项目恢复
- GDPR 合规性:数据导出和账户删除
有关当前限制、GPU 访问权限、协作功能和许可信息,请参见权威的 Free、Pro 和 Enterprise 对比。
快速链接#
通过以下资源开始使用:
- 快速入门:创建你的第一个项目,并在几分钟内训练模型
- 探索:浏览并克隆公开数据集和项目
- 数据:数据集准备概览
- 数据集:上传和管理训练数据
- 标注:使用手动和 AI 辅助工具标注数据
- 训练:训练概览
- 项目:组织模型和实验
- 模型:模型页面、下载和导出
- 云端训练:在云端 GPU 上训练
- 部署:部署概览
- 推理:测试模型
- 端点:将模型部署到生产环境
- 监控:跟踪部署性能
- 账户:账户概览
- 设置:个人资料和工作区偏好设置
- 团队:成员、角色和邀请
- API 密钥:管理 API 访问权限
- 账单:额度和付款
- 活动:跟踪账户事件
- 回收站:恢复已删除的项目
- 集成:云存储、标注工具和 Slack
- REST API:API 参考
故障排除#
数据集问题#
| 问题 | 解决方案 |
|---|---|
| 数据集无法处理 | 检查文件格式是否受支持(图像支持 JPEG、PNG、WebP、TIFF、HEIC、AVIF、BMP、JP2、DNG、MPO)。文件大小上限:图像 50 MB,视频 1 GB,数据集压缩包 Free 10 GB / Pro 20 GB / Enterprise 50 GB |
| 缺少标注 | 确认标签采用 YOLO 格式,且 .txt 文件名与图像文件名匹配,或上传 COCO JSON |
| “需要训练集划分” | 将 train/ 文件夹添加到数据集结构中,或通过划分栏重新分配数据集划分 |
| 未定义类别名称 | 添加包含 names: 列表的 data.yaml 文件(参见 YOLO 格式),或在类别选项卡中定义类别 |
训练问题#
| 问题 | 解决方案 |
|---|---|
| 训练无法开始 | 在“设置 > 账单”中检查额度余额。余额必须为正数 |
| 内存不足错误 | 减小批量大小,使用更小的模型(n/s),或选择 VRAM 更大的 GPU |
| 指标较差 | 检查数据集质量,增加训练轮数,尝试数据增强,并确认类别均衡 |
| 训练速度慢 | 选择更快的 GPU,减小图像尺寸,并检查数据集是否成为瓶颈 |
部署问题#
| 问题 | 解决方案 |
|---|---|
| 端点无响应 | 检查端点状态(Ready 或 Stopped)。闲置后的冷启动可能导致首次请求最多需要 ~45 秒 |
| 401 未授权 | 确认 API 密钥处于激活状态且复制正确 |
| 推理速度慢 | 检查模型大小,考虑 TensorRT 导出,并选择距离更近的区域 |
| 导出失败 | 某些格式需要特定的模型架构。若要获得最广泛的兼容性,请尝试 ONNX |
常见问题#
注册后可以更改用户名吗?
不可以,用户名是永久的,无法更改。注册时请谨慎选择。
可以更改数据区域吗?
数据区域在引导过程中选择,无法自行更改。如需切换区域,请联系支持团队申请更改区域。
如何获得更多额度?
前往 设置 > 账单,然后点击 充值。可购买 $5 至 $1,000 的额度。购买的额度永不过期。
如果训练失败,会发生什么?
如果云计算已启动,则会收取已用 GPU 时间的费用。GPU 启动前发生的失败不会产生计算使用费。
可以下载训练好的模型吗?
可以。在模型页面点击下载图标即可下载其 .pt 权重,或打开 导出 选项卡查看已完成的导出格式。
如何公开分享我的工作?
打开项目或数据集,点击顶部导航栏中的 Private 标记,然后确认 设为公开。公开内容会显示在探索页面上。
文件大小限制是多少?
图像:50MB;视频:1GB;数据集:Free 10GB、Pro 20GB、Enterprise 50GB。对于更大的文件,请拆分为多个上传内容。
已删除的项目会在回收站中保留多久?
30 天。之后项目会被永久删除,无法恢复。
可以将 Platform 模型用于商业用途吗?
Free 和 Pro 方案使用 AGPL 许可证。如需在不受 AGPL 要求限制的情况下进行商业使用,请参阅 Ultralytics 许可。
常见问题#
要开始使用 Ultralytics Platform:
- 注册:在 platform.ultralytics.com 创建账户
- 选择区域:在引导过程中选择数据区域(US、EU 或 AP)
- 上传数据集:在侧边栏中打开
Annotate,然后上传数据 - 训练模型:创建项目,并在云 GPU 上开始训练
- 部署:测试模型并将其部署到专用端点
如需详细指南,请参阅 快速入门页面。
Ultralytics Platform 支持多种用于云训练的 GPU 类型:
GPU 代次 VRAM 每小时费用 最适用场景 RTX 2000 Ada Ada 16 GB $0.24 小型数据集、测试 RTX A4500 Ampere 20 GB $0.25 小型至中型数据集 RTX 4000 Ada Ada 20 GB $0.26 中型数据集 RTX A5000 Ampere 24 GB $0.27 中型数据集 L4 Ada 24 GB $0.39 针对推理优化 A40 Ampere 48 GB $0.44 更大的批量大小 RTX 3090 Ampere 24 GB $0.46 通用训练 RTX A6000 Ampere 48 GB $0.49 大型模型 RTX PRO 4000 Blackwell 24 GB $0.57 经济型 Blackwell RTX PRO 4500 Blackwell 32 GB $0.64 出色的性价比 RTX 4090 Ada 24 GB $0.69 最佳性价比 RTX 6000 Ada Ada 48 GB $0.77 大批量训练 L40S Ada 48 GB $0.86 大批量训练 RTX PRO 5000 Blackwell 48 GB $0.96 大批量训练 RTX 5090 Blackwell 32 GB $0.99 最新消费级一代 L40 Ada 48 GB $0.99 大型模型 A100 PCIe Ampere 80 GB $1.39 生产训练 A100 SXM Ampere 80 GB $1.49 生产训练 RTX PRO 6000 Blackwell 96 GB $2.09 推荐默认选项 H100 PCIe Hopper 80 GB $2.89 高性能训练 H100 NVL Hopper 94 GB $3.19 最高性能 H100 SXM Hopper 80 GB $3.29 最快训练 H200 NVL Hopper 143 GB $3.39 最大内存 H200 SXM Hopper 141 GB $4.39 最高性能 B200 Blackwell 180 GB $5.89 大型模型(Pro+) B300 Blackwell 288 GB $7.39 最大型模型(Pro+) 完整的定价和 GPU 选项请参阅 云端训练。
你可以在自己的硬件上训练模型,并将实时指标流式传输到 Ultralytics Platform。
软件包版本要求平台集成需要 Python>=3.11 和 ultralytics>=8.4.120。较低版本将无法与平台配合使用。
pip install "ultralytics>=8.4.120"# Set your API key export ULTRALYTICS_API_KEY="YOUR_API_KEY" # Train with project/name to stream metrics yolo train model=yolo26n.pt data=coco.yaml epochs=100 project=username/my-project name=exp1有关远程训练的更多详细信息,请参阅 云端训练。
Platform 包含功能齐全的标注编辑器,支持:
- 手动工具:边界框、多边形、带骨架模板的关键点、定向框、分类
- 骨架模板:使用内置模板(Person、Hand、Dog、Face、Box)或自定义模板一次放置所有关键点
- 智能标注:使用 SAM 2.1、SAM 3 或 SAM 3.1(默认)在目标检测、图像分割、语义分割和定向边界框数据集中进行基于点击的标注,或者从工具栏运行预训练的 Ultralytics YOLO 模型和你自己微调的 YOLO 模型来完成这些任务及姿态估计
- 键盘快捷键:使用热键提高工作效率,快捷键列表显示在编辑器的快捷键弹出窗口中
快捷键 操作 V手动(绘制)模式 S智能模式(SAM 或 YOLO 模型) P预测(智能模式下) A切换自动应用(SAM 智能模式) 1-9按编号选择类别 H切换标注可见性 Space+ 拖动平移画布 Delete/Backspace删除选中的标注 Ctrl+S保存标注 Ctrl+Z撤销 Ctrl+Y重做 Escape保存 / 取消选择 / 退出 完整指南请参阅 标注。
Platform 支持与 Ultralytics 导出模式相同的 20 种部署格式。PyTorch 是源格式;每个包含
format参数的行都是导出目标。格式 format参数模型 元数据 参数 PyTorch - yolo26n.pt✅ - TorchScript torchscriptyolo26n.torchscript✅ imgsz、quantize、dynamic、nms、batch、deviceONNX onnxyolo26n.onnx✅ imgsz、quantize、dynamic、simplify、opset、nms、batch、data、fraction、deviceOpenVINO openvinoyolo26n_openvino_model/✅ imgsz、quantize、dynamic、nms、batch、data、fraction、deviceTensorRT engineyolo26n.engine✅ imgsz、quantize、dynamic、simplify、opset、workspace、nms、batch、data、fraction、deviceCoreML coremlyolo26n.mlpackage✅ imgsz、dynamic、quantize、nms、batch、deviceTF SavedModel saved_modelyolo26n_saved_model/✅ imgsz、keras、quantize、opset、nms、batch、data、fraction、deviceTF GraphDef pbyolo26n.pb❌ imgsz、opset、batch、deviceTF Edge TPU edgetpuyolo26n_edgetpu.tflite✅ imgsz、quantize、opset、data、fraction、devicePaddlePaddle paddleyolo26n_paddle_model/✅ imgsz、batch、deviceMNN mnnyolo26n.mnn✅ imgsz、batch、dynamic、quantize、simplify、opset、nms、deviceNCNN ncnnyolo26n_ncnn_model/✅ imgsz、quantize、batch、deviceIMX500 imxyolo26n_imx_model/✅ imgsz、quantize、data、fraction、nms、deviceRKNN rknnyolo26n_rknn_model/✅ imgsz、batch、name、quantize、simplify、opset、data、fraction、deviceExecuTorch executorchyolo26n_executorch_model/✅ imgsz、batch、deviceAxelera axelerayolo26n_axelera_model/✅ imgsz、batch、quantize、data、fraction、deviceDEEPX deepxyolo26n_deepx_model/✅ imgsz、quantize、simplify、opset、data、optimize、deviceQualcomm QNN qnnyolo26n_qnn.onnx✅ imgsz、batch、name、quantize、simplify、opset、data、fraction、deviceLiteRT litertyolo26n.tflite✅ imgsz、quantize、batch、data、fraction、deviceHailo hailoyolo26n_hailo_model/✅ imgsz、name、quantize、data、fraction、simplify、conf、iouHuawei Ascend ascendyolo26n_ascend_model/✅ imgsz、batch、name、quantize、opset、simplify、nmsApple Core AI coreaiyolo26n.aimodel✅ imgsz、batch、quantizenms=None默认对外部 NMS 使用原始输出。设置nms=False以选择可用的无 NMS 检测头;不支持的格式将回退到其本机输出路径。上面的nms条目标识了可以通过nms=True嵌入 NMS 的格式。