Ultralytics YOLO 模型的 Qualcomm QNN 导出#
要在 Qualcomm Snapdragon 设备上部署计算机视觉模型,需要使用针对 Qualcomm AI Engine Direct (QNN) 运行时调优的模型格式。将 Ultralytics YOLO模型导出为 QNN 格式后,你就能在 Snapdragon CPU、Adreno GPU 和 Hexagon NPU 硬件上运行加速的设备端推理。这些硬件广泛应用于数十亿部手机、笔记本电脑、汽车系统和 IoT 设备。本指南将介绍如何将 YOLO 导出为 Qualcomm QNN 格式,并部署到 Snapdragon 硬件上,以实现快速、低功耗推理。
官方 Ultralytics Flutter 插件提供可选的 QNN 支持,可通过实时摄像头推理和单图像预测处理全部七种 YOLO26 任务。按照插件 README 中的说明,启用 QNN 运行时并添加其 ONNX Runtime 依赖项。如需在 iOS 上部署,请参阅 Ultralytics YOLO iOS SDK和 CoreML 集成。
在 imgsz=224 导出分类模型。在 imgsz=640 导出检测、分割、语义、深度、姿势和 OBB 模型。这一 224/640 标准适用于官方 QNN、LiteRT 和 CoreML 移动端资产。 所有七种 nano 任务的即用型 v73 和 v81 资产均已发布在 yolo-flutter-app v0.6.6 版本中。
什么是 Qualcomm QNN?#
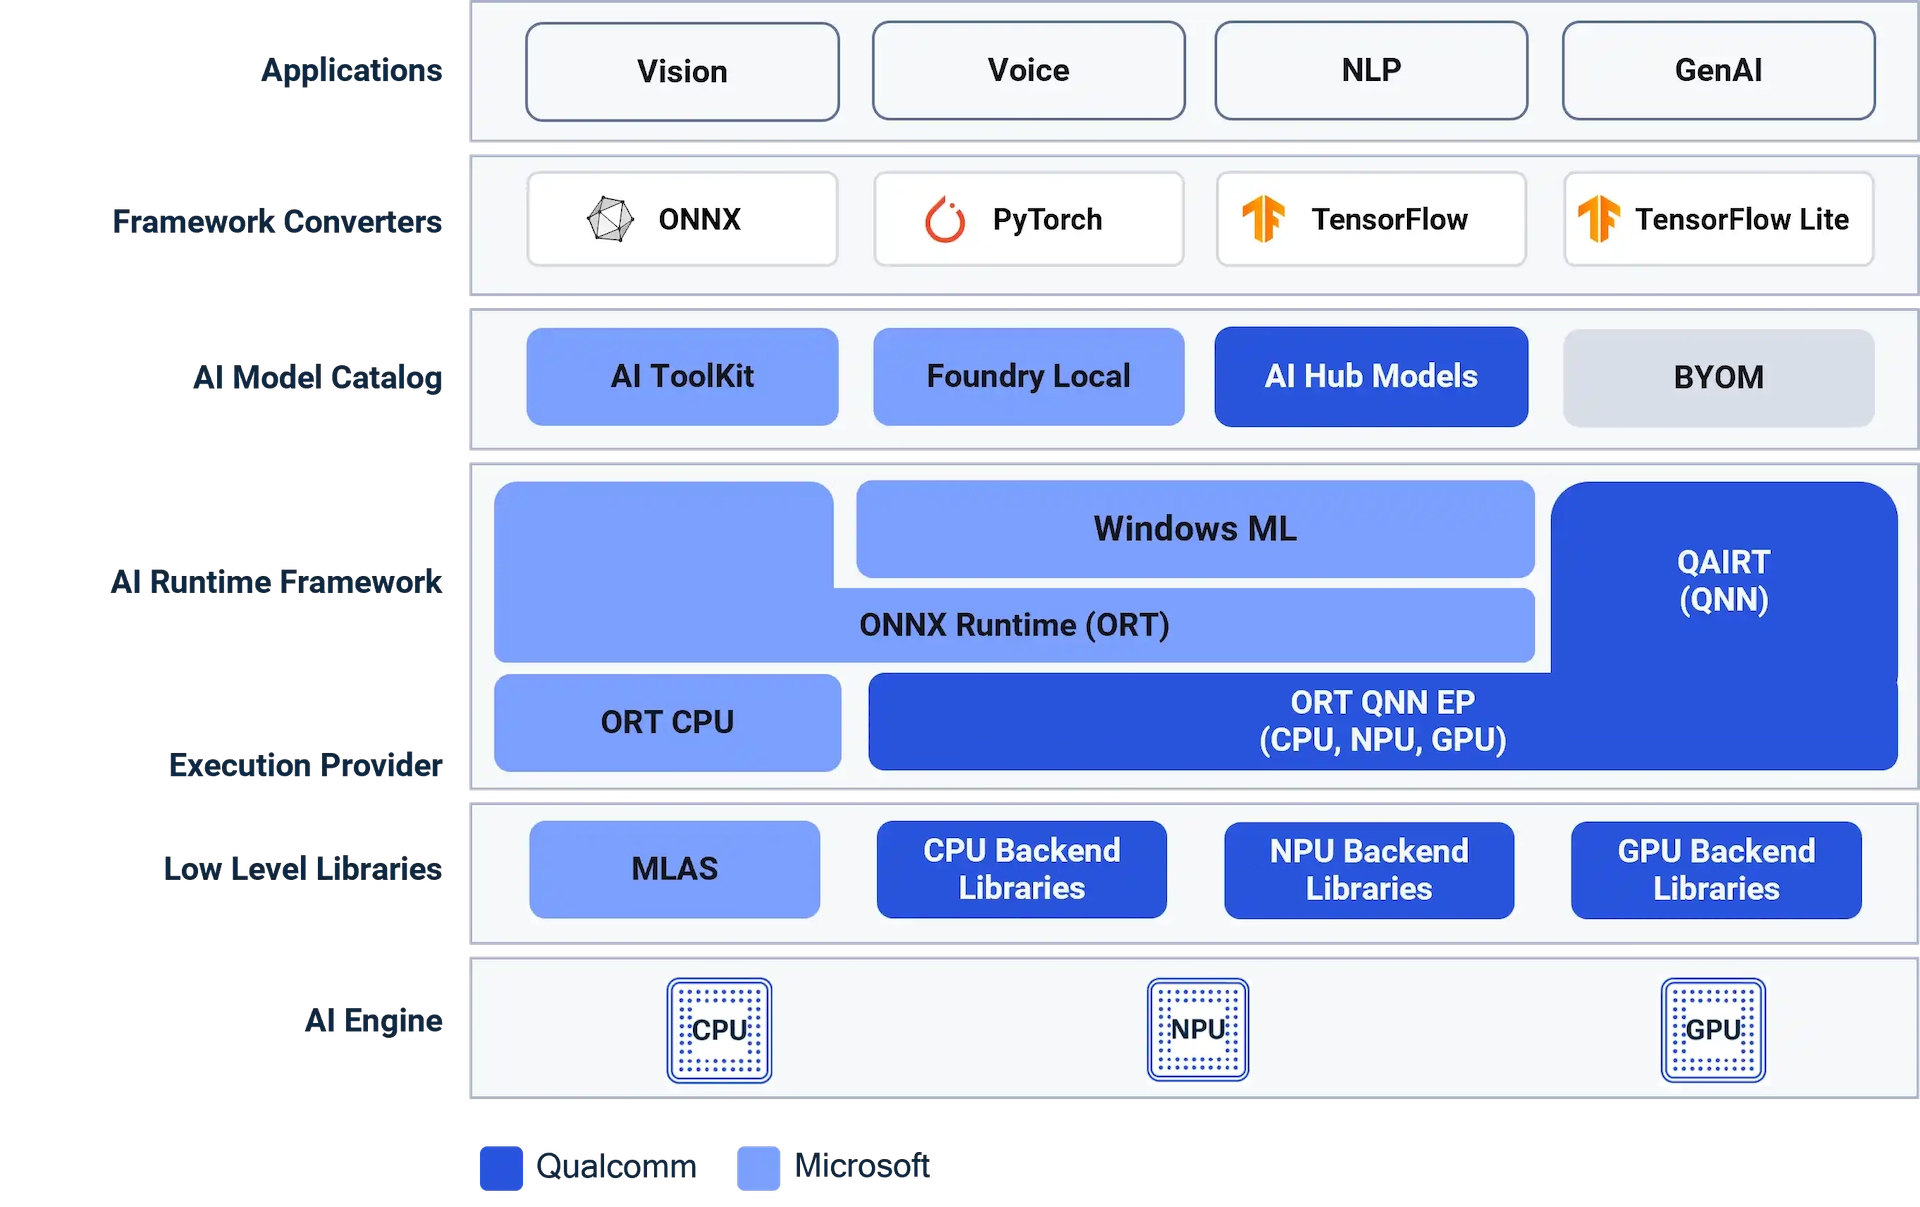
Qualcomm AI Engine Direct通常简称为 QNN,并作为 Qualcomm AI Runtime (QAIRT) SDK 的一部分发布,是 Qualcomm 面向 Snapdragon处理器的底层推理技术栈。它提供统一的 API 和特定于后端的库,可用于 Snapdragon CPU、Adreno GPU,以及现代 Snapdragon SoC 中专用的神经网络处理单元 (NPU) Hexagon Tensor Processor (HTP)。QNN 为开发者提供对 Snapdragon AI 加速器的全栈访问能力,是较早的 Snapdragon 神经处理引擎 (SNPE) SDK 的现代继任者。它为 Snapdragon 8 Gen 2、8 Gen 3 和 8 Elite 移动平台、Snapdragon X 笔记本电脑以及汽车和 XR 产品提供设备端 AI 支持。
为什么要导出为 Qualcomm QNN?#
Snapdragon 是全球部署最广泛的移动计算平台。将 Ultralytics YOLO 导出为 Qualcomm QNN 格式,即可充分利用这些设备上的专用 AI 硬件:
- Hexagon NPU 加速:在 Hexagon Tensor Processor 上运行 YOLO,吞吐量远高于 CPU 推理,功耗也更低,非常适合 Snapdragon 上的实时推理和常开式计算机视觉。
- 设备端运行,无需联网:QNN 推理完全在 Snapdragon 设备上运行,无需往返云端,延迟保持较低,数据也不会离开设备。
- 量化带来高效表现:QNN 导出会将 YOLO 量化为 INT8 权重和 16 位激活值,这种精度与性能平衡方式是 Hexagon NPU 的首选。此举可缩小模型体积,并在电池供电的硬件上最大限度提高每秒帧数。
- 一种格式,适用于多种设备:单次 Qualcomm QNN 导出即可适用于 Snapdragon 8 Gen 2、8 Gen 3、8 Elite 系列及后续产品中的 Snapdragon CPU、Adreno GPU 和 Hexagon NPU。
- 面向生产环境的 Qualcomm AI 技术栈:QNN (Qualcomm AI Engine Direct / QAIRT) 是 Qualcomm 当前积极维护的设备端 AI 运行时,也是 SNPE 的推荐替代方案。
QNN 导出格式#
Ultralytics 使用 ONNX Runtime QNN Execution Provider 在本地编译 YOLO 模型(可通过 pip 安装的 onnxruntime-qnn 包,其中包含 QAIRT 库)。导出器会将模型转换为 ONNX,使用校准数据将其量化为 16 位激活值和 INT8 权重(这是 Hexagon NPU 的推荐平衡配置),然后初始化启用了上下文二进制缓存的 ONNX Runtime 会话——此过程会将量化后的计算图编译为嵌入 <model>_qnn.onnx 的 QNN 上下文二进制文件。无需 Qualcomm 账户、云端上传或单独下载 SDK。
基于云端的 Qualcomm AI Hub会在 Qualcomm 托管的 Snapdragon 设备上编译和分析模型,并且需要 Qualcomm 账户;与之不同,Ultralytics QNN 导出完全在你自己的计算机上运行,只需调用一次 export(format="qnn", imgsz=640)(分类任务使用 imgsz=224)。你无需注册账户,也不受上传限制或排队时间影响,即可使用同一 QNN/QAIRT 运行时目标——Snapdragon CPU、Adreno GPU 和 Hexagon NPU;它还能直接融入标准 YOLO 导出工作流。
导出的 *_qnn.onnx 文件是自包含的:其中嵌入了 QNN 上下文二进制文件和 ONNX 元数据,例如类别名称、图像尺寸和任务类型。
QNN 模型的主要功能#
- 量化:模型通过 ONNX Runtime QNN QDQ 流程和校准数据集量化为 16 位激活值和 INT8 权重,这是 Hexagon NPU 推荐的精度与性能平衡配置。详细了解模型量化。
- 完全本地编译:上下文二进制文件完全在主机上生成,无需 Qualcomm 账户、API 令牌或云端上传。
- 充分利用 Snapdragon 加速能力:通过统一运行时在 Hexagon NPU (HTP)、Adreno GPU 或 CPU 上运行推理。
- 广泛覆盖设备:适用于多种 Snapdragon 平台,包括手机、PC(Windows on Snapdragon)、汽车、XR 和嵌入式产品。
- 预编译上下文二进制文件:随附上下文二进制文件可最大限度减少设备端计算图编译,从而降低目标设备上的模型加载延迟。
- 自包含输出:导出的 ONNX 文件包含预编译的 QNN 上下文二进制文件和元数据,便于直接部署。
实测性能#
Android 手机#
硬件:Xiaomi 17,配备 12 GB LPDDR5X 内存,运行 Android 16 / API 36。其 3 nm Snapdragon 8 Elite Gen 5 (SM8850) 具有 8 核 Qualcomm Oryon CPU(2 个主核心,最高 4.6 GHz;6 个性能核心,最高 3.62 GHz)、 Adreno GPU 和 Hexagon NPU (HTP v81)。
| 模型 | 任务 | 尺寸 (像素) | CPU w8a32 LiteRT (毫秒) | GPU w8a32 LiteRT (毫秒) | NPU QNN W8A16 (毫秒) |
|---|---|---|---|---|---|
| YOLO26n | 检测 | 640 | 52.2 1.8 / 48.1 / 2.4 | 15.8 2.3 / 8.9 / 4.6 | 10.7 1.8 / 6.7 / 2.2 |
| YOLO26n-seg | 分割 | 640 | 73.4 1.8 / 65.6 / 6.0 | 33.2 1.8 / 23.8 / 7.6 | 17.4 1.8 / 9.9 / 5.7 |
| YOLO26n-sem | 语义 | 640 | 61.2 1.8 / 51.1 / 8.3 | 34.2 1.8 / 24.0 / 8.3 | 11.5 1.8 / 7.1 / 2.6 |
| YOLO26n-depth | 深度 | 640 | 124.4 1.9 / 115.1 / 7.4 | 23.0 1.8 / 13.5 / 7.7 | 35.2 1.8 / 26.1 / 7.3 |
| YOLO26n-cls | 分类 | 224 | 4.4 0.4 / 4.0 / 0.0 | 3.1 0.8 / 2.1 / 0.2 | 1.2 0.6 / 0.6 / 0.0 |
| YOLO26n-pose | 姿态 | 640 | 57.4 1.8 / 53.8 / 1.8 | 16.6 2.7 / 10.1 / 3.9 | 10.9 1.8 / 7.0 / 2.0 |
| YOLO26n-obb | OBB | 640 | 50.3 1.8 / 47.2 / 1.4 | 11.7 1.8 / 7.8 / 2.0 | 8.6 1.8 / 5.7 / 1.1 |
- 速度数值为单图突发延迟——在
bus.jpg上完成 3 次预热运行后,取 15 次运行的平均值, 使用 Flutter 插件的0.6.10设备端基准测试 工具和标准化的v0.6.6资产进行测量。各任务的后端顺序在一次连续测试中轮换。原生 日志确认,所有 CPU 行均使用 LiteRT CPU/XNNPACK,所有 GPU 行均通过 LiteRT OpenCL (LITERT_CL) 执行完整计算图,所有 NPU 行均使用 QNN Hexagon HTP 后端。 - 详细的基准测试记录请参阅 Flutter 性能文档。
- 请在 LiteRT 集成中比较其他 Android 设备,并在 CoreML 集成中比较 Apple 设备。
搭载 Snapdragon 的 Windows 笔记本电脑#
这次历史测试使用了标准化之前的 v73 QNN 二进制文件;语义和 OBB 任务使用 1024px 输入。测试在一台配备 32 GB 内存、运行 Windows 11 的 Lenovo 笔记本电脑上进行。其 Snapdragon X Elite (X1E78100) 配备 12 核 Qualcomm Oryon CPU、Adreno GPU 和 Hexagon NPU (HTP v73);未记录具体 Lenovo 型号。这项 Windows on Snapdragon 对比测试将原生 PyTorch FP32 CPU 基准(大多数桌面 开发者的起点)与 ONNX Runtime QNN Hexagon HTP 路径进行比较。每个单元格显示完整的 model.predict() 总耗时,其下方列出报告的预处理 / 推理 / 后处理耗时; 总耗时可能包含这三个阶段以外的框架开销。CPU 数值为 PyTorch FP32 (torch==2.10.0+cpu), NPU 数值为 ONNX Runtime QNN (onnxruntime-qnn==2.2.0,INT8 权重 / 16 位激活值)。
| 模型 | 任务 | 尺寸 (像素) | CPU PT FP32 (毫秒) | NPU Hexagon QNN W8A16 (毫秒) |
|---|---|---|---|---|
| YOLO26n | 检测 | 640 | 91.4 4.3 / 75.2 / 0.1 | 27.2 4.9 / 19.4 / 0.9 |
| YOLO26n-seg | 分割 | 640 | 138.8 4.5 / 127.1 / 2.8 | 34.3 5.0 / 24.0 / 5.1 |
| YOLO26n-sem | 语义 | 1024 | 295.8 9.1 / 189.2 / 94.8 | 133.0 8.8 / 37.4 / 83.9 |
| YOLO26n-cls | 分类 | 224 | 15.4 3.0 / 9.8 / 0.0 | 11.7 2.7 / 5.5 / 0.0 |
| YOLO26n-pose | 姿态 | 640 | 109.6 4.6 / 102.9 / 0.2 | 28.9 5.3 / 23.3 / 0.6 |
| YOLO26n-obb | OBB | 1024 | 267.8 8.1 / 254.6 / 0.1 | 64.8 8.9 / 54.7 / 0.6 |
- Speed 数值是单张图像突发延迟——在
bus.jpg上预热运行 10 次后,再运行 100 次取平均值;使用time.perf_counter()测量完整的model.predict()调用,设备经过热稳定处理(ultralytics==8.4.67,Python 3.12.10)。 - 在 640-1024 px 的任务中,Hexagon NPU 的运行速度大约比 PyTorch CPU 基准快 2-4 倍(检测任务约快 ~3.4 倍);而在 224 px 分类任务中,由于固定预处理开销在微小工作负载中占主导,优势缩小到约 ~1.3 倍。
支持的任务#
Qualcomm QNN 导出支持全部七种 Ultralytics 任务。语义分割和深度估计仅适用于 YOLO26,它是唯一提供这两种任务头的系列。
导出到 QNN:转换你的 YOLO 模型#
将 Ultralytics YOLO 模型导出为 QNN 格式,以便部署到 Qualcomm 硬件。上下文二进制文件会针对目标 Hexagon Tensor Processor (HTP) 架构或支持的 SoC 完成编译,你可以通过 name 参数选择目标——该参数也用于在 RKNN 导出时指定芯片。
支持的 HTP 目标#
通过 name 传入目标架构或 SoC(例如 name="73" 或 name="iq-8275")。支持情况取决于 HTP 目标,因此下表中的 Snapdragon 机型仅代表部分平台,并未穷举所有 SoC。 Dragonwing 设备会逐一列出。
| 状态 | name | Hexagon HTP | 示例设备或平台 |
|---|---|---|---|
| ✅ 支持 | 68 | v68 | Snapdragon 888 |
| ✅ 支持 | 69 | v69 | Snapdragon 8 Gen 1 / 8+ Gen 1 |
| ✅ 支持 | 73 | v73 | Snapdragon 8 Gen 2、X Elite(默认) |
| ✅ 支持 | 75 | v75 | Snapdragon 8 Gen 3 |
| ✅ 支持 | 79 | v79 | Snapdragon 8 Elite |
| ✅ 支持 | 81 | v81 | Snapdragon 8 Elite Gen 5 |
| ✅ 支持 | iq-8275 或 qcs8275 | v75 | Dragonwing IQ-8275 / QCS8275(QNN SoC 型号 82) |
| ❌ 不支持 | — | v66 | Dragonwing IQ-615 / QCS615 |
Dragonwing IQ-615 无法使用 Ultralytics QNN 上下文二进制导出,因为 ONNX Runtime 不会将其 v66 DSP 暴露为 离线 HTP 目标。你仍然可以单独集成标准 ONNX 导出,并使用开发板 BSP 支持的 CPU 或 GPU 执行提供程序。
from ultralytics import YOLO

model = YOLO("best.pt")
model.export(format="qnn", name="iq-8275", imgsz=640)QNN 导出使用 onnxruntime-qnn 软件包。2.4.0 及更高版本为 Python 3.11 或更高版本提供预构建 wheel,支持 Windows (x64 和 ARM64) 及 Linux (x86-64 和 ARM64);macOS 不是受支持的 QNN 主机平台。QNN 上下文二进制生成在 x64 主机上运行,导出时不需要 Snapdragon 设备。
安装#
运行以下命令安装所需的软件包:
# Install the required package for YOLO
pip install ultralytics
首次导出时会自动安装 onnxruntime-qnn 软件包(提供 ONNX Runtime QNN Execution Provider 并捆绑 QAIRT 库)。有关安装流程的详细说明和最佳实践,请参阅我们的 Ultralytics 安装指南。为 YOLO 安装所需软件包时,如果遇到问题,请查阅我们的常见问题指南,获取解决方案和建议。
用法#
QNN 格式支持导出、预测和验证模式。推理和验证通过 ONNX Runtime 的 QNN Execution Provider(导出时使用的同一个 onnxruntime-qnn 软件包)在 Qualcomm Snapdragon 硬件上运行。导出模型后,将导出的模型加载到 Snapdragon 设备上,即可进行推理或验证准确率。
from ultralytics import YOLO

# 加载 YOLO26 模型
model = YOLO("yolo26n.pt")

# 导出为 Qualcomm QNN 格式(自动强制使用 INT8),目标为默认的 v73 HTP
model.export(format="qnn", name="73", imgsz=640) # 分类任务使用 imgsz=224from ultralytics import YOLO
# 加载导出的 QNN 模型(在安装了 onnxruntime-qnn 的 Snapdragon 设备上)
model = YOLO("yolo26n_qnn.onnx")
# 运行推理
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# 加载导出的 QNN 模型(在安装了 onnxruntime-qnn 的 Snapdragon 设备上)
model = YOLO("yolo26n_qnn.onnx")
# 在 COCO8 数据集上验证准确率
metrics = model.val(data="coco8.yaml")导出参数#
| 参数 | 类型 | 默认值 | 说明 |
|---|---|---|---|
format | str | 'qnn' | 导出模型的目标格式,用于定义其与 Qualcomm QNN 运行时的兼容性。 |
imgsz | int 或 tuple | 640 | 模型输入所需的图像尺寸。可以是表示正方形图像的整数,也可以是元组 (height, width)。 |
batch | int | 1 | 指定导出模型的批次大小,该值会固化到生成的 QNN 上下文二进制文件中。 |
name | str | '73' | 目标 Hexagon HTP 架构(68、69、73、75、79 或 81)或支持的 SoC(iq-8275 或 qcs8275)。上下文二进制文件会针对该目标完成编译。 |
quantize | int 或 str | 'w8a16'/自动 | 量化精度。QNN HTP 导出会将权重量化为 INT8,并使用 16 位激活值('w8a16');如果未指定,则自动启用。替代已弃用的 half/int8 标志。 |
simplify | bool | True | 使用 onnxslim 简化中间 ONNX 图。 |
opset | int | None | 指定中间 ONNX 图的 ONNX opset 版本。若未设置,则使用最新的受支持版本。 |
data | str | None | 用于 INT8 校准的数据集 YAML;分类任务则使用数据集目录或内置数据集名称。如果省略,Ultralytics 会为该模型任务选择默认校准数据集。 |
fraction | float、int 或 list | 1.0 | 校准子集,可按比例、图像数量或 [train, val, test] 比例/数量指定。包含两个项目的列表会让 test 保持完整,而 0 会跳过它。 |
device | str | None | 指定 ONNX 导出步骤所用的设备:GPU(device=0)或 CPU(device=cpu)。 |
QNN 导出会将模型量化为 16 位激活值和 INT8 权重——这是 Hexagon NPU 推荐的精度与性能平衡配置——使用来自 data 的校准图像,并通过 ONNX Runtime QDQ 量化流程完成。quantize='w8a16' 会自动强制启用。
有关导出流程的更多详情,请访问 Ultralytics 导出文档页面。
输出结构#
成功导出后,会创建一个独立的 ONNX 文件:
yolo26n_qnn.onnx # ONNX wrapping the precompiled QNN context binary and metadata
yolo26n_qnn.onnx 文件内嵌 QNN 上下文二进制文件,并由 Snapdragon 设备上的 ONNX Runtime QNN Execution Provider 加载。该文件还会在 ONNX metadata_props 中携带类别名称、图像尺寸和任务等模型元数据。
部署导出的 YOLO QNN 模型#
QNN 模型可在受支持的 Qualcomm 硬件上运行,因此模型部署非常简单。在安装了 onnxruntime-qnn 的兼容设备上,直接使用 Ultralytics API(yolo predict/yolo val,参见上文用法)运行导出的模型即可——Ultralytics 会通过 ONNX Runtime QNN Execution Provider加载 HTP 上下文二进制文件。
对于自定义流水线,你也可以直接使用 ONNX Runtime 加载上下文二进制 ONNX 文件。onnxruntime-qnn 是一个插件式 Execution Provider,因此需要在运行时注册:
import onnxruntime as ort
import onnxruntime_qnn as qnn_ep

# 在 Snapdragon 设备上注册 QNN 插件 EP 并选择其设备
ort.register_execution_provider_library("QNNExecutionProvider", qnn_ep.get_library_path())
devices = [d for d in ort.get_ep_devices() if d.ep_name == "QNNExecutionProvider"]

options = ort.SessionOptions()
options.add_provider_for_devices(devices, {"backend_path": qnn_ep.get_qnn_htp_path()})
session = ort.InferenceSession("yolo26n_qnn.onnx", sess_options=options)
input_info = session.get_inputs()[0]
outputs = session.run(None, {input_info.name: input_tensor})  # input_tensor: float32 NHWC
由于 QNN 上下文二进制文件已经预编译,会话可以快速加载,无需在设备上重新编译计算图。
Linux 和 Yocto BSP 要求#
目标开发板必须提供相互兼容的 Qualcomm 运行时和 BSP。对于 HTP 推理,这包括 ONNX Runtime QNN Execution Provider、libQnnSystem.so、libQnnHtp.so、IQ-8275 的 v75 HTP stub 和 skeleton 库、FastRPC 用户空间支持(例如 libcdsprpc.so)、DSP 固件,以及相应的 FastRPC/内核驱动程序。BSP 的 DSP 库路径必须能够找到 skeleton 库。
这些目标端组件由开发板供应商提供,包含在启用了 QAIRT/QNN 的 BSP 中;它们不会嵌入导出的模型。GPU 执行则需要 libQnnGpu.so 和匹配的 Adreno 用户空间驱动程序栈。Ultralytics 的 format=qnn 输出是专用于 HTP 的上下文二进制文件,因此 GPU 或 CPU 部署应从标准 ONNX 导出开始,而不是使用预编译的 *_qnn.onnx 文件。
推荐工作流#
- 使用 Ultralytics 训练模式训练模型
- 在受支持的平台上使用
model.export(format="qnn", name="iq-8275", imgsz=640)导出为 QNN 格式(分类任务使用imgsz=224) - 将导出的
*_qnn.onnx文件部署到 Qualcomm 设备 - 使用 ONNX Runtime 和 QNN Execution Provider,通过 HTP 后端运行推理
实际应用#
在 Qualcomm Snapdragon 硬件上运行的 YOLO 模型非常适合各种边缘 AI应用:
- 智能手机:借助 NPU 加速,在相机和照片应用中实时进行目标检测和场景理解。
- 搭载 Snapdragon 的 Windows 设备:在 Copilot+ PC 上运行设备端计算机视觉,无需将任务交给云端处理。
- 汽车:在 Snapdragon Digital Chassis 平台上实现驾驶员监控、乘员检测和 ADAS 功能。
- XR 和可穿戴设备:为 AR/VR 头显和智能眼镜提供低功耗、低延迟的感知能力。
- IoT 和机器人:在搭载 Snapdragon 的摄像头、无人机和嵌入式系统上高效运行视觉推理。
总结#
在本指南中,你已了解如何通过 ONNX Runtime QNN Execution Provider,在本地将 Ultralytics YOLO 模型导出为 Qualcomm QNN 格式。导出流水线会先将模型转换为 ONNX,再在主机上编译成 QNN 上下文二进制文件——无需 Qualcomm 账户或云服务——生成针对 Snapdragon CPU、Adreno GPU 和 Hexagon NPU 硬件优化的 *_qnn.onnx 文件,并通过 QNN/QAIRT 运行时运行。
Ultralytics YOLO 与 Qualcomm 设备端 AI 技术栈相结合,为在广泛的 Snapdragon 生态系统中运行先进的计算机视觉工作负载提供了有效方案。
对于其他设备端和移动部署目标,请参阅相关的 ONNX、CoreML、NCNN、LiteRT、ExecuTorch、RKNN、Sony IMX500和 TensorRT导出指南。发布前若要比较格式,请使用基准测试模式。如需查看完整的格式和选项列表,请访问导出模式文档和集成指南页面。
常见问题#
你可以使用
export(format="qnn", imgsz=640)(分类任务使用imgsz=224)或对应的 CLI 参数导出模型。导出时会先创建 ONNX 模型,然后使用 ONNX Runtime QNN Execution Provider 在本地将其编译为 QNN 上下文二进制文件。首次导出时会自动安装onnxruntime-qnn软件包。示例from ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="qnn", imgsz=640) # 分类任务使用 imgsz=224不需要。QNN 导出完全在你的本地计算机上运行,使用的是捆绑 QAIRT 库的
onnxruntime-qnn软件包。无需 Qualcomm 账户、API 令牌或网络访问权限。Qualcomm AI Hub 是 Qualcomm 提供的云服务,可在托管的 Snapdragon 设备上编译、分析和基准测试模型,并且需要 Qualcomm 账户。Ultralytics QNN 导出面向相同的 QNN/QAIRT 运行时(Snapdragon CPU、Adreno GPU 和 Hexagon NPU),但会通过 ONNX Runtime QNN Execution Provider 在本地编译上下文二进制文件——无需账户、上传或排队。从
.pt模型直接在标准 YOLO 导出工作流中生成可用于 Snapdragon 的构建版本,这是最快捷的方式。onnxruntime-qnn2.4.0 及更高版本为 Python 3.11 或更高版本提供预构建 wheel,支持 Windows (x64 和 ARM64) 及 Linux (x86-64 和 ARM64);macOS 不是受支持的 QNN 主机平台。上下文二进制文件生成在 x64 主机上运行,无需实体 Snapdragon 设备。使用
model.export(format="qnn", imgsz=640)导出(分类任务使用imgsz=224),将生成的yolo26n_qnn.onnx文件复制到 Snapdragon 设备,然后运行yolo predict model=yolo26n_qnn.onnx source=image.jpg(或yolo val)。Ultralytics 会通过 ONNX Runtime QNN Execution Provider 加载上下文二进制文件,并在 Hexagon NPU 上运行——请参阅 部署导出的 YOLO QNN 模型。QNN(Qualcomm AI Engine Direct,属于 QAIRT SDK)是 Qualcomm 当前的推理技术栈,也是旧版 Snapdragon Neural Processing Engine (SNPE) SDK 的推荐替代方案。新的部署应使用 QNN。
可以,在安装了
onnxruntime-qnn的 Qualcomm Snapdragon 设备上运行即可——YOLO("yolo26n_qnn.onnx")会通过 QNN Execution Provider 加载上下文二进制文件,并像其他格式一样运行predict/val。在没有 QNN 硬件的 x86 主机上,模型无法执行,因为上下文二进制文件是针对 Snapdragon NPU 编译的。导出会生成一个独立的上下文二进制 ONNX 文件(例如
yolo26n_qnn.onnx),其中的 ONNXmetadata_props嵌入了类别名称、图像尺寸、任务和其他模型元数据。