使用 Ultralytics YOLO 进行单目深度估计#
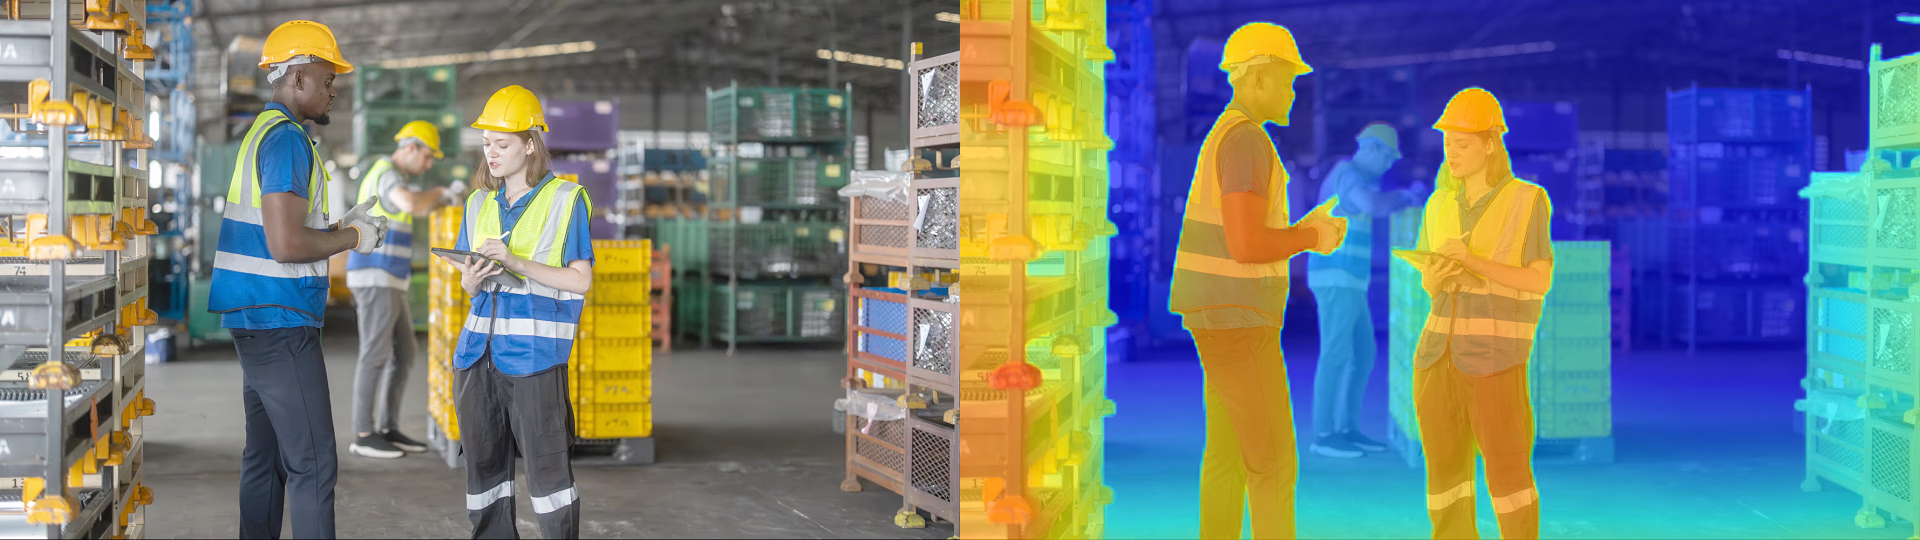
单目深度估计根据单张 RGB 图像预测逐像素深度图。每个输出像素都包含一个以米为单位的深度值,表示从相机到该表面点的估计距离。
深度模型的输出是一个与输入图像对齐、形状为 (H, W) 的稠密浮点图。逐像素表示使单目深度估计适用于 3D 场景重建、机器人导航、AR/VR 内容创作,以及任何需要根据单个摄像头获取空间布局信息的应用。
观看: 使用 Ultralytics YOLO26 进行单目深度估计 | Python 教程 | Vision AI 🚀
进行单目深度估计时,使用 task=depth 或 CLI 的 yolo depth 任务。YOLO26 深度模型文件使用 -depth 后缀,例如 yolo26n-depth.pt。
模型#
下方展示了使用广泛的多数据集组合(室内 + 室外,~219 万张图像)预训练的 YOLO26 深度模型。指标列是在 NYU Depth V2 Eigen 测试集划分上报告的。
首次使用时,模型会自动从 Ultralytics 最新版本下载。
| 模型 | 尺寸 (像素) | delta1NYU | abs_relNYU | rmseNYU | 速度 CPU ONNX (毫秒) | 速度 T4 TensorRT10 (ms) | 参数 (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|---|
| YOLO26n-depth | 768 | 0.882 | 0.109 | 0.414 | 272.0 ± 27.2 | 2.7 ± 0.1 | 6.3 | 46.9 |
| YOLO26s-depth | 768 | 0.896 | 0.104 | 0.399 | 393.7 ± 13.1 | 3.8 ± 0.0 | 13.2 | 68.0 |
| YOLO26m-depth | 768 | 0.921 | 0.089 | 0.364 | 621.5 ± 49.7 | 6.0 ± 0.1 | 23.3 | 130.4 |
| YOLO26l-depth | 768 | 0.930 | 0.083 | 0.351 | 821.9 ± 50.7 | 7.7 ± 0.1 | 27.7 | 157.0 |
| YOLO26x-depth | 768 | 0.933 | 0.080 | 0.344 | 1240.9 ± 73.3 | 13.6 ± 0.2 | 57.0 | 301.7 |
- delta1NYU 表示在 NYU Depth V2 Eigen 测试集划分(654 张图像)上,预测深度与真实深度的差距在 1.25 倍以内的像素比例;评估采用多尺度 + 水平翻转 TTA 和对数最小二乘对齐。
- 使用
yolo depth val model=yolo26n-depth.pt data=nyu-depth.yaml imgsz=768 device=0可复现不带 TTA 的单尺度准确率(将每种尺寸对应替换为model=);该方法使用中位数(仅缩放)对齐,得分较低:delta1 分别为 0.783(n)、0.793(s)、0.840(m)、0.853(l)和 0.860(x)。 - abs_rel 是预测深度值与真实深度值之间的平均绝对相对误差。
- rmse 是以米为单位的均方根误差。
- 速度是仅推理延迟(不包括预处理和后处理),在
imgsz=768、batch=1下测得,数值为预热后多次计时运行的均值 ± 标准差。CPU ONNX 是在 32 核 Intel Xeon(Skylake)上运行的 ONNX Runtime fp32;T4 TensorRT10 是在 Tesla T4 上运行的 TensorRT fp16。 - params 和 FLOPs 是在 768×768 分辨率下测得的,该分辨率是已发布权重的训练分辨率。
参阅尚未发布的 YOLO27 预览版,查看初步的 NYU Depth V2 结果。
与 Depth Anything V2 的速度对比#
Depth Anything V2 是广泛使用的单目深度开源基线。其 DINOv2 视觉 Transformer 主干网络和 DPT 解码器计算开销较大,因此在同一台 Tesla T4 上使用 TensorRT fp16 时,最小的已发布 Depth Anything V2 模型比所有 YOLO26 深度模型都慢——包括参数量多出一倍以上的 YOLO26x-depth。
约 768 px 时——YOLO26 使用 imgsz=768,即其已发布权重的训练分辨率;Depth Anything V2 使用 770 px,因为其 DINOv2 主干网络要求尺寸为补丁大小 14 的倍数:
| 模型 | 参数量(M) | FLOPs(B) | T4 TensorRT10(ms) | FPS | 相对 V2 Small 的加速倍数 | 相对 V2 Base 的加速倍数 |
|---|---|---|---|---|---|---|
| Depth Anything V2 Base | 97.5 | 1025.5 | 55.40 | 18.1 | — | — |
| Depth Anything V2 Small | 24.8 | 346.9 | 20.99 | 47.6 | — | — |
| YOLO26x-depth | 57.0 | 301.7 | 13.57 | 73.7 | 1.5× | 4.1× |
| YOLO26l-depth | 27.7 | 157.0 | 7.68 | 130.2 | 2.7× | 7.2× |
| YOLO26m-depth | 23.3 | 130.4 | 6.00 | 166.7 | 3.5× | 9.2× |
| YOLO26s-depth | 13.2 | 68.0 | 3.82 | 261.6 | 5.5× | 14.5× |
| YOLO26n-depth | 6.3 | 46.9 | 2.73 | 365.8 | 7.7× | 20.3× |
约 640 px 时——分别为 imgsz=640 和 644 px——排序没有变化,YOLO26n-depth 比 Depth Anything V2 Small 快 5.9 倍:
| 模型 | T4 TensorRT10(ms) | FPS |
|---|---|---|
| Depth Anything V2 Base | 35.10 | 28.5 |
| Depth Anything V2 Small | 13.62 | 73.4 |
| YOLO26x-depth | 10.26 | 97.5 |
| YOLO26l-depth | 6.14 | 162.8 |
| YOLO26m-depth | 4.71 | 212.1 |
| YOLO26s-depth | 3.08 | 324.4 |
| YOLO26n-depth | 2.29 | 436.9 |
- 延迟仅指推理延迟,分辨率为
batch=1,在 Tesla T4 上使用 TensorRT fp16 测得——与上方模型表使用相同的测试流程,此处数值保留两位小数;FPS 是未舍入延迟的倒数。加速倍数列分别用 Depth Anything V2 Small(20.99 ms)和 Base(55.40 ms)的延迟除以 YOLO26 的延迟。 - Depth Anything V2 Small 和 Base 分别是已发布的 ViT-S 和 ViT-B 检查点。
- 此对比仅涉及延迟——这里没有按照统一的准确率评估协议评估这两个模型系列。
深度范围和对数深度头#
深度头预测 exp(logit)——无界(约 0.02–150 m)——并且将场景形状与绝对尺度解耦:网络预测相对对数深度场,再通过单独的双参数变换(exp(a·log d + b))设定绝对米制深度;该变换可在评估时恢复,也可通过轻量校准或微调获得。常见的替代方案是有界的 sigmoid × max_depth 深度头,它会在架构中固定一个上限,因此任何超过 max_depth 的深度都会被截断,从而无法训练和预测更远距离的场景。
受控 A/B 对比——数据相同、训练计划相同,仅深度头不同。使用相同的室内(≤10 m)和室外(≤80 m)数据组合,从头开始训练两个深度头:
| 深度头 | 输出范围 | 混合范围验证集 δ1 | 训练表现 |
|---|---|---|---|
sigmoid × max_depth(10 m) | 有界,0–10 m | 0.221 | 在第 1 个 epoch 就停滞 |
log(无界) | 0–~150 m | 0.367 (+66%) | 持续提升 |
有界深度头无法表示室外像素中占多数的 >10 m 深度,因此几乎立即停止提升;log 深度头则能从完整深度范围的数据中学习。
它解决的问题——在单个数据集上微调时,按深度范围分层。在单个数据集上微调有界(10 m)深度头时,如果数据符合上限,效果良好;如果超出上限,性能就会崩溃:
| 数据集 | 深度范围 | 有界深度头 δ1 |
|---|---|---|
| SUN RGB-D | ≤10 m | 0.78 ✅ |
| Hypersim | 大多 ≤10 m | 0.74 ✅ |
| KITTI | ~80 m | 0.08 ❌(abs_rel ≈ 7.0——80/10 的尺度不匹配) |
| vKITTI2 | 80 m | 0.04 ❌ |
性能崩溃恰好发生在上限边界。log 深度头没有这样的边界。
已发布模型——跨深度范围性能。已发布的 log 深度头系列在涵盖 10 m(NYU、iBims-1)到 80 m(KITTI)的基准上进行评估,使用尺度对齐的 δ1:
| 基准测试 | 范围 | YOLO26x-depth(log) | 此前发布的有界版本 |
|---|---|---|---|
| NYU Eigen | 10 m | 0.933 | 0.934 |
| iBims-1 | 10 m | 0.961 | 0.945 |
| ETH3D | ~60 m | 0.959 | 0.931 |
| Make3D | ~70 m | 0.302 | 0.296 |
| KITTI Eigen | 80 m | 0.942 | 0.891 |
| 平均值 | — | 0.819 | 0.799 |
两列数据均为已发表的结果。其他行采用各数据集页面所述的 TTA 和对数最小二乘协议进行评分;此仓库中的验证器尚未实现该协议,因此无法用相同标准重新测量 KITTI 行。相反,KITTI 页面列出的是在标准 652 帧 Eigen 划分上测得的数值。
提升最大的是距离更远的室外基准(KITTI、ETH3D)——固定的 10 m 上限在这些场景中影响最大——同时保留了室内性能。
训练#
在 Depth8 数据集上训练 YOLO26n-depth,训练 100 个 epoch,图像尺寸设为 640。可用参数的完整列表请参阅配置页面。
from ultralytics import YOLO

# 加载模型
model = YOLO("yolo26n-depth.yaml")  # 从 YAML 构建新模型
model = YOLO("yolo26n-depth.pt")  # 加载预训练模型(推荐用于训练)
model = YOLO("yolo26n-depth.yaml").load("yolo26n-depth.pt")  # 从 YAML 构建模型并迁移权重

# 训练模型
results = model.train(data="depth8.yaml", epochs=100, imgsz=640)在训练页面查看 train 模式的完整详情。你也可以通过 Ultralytics Platform 云训练训练深度模型。
数据集格式#
深度估计数据集会将每张 RGB 图像与经过缩放的 uint16 深度 PNG 或以米为单位的浮点 NPY 深度图配对。PNG 值默认使用毫米;采用其他单位约定的数据集可在其 YAML 中设置 depth_scale。加载器通过将 images 部分替换为 depth 来推导深度图路径,并优先选择 .png,若不存在则回退到 .npy。
dataset/
├── images/
│   ├── train/
│   └── val/
└── depth/
    ├── train/
    └── val/
例如,路径为 images/train/scene_001.jpg 的图像会与路径为 depth/train/scene_001.png 的深度图配对。有关完整格式规范,请参阅深度估计数据集指南。
使用你自己的数据进行微调#
将预训练深度模型适配到自定义数据集时,请降低学习率并使用 AdamW 优化器。默认优化器设置针对从头训练进行了调优;如果将这些设置用于已经收敛的深度模型,可能会覆盖预训练知识并导致性能下降——尤其是在单一领域的数据上微调时。
from ultralytics import YOLO

model = YOLO("yolo26s-depth.pt")  # 从预训练权重开始

model.train(
    data="path/to/your_dataset.yaml",
    epochs=20,
    imgsz=640,
    optimizer="AdamW",
    lr0=1e-4,  # 约为从头训练默认值的 1/100
    warmup_bias_lr=1e-4,  # 预热也要保持平缓
)
其他提示:
- 增强由标准参数控制(
degrees,translate,scale,shear,perspective,flipud,fliplr,hsv_h,hsv_s,hsv_v);几何变换和翻转会以相同方式应用于配对深度图。要查看已发布 YOLO26-Depth 权重使用的确切方案,请检查检查点中存储的train_args——参见检查 YOLO26 检查点训练参数。 - 深度任务不支持
mosaic、mixup、cutmix和copy_paste。 深度数据集加载器会自动将这些概率设为 0,因此传入这些参数不会产生任何效果。这些增强会组合多张图像,从而生成无效的配对深度图,因此不受支持。 - 开箱即可适配任意深度范围。
log-head 模型预测的深度没有范围限制,因此无需修改即可适配短距离(微距)或长距离(户外/驾驶)数据。在数据集 YAML 中设置max_depth:(单位为米),即可限定哪些 GT 像素计入验证指标。 - 保留通用场景性能。 如果你需要模型在训练集以外的场景中仍保持准确,可在训练数据中混入少量(~5–10%)多样化的通用图像;这能显著减少微调期间的灾难性遗忘。
- 只有在你的领域差异很大且拥有大型数据集时,才从头开始训练(
model=yolo26s-depth.yaml)——此时默认的optimizer=auto是合适的,因为没有需要保留的预训练权重。
校准深度尺度#
深度头将形状(场景的相对结构)与尺度(绝对米数)分开。如果模型已能在你的场景中生成良好的相对深度,但绝对值不适合你的相机,你可以使用 model.calibrate() 在几秒内校正尺度——它会针对少量带标注的数据集,对深度头的对数仿射变换进行闭式、仅尺度拟合,并且仅在能改善交叉验证留出集上的 δ1 时保留结果;无需梯度训练,也不会更改网络权重,因此不会损害相对结构。
from ultralytics import YOLO

model = YOLO("yolo26s-depth.pt")

# 在带标注的数据划分上拟合尺度(约 100 张以上图像即可),然后保存校准结果
model.calibrate(data="path/to/your_dataset.yaml")
model.save("yolo26s-depth-calibrated.pt")
校准需要使用真实深度作为拟合依据,因此必须在带标注的数据划分上运行,不能在盲推理时进行。它会在与验证指标相同的像素上拟合和评分:数据集 YAML 中 max_depth(默认 100 m)及以上的 GT 会被排除。如果相对深度已经准确、只有尺度/范围不对,请使用此功能;如果你的领域需要改变相对结构,则应改为微调。
训练会自动为你完成此操作:model.train(...) 完成后,最佳和最后的检查点都会在验证集上进行校准,因此开箱即可输出经过米制尺度校准的深度。
已发布的 yolo26*-depth.pt 检查点已内置此校准,校准拟合使用的是预训练验证集混合数据。它采用跨所有领域的单一全局尺度;因此,如果你希望在特定相机或场景类型上获得最准确的绝对深度,请在你自己的少量带标注数据上运行 model.calibrate(),这会替换内置的拟合结果。
无需深度相机也能获取深度真值#
如果你的相机没有深度传感器,仍然可以对其进行标定。标定会拟合一个全局尺度,并忽略深度为 0 的像素,因此每张图像只需测量少量点即可。
-
采集图像。 使用相机在实际部署时采用的分辨率和镜头设置,拍摄 50 到 150 张图像,并将它们放入
dataset/images/val/。标定会读取val划分。 -
标注深度。 使用以下两种方法之一。两种方法都会按照数据集格式,为每张图像在
dataset/depth/val/中写入一张深度图。
使用激光测距仪或卷尺测量每张图像中若干点的距离。选择远离物体边缘的平坦表面,并在 points.csv 中记录每个点的像素位置:
image,x,y,meters
img_0001.jpg,352,453,3.15
img_0001.jpg,28,300,2.672
然后写入深度图,并将所有未测量像素设为 0。每个点都会绘制成一个小圆点,确保调整尺寸至 imgsz 后仍然保留:
import csv
from collections import defaultdict
from pathlib import Path

import cv2
import numpy as np

points = defaultdict(list)
with open("points.csv") as f:  # columns: image, x, y, meters
    for row in csv.DictReader(f):
        points[row["image"]].append((int(row["x"]), int(row["y"]), float(row["meters"])))

for name, pts in points.items():
    h, w = cv2.imread(f"dataset/images/val/{name}").shape[:2]
    depth = np.zeros((h, w), np.uint16)  # 0 means no label
    r = max(h, w) // 768 + 1  # dot radius that survives the resize to imgsz=768
    for x, y, meters in pts:
        cv2.circle(depth, (x, y), r, round(meters * 100), -1)  # centimeters, matching depth_scale: 100
    out = Path("dataset/depth/val") / f"{Path(name).stem}.png"
    out.parent.mkdir(parents=True, exist_ok=True)
    cv2.imwrite(str(out), depth)
测距仪测量的是到某个点的直线距离,而深度图存储的是沿相机视轴方向的距离。两者在图像中心处相同,在偏离中心 15° 处相差约 3.5%,因此应测量靠近中心的点,或使用相机内参,通过 meters / sqrt(1 + ((x - cx) / fx) ** 2 + ((y - cy) / fy) ** 2) 转换每次测量结果。
-
将数据集 YAML 写入
calib.yaml。depth_scale: 100会读取实测点生成的厘米单位 PNG 图像;对于 NPY 深度图则会忽略该项:path: dataset train: images/val val: images/val depth_scale: 100 # PNG value 100 = 1 meter names: 0: depth -
进行标定并保存,然后加载
yolo26s-depth-calibrated.pt进行预测或导出:from ultralytics import YOLO model = YOLO("yolo26s-depth.pt") model.calibrate(data="calib.yaml", imgsz=768) model.save("yolo26s-depth-calibrated.pt")
在使用 yolo26s-depth.pt、每台相机采集 150 张图像的测试中,对于 NYU、KITTI 和一台窄视场镜头相机,已发布的标定结果与使用完整深度真值拟合的尺度相差 4% 到 46%。每张图像使用 5 个实测点进行标定时,与该拟合结果的误差在 1% 以内;使用 DA3METRIC-LARGE 标签时,误差在 7% 以内。增加图像数量比增加每张图像中的点数更有效:150 张图像、每张 1 个点时,误差在约 3% 以内;20 张图像、每张 5 个点时,误差最高达 9%。
验证#
在深度估计数据集上验证经过训练的 YOLO26n-depth 模型的准确率。请显式传入 data,确保验证使用预期的数据集 YAML。已发布的权重是在 imgsz=768 尺寸下训练的,训练图像会拉伸为正方形,而不是通过填充进行信箱变换,因此请以该尺寸进行验证和预测,以获得最佳准确率。预测、验证和 model.calibrate() 都会以相同方式拉伸输入。
from ultralytics import YOLO

# 加载模型
model = YOLO("yolo26n-depth.pt")  # 加载官方模型
model = YOLO("path/to/best.pt")  # 加载自定义模型

# 验证模型
metrics = model.val(data="nyu-depth.yaml")
metrics.delta1  # 阈值 δ=1.25 范围内的像素比例
metrics.abs_rel  # 平均绝对相对误差
metrics.rmse  # 均方根误差(米)
metrics.silog # 尺度不变对数误差预测#
使用训练好的 YOLO26n-depth 模型对图像运行预测。
from ultralytics import YOLO

# 加载模型
model = YOLO("yolo26n-depth.pt")  # 加载官方模型
model = YOLO("path/to/best.pt")  # 加载自定义模型

# 使用模型进行预测
results = model("https://ultralytics.com/images/bus.jpg")  # 对图像进行预测

# 访问结果
for result in results:
depth_map = result.depth.data.cpu().numpy() # torch.Tensor -> NumPy float32,形状 (H, W),单位为米请参阅预测页面,了解完整的 predict 模式详情。
结果输出#
YOLO 深度估计会为每张图像返回一个 Results 对象。每个结果都存储一张覆盖整幅图像的稠密浮点深度图。
| 属性 | 类型 | 形状 | 说明 |
|---|---|---|---|
result.depth | DepthMap | (H,W) | 密集的逐像素深度图。 |
result.depth.data | torch.Tensor | (H,W) | 深度值以米为单位;调用 .cpu().numpy() 获取 NumPy 格式。 |
result.boxes | - | - | 没有实例框。 |
result.masks | - | - | 没有实例掩码。 |
如需了解所有任务中特定于任务的 Results 字段,请参阅按任务查看预测结果部分。
实例分割的逐对象深度#
将实例分割与深度信息结合,估算每个检测对象的距离。使用 retina_masks=True 在同一张图像上运行两个模型,使掩码与深度图保持原始图像分辨率,然后计算每个掩码内有效深度像素的中值。
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True)[0]
depth = YOLO("yolo26n-depth.pt")(image)[0].depth.data  # (H, W) meters

if seg.masks is not None:
    for mask, cls in zip(seg.masks.data.bool(), seg.boxes.cls):
        values = depth[mask & (depth > 0)]  # valid depth pixels inside this mask
        if values.numel():
print(f"{seg.names[int(cls)]}: {values.median():.2f} m")中值不容易受掩码边缘背景像素的影响,但描述的是对象可见表面的深度,而不是对象中心的深度;其准确性取决于模型的深度尺度(参见校准深度尺度)。
深度图着色#
原始深度图是以米为单位的单通道浮点数组——适合计算,但直接查看不易理解。要将其转换为彩色图像,可使用 ultralytics.utils.plotting 中的 colorize_depth 辅助函数,将 (H, W) 深度数组映射为 (H, W, 3) BGR uint8 图像(无效像素 <= 0 会显示为黑色)。
result.plot() 已使用默认值(cmap="jet"、mode="disparity")将此着色效果叠加到输入图像上;如果你需要独立的彩色深度图,或想使用其他色图或归一化方式,请直接调用 colorize_depth。
import cv2

from ultralytics import YOLO
from ultralytics.utils.plotting import colorize_depth

model = YOLO("yolo26n-depth.pt")
result = model("https://ultralytics.com/images/bus.jpg")[0]

depth = result.depth.data.cpu().numpy()  # (H, W) float32, meters

# 使用近处为暖色的方式着色并保存
cv2.imwrite("depth_colored.png", colorize_depth(depth, cmap="spectral"))  # (H, W, 3) BGR uint8

# 将范围固定为 0–20 m,使不同帧中相同的颜色始终表示相同的距离
cv2.imwrite("depth_metric.png", colorize_depth(depth, vmin=0.0, vmax=20.0, cmap="inferno", mode="metric"))

# 直接从 Results 对象生成混合叠加图(使用 cmap="jet"、mode="disparity")
result.save("depth_overlay.png")每种色图都会从冷/暗色过渡到暖/亮色。mode 决定哪一端表示近处,vmin/vmax 则会锁定不同帧之间的范围,确保相同颜色始终表示相同距离。
| 参数 | 值 | 说明 |
|---|---|---|
cmap | jet(默认) | 高对比度的蓝 → 绿 → 红配色,result.plot() 使用的调色板。 |
cmap | inferno | 黑 → 紫 → 橙 → 黄。感知均匀、色盲友好,且在灰度图中也易于辨认。 |
cmap | spectral | 红 → 黄 → 绿 → 蓝(matplotlib Spectral_r)。 |
mode | disparity(默认) | 在第 2 和第 98 百分位之间对逆深度(1/d)进行归一化;暖色表示近处,远处离群值会被压缩。 |
mode | metric | 在 vmin 和 vmax 之间按线性方式对米制深度进行归一化;暖色表示远处,因此颜色对应真实距离。 |
导出#
将 YOLO26n-depth 模型导出为 ONNX、CoreML 等其他格式。
from ultralytics import YOLO

# 加载模型
model = YOLO("yolo26n-depth.pt")  # 加载官方模型
model = YOLO("path/to/best.pt")  # 加载自定义模型

# 导出模型
model.export(format="onnx")
下表列出了可用的 YOLO26 深度估计导出格式。你可以使用 format 参数导出为任意格式,例如 format='onnx' 或 format='engine'。你可以直接在已导出的模型上进行预测或验证,例如 yolo predict model=yolo26n-depth.onnx。导出完成后,系统会显示适用于你模型的用法示例。
| 格式 | format 参数 | 模型 | 元数据 | 参数 |
|---|---|---|---|---|
| PyTorch | - | yolo26n-depth.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-depth.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-depth.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-depth_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-depth.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-depth.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n-depth.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n-depth_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-depth.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-depth_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n-depth.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-depth_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-depth.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-depth_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo26n-depth_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-depth_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-depth_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-depth_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-depth_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-depth_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n-depth_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n-depth_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n-depth_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
nms=None 默认输出原始结果,以供外部 NMS 使用。设置 nms=False 可选择可用的无 NMS 检测头;不支持的格式会回退到其原生输出路径。上方的 nms 条目表示可以通过 nms=True 嵌入 NMS 的格式。
请参阅 Export 页面,了解完整的 export 详情。
常见问题#
准备配对的 RGB 图像,以及 16 位深度 PNG 或以米为单位的浮点 NPY 深度图,然后创建一个指向
images/目录的数据集 YAML。加载器会自动在路径中将images替换为depth来查找深度文件,优先使用.png,找不到时则回退到.npy。从预训练权重开始,并使用较低的学习率和 AdamW,以便微调保留模型已有的知识(原因请参阅在你自己的数据上微调):
示例from ultralytics import YOLO # 加载预训练的 YOLO26 深度模型 model = YOLO("yolo26s-depth.pt") # 在自定义深度数据集上微调 results = model.train( data="path/to/your_dataset.yaml", epochs=20, imgsz=640, optimizer="AdamW", lr0=1e-4, warmup_bias_lr=1e-4, )请查看配置页面,了解更多可用参数。
深度估计验证会报告 Depth Anything 及相关单目深度研究所使用的指标集:
- delta1 / delta2 / delta3 — 预测深度与真实深度(或其倒数)的比值低于 1.25、1.25² 和 1.25³ 的像素比例。数值越高越好。
- abs_rel — 平均绝对相对误差。数值越低越好。
- rmse — 以米为单位的均方根误差。数值越低越好。
- silog — 尺度不变对数误差。数值越低越好。
每张图像的预测都会与其真实值进行中值对齐,每项指标都会在该图像上计算完成,然后对验证集中的逐图结果取平均,因此无论图像包含多少有效深度像素,每张图像的权重都相同。少于 10 个有效真实深度像素的图像会被跳过,不计入平均值,因为对少数像素进行中值对齐没有意义;非有限预测值则按深度边界进行评分。这与 Depth Anything V2 使用的逐样本平均方式和 10 像素下限一致。
深度图存储为形状为
(H, W)的torch.Tensor,其中每个值都是以米为单位的预测深度(使用result.depth.data.cpu().numpy()获取 NumPyfloat32数组)。运行预测后,可通过result.depth.data访问深度图。深度图与输入图像分辨率对齐。Ultralytics YOLO26 内置了多个深度估计数据集的 YAML 配置,包括 NYU Depth V2、KITTI、Hypersim、SUN RGB-D 和 ARKitScenes。完整列表和格式详情请参阅深度估计数据集指南。
验证预训练的 YOLO26 深度模型时,请提供用于评估的数据集 YAML:
示例from ultralytics import YOLO # 加载预训练模型 model = YOLO("yolo26n-depth.pt") # 验证模型 metrics = model.val(data="nyu-depth.yaml") print("delta1:", metrics.delta1) print("abs_rel:", metrics.abs_rel) print("rmse:", metrics.rmse)使用 Python 或 CLI 将 YOLO26 深度模型导出为 ONNX:
示例from ultralytics import YOLO # 加载预训练模型 model = YOLO("yolo26n-depth.pt") # 将模型导出为 ONNX 格式 model.export(format="onnx")如需了解将模型导出为各种格式的更多详情,请参阅导出页面。