使用 Ultralytics YOLO 进行姿态估计#
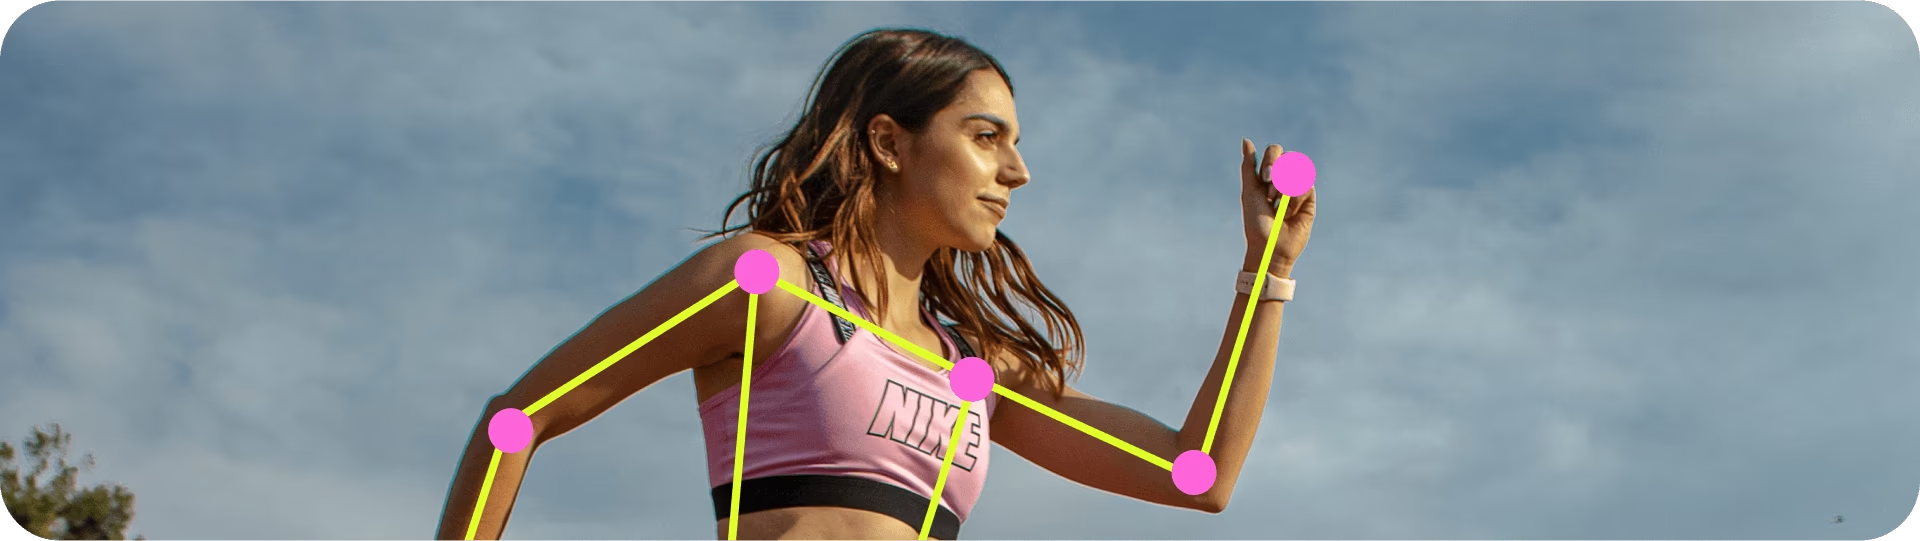
姿态估计是一项用于识别图像中特定点位置的任务,这些点通常称为关键点。关键点可以表示对象的不同部位,例如关节、标志点或其他显著特征。关键点位置通常表示为一组二维 [x, y] 坐标,可选地附带可见性标志 [x, y, visible]。
姿态估计模型的输出是一组表示图像中对象关键点的点,通常还包含每个点的置信度分数。当你需要识别场景中对象的特定部位及其相对位置时,姿态估计是一个不错的选择。
观看: 如何使用 Ultralytics YOLO26 进行实时姿态估计 | 跟踪和关键点提取 🕺
YOLO26 Pose 模型使用 -pose 后缀,例如 yolo26n-pose.pt,并在 COCO keypoints 上预训练。
模型#
以下展示了在 COCO keypoints 数据集上预训练的 YOLO26 Pose 模型。
首次使用时,模型会自动从 Ultralytics 最新版本下载。
| 模型 | 尺寸 (像素) | mAP姿态 50-95(e2e) | mAP姿态 50(e2e) | 速度 CPU ONNX (毫秒) | 速度 T4 TensorRT10 (ms) | 参数 (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|
| YOLO26n-pose | 640 | 57.2 | 83.3 | 40.3 ± 0.5 | 1.8 ± 0.0 | 2.9 | 7.6 |
| YOLO26s-pose | 640 | 63.0 | 86.6 | 85.3 ± 0.9 | 2.7 ± 0.0 | 10.4 | 24.1 |
| YOLO26m-pose | 640 | 68.8 | 89.6 | 218.0 ± 1.5 | 5.0 ± 0.1 | 21.5 | 73.3 |
| YOLO26l-pose | 640 | 70.4 | 90.5 | 275.4 ± 2.4 | 6.5 ± 0.1 | 25.9 | 91.7 |
| YOLO26x-pose | 640 | 71.6 | 91.6 | 565.4 ± 3.0 | 12.2 ± 0.2 | 57.6 | 202.3 |
- mAPval 数值是在 COCO Keypoints val2017 数据集上以单模型、单尺度方式得出的。
使用yolo pose val data=coco-pose.yaml device=0 nms=False复现 - 速度是在 COCO val 图像上使用 ONNX(CPU)和 TensorRT10(NVIDIA T4 GPU)测得的平均值。
使用yolo pose val data=coco-pose.yaml batch=1 device=0|cpu nms=False复现 - 参数量和 FLOPs 数值对应融合后的模型,该模型经过 Conv/BatchNorm 折叠并移除了未使用的检测分支。预训练检查点保留完整的训练架构,因此显示的数值可能更高。
初步 COCO keypoint 结果请参阅尚未发布的 YOLO27 预览版。
训练#
在 COCO8-pose 数据集上以 640 的图像尺寸训练 YOLO26n-pose,共训练 100 个 epochs。如需查看可用参数的完整列表,请参阅 Configuration 页面。
from ultralytics import YOLO

# 加载模型
model = YOLO("yolo26n-pose.yaml")  # 从 YAML 构建新模型
model = YOLO("yolo26n-pose.pt")  # 加载预训练模型(推荐用于训练)
model = YOLO("yolo26n-pose.yaml").load("yolo26n-pose.pt")  # 从 YAML 构建模型并迁移权重

# 训练模型
results = model.train(data="coco8-pose.yaml", epochs=100, imgsz=640)
有关 train 模式的完整详情,请参阅 Train 页面。你也可以通过 Ultralytics Platform 云训练训练姿态模型。
数据集格式#
YOLO 姿态数据集格式的详细说明请参阅 Dataset Guide。如需将现有的 COCO keypoints JSON 数据集转换为 YOLO 格式,请按照 COCO to YOLO guide 中的说明,使用内置的 convert_coco 函数和 use_keypoints=True。Ultralytics Platform 标注也支持姿态标签,并内置适用于人体、手部、面部和自定义关键点布局的骨架模板。
对于自定义姿态估计任务,你也可以探索专用数据集,例如用于动物姿态估计的 Tiger-Pose、用于手部追踪的 Hand Keypoints,或用于犬类姿态分析的 Dog-Pose。
验证#
验证训练好的 YOLO26n-pose 模型的准确率。无需提供参数,因为 model 会将训练时使用的 data 和参数保留为模型属性:Train 示例中的 path/to/best.pt 会在 COCO8-pose 上进行验证。官方权重记录的训练数据集路径在你的机器上可能不存在,因此会在发出警告后回退到任务默认值 coco8-pose.yaml。传入 data 可在其他数据集上进行验证。
from ultralytics import YOLO

# 加载模型
model = YOLO("yolo26n-pose.pt")  # 加载官方模型
model = YOLO("path/to/best.pt")  # 加载自定义模型

# 验证模型
metrics = model.val()  # 无需参数,数据集和设置会自动记住
metrics.box.map  # map50-95
metrics.box.map50  # map50
metrics.box.map75  # map75
metrics.box.maps  # 包含每个类别 mAP50-95 的列表
metrics.box.image_metrics  # 每张图像的框指标字典,包含 precision、recall、F1、TP、FP 和 FN
metrics.pose.map  # map50-95(P)
metrics.pose.map50  # map50(P)
metrics.pose.map75  # map75(P)
metrics.pose.maps  # 包含各类别 mAP50-95(P) 的列表
metrics.pose.image_metrics # 每张图像的姿态指标字典,包含 precision、recall、F1、TP、FP 和 FN预测#
使用训练好的 YOLO26n-pose 模型对图像进行预测。
from ultralytics import YOLO

# 加载模型
model = YOLO("yolo26n-pose.pt")  # 加载官方模型
model = YOLO("path/to/best.pt")  # 加载自定义模型

# 使用模型进行预测
results = model("https://ultralytics.com/images/bus.jpg")  # 对图像进行预测

# 访问结果
for result in results:
    xy = result.keypoints.xy  # x 和 y 坐标
    xyn = result.keypoints.xyn  # normalized
kpts = result.keypoints.data # x、y、可见性(如果有)请参阅预测页面,了解完整的 predict 模式详情。
结果输出#
姿态估计会为每张图像返回一个 Results 对象。主要预测字段为表示姿态坐标的 result.keypoints,以及关键点所属检测实例的 result.boxes。
| 属性 | 类型 | 形状 | 说明 |
|---|---|---|---|
result.keypoints | Keypoints | (N) | 关键点。 |
result.keypoints.data | torch.float32 | (N,K,2/3) | x,y,以及可选的可见性/置信度。 |
result.keypoints.xy | torch.float32 | (N,K,2) | 像素坐标中的关键点。 |
result.keypoints.xyn | torch.float32 | (N,K,2) | 归一化关键点。 |
result.boxes | Boxes | (N) | 实例框。 |
如需了解所有任务中特定于任务的 Results 字段,请参阅按任务查看预测结果部分。
关键点索引映射#
默认的 YOLO26 Pose 模型会预测 17 个 COCO 关键点,因此 result.keypoints.xy[:, k] 中索引为 k 的点是:
- 鼻子
- 左眼
- 右眼
- 左耳
- 右耳
- 左肩
- 右肩
- 左肘
- 右肘
- 左腕
- 右腕
- 左髋
- 右髋
- 左膝
- 右膝
- 左踝
- 右踝
导出#
将 YOLO26n-pose 模型导出为其他格式,例如 ONNX、CoreML 等。
from ultralytics import YOLO

# 加载模型
model = YOLO("yolo26n-pose.pt")  # 加载官方模型
model = YOLO("path/to/best.pt")  # 加载自定义模型

# 导出模型
model.export(format="onnx")
下表列出了可用的 YOLO26-pose 导出格式。你可以使用 format 参数导出为任意格式,例如 format='onnx' 或 format='engine'。你也可以直接使用导出的模型进行预测或验证,例如 yolo predict model=yolo26n-pose.onnx。导出完成后,系统会显示适用于你模型的用法示例。
| 格式 | format 参数 | 模型 | 元数据 | 参数 |
|---|---|---|---|---|
| PyTorch | - | yolo26n-pose.pt | ✅ | - |
| TorchScript | torchscript | yolo26n-pose.torchscript | ✅ | imgsz, quantize, dynamic, nms, batch, device |
| ONNX | onnx | yolo26n-pose.onnx | ✅ | imgsz, quantize, dynamic, simplify, opset, nms, batch, data, fraction, device |
| OpenVINO | openvino | yolo26n-pose_openvino_model/ | ✅ | imgsz, quantize, dynamic, nms, batch, data, fraction, device |
| TensorRT | engine | yolo26n-pose.engine | ✅ | imgsz, quantize, dynamic, simplify, opset, workspace, nms, batch, data, fraction, device |
| CoreML | coreml | yolo26n-pose.mlpackage | ✅ | imgsz, dynamic, quantize, nms, batch, device |
| Apple Core AI | coreai | yolo26n-pose.aimodel | ✅ | imgsz, batch, quantize |
| TF SavedModel | saved_model | yolo26n-pose_saved_model/ | ✅ | imgsz, quantize, opset, nms, batch, data, fraction, device |
| TF GraphDef | pb | yolo26n-pose.pb | ❌ | imgsz, opset, batch, device |
| TF Edge TPU | edgetpu | yolo26n-pose_edgetpu.tflite | ✅ | imgsz, quantize, opset, data, fraction, device |
| LiteRT | litert | yolo26n-pose.tflite | ✅ | imgsz, quantize, batch, data, fraction, device |
| PaddlePaddle | paddle | yolo26n-pose_paddle_model/ | ✅ | imgsz, batch, device |
| MNN | mnn | yolo26n-pose.mnn | ✅ | imgsz, batch, dynamic, quantize, simplify, opset, nms, device |
| NCNN | ncnn | yolo26n-pose_ncnn_model/ | ✅ | imgsz, quantize, batch, device |
| IMX500 | imx | yolo26n-pose_imx_model/ | ✅ | imgsz, quantize, data, fraction, nms, device |
| RKNN | rknn | yolo26n-pose_rknn_model/ | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| ExecuTorch | executorch | yolo26n-pose_executorch_model/ | ✅ | imgsz, batch, device |
| Axelera | axelera | yolo26n-pose_axelera_model/ | ✅ | imgsz, batch, quantize, data, fraction, device |
| DEEPX | deepx | yolo26n-pose_deepx_model/ | ✅ | imgsz, quantize, simplify, opset, data, optimize, device |
| Qualcomm QNN | qnn | yolo26n-pose_qnn.onnx | ✅ | imgsz, batch, name, quantize, simplify, opset, data, fraction, device |
| Hailo | hailo | yolo26n-pose_hailo_model/ | ✅ | imgsz, name, quantize, data, fraction, simplify, conf, iou, device |
| Huawei Ascend | ascend | yolo26n-pose_ascend_model/ | ✅ | imgsz, batch, name, quantize, opset, simplify, nms, device |
| AMD Xilinx | xilinx | yolo26n-pose_xilinx_model/ | ✅ | imgsz, name, quantize, data, fraction, opset, simplify, device |
nms=None 默认输出原始结果,以供外部 NMS 使用。设置 nms=False 可选择可用的无 NMS 检测头;不支持的格式会回退到其原生输出路径。上方的 nms 条目表示可以通过 nms=True 嵌入 NMS 的格式。
请参阅 Export 页面,了解完整的 export 详情。
常见问题#
使用 Ultralytics YOLO26 进行姿态估计,需要识别图像中的特定点,即关键点。这些关键点通常表示对象的关节或其他重要特征。输出包括每个点的
[x, y]坐标和置信度分数。YOLO26-pose 模型专为此任务设计,使用-pose后缀,例如yolo26n-pose.pt。这些模型在 COCO keypoints 等数据集上预训练,可用于各种姿态估计任务。如需了解更多信息,请访问姿态估计页面。要在自定义数据集上训练 YOLO26-pose 模型,你需要先加载模型,可以是通过 YAML 文件定义的新模型,也可以是预训练模型。然后,你可以使用指定的数据集和参数开始训练。
示例from ultralytics import YOLO # 加载模型 model = YOLO("yolo26n-pose.yaml") # 从 YAML 构建新模型 model = YOLO("yolo26n-pose.pt") # 加载预训练模型(推荐用于训练) # 训练模型 results = model.train(data="your-dataset.yaml", epochs=100, imgsz=640)如需了解训练的完整详情,请参阅 Train Section。你也可以使用 Ultralytics Platform 云训练,无需编写代码即可训练自定义姿态估计模型。
验证 YOLO26-pose 模型时,需要使用训练时保留的相同数据集参数来评估模型准确率。示例如下:
示例from ultralytics import YOLO # 加载模型 model = YOLO("yolo26n-pose.pt") # 加载官方模型 model = YOLO("path/to/best.pt") # 加载自定义模型 # 验证模型 metrics = model.val() # 无需参数,数据集和设置会自动记住如需了解更多信息,请访问 Val Section。
可以,你可以将 YOLO26-pose 模型导出为 ONNX、CoreML、TensorRT 等多种格式。你可以使用 Python 或命令行界面 (CLI) 完成此操作。
示例from ultralytics import YOLO # 加载模型 model = YOLO("yolo26n-pose.pt") # 加载官方模型 model = YOLO("path/to/best.pt") # 加载自定义模型 # 导出模型 model.export(format="onnx")如需了解详情,请参阅 Export Section。导出的模型可以部署到边缘设备,用于实时应用,例如健身追踪、运动分析或机器人。
Ultralytics YOLO26 提供多种预训练姿态模型,例如 YOLO26n-pose、YOLO26s-pose、YOLO26m-pose 等。这些模型在大小、准确率 (mAP) 和速度方面各不相同。如需查看完整列表以及各模型的 COCO keypoint mAP、速度、参数量和 FLOPs,请参阅 Models 部分。