Ultralytics Platform
Ultralytics Platform 是一个端到端的计算机视觉平台,覆盖从数据准备到模型部署的完整机器学习工作流程。它面向希望训练并部署生产级视觉模型、又无需自行管理基础设施的团队和个人。
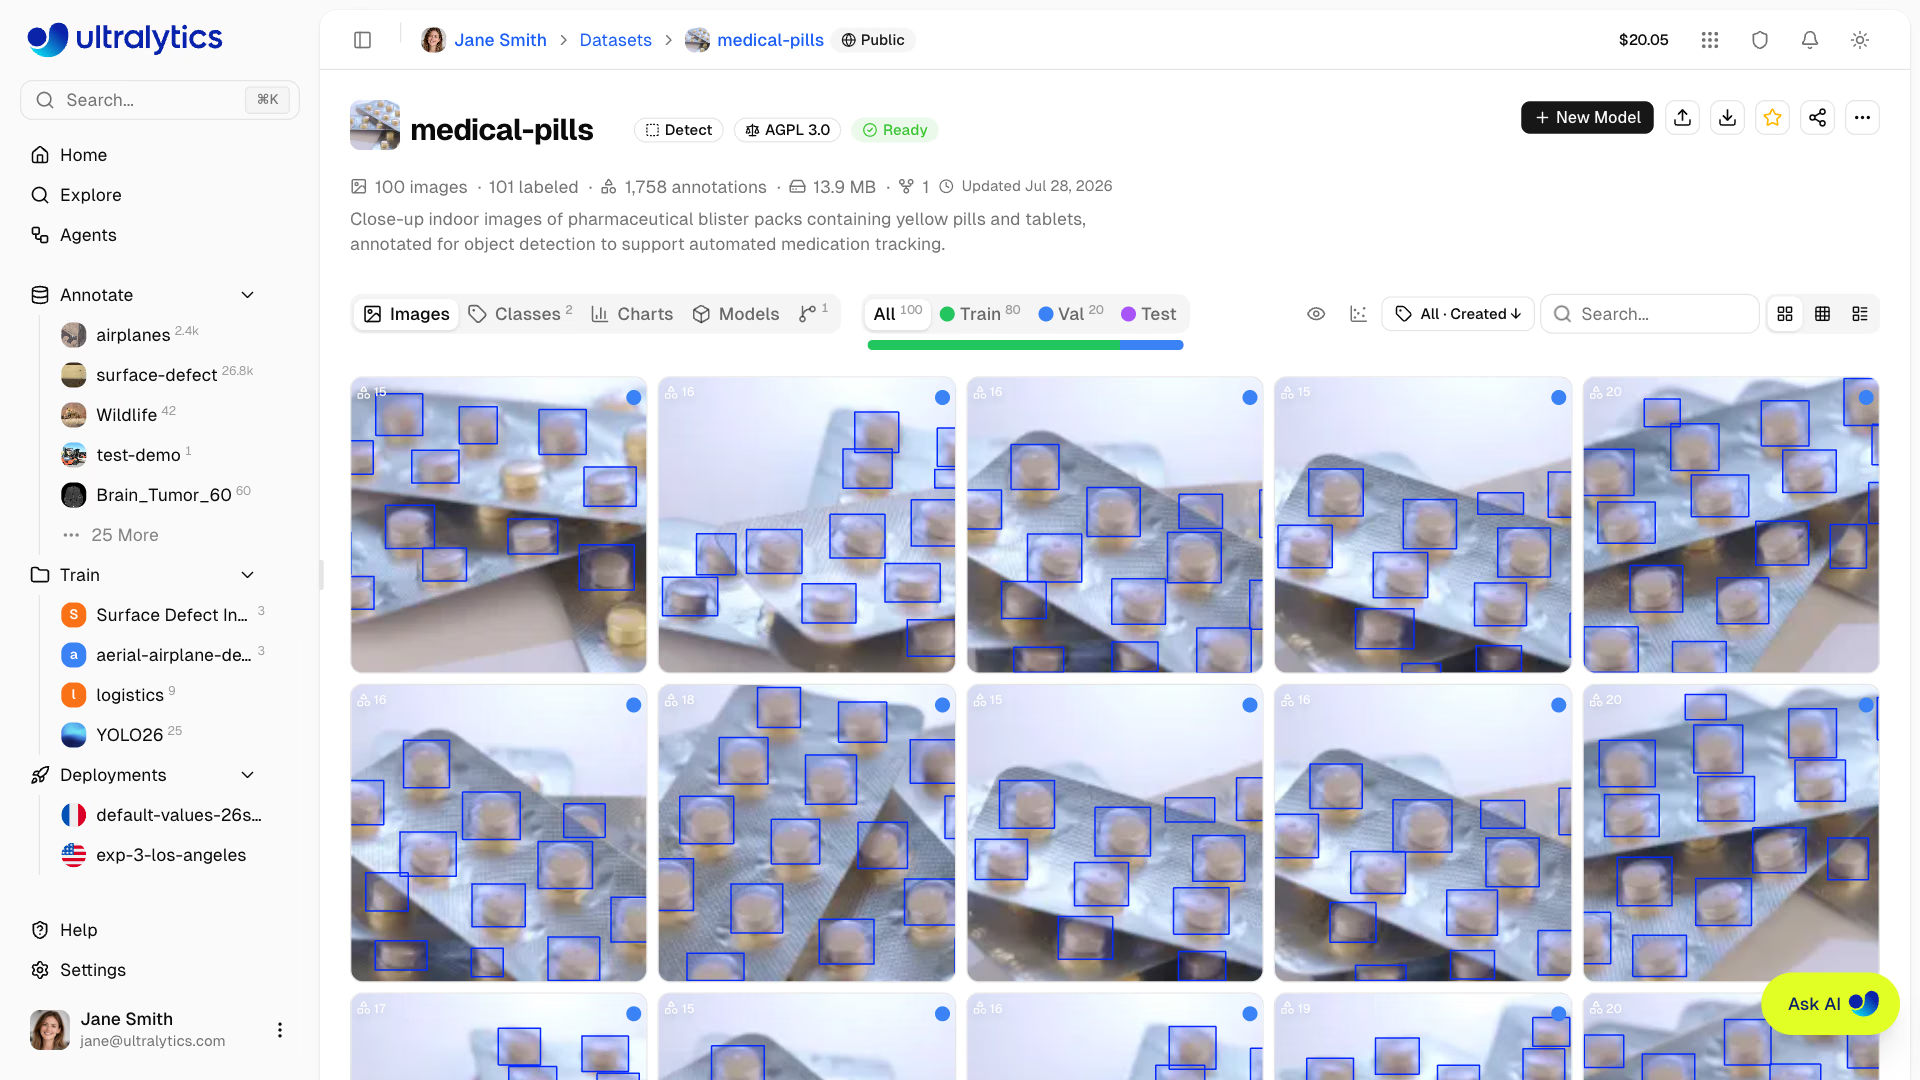
什么是 Ultralytics Platform?#
Ultralytics Platform 将数据集管理与标注、实验跟踪、云端和远程训练、模型导出、专用推理端点及部署监控整合到一个工作区中。平台原生支持 YOLO26、YOLO11、YOLOv8 和 YOLOv5 模型。
工作流程:上传 → 标注 → 训练 → 导出或部署#
该平台提供端到端工作流程:
| 阶段 | 功能 |
|---|---|
| 上传 | 从你的设备、URL、云存储或本地部署的主机上传图像(50MB)、视频(1GB)和数据集文件(ZIP、TAR,包含 .tar.gz/.tgz、NDJSON) |
| 标注 | 适用于 6 种任务类型的手动标注工具,以及 Smart Annotation:用于检测、分割、语义分割和 OBB 任务的 SAM 模型;用于这些任务及姿态估计的 YOLO 模型;或者用于包含 1–200 个类别的检测数据集的类别提示模型(托管的开源模型或付费服务商模型;请参阅支持的任务类型) |
| 训练 | 云端 GPU(所有套餐均提供 24 个,Pro/Enterprise 套餐专享另外 2 个:B200、B300)、实时指标、项目组织管理 |
| 导出 | 23 种部署格式(ONNX、TensorRT、CoreML、LiteRT、Hailo、Ascend 等;参见支持的格式) |
| 部署 | 覆盖全球 42 个区域的专用端点,默认缩容至零(单个活动实例),并提供监控 |
你可以执行的操作:
- 上传图像、视频和数据集文件,以创建训练数据集
- 可视化标注内容,并通过交互式叠加层查看标注编辑器支持的 6 种 YOLO 任务类型(请参阅支持的任务类型)
- 训练模型:使用云端 GPU(所有套餐均提供 24 个,Pro 或 Enterprise 套餐提供 26 个,包含 B200 和 B300),并查看实时指标
- 导出为 23 种部署格式(ONNX、TensorRT、CoreML、LiteRT、Hailo、Ascend 等)
- 部署到全球 42 个区域,并一键创建专用端点
- 构建 Agents 工作流程,连接模型、条件、数据集收集、Slack 警报和 Webhook
- 监控训练进度、部署运行状况和使用指标
- 通过集成连接云存储、标注工具和 Slack
- 协作:向社区公开项目和数据集
多区域基础设施#
你的数据会保留在所在区域。Ultralytics Platform 在全球三个区域运营基础设施:
| 区域 | 标签 | 位置 | 适用场景 |
|---|---|---|---|
| 美国 | 美洲 | 美国爱荷华州 | 美洲用户;为美洲用户提供最快速度 |
| 欧盟 | 欧洲、中东和非洲 | 欧洲比利时 | 欧洲用户;符合 GDPR 要求 |
| 亚太 | 亚太地区 | 亚太地区台湾 | 亚太地区用户;提供最低的亚太地区延迟 |
你可以在注册引导过程中选择数据区域。数据集、模型和托管训练数据都会保留在该区域。 专用端点会单独部署到你从全球部署地图中选择的区域。
主要功能#
数据准备#
- 数据集管理:从本地文件、URL、已连接的云存储或本地部署的主机创建数据集,并自动处理数据
- 标注编辑器:提供适用于 6 种 YOLO 任务类型的手动标注工具(检测、分割、语义分割、分类、姿势估计、OBB;请参阅支持的任务类型)
- 骨架模板:内置模板(人物、手部、狗、面部、框)和自定义骨架模板,支持一键进行姿势标注
- 智能标注:在标注工具栏中使用 SAM 2.1(Tiny、Small、Base、Large)、SAM 3 或 SAM 3.1(默认),执行检测、分割、语义分割和 OBB 任务;也可以使用预训练的 Ultralytics YOLO 模型和你自己微调的 YOLO 模型执行这些任务及姿态估计,或者在包含 1–200 个类别的检测数据集中使用类别提示模型:九种托管开源模型(批量标注中默认使用 Moondream 3.1,另有一种可通过 Early access 启用)、托管的文本提示 SAM 3 和 SAM 3.1,或者来自 OpenAI、Anthropic、Google、Meta、SpaceXAI、DeepSeek、Z.ai、Kimi、Xiaomi MiMo、Alibaba、MiniMax 和 Tencent 的付费视觉模型;使用 Settings > API Keys 中的提供商密钥即可
- 数据集版本控制:创建带描述的编号 NDJSON 快照,然后下载或还原任意版本,以实现可复现训练
- 统计信息:类别分布、数据集划分分布、位置热力图和边界框尺寸分析
模型训练#
- 云端训练:使用云端 GPU(所有套餐均提供 24 个,Pro 或 Enterprise 套餐可使用 26 个,包含 B200 和 B300)进行训练,并查看实时指标和实时费用估算
- 远程训练:在任何位置进行训练,并将指标流式传输到 Ultralytics Platform
- 高级设置:在训练对话框内置的 YAML 编辑器中覆盖任何 Ultralytics 训练参数
- 项目组织管理:将相关模型分组、比较实验并跟踪活动
- 23 种导出格式:ONNX、TensorRT、CoreML、LiteRT、Hailo、Ascend 等(参见支持的格式)
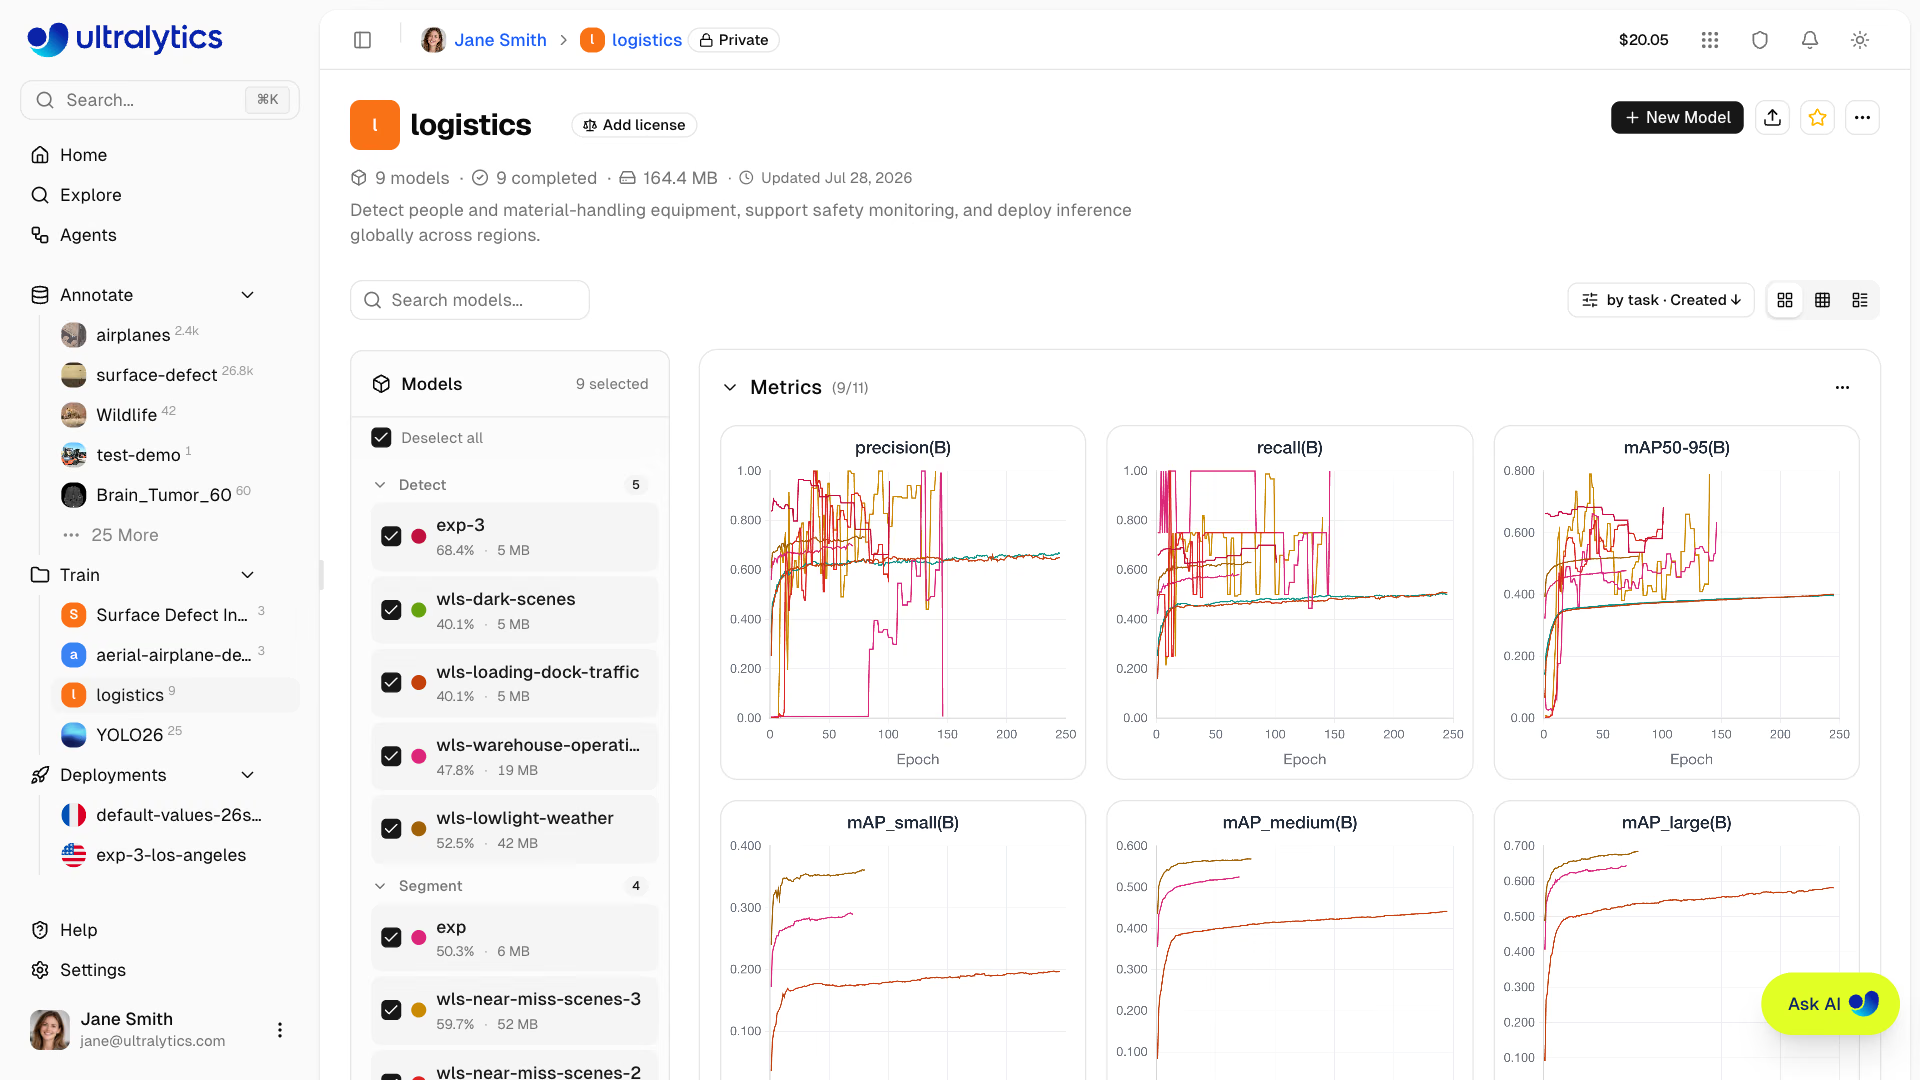
你可以通过 Web UI(云端训练)或在自己的设备上(远程训练)训练模型:
- 前往你的项目
- 点击
New Model - 选择数据集、模型、GPU 和训练轮数
- 监控实时损失曲线和指标
部署#
- 推理测试:直接在浏览器中使用你自己的图像、摄像头拍摄内容或内置示例测试模型
- 专用端点:部署到全球 42 个区域,默认缩容至零(单个活动实例)
- 监控:实时指标、请求日志和性能仪表板
部署后,你可以使用任意语言调用你的端点。conf、iou 和 imgsz 是可选表单字段,默认值分别为 0.25、0.5 和模型的训练图像尺寸(如果无法获取,则为 640):
import requests

url = "https://your-deployment-url.run.app/predict"
api_key = "YOUR_API_KEY"
args = {"conf": 0.25, "iou": 0.5, "imgsz": 640}

with open("image.jpg", "rb") as f:
    response = requests.post(
        url,
        headers={"Authorization": f"Bearer {api_key}"},
        data=args,
        files={"file": f},
    )

print(response.json())账户管理#
- 团队与组织:与团队成员协作、管理角色和邀请,并从账户菜单切换工作区
- API 密钥:安全管理远程训练和 API 访问所需的密钥
- 积分与账单:按需付费训练,价格透明,可充值 $5 至 $1,000
- 活动动态:跟踪所有账户事件和操作
- 回收站与恢复:支持 30 天软删除和项目恢复
- 符合 GDPR:导出数据和删除账户
查看权威的 免费版、专业版和企业版对比,了解当前限制、GPU 访问权限、协作功能和许可信息。
快速链接#
通过以下资源快速开始:
- 快速入门:几分钟内创建你的第一个项目并训练模型
- 探索:浏览和克隆公开数据集与项目,还可根据图像内容搜索图像
- 数据:数据集准备概览
- 数据集:上传并管理你的训练数据
- 标注:使用手动和 AI 辅助工具标注你的数据
- 训练:训练概览
- 项目:整理你的模型和实验
- 模型:模型页面、下载和导出
- 云端训练:在云端 GPU 上训练
- 部署:部署概览
- 推理:测试你的模型
- 端点:将模型部署到生产环境
- 监控:跟踪部署性能
- 账户:账户概览
- 设置:个人资料和工作区偏好设置
- 团队:成员、角色和邀请
- API 密钥:管理 API 访问权限
- 账单:积分和付款
- 活动:跟踪账户事件
- 回收站:恢复已删除的项目
- 集成:云存储、标注工具和 Slack
- REST API:API 参考
故障排除#
数据集问题#
| 问题 | 解决方案 |
|---|---|
| 数据集无法处理 | 检查文件格式是否受支持(图像支持 JPEG、PNG、WebP、TIFF、HEIC、AVIF、BMP、JP2、DNG、MPO)。最大文件大小:图像 50 MB、视频 1 GB、数据集压缩包 10 GB(免费版)/ 20 GB(专业版)/ 50 GB(企业版) |
| 缺少标注 | 确认标签采用 YOLO 格式,且 .txt 文件名与图像文件名匹配;或者上传 COCO JSON |
| “需要训练集拆分” | 将 train/ 文件夹添加到你的数据集结构中,或通过拆分栏重新分配拆分 |
| 未定义类别名称 | 添加包含 names: 列表的 data.yaml 文件(参见 YOLO 格式),或在类别选项卡中定义类别 |
训练问题#
| 问题 | 解决方案 |
|---|---|
| 训练无法启动 | 在“设置”>“账单”中检查积分余额。余额必须大于零 |
| 内存不足错误 | 减小批次大小、使用更小的模型(n/s),或选择显存更大的 GPU |
| 指标表现不佳 | 检查数据集质量、增加训练轮数、尝试数据增强,并确认类别平衡 |
| 训练速度慢 | 选择速度更快的 GPU、减小图像尺寸,并检查数据集是否成为瓶颈 |
部署问题#
| 问题 | 解决方案 |
|---|---|
| 端点无响应 | 检查端点状态(就绪或已停止)。闲置后冷启动时,首次请求最多可能需要一分钟 |
| 401 未授权 | 确认 API 密钥处于启用状态且复制正确 |
| 推理速度慢 | 检查模型大小,考虑导出为 TensorRT,并选择距离更近的区域 |
| 导出失败 | 某些格式需要特定的模型架构。若要获得最广泛的兼容性,请尝试 ONNX |
常见问题#
注册后可以更改用户名吗?
不可以,用户名是永久的,无法更改。注册时请谨慎选择。
可以更改数据区域吗?
数据区域会在引导设置期间选定,你无法自行更改。如需切换区域,请联系支持团队申请更改。
如何获取更多积分?
前往 设置 > 账单,然后点击 充值。你可以购买 $5 至 $1,000 的积分。购买的积分永不过期。
训练失败会怎样?
如果云端计算已启动,则会按已用 GPU 时间收费。如果在 GPU 启动前失败,则不会收取计算费用。
我可以下载训练好的模型吗?
可以。点击模型页面上的下载图标即可下载模型的 .pt 权重,或者打开 导出 选项卡查看已完成导出的格式。
如何公开分享我的作品?
打开项目或数据集,点击顶部导航栏中的 私有 标记,然后确认选择 设为公开。公开内容会显示在“探索”页面上。
文件大小限制是多少?
图像:50MB;视频:1GB;数据集:免费版 10GB、专业版 20GB、企业版 50GB。对于更大的文件,请拆分后分多次上传。
已删除的项目会在回收站中保留多久?
30 天。之后,项目会被永久删除,无法恢复。
我可以将平台模型用于商业用途吗?
免费版和专业版套餐使用 AGPL 许可证。如需在不受 AGPL 要求约束的情况下用于商业用途,请参阅 Ultralytics 许可。
常见问题#
要开始使用 Ultralytics Platform:
- 注册:在 platform.ultralytics.com 创建账户
- 选择区域:在引导设置期间选择你的数据区域(美国、欧盟或亚太地区)
- 上传数据集:在侧边栏中打开
Annotate并上传你的数据 - 训练模型:创建项目并在云端 GPU 上开始训练
- 部署:测试你的模型并将其部署到专用端点
如需详细指南,请参阅快速入门页面。
Ultralytics Platform 支持多种 GPU 类型用于云端训练:
GPU 代际 显存 适用场景 RTX 2000 Ada Ada 16 GB 小型数据集、测试 RTX A4500 Ampere 20 GB 小型到中型数据集 RTX A5000 Ampere 24 GB 中型数据集 RTX 4000 Ada Ada 20 GB 中型数据集 RTX 3090 Ampere 24 GB 通用训练 RTX PRO 4000 Blackwell 24 GB 经济型 Blackwell L4 Ada 24 GB 针对推理优化 A40 Ampere 48 GB 较大的批次大小 RTX A6000 Ampere 48 GB 大型模型 RTX PRO 4500 Blackwell 32 GB 性价比出色 L40 Ada 48 GB 大型模型 RTX 4090 Ada 24 GB 通用训练 RTX PRO 5000 Blackwell 48 GB 大批次训练 RTX 6000 Ada Ada 48 GB 大批次训练 L40S Ada 48 GB 大批次训练 RTX 5090 Blackwell 32 GB 最新一代消费级产品 A100 PCIe Ampere 80 GB 生产环境训练 A100 SXM Ampere 80 GB 生产环境训练 RTX PRO 6000 Blackwell 96 GB 推荐默认选项 H100 PCIe Hopper 80 GB 高性能训练 H100 NVL Hopper 94 GB 最高性能 H200 NVL Hopper 143 GB 最大显存 H100 SXM Hopper 80 GB 最快的训练 H200 SXM Hopper 141 GB 最高性能 B200 Blackwell 180 GB 大型模型(Pro+) B300 Blackwell 288 GB 最大型模型(Pro+) 当前每小时价格显示在训练对话框的 GPU 选择器和定价页面上。
请参阅云端训练,了解完整的 GPU 选项。
你可以在自己的硬件上训练模型,并将实时指标流式传输到 Ultralytics Platform。
软件包版本要求Platform 集成要求使用 Python>=3.11 和 ultralytics>=8.4.120。较低版本无法与 Platform 配合使用。
pip install "ultralytics>=8.4.120"# Set your API key export ULTRALYTICS_API_KEY="YOUR_API_KEY" # Train with project/name to stream metrics yolo train model=yolo26n.pt data=coco.yaml epochs=100 project=username/my-project name=exp1有关远程训练的更多详情,请参阅云端训练。
Platform 包含功能齐全的标注编辑器,支持:
- 手动工具:边界框、多边形、带骨架模板的关键点、定向框、分类
- 骨架模板:使用内置模板(Person、Hand、Dog、Face、Box)或自定义模板,一次性放置所有关键点
- 智能标注:使用 SAM 2.1、SAM 3 或 SAM 3.1(默认)对检测、分割、语义分割和 OBB 数据集执行点击式标注;也可以在工具栏中运行预训练的 Ultralytics YOLO 模型和你自己微调的 YOLO 模型,执行这些任务及姿态估计;或者在包含 1–200 个类别的检测数据集中运行类别提示模型:九种托管开源模型(批量标注中默认使用 Moondream 3.1,另有一种可通过 Early access 启用)、托管的文本提示 SAM 3 和 SAM 3.1,或者来自 OpenAI、Anthropic、Google、Meta、SpaceXAI、DeepSeek、Z.ai、Kimi、Xiaomi MiMo、Alibaba、MiniMax 和 Tencent 的付费视觉模型;使用 Settings > API Keys 中的提供商密钥即可
- 键盘快捷键:通过热键提高工作效率,快捷键列表可在编辑器的快捷键弹出窗口中查看
快捷键 操作 V手动(绘制)模式 S智能模式(SAM、YOLO 或类别提示模型) P预测(智能模式下) A切换自动应用(SAM 智能模式) 1-9按数字选择类别 H切换标注可见性 Space+ 拖动或按住鼠标中键拖动平移画布 Delete/Backspace删除选中的标注 Ctrl+S保存标注 Ctrl+Z撤销 Ctrl+Y重做 Escape保存 / 取消选择 / 退出 完整指南请参阅标注。
Platform 支持与 Ultralytics 导出模式相同的 23 种部署格式。PyTorch 是源格式;每个包含
format参数的行都代表一个导出目标。格式 format参数模型 元数据 参数 PyTorch - yolo26n.pt✅ - TorchScript torchscriptyolo26n.torchscript✅ imgsz,quantize,dynamic,nms,batch,deviceONNX onnxyolo26n.onnx✅ imgsz,quantize,dynamic,simplify,opset,nms,batch,data,fraction,deviceOpenVINO openvinoyolo26n_openvino_model/✅ imgsz,quantize,dynamic,nms,batch,data,fraction,deviceTensorRT engineyolo26n.engine✅ imgsz,quantize,dynamic,simplify,opset,workspace,nms,batch,data,fraction,deviceCoreML coremlyolo26n.mlpackage✅ imgsz,dynamic,quantize,nms,batch,deviceApple Core AI coreaiyolo26n.aimodel✅ imgsz,batch,quantizeTF SavedModel saved_modelyolo26n_saved_model/✅ imgsz,quantize,opset,nms,batch,data,fraction,deviceTF GraphDef pbyolo26n.pb❌ imgsz,opset,batch,deviceTF Edge TPU edgetpuyolo26n_edgetpu.tflite✅ imgsz,quantize,opset,data,fraction,deviceLiteRT litertyolo26n.tflite✅ imgsz,quantize,batch,data,fraction,devicePaddlePaddle paddleyolo26n_paddle_model/✅ imgsz,batch,deviceMNN mnnyolo26n.mnn✅ imgsz,batch,dynamic,quantize,simplify,opset,nms,deviceNCNN ncnnyolo26n_ncnn_model/✅ imgsz,quantize,deviceIMX500 imxyolo11n_imx_model/✅ imgsz,quantize,data,fraction,nms,deviceRKNN rknnyolo26n_rknn_model/✅ imgsz,batch,name,quantize,simplify,opset,data,fraction,deviceExecuTorch executorchyolo26n_executorch_model/✅ imgsz,batch,deviceAxelera axelerayolo26n_axelera_model/✅ imgsz,batch,quantize,data,fraction,deviceDEEPX deepxyolo26n_deepx_model/✅ imgsz,quantize,simplify,opset,data,optimize,deviceQualcomm QNN qnnyolo26n_qnn.onnx✅ imgsz,batch,name,quantize,simplify,opset,data,fraction,deviceHailo hailoyolo26n_hailo_model/✅ imgsz,name,quantize,data,fraction,simplify,conf,iou,deviceHuawei Ascend ascendyolo26n_ascend_model/✅ imgsz,batch,name,quantize,opset,simplify,nms,deviceAMD Xilinx xilinxyolo26n_xilinx_model/✅ imgsz,name,quantize,data,fraction,opset,simplify,deviceNXP nxpyolo26n_nxp.tflite✅ imgsz,quantize,data,fraction,devicenms=None默认输出原始结果,以便进行外部 NMS(YOLO26 在 Axelera 上保留其无 NMS 检测头)。设置nms=False以选择可用的无 NMS 检测头;不支持的格式会回退到其原生输出路径。上方的nms条目指出可通过nms=True嵌入 NMS 的格式。


评论4
提出问题、分享结果,或帮助其他人。
WDWeihua Duan 我觉得在上传数据集方面还可以再改进改进,具体说明上传的文件夹的格式,而且现在只能上传训练集images和labels,之前我们用的数据集还有验证集哪些val,需要手工改,比较麻烦,能不能自动识别
WDWeihua Duan 表达有一点错误“哪些”=“那些”
 Glenn JocherUltralytics
感谢反馈,也收到“那些”的笔误说明;关于上传,平台已支持按标准 YOLO 目录自动识别
train/val/test,无显式 split 的平铺图片上传时也可按当前目标 split 导入并在缺少划分时自动生成一部分val,可参考 Datasets 文档,如果你愿意也欢迎把你的目录树直接贴在这里,Ultralytics 团队会据此补充更清晰的中文示例。
Sebastian Borja Hello Ultralytics Support Team,
I’m currently experiencing an issue on the Ultralytics Platform while trying to train a model. My dataset is approximately 21 GB, and when I attempt to download the dataset or start training, the platform returns a “500 Internal Server Error.”
Could you please help me investigate and resolve this issue?
Details:
Dataset size: ~21 GB
Action: Download dataset / Start training
Error: 500 Internal Server Error
If helpful, I can provide the project/workspace link, timestamp of the failure, browser/OS details, and any logs or screenshots you need to diagnose it.
Thank you in advance for your support.