获得最佳 YOLOv5 训练效果的技巧#
本指南介绍如何使用 YOLOv5 获得最佳 mAP 和训练效果。
大多数情况下,只要数据集足够大且标注质量良好,无需更改模型或训练设置也能获得不错的结果。如果一开始没有取得理想效果,你可以采取一些措施来改进;但我们始终建议你在考虑任何更改之前,先使用所有默认设置进行训练。这样有助于建立性能基准并找出可改进之处。
如果你对训练结果有疑问,请尽可能提供详细信息,以便获得有帮助的答复,包括结果图(训练损失、验证损失、P、R、mAP)、PR 曲线、混淆矩阵、训练马赛克图、测试结果以及 labels.png 等数据集统计图像。这些内容都位于你的 project/name 目录中,通常是 yolov5/runs/train/exp。
以下各节介绍影响 YOLOv5 训练结果的主要因素。
数据集#
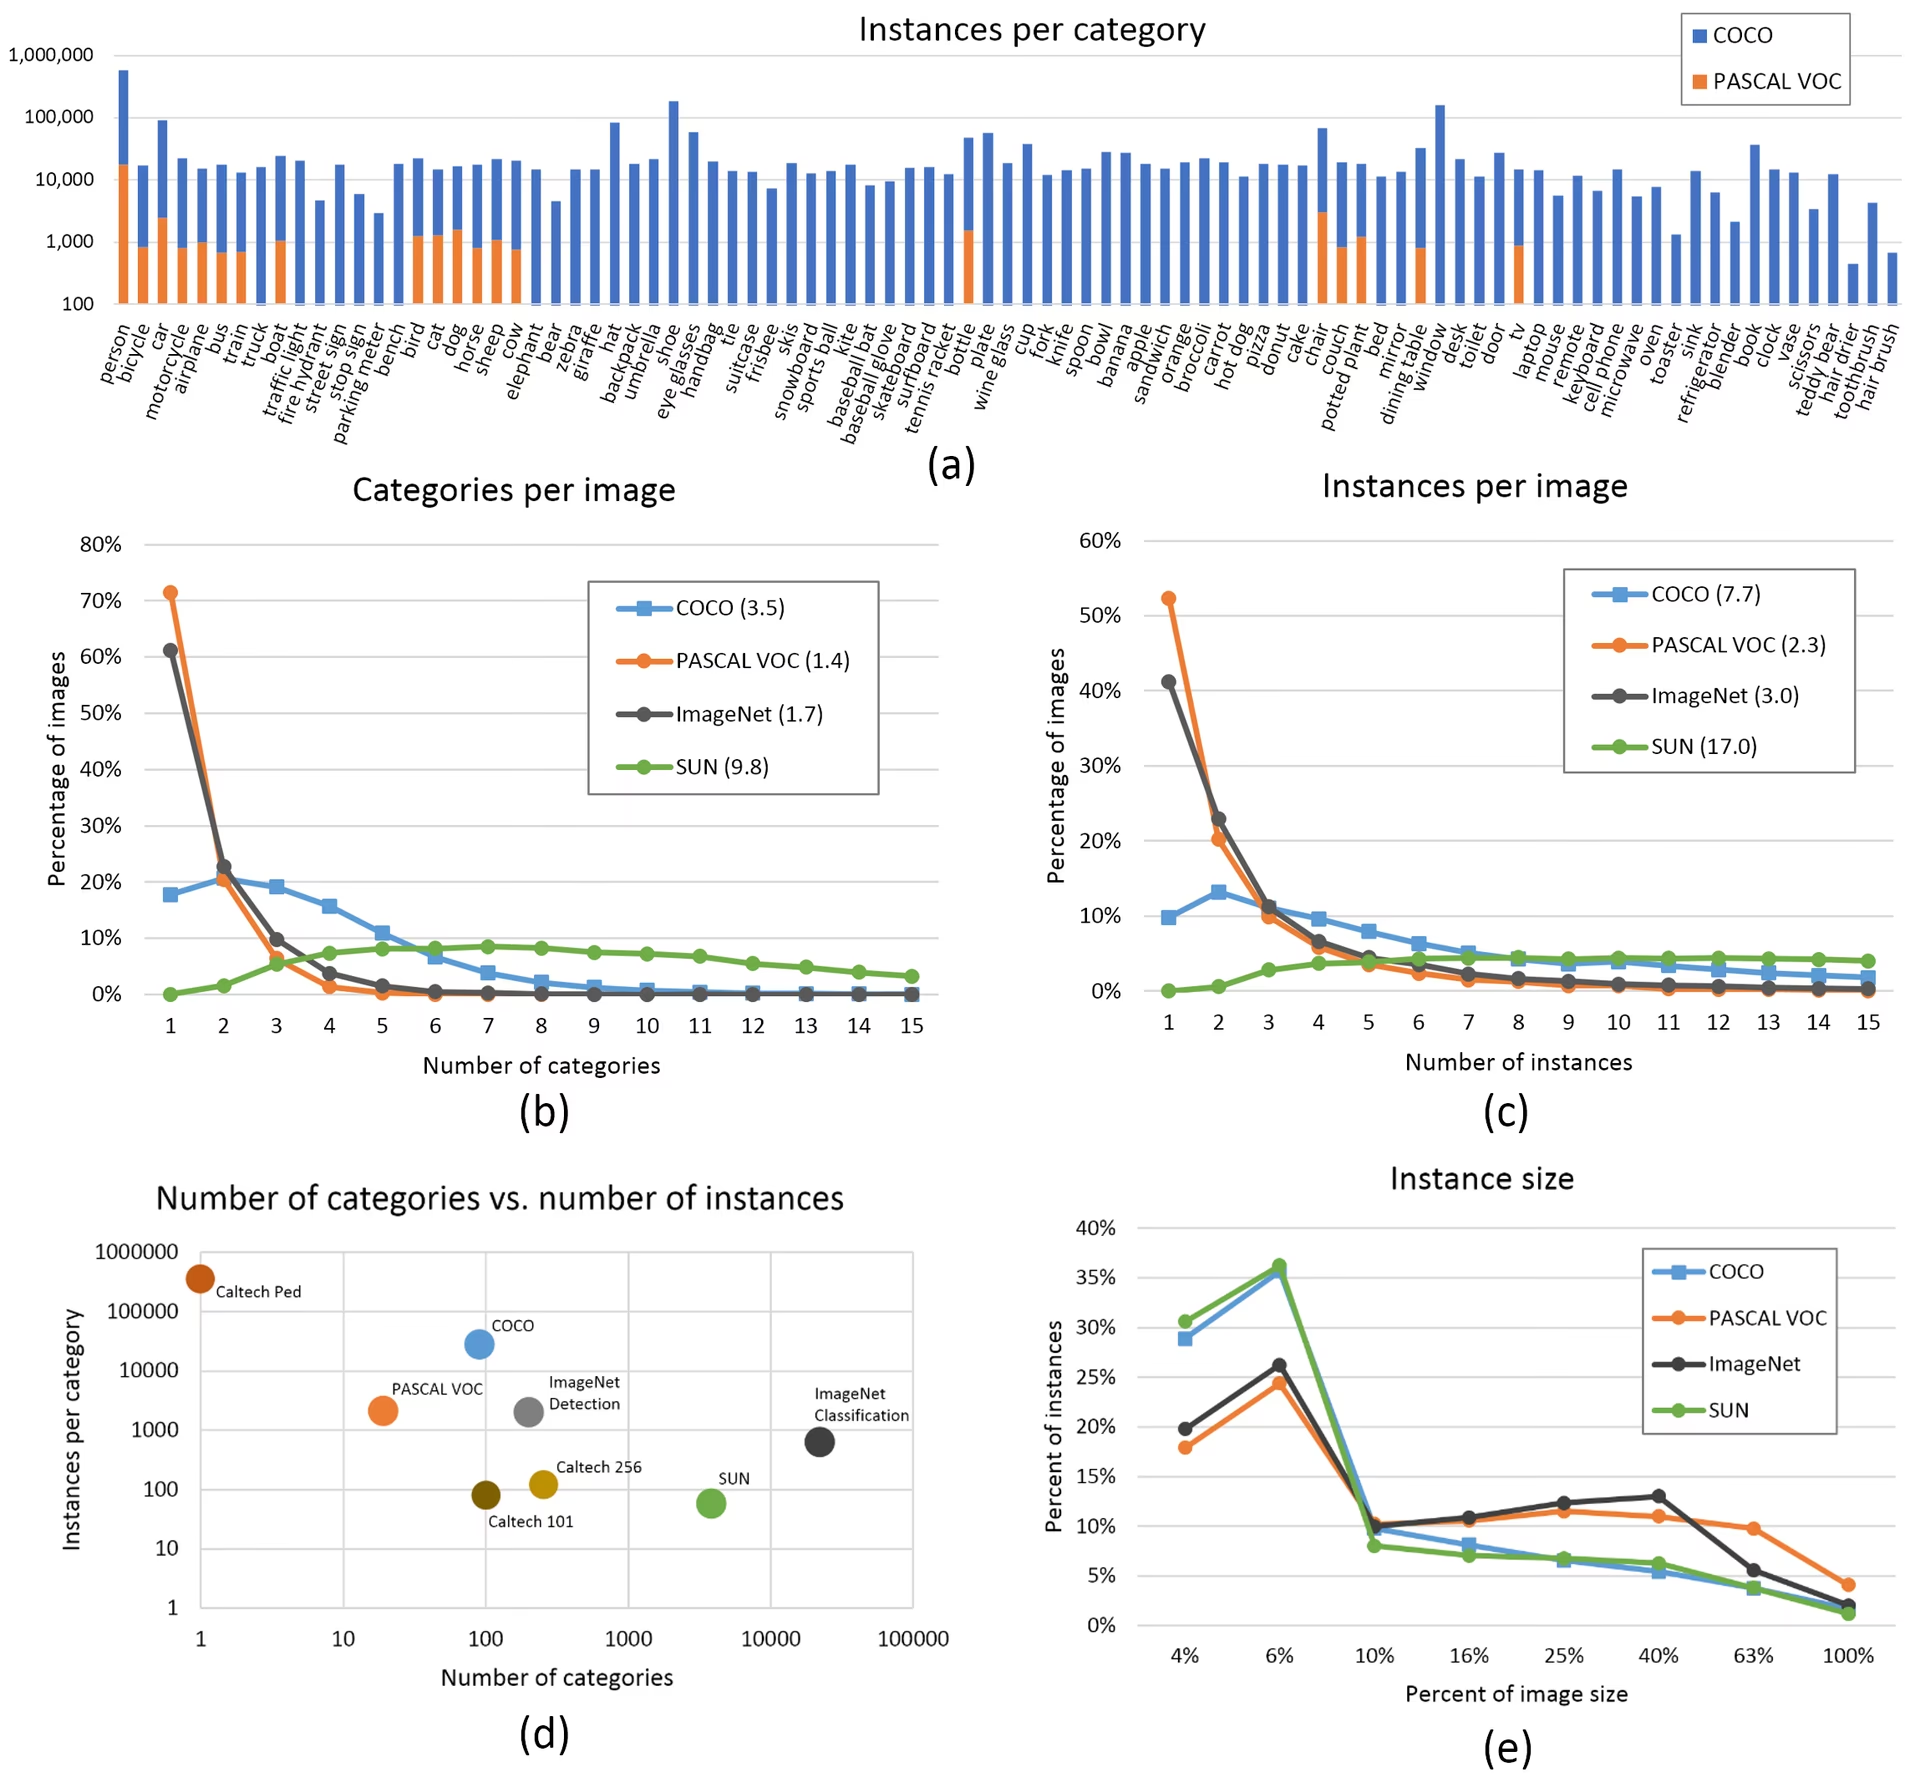
- 每个类别的图像数。 建议每个类别至少有 1500 张图像
- 每个类别的实例数。 建议每个类别至少有 10000 个实例(已标注对象)
- 图像多样性。 图像必须能代表模型的部署环境。对于实际应用场景,我们建议使用来自不同时间段、季节、天气、光照、角度和来源(网上抓取、本地收集、不同相机等)的图像。
- 标签一致性。 所有图像中的所有类别实例都必须标注。部分标注不可行。
- 标签准确性。 标签必须紧密框住每个对象。对象与其边界框之间不应留有空隙。所有对象都必须有标签。
- 训练集/验证集划分规范。 确保验证集和测试集中的图像绝不出现在训练集中,以避免指标过于乐观。保持各个划分中的类别分布相近。
- 标签验证。训练开始时查看
train_batch*.jpg马赛克图,确认标签显示正确。 - 背景图像。 背景图像是不包含对象、添加到数据集中以减少误报(FP)的图像。我们建议背景图像约占 0-10%,以帮助减少误报(COCO 有 1000 张背景图像,可作为参考,占总数的 1%)。背景图像无需标注。
模型选择#
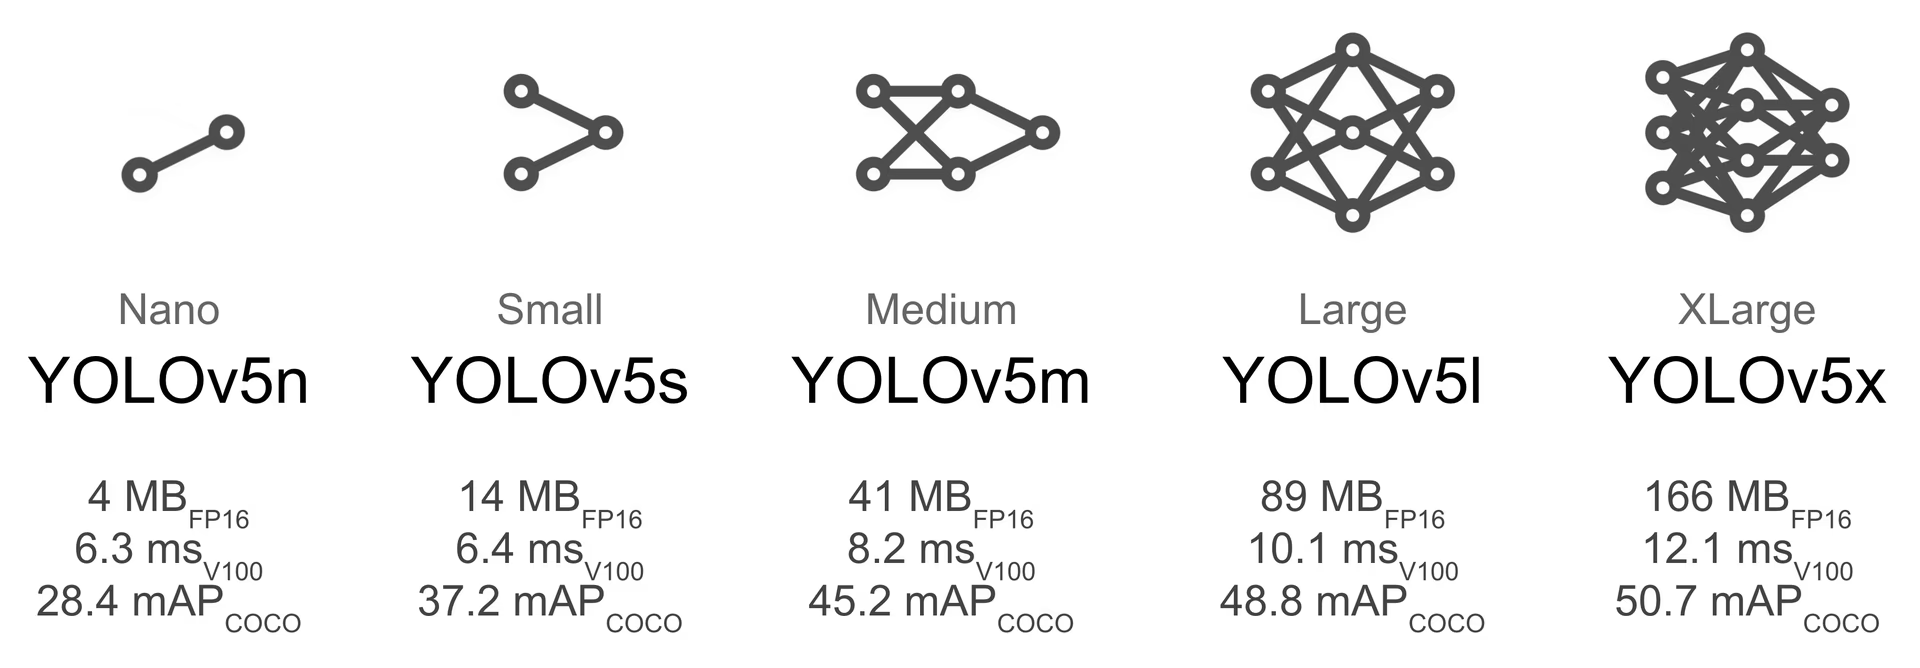
YOLOv5x 和 YOLOv5x6 等较大的模型几乎在所有情况下都能带来更好的结果,但参数更多、训练时需要更多 CUDA 内存,运行速度也更慢。对于移动端部署,我们推荐 YOLOv5s/m;对于云端部署,我们推荐 YOLOv5l/x。
-
从预训练权重开始。推荐用于中小型数据集(例如 VOC、VisDrone、GlobalWheat)。将模型名称传递给
--weights参数。模型会自动从最新 YOLOv5 版本下载。python train.py --data custom.yaml --weights yolov5s.pt python train.py --data custom.yaml --weights yolov5m.pt python train.py --data custom.yaml --weights yolov5l.pt python train.py --data custom.yaml --weights yolov5x.pt python train.py --data custom.yaml --weights custom_pretrained.pt -
从头开始训练。推荐用于大型数据集(例如 COCO、Objects365、OIv6)。传入你感兴趣的模型架构 YAML,并将
--weights ''参数留空:python train.py --data custom.yaml --weights '' --cfg yolov5s.yaml python train.py --data custom.yaml --weights '' --cfg yolov5m.yaml python train.py --data custom.yaml --weights '' --cfg yolov5l.yaml python train.py --data custom.yaml --weights '' --cfg yolov5x.yaml
训练设置#
修改任何设置之前,先使用默认设置进行训练,以建立性能基准。完整的 train.py 设置列表可在 train.py 参数解析器中找到。
- 训练轮次。从 300 个训练轮次开始。如果模型过早过拟合,可以减少轮次。如果训练 300 个轮次后仍未过拟合,则延长训练时间,例如训练 600 或 1200 个轮次。
- 图像尺寸。COCO 使用
--img 640的原始分辨率进行训练;不过,由于数据集中小目标数量很多,采用更高分辨率(例如--img 1280)训练可能会更有效。如果数据集中有许多小目标,自定义数据集也能从原始或更高分辨率训练中受益。要获得最佳推理结果,推理时应使用与训练相同的--img;例如,如果你使用--img 1280进行训练,那么测试和检测时也应使用--img 1280。 - 批次大小。 使用硬件允许的最大
--batch-size。较小的批次大小会导致批次归一化统计数据不佳,应尽量避免。你可以使用--batch-size -1自动为 GPU 选择最佳批次大小。 - 学习率。 默认学习率调度策略在大多数情况下效果良好。若想加快收敛,可以尝试使用
--cos-lr标志启用余弦学习率调度,使学习率随着训练轮数增加,沿余弦曲线逐渐降低。 - 数据增强。 YOLOv5 包含多种增强技术,例如将多张训练图像合并的马赛克增强。你可以在
--hyp文件中通过mosaic超参数调整增强强度,以帮助稳定训练。 - 超参数。 默认超参数位于 hyp.scratch-low.yaml 中。我们建议先使用默认超参数进行训练,再考虑修改。通常,增大数据增强超参数可以减少并延缓过拟合,从而支持更长时间的训练并提高最终 mAP。减小
hyp['obj']等损失分量增益超参数,有助于减少相应损失分量上的过拟合。如需自动优化这些超参数,请参阅我们的超参数演化教程。 - 混合精度训练。 检测到受支持的 GPU 时,YOLOv5 会自动启用自动混合精度 (AMP),从而加快训练并降低内存使用量,同时不损失模型精度。
- 多 GPU 训练。如果你有多个 GPU,可以使用
python -m torch.distributed.run --nproc_per_node 4 train.py ... --device 0,1,2,3启动分布式数据并行训练,从而显著缩短训练时间。 - 提前停止。 使用
--patience 50,当验证指标连续 50 轮没有提升时停止训练,以节省时间并避免过拟合。
高级优化技术#
- 迁移学习。 对于专业领域的数据集,可以从预训练权重开始,并可选择使用
--freeze冻结层,使模型适应特定任务。 - 模型剪枝。训练完成后,可以考虑剪枝模型,在精度损失很小的情况下将冗余权重置零,然后使用支持稀疏性的运行时进行部署,以提升速度。
- 模型集成。对于关键应用,可以使用不同配置训练多个模型,并集成它们的预测结果,以提高准确度。
- 测试时增强。在推理时启用 TTA:使用
--augment合并输入图像的翻转和缩放版本所产生的预测结果,从而提高预测准确度。
延伸阅读#
如果你想进一步了解,一个不错的起点是 Karpathy 的 A Recipe for Training Neural Networks,其中介绍的训练方法广泛适用于所有 ML 领域。
祝你顺利!如果还有其他问题,请告诉我们。
常见问题#
最佳批次大小取决于 GPU 内存。较大的批次大小通常能提供更好的批次归一化统计数据和训练稳定性。使用硬件能够支持且不会导致内存溢出的最大批次大小。你可以使用
--batch-size -1自动确定适合当前配置的最佳批次大小。要加快训练速度,可以尝试:使用多块 GPU 配合 DDP,使用
--cache缓存数据集,并优化批次大小(在受支持的 GPU 上会自动启用混合精度)。如果对绝对精度要求不高,也可以考虑使用 YOLOv5s 这样的较小模型变体。
评论
提出问题、分享结果,或帮助其他人。