ClearML 集成#

关于 ClearML#
ClearML 是一个开源 MLOps 平台,旨在简化机器学习工作流并节省工程时间。
- 🔨 在实验管理器中跟踪每次 YOLOv5 训练运行。
- 🔧 使用集成的 ClearML 数据版本管理工具为你的自定义训练数据进行版本管理并访问数据。
- 🔦 使用 ClearML Agent 远程训练和监控 YOLOv5 运行。
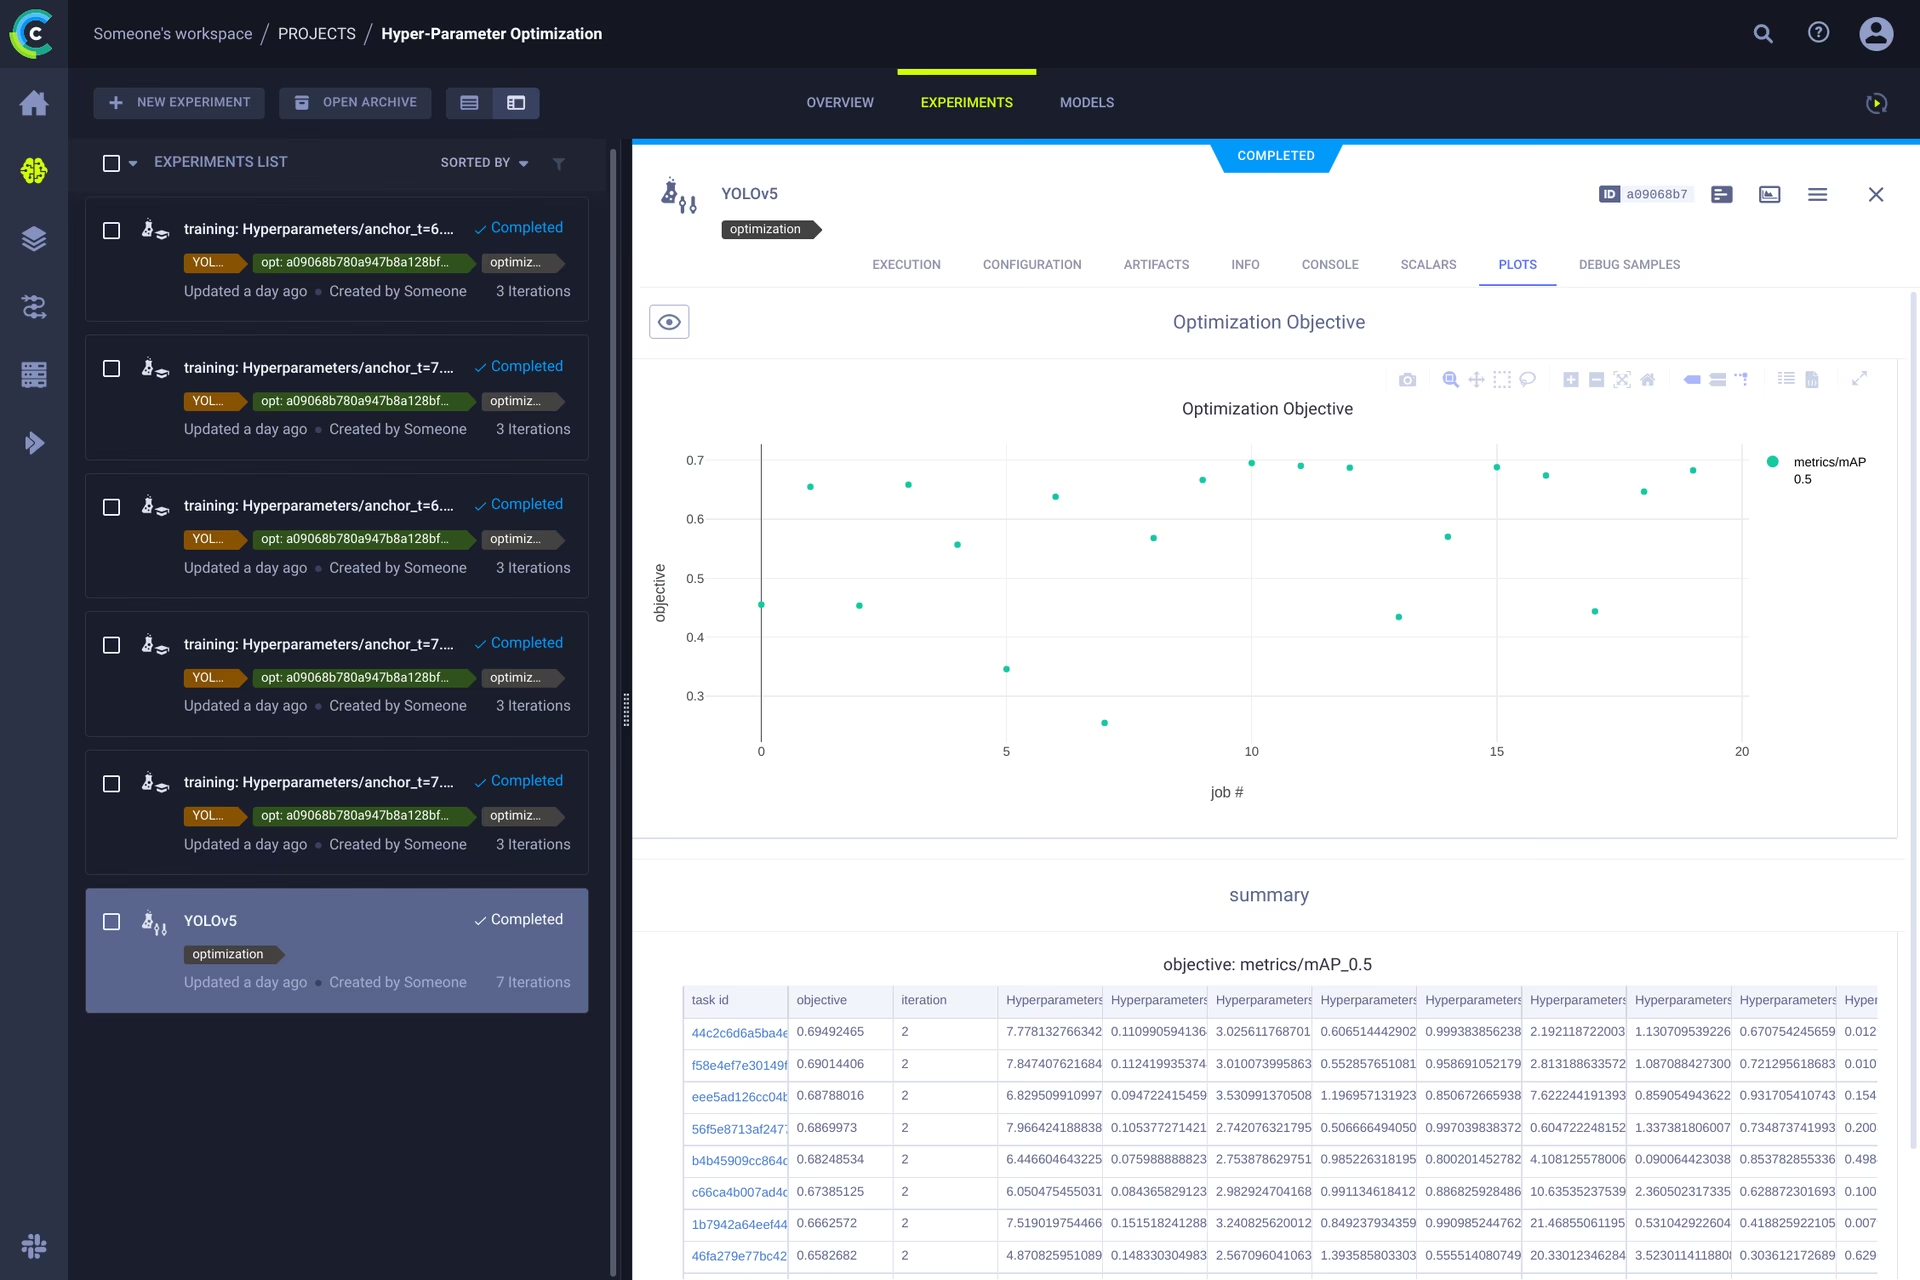
- 🔬 使用 ClearML 超参数优化找到最佳 mAP。
- 🔭 使用 ClearML Serving,只需几条命令即可将训练好的 YOLOv5 模型转换为 API。
根据需要使用这些工具,可以只从实验管理器开始,也可以将所有工具串联起来组成完整的流水线。
🦾 开始设置#
ClearML 需要与服务器通信,以跟踪实验和数据。你有两个选择:
- 注册免费的 ClearML 托管服务,或
- 部署自己的 ClearML 服务器——它是开源的,因此即使处理敏感数据,也仍然是可行的选择。
然后安装 clearml Python 软件包,并将 SDK 连接到服务器:
pip install clearml在 设置 → 工作区 → 创建新凭据(ClearML UI 右上角)生成凭据,然后运行:
clearml-init按照提示操作即可。设置完成。
🚀 使用 ClearML 训练 YOLOv5#
要启用实验跟踪,如果尚未安装 ClearML pip 软件包,请先安装:
pip install clearml这样即可将 YOLOv5 训练脚本与 ClearML 集成。从现在开始,每次训练运行都会被 ClearML 的实验管理器捕获并存储。
要自定义项目名称和任务名称,请将 --project 和 --name 传递给 train.py。默认值为 YOLOv5 和 Training。ClearML 使用 / 作为子项目分隔符,因此自定义项目名称时请避免使用 /。
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cache或者使用自定义名称:
python train.py --project my_project --name my_training --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cache每次运行都会捕获以下内容:
- 源代码和未提交的更改
- 已安装的软件包
- 超参数
- 模型检查点(使用
--save-period n每隔n个轮次保存一次) - 控制台输出
- 标量(mAP_0.5、mAP_0.5:0.95、精确率、召回率、损失、学习率)
- 机器详细信息、运行时间和创建日期
- 生成的图表,例如标签相关图和混淆矩阵
- 每个轮次中带有边界框的图像
- 每个轮次的 Mosaic 可视化结果
- 每个轮次的验证图像
所有内容都会显示在 ClearML UI 中,让你可以在一个地方监控训练。添加自定义列(例如 mAP_0.5),即可按性能最佳的模型排序;也可以选择多个实验并排比较。
继续阅读,了解超参数优化和远程执行。
🔗 数据集版本管理#
将数据与代码分开进行版本管理,便于获取最新版本并确保完全可复现。此仓库接受数据集版本 ID,在数据缺失时自动获取数据,并将 ID 记录为任务参数,以便你始终知道每个实验使用了哪个数据集。
准备数据集#
YOLOv5 仓库通过 YAML 配置文件支持许多数据集。默认情况下,数据集会下载到相对于仓库根目录的 ../datasets 文件夹中。下载 coco128 后,文件夹结构如下:
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ LICENSE
        |_ README.txt
只要保留此结构,任何数据集都可以使用。
接下来,将数据集的 YAML 文件复制到数据集根文件夹中——ClearML 会读取此文件以正确使用数据集。你可以按照示例布局编写自己的 YAML,确保其中定义了 path、train、test、val、nc 和 names。
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ coco128.yaml  # <---- HERE
        |_ LICENSE
|_ README.txt上传数据集#
要将数据集注册为有版本管理的 ClearML 数据集,请切换到其根文件夹并运行:
cd ../datasets/coco128
clearml-data sync --project YOLOv5 --name coco128 --folder .
clearml-data sync 是以下命令序列的简写,你也可以显式运行这些命令:
# Add --parent <parent_dataset_id> to base this version on a previous one.
# Duplicate files are not re-uploaded.
clearml-data create --name coco128 --project YOLOv5
clearml-data add --files .
clearml-data close
在 ClearML 数据集上训练#
注册数据集后,通过 ID 指定训练数据集:
python train.py --img 640 --batch 16 --epochs 3 --data clearml://YOUR_DATASET_ID --weights yolov5s.pt --cache👀 超参数优化#
实验和数据都完成版本管理后,你就可以在此基础上开展工作。由于每个受跟踪的实验都会捕获完整环境——代码、已安装的软件包和配置——因此运行完全可复现。ClearML 支持克隆实验、修改参数并自动重新运行,这是超参数优化(HPO)的基础。
要在本地运行 HPO,请使用附带的脚本。首先确保实验管理器中存在训练任务——脚本会克隆该任务并调整其超参数。
在 utils/loggers/clearml/hpo.py 中填写模板任务 ID,然后运行:
# Install Optuna or change the optimizer to RandomSearch.
pip install optuna
python utils/loggers/clearml/hpo.py
若要改为在远程 Agent 上运行试验,请将 optimizer.start_locally() 替换为 optimizer.start(),并在 HyperParameterOptimizer 调用中将 execution_queue 设置为 Agent 监听的队列。
🤯 远程执行(高级)#
在本地运行 HPO 很方便,但你通常会希望在更强大的硬件上运行实验,例如本地部署的 GPU 机器或云实例。ClearML Agent 就是为此而设计的:
每个受跟踪的实验都包含在另一台机器上复现该实验所需的一切内容(已安装的软件包、未提交的更改和配置)。ClearML Agent 会监听队列、获取传入的任务、重建环境、运行作业,并将标量和图表流式传回实验管理器。
使用以下命令,可将任何机器——云 VM、本地 GPU 工作站或笔记本电脑——变成 ClearML Agent:
clearml-agent daemon --queue QUEUES_TO_LISTEN_TO [--docker]克隆、编辑并加入队列#
Agent 运行后,你可以直接从 UI 为它分配工作:
- 🪄 右键单击实验并克隆它。
- 🎯 编辑其超参数。
- ⏳ 右键单击克隆的任务,并将其加入目标队列。
远程执行任务#
你也可以通过编程方式,将运行中的脚本指定为远程执行:在 ClearML logger 实例化后添加 task.execute_remotely()。将突出显示的代码行添加到 train.py:
# ...
# Loggers
data_dict = None
if RANK in {-1, 0}:
    loggers = Loggers(save_dir=save_dir, weights=weights, opt=opt, hyp=hyp, logger=LOGGER)
    if loggers.clearml:
        loggers.clearml.task.execute_remotely(queue="my_queue")  # <------ 在此处添加此行
    # ...
    # 处理自定义数据集 Artifact 链接
    data_dict = loggers.remote_dataset
# ...
完成此更改后,运行训练脚本时会执行到该行,然后打包代码并将其发送到队列。
自动扩缩工作节点#
ClearML 附带了自动扩缩器:当队列中有待处理的实验时,它们会在 AWS、GCP 或 Azure 中启动远程机器,将这些机器转换为 ClearML Agent,并在工作完成后关闭机器——因此你只需为实际运行的计算资源付费。
观看下方的入门视频:
了解更多#
如需详细了解如何将 ClearML 与 Ultralytics 模型集成,请查看我们的 ClearML 集成指南,并探索如何借助其他实验跟踪工具改进你的 MLOps 工作流。
常见问题#
不需要。app.clear.ml 提供的免费托管服务在
clearml-init后即可开箱即用。自托管是可选方案,通常适用于数据不能离开你所在网络的情况。只要
clearml包可以导入,YOLOv5 就会启用集成;因此,运行pip uninstall clearml将其卸载,即可禁用本次运行的跟踪功能。使用
clearml-data sync注册数据集,然后将其 ID 作为 data 参数传入:python train.py --data clearml://YOUR_DATASET_ID --weights yolov5s.pt。该 ID 会记录在任务中,因此每次实验都能准确知道自己使用了哪些数据。可以。在每台机器上启动一个
clearml-agent daemon,然后从界面将实验克隆并加入队列,或者编辑utils/loggers/clearml/hpo.py,让它调用optimizer.start(),并设置execution_queue,使优化器将试验任务推送到队列。