使用自定义数据训练 YOLOv5
本指南介绍如何使用 YOLOv5 模型训练自己的自定义数据集。训练自定义模型是将计算机视觉解决方案应用于特定现实场景的重要步骤,可处理通用目标检测以外的需求。
开始之前#
首先,确保已设置好所需环境。克隆 YOLOv5 仓库,并从 requirements.txt 安装所需依赖项。必须使用安装了 PyTorch>=1.8 的 Python>=3.8.0 环境。如果本地不存在模型和数据集,系统会自动从最新的 YOLOv5 发布版本下载。
git clone https://github.com/ultralytics/yolov5 # Clone the repository
cd yolov5
pip install -r requirements.txt # Install dependencies使用自定义数据训练#
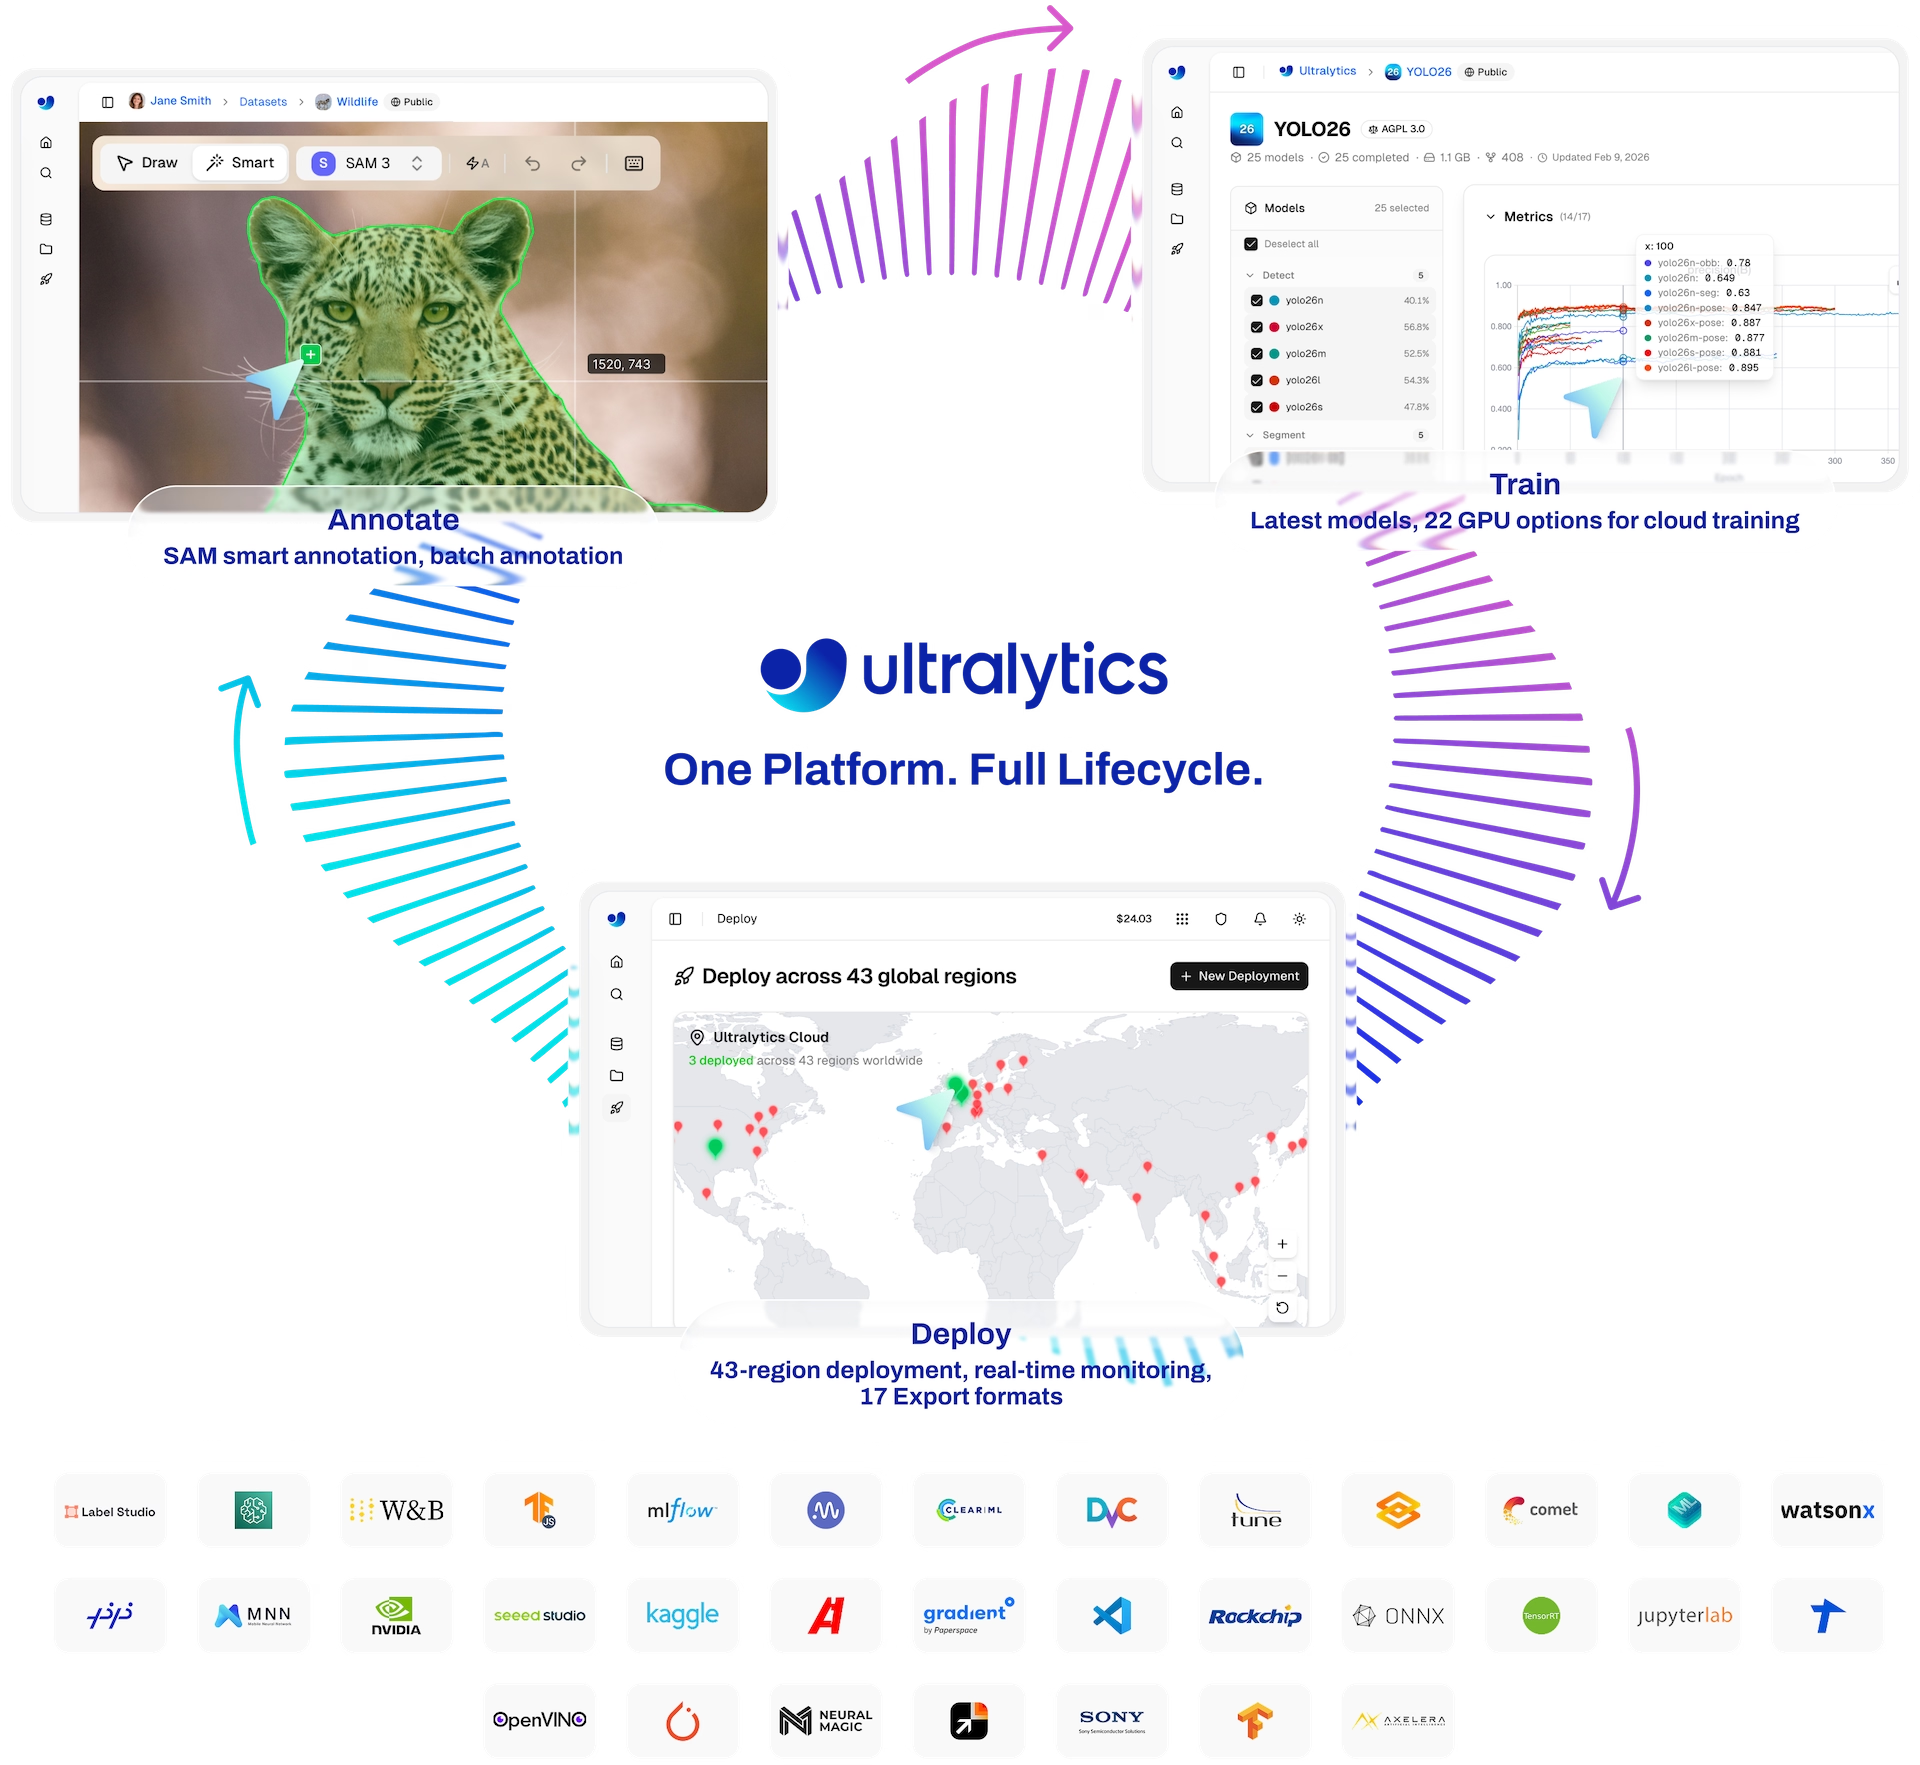
开发自定义目标检测模型是一个迭代过程:
- 收集并整理图像:收集与你的具体任务相关的图像。高质量、多样化的数据至关重要。请参阅我们的数据收集与标注指南。
- 标注对象:准确标注图像中感兴趣的对象。
- 训练模型:使用标注数据训练 YOLOv5 模型。通过使用预训练权重启动训练来利用迁移学习。
- 部署与预测:使用训练好的模型对新的、未见过的数据进行推理。
- 收集边缘案例:找出模型表现不佳的场景(边缘案例),并向数据集中添加类似数据,以提升模型的鲁棒性。重复此循环。
Ultralytics Platform 为整个机器学习运维(MLOps)周期提供免代码解决方案,涵盖数据集管理、模型训练和部署。
Ultralytics 提供两种许可选项,以适应不同的使用场景:
- AGPL-3.0 许可证:此经 OSI 批准的开源许可证非常适合热衷于开放协作和知识共享的学生、研究人员及爱好者。它要求衍生作品采用相同的许可证共享。详情请参阅 LICENSE 文件。
- 企业许可证:此许可证适用于开发和生产用途,允许将 Ultralytics 软件和 AI 模型集成到商业产品和服务中,包括内部工具、自动化工作流和生产部署,无需遵循 AGPL-3.0 的开源要求。请通过 Ultralytics Licensing 联系我们,开始使用。
在 Ultralytics 许可页面进一步了解我们的许可选项。
开始训练前,必须先准备好数据集。
1. 创建数据集#
YOLOv5 模型需要标注数据来学习各个对象类别的视觉特征。正确整理数据集至关重要。
1.1 创建 dataset.yaml#
数据集配置文件(例如 coco128.yaml)会说明数据集的结构、类别名称以及图像目录的路径。COCO128 是一个小型示例数据集,包含大型 COCO 数据集中的前 128 张图像。它适用于快速测试训练流程,并诊断过拟合等潜在问题。
dataset.yaml 文件结构包括:
path:包含数据集的根目录。train、val、test:从path到包含图像的目录或列出图像路径的文本文件的相对路径,分别用于训练集、验证集和测试集。names:将类别索引(从 0 开始)映射到对应类别名称的字典。
启动训练时,你可以将 path 设为绝对目录(例如 /home/user/datasets/coco128),也可以设为相对路径,例如从 YOLOv5 仓库根目录启动训练时使用 ../datasets/coco128。
以下是 coco128.yaml 的结构(在 GitHub 上查看):
# Dataset root directory relative to the yolov5 directory
path: ../datasets/coco128

# Train/val/test sets: specify directories, *.txt files, or lists
train: images/train2017 # 128 images for training
val: images/train2017 # 128 images for validation
test: # Optional path to test images

# Classes (example using 80 COCO classes)
names:
    0: person
    1: bicycle
    2: car
    # ... (remaining COCO classes)
    77: teddy bear
    78: hair drier
    79: toothbrush
1.2 利用模型自动标注#
手动标注是常见做法,但非常耗时。基础模型可以自动或半自动完成标注,加快数据集创建速度。以下是可用于生成标签的模型示例:
- Google Gemini:Gemini 等大型多模态模型具备强大的图像理解能力。你可以通过提示词让它们识别并定位图像中的对象,生成边界框或描述,再将其转换为 YOLO 格式标签,如链接的教程 notebook 所示。Ultralytics VLM 排行榜比较 Gemini 与其他视觉语言模型对真实检测数据集进行自动标注的准确度。
- SAM2(Segment Anything Model 2):SAM2 等专注于分割的基础模型可以高精度地识别和勾勒对象。虽然它们主要用于分割,但生成的掩码通常可以转换为边界框标注,用于目标检测任务。
- YOLO-World:该模型支持开放词汇检测。你可以提供感兴趣对象的文本描述,YOLO-World 就能在图像中定位这些对象,无需预先针对这些类别进行训练。你可以用它生成初始标签,再对标签进行完善。
使用这些模型可以预先标注数据,减少所需的人工工作量。Ultralytics Platform 智能标注可在浏览器中免代码使用 SAM、YOLO 和视觉语言模型进行预标注。不过,务必检查并完善自动生成的标签,确保其准确一致,因为标签质量会直接影响训练后 YOLOv5 模型的性能。生成(并视需要完善)标签后,请确保标签符合 YOLO 格式:每张图像对应一个 *.txt 文件,每行以 class_index x_center y_center width height 的形式表示一个对象(归一化坐标,类别从零开始索引)。如果图像中没有感兴趣的对象,则无需创建对应的 *.txt 文件。
YOLO 格式的 *.txt 文件规范如下:
- 每个对象占一行边界框。
- 每行必须包含:
class_index x_center y_center width height。 - 坐标必须归一化到 0 到 1 的范围。为此,将
x_center和width的像素值除以图像总宽度,并将y_center和height除以图像总高度。 - 类别索引从零开始(即第一个类别用
0表示,第二个类别用1表示,以此类推)。
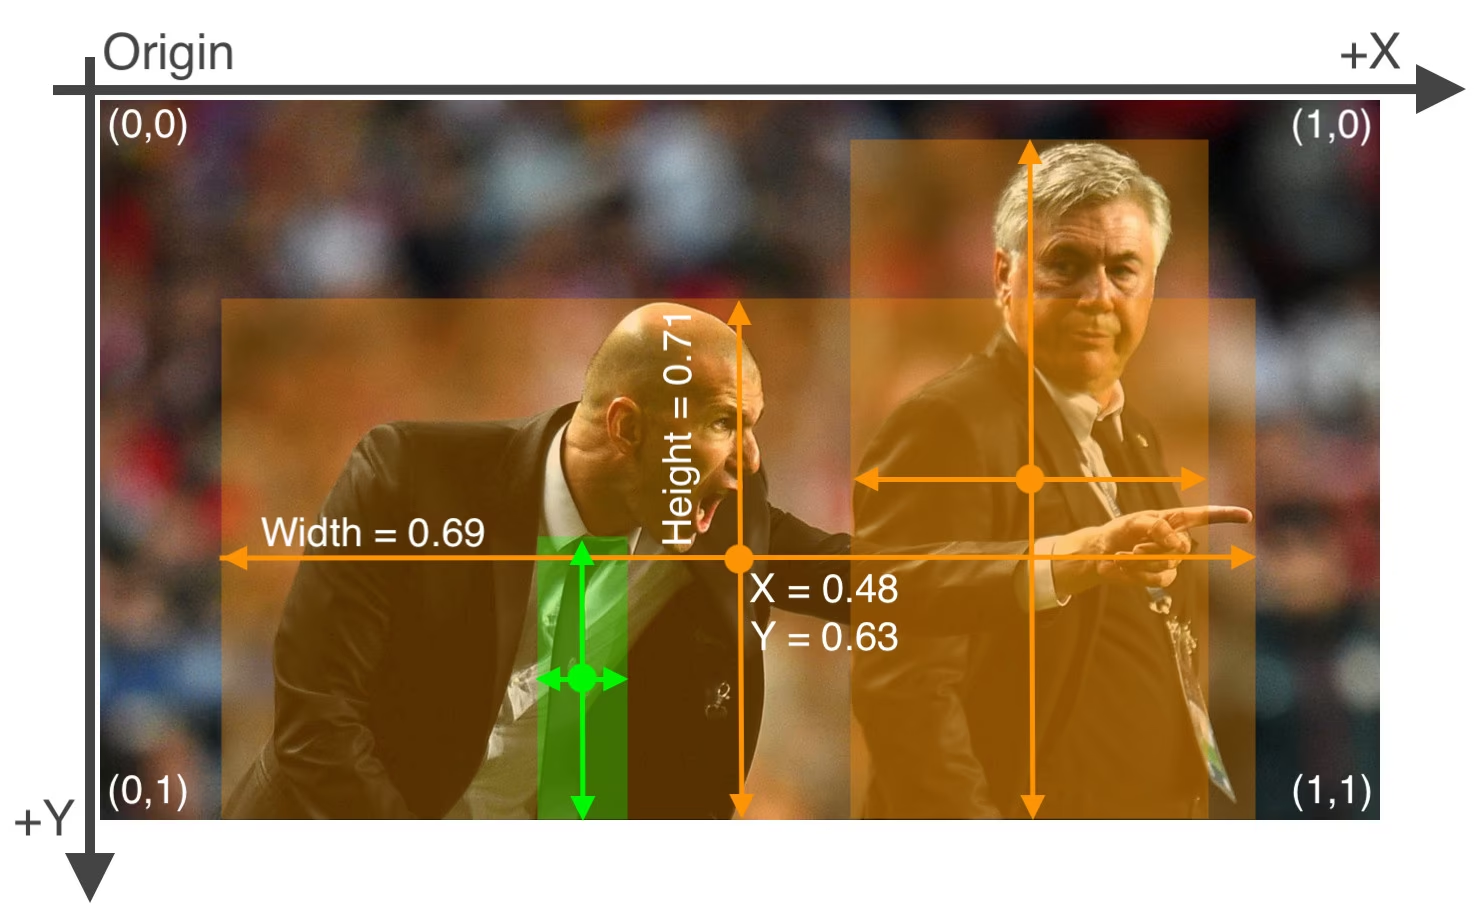
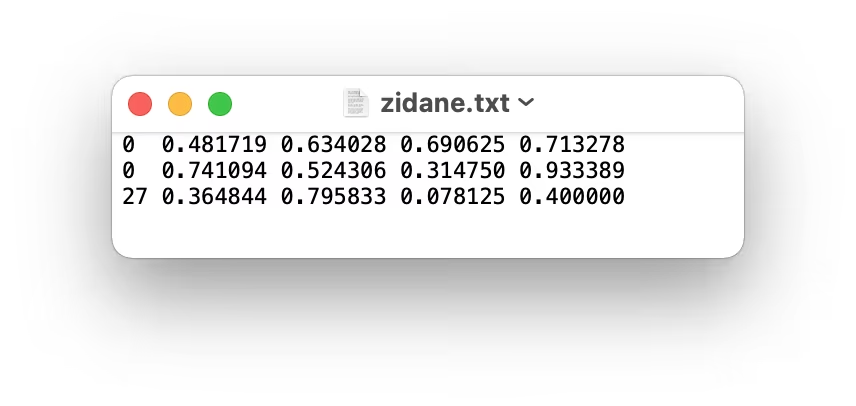
上方图像对应的标签文件中包含两个“person”对象(类别索引为 0)和一个“tie”对象(类别索引为 27),文件内容如下:
1.3 整理目录#
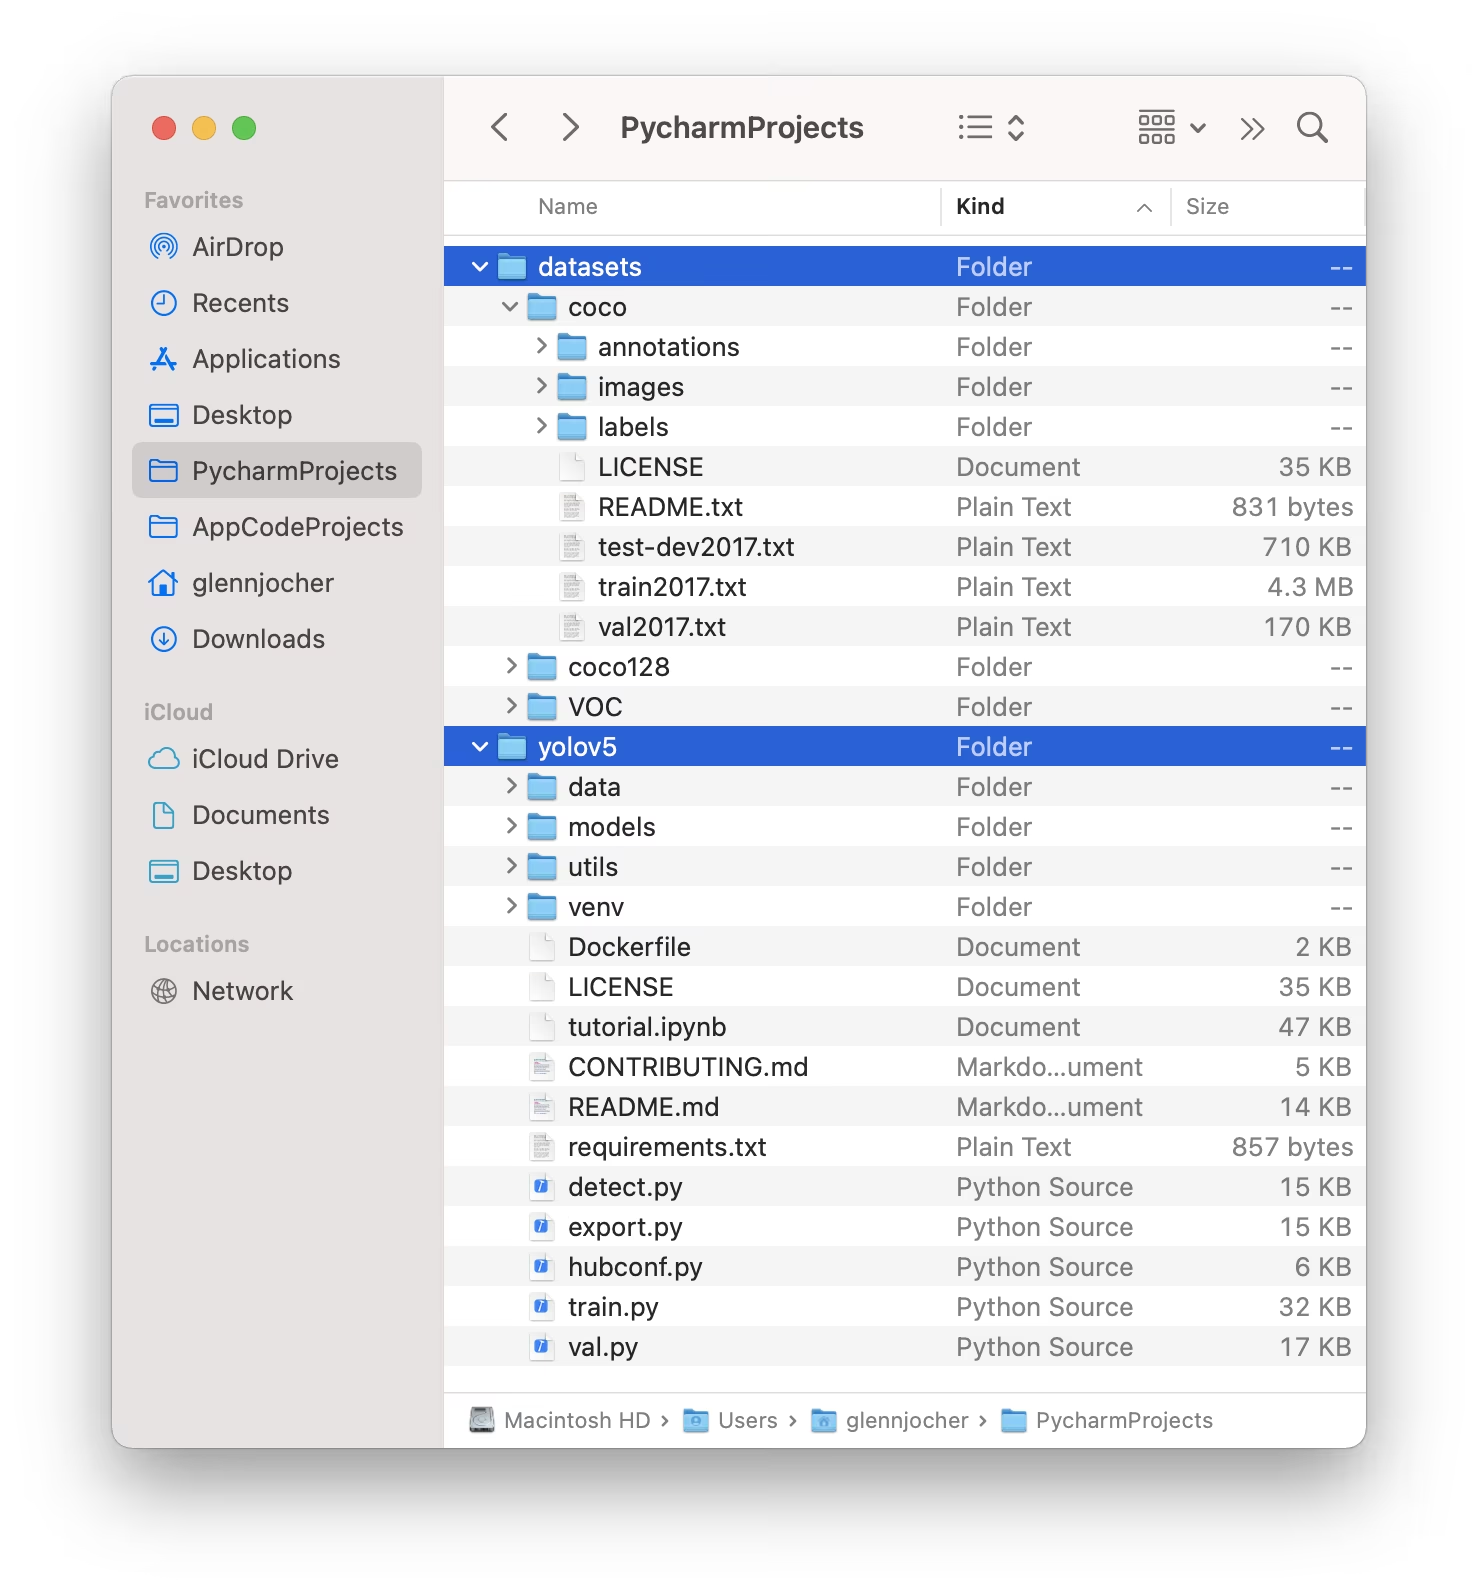
如下所示,整理你的数据集目录。默认情况下,YOLOv5 要求数据集目录(例如 /coco128)位于 /yolov5 仓库目录旁边的 /datasets 文件夹中。
YOLOv5 会将图像路径中最后一个 /images/ 替换为 /labels/,从而自动定位每张图像的标签。例如:
../datasets/coco128/images/im0.jpg # Path to the image file
../datasets/coco128/labels/im0.txt # Path to the corresponding label file
推荐的目录结构如下:
/datasets/
└── coco128/  # Dataset root
    ├── images/
    │   ├── train2017/  # Training images
    │   │   ├── 000000000009.jpg
    │   │   └── ...
    │   └── val2017/    # Validation images (optional if using same set for train/val)
    │       └── ...
    └── labels/
        ├── train2017/  # Training labels
        │   ├── 000000000009.txt
        │   └── ...
        └── val2017/    # Validation labels (optional if using same set for train/val)
            └── ...
2. 选择模型#
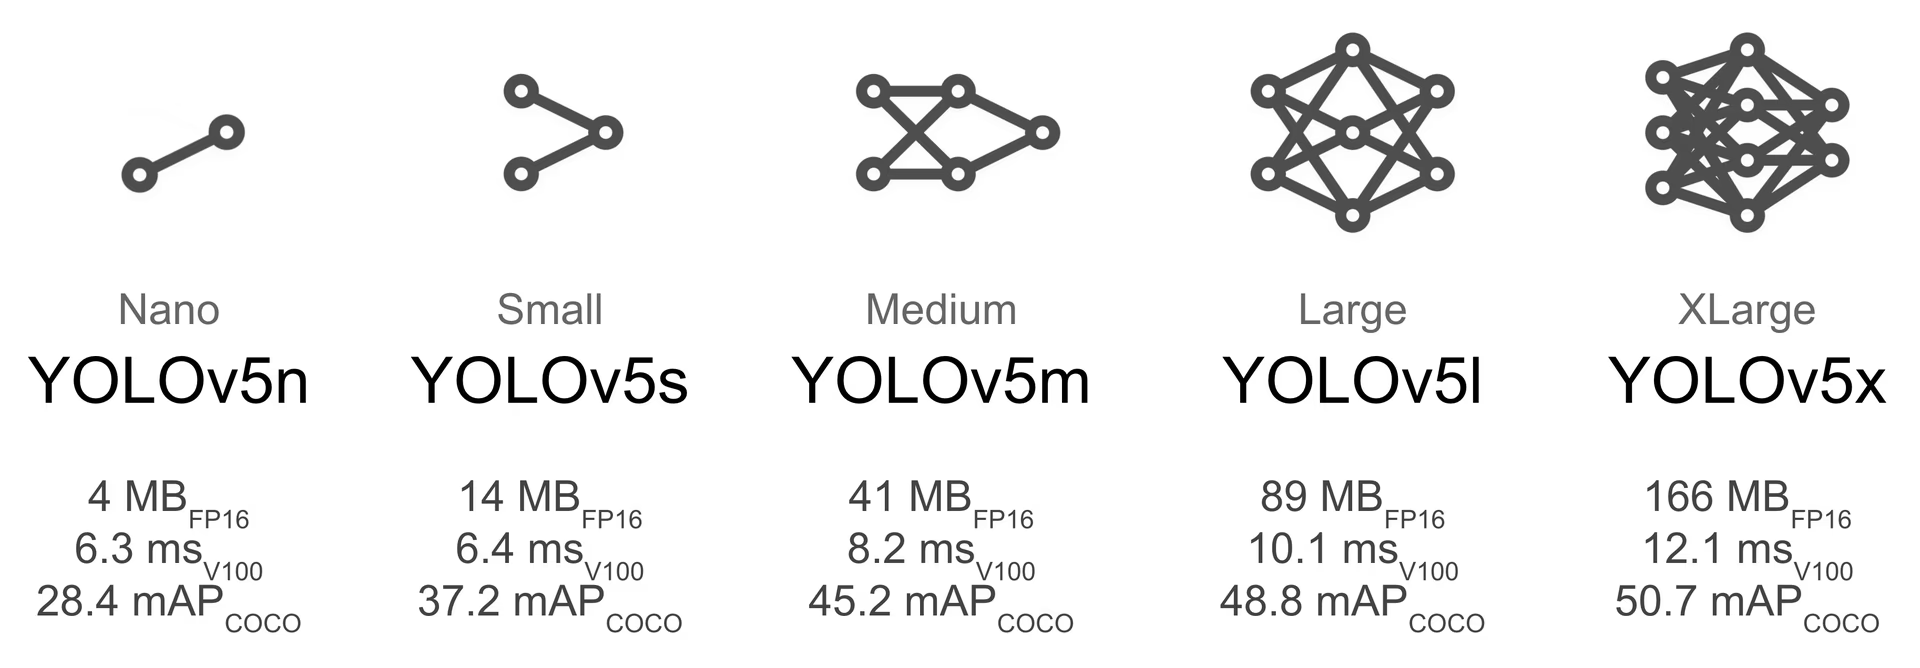
选择一个预训练模型来启动训练。与从头开始训练相比,使用预训练权重可显著加快学习速度并提升性能。YOLOv5 提供多种模型尺寸,在速度和精度之间各有不同的权衡。例如,YOLOv5s 是第二小、速度第二快的模型,适合资源受限的环境。
3. 训练#
使用 train.py 脚本开始模型训练。重要参数包括:
--img:设置输入图像尺寸(例如--img 640)。较大的尺寸通常能带来更高的精度,但需要更多 GPU 内存。--batch:设置批量大小(例如--batch 16)。请选择 GPU 能够处理的最大值。--epochs:指定训练轮数(例如--epochs 100)。一个训练轮次表示完整遍历整个训练数据集一次。--data:你的dataset.yaml文件路径(例如--data coco128.yaml)。--weights:初始权重文件的路径。建议使用预训练权重(例如--weights yolov5s.pt),以加快收敛并获得更好的结果。从头开始训练(除非你拥有非常大的数据集且有特定需求,否则不建议)时,请使用--weights '' --cfg yolov5s.yaml。
如果本地不存在预训练权重,系统会自动从最新的 YOLOv5 发布版本下载。
# Example: Train YOLOv5s on the COCO128 dataset for 3 epochs
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt使用 --cache ram 或 --cache disk,分别将数据集图像缓存到 RAM 或本地磁盘。这可以显著加快训练,尤其是在数据集 I/O(输入/输出)操作成为瓶颈时。请注意,这需要大量 RAM 或磁盘空间。
始终使用存储在本地的数据集进行训练。从网络驱动器(如 Google Drive)或远程存储访问数据可能会慢很多,从而影响训练性能。通常,最佳做法是将数据集复制到本地 SSD。
所有训练输出,包括权重和日志,都会保存在 runs/train/ 目录中。每次训练都会创建一个新的子目录(例如 runs/train/exp、runs/train/exp2 等)。如需互动式实践体验,请查看我们官方教程笔记本中的训练部分:

4. 可视化#
YOLOv5 集成了多种工具,可用于可视化训练进度、评估结果以及实时监控性能。
Comet 日志记录与可视化#
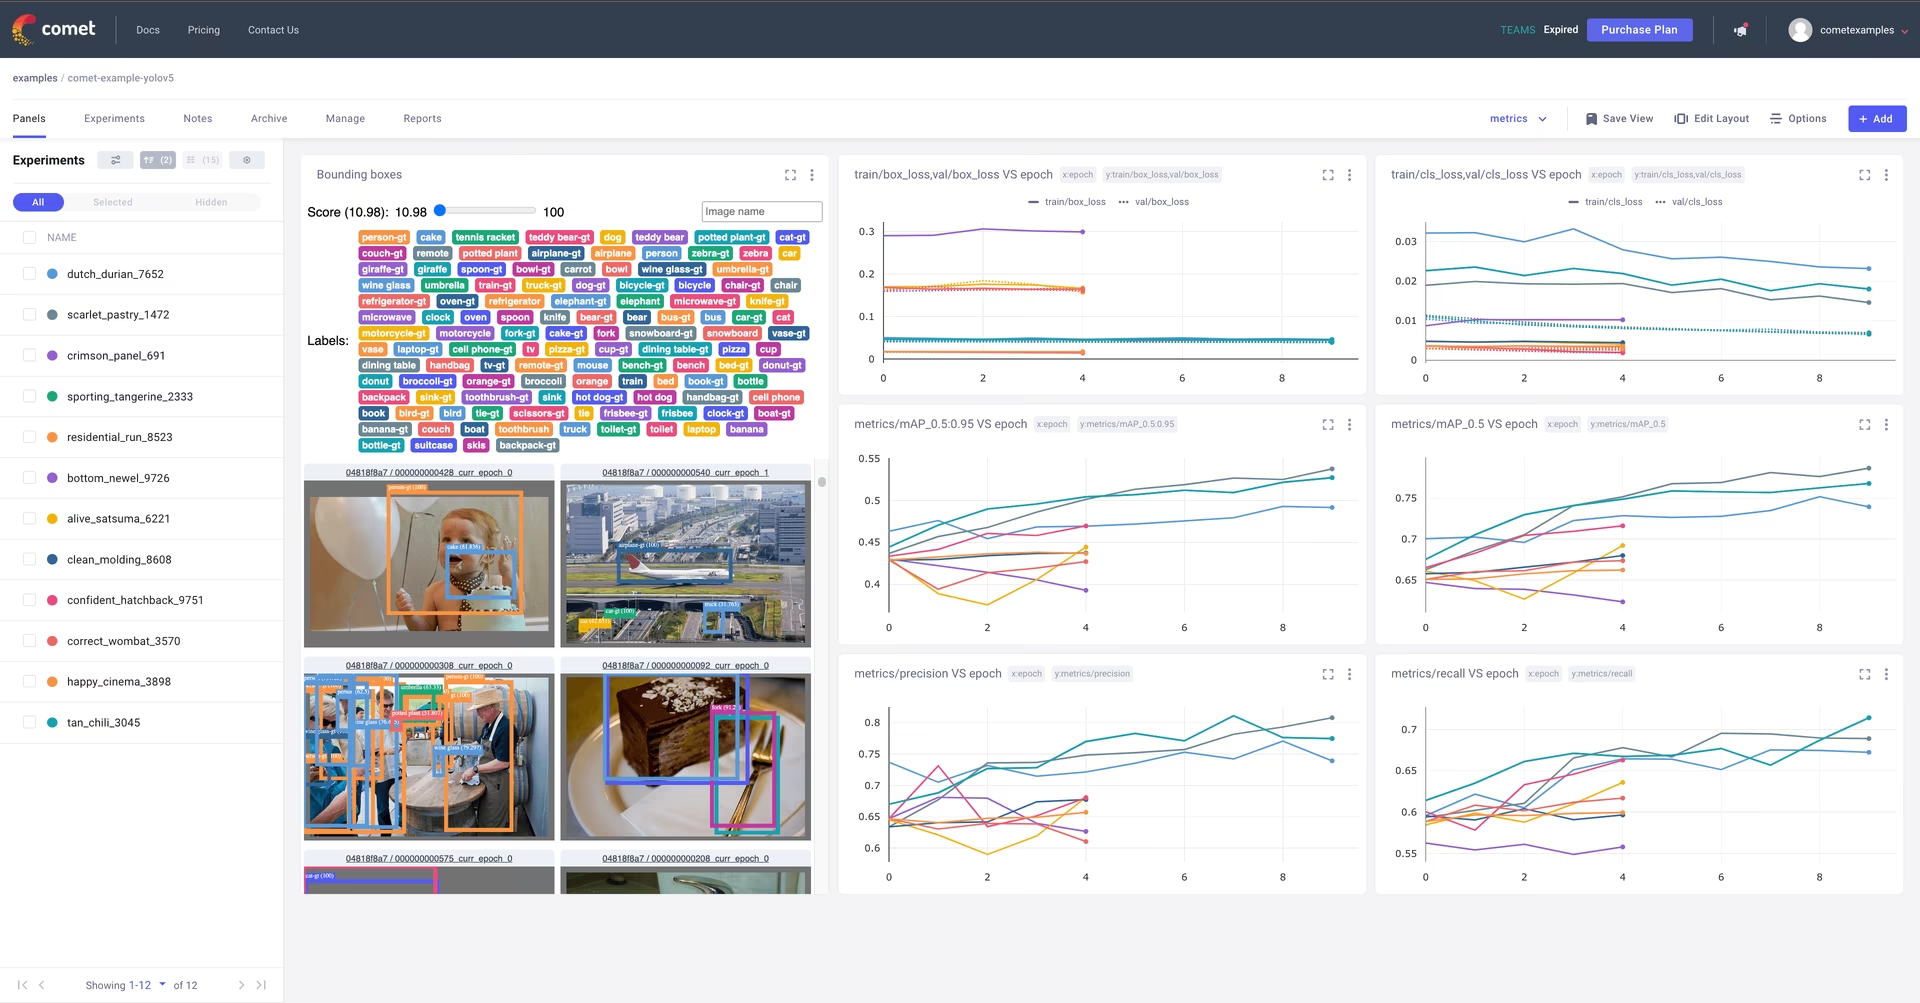
Comet 已集成,可实现完整的实验跟踪。实时可视化指标、保存超参数、管理数据集和模型检查点,并使用交互式 Comet 自定义面板分析模型预测。
开始使用非常简单:
pip install comet_ml                                                          # 1. Install Comet library
export COMET_API_KEY=YOUR_API_KEY_HERE                                        # 2. Set your Comet API key (create a free account at Comet.ml)
python train.py --img 640 --epochs 3 --data coco128.yaml --weights yolov5s.pt # 3. Train your model - Comet automatically logs everything!
试试 Comet Colab Notebook 的实时演示:
ClearML 日志记录与自动化#
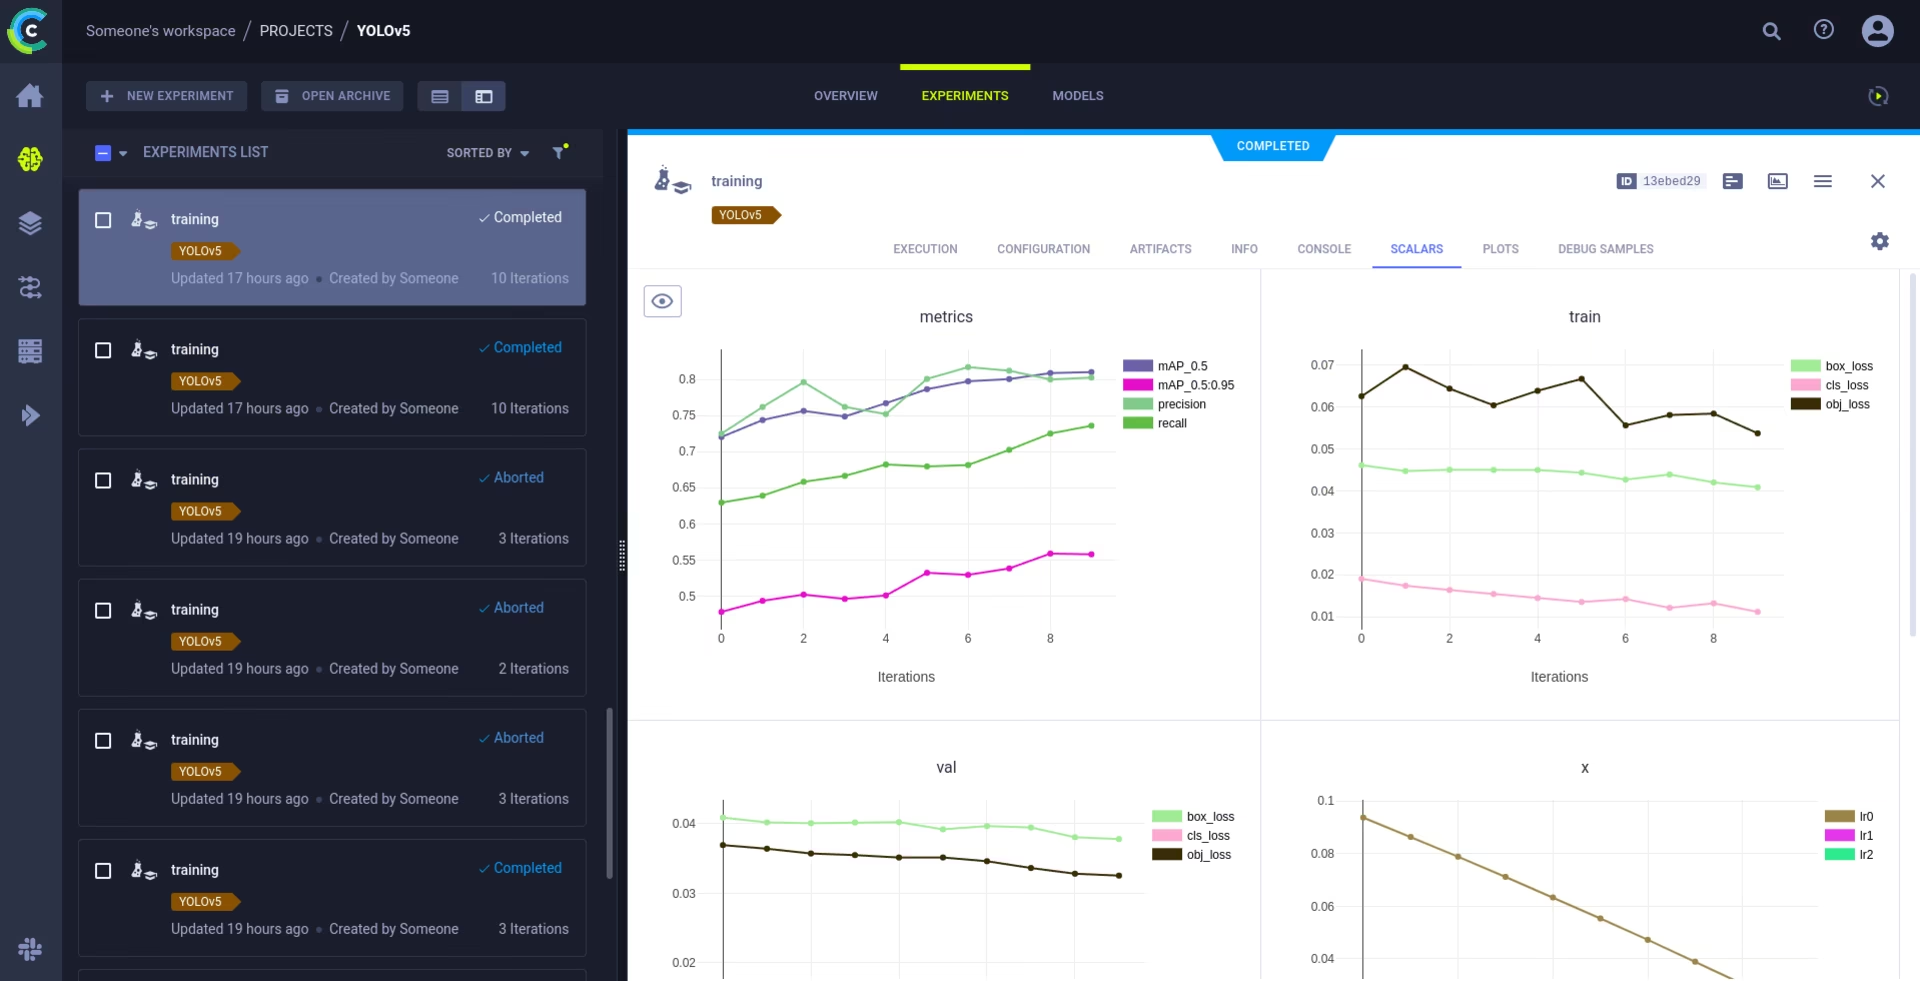
ClearML 集成支持详细的实验跟踪、数据集版本管理,甚至可以远程执行训练任务。按照以下步骤启用 ClearML:
- 安装软件包:
pip install clearml - 初始化 ClearML:运行一次
clearml-init,以连接到你的 ClearML 服务器(自托管服务器或免费套餐均可)。
ClearML 会自动记录实验详情、模型上传、比较结果、未提交的代码更改和已安装的软件包,确保实验完全可复现。你可以在远程代理上安排训练任务,并使用 ClearML Data 管理数据集版本。
本地日志记录#
训练结果会通过 TensorBoard 自动记录,并以 CSV 文件的形式保存在相应的实验目录中(例如 runs/train/exp)。记录的数据包括:
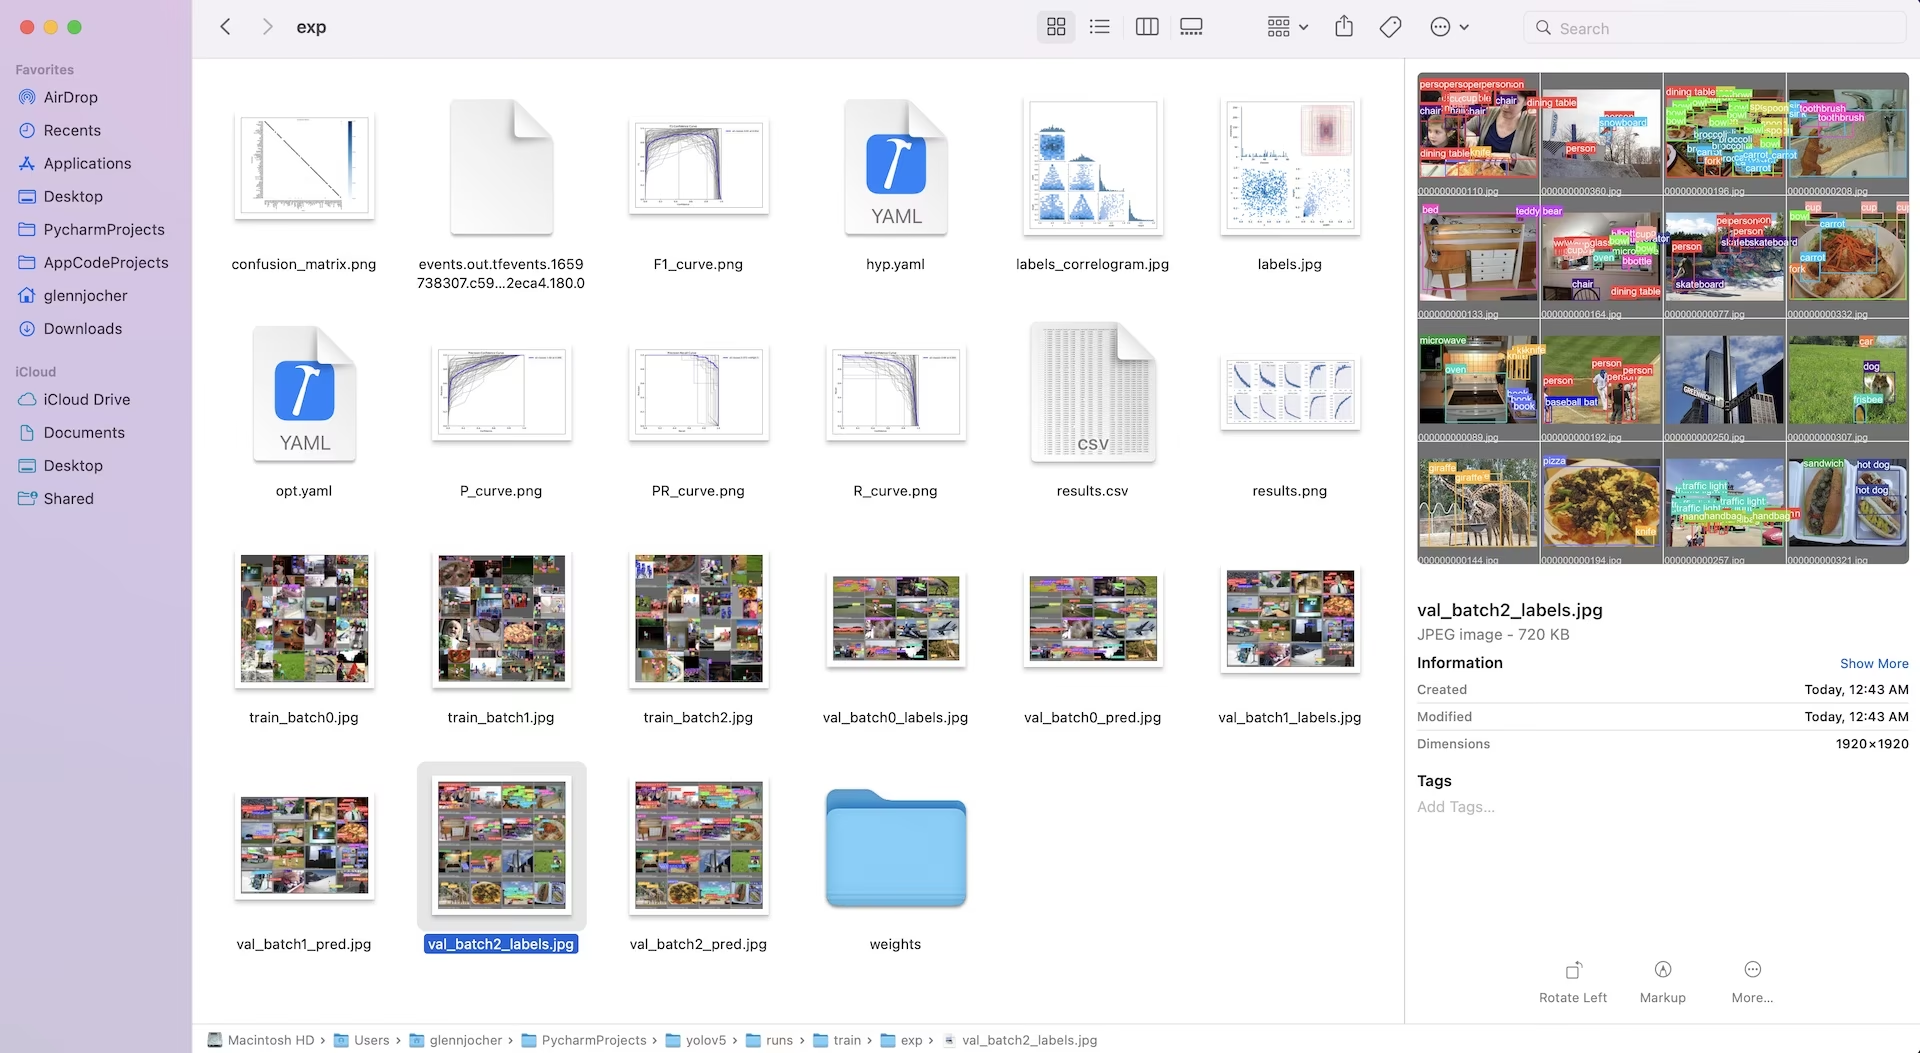
每个训练轮次结束后都会更新 results.csv 文件,并在训练完成后将其绘制为 results.png。你也可以使用提供的实用函数手动绘制任意 results.csv 文件:
from utils.plots import plot_results

# 绘制特定训练运行目录中的结果
plot_results("runs/train/exp/results.csv")  # 这将在同一目录中生成 'results.png'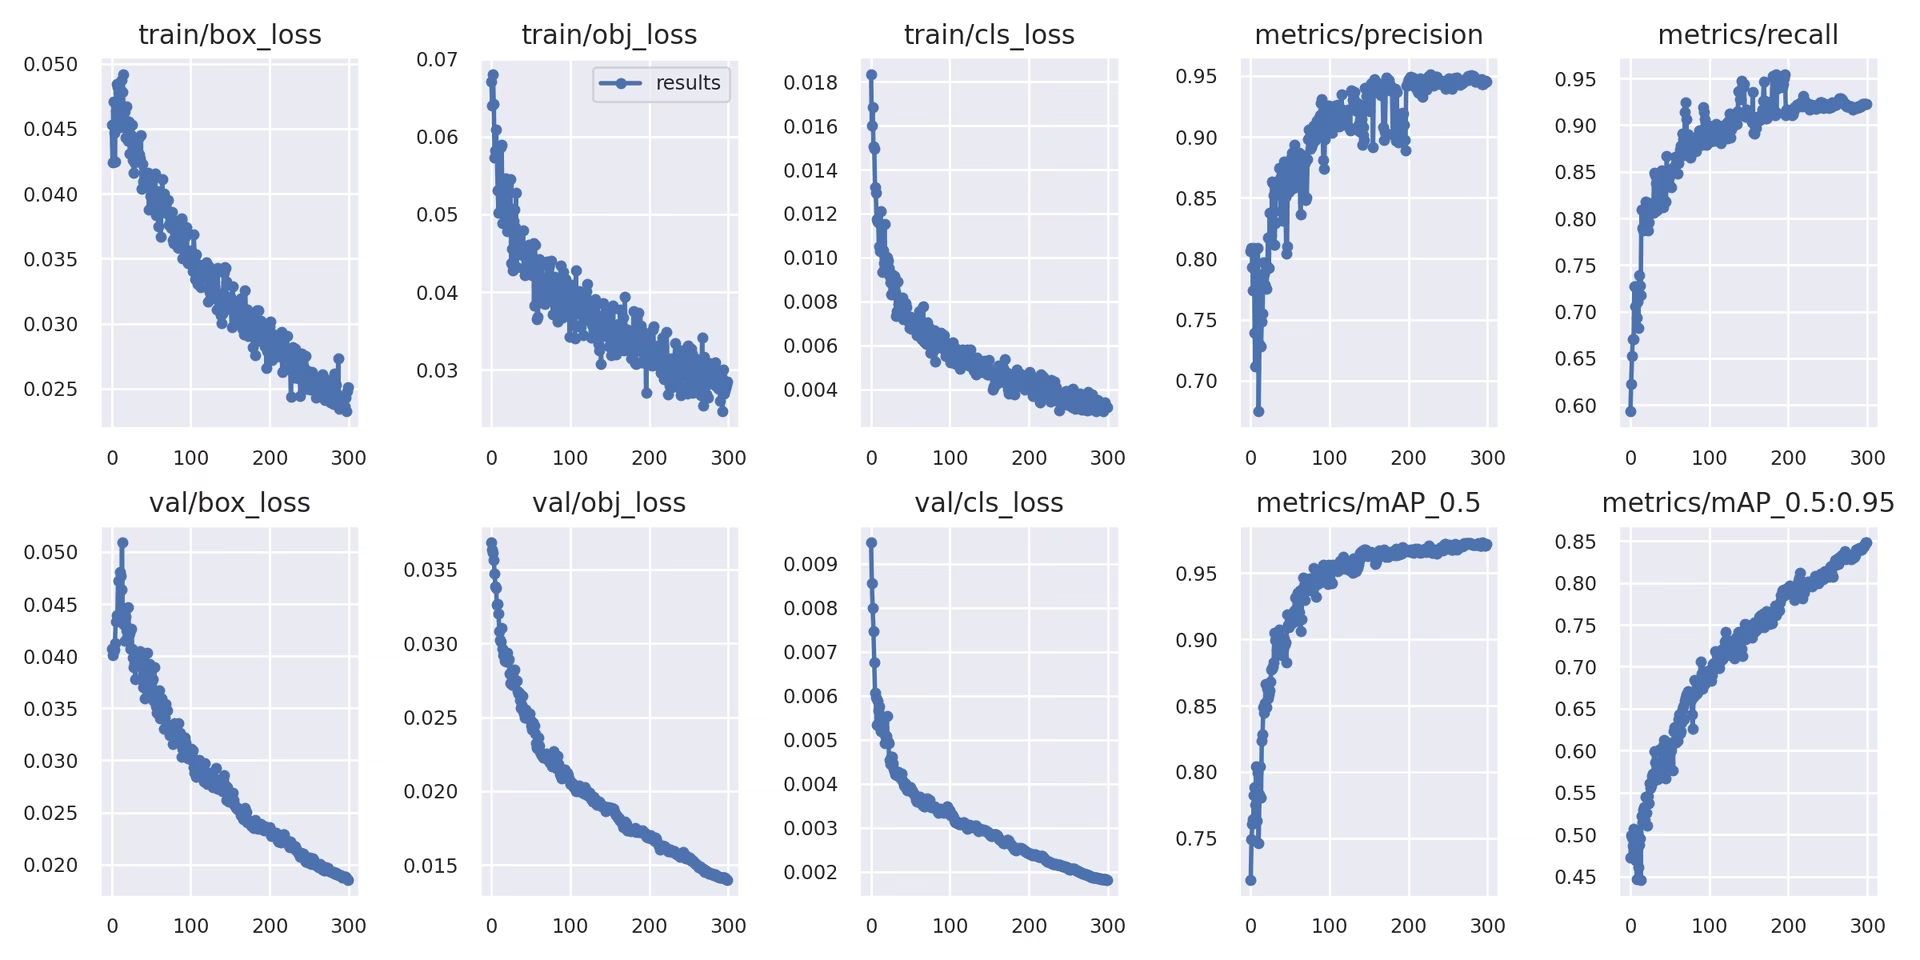
5. 后续步骤#
训练成功完成后,性能最佳的模型检查点(best.pt)会保存下来,可用于部署或进一步优化。后续可以:
- 通过 CLI 或 Python,使用训练好的模型对新图像或视频进行推理。
- 运行
val.py,评估模型在不同数据划分(例如留出的测试集)上的准确率和泛化能力。 - 将模型导出为多种部署格式,例如 ONNX、TensorFlow SavedModel 或 TensorRT,以便在不同平台上进行优化推理。
- 使用超参数进化,有望进一步提升性能。
- 请遵循我们的获得最佳训练结果的技巧,并根据性能分析不断添加更多样、更具挑战性的数据,以持续改进模型。
支持的环境#
Ultralytics 提供开箱即用的环境,其中预装了 CUDA、cuDNN、Python 和 PyTorch 等必要依赖项,助你顺利开始。
- 免费 GPU 笔记本:
- 云平台:
- Google Cloud:GCP 快速入门指南
- Amazon AWS:AWS 快速入门指南
- Microsoft Azure:AzureML 快速入门指南
- 本地设置:
- Docker:Docker 快速入门指南
- Docker:Docker 快速入门指南


项目状态#

此徽章表示所有 YOLOv5 GitHub Actions 持续集成(CI)测试均已通过。这些 CI 测试涵盖核心功能,包括训练、验证、推理、导出和基准测试,并在 macOS、Windows 和 Ubuntu 操作系统上运行。测试每 24 小时自动执行一次,并在每次代码提交时执行。
常见问题#
在自定义数据集上训练 YOLOv5 包含几个关键步骤:
- 准备数据集:收集图像并进行标注。确保标注符合所需的 YOLO 格式。将图像和标签整理到
train/和val/(以及可选的test/)目录中。你可以考虑使用 Google Gemini、SAM2 或 YOLO-World 等模型来辅助或自动完成标注(参见第 1.2 节)。 - 设置环境:克隆 YOLOv5 仓库,并使用
pip install -r requirements.txt安装依赖项。git clone https://github.com/ultralytics/yolov5 cd yolov5 pip install -r requirements.txt - 创建数据集配置:在
dataset.yaml文件中定义数据集路径、类别数量和类别名称。 - 开始训练:运行
train.py脚本,并提供dataset.yaml的路径、所需的预训练权重(例如yolov5s.pt)、图像尺寸、批次大小和训练轮数。python train.py --img 640 --batch 16 --epochs 100 --data path/to/your/dataset.yaml --weights yolov5s.pt
- 准备数据集:收集图像并进行标注。确保标注符合所需的 YOLO 格式。将图像和标签整理到
Ultralytics Platform 涵盖 YOLO 模型开发的整个生命周期,通常无需编写任何代码。主要优势包括:
- 简化训练:通过 Web 界面在预配置的云环境中训练模型。
- 集成数据管理:在平台中上传、管理数据集并进行版本控制。
- 实时监控:跟踪训练进度,并在性能指标不断传入时将其可视化。
- 协作功能:通过共享资源、项目管理工具和便捷的模型共享,促进团队协作。
- 无代码部署:将训练好的模型直接部署到各种目标平台。
如需了解实际操作流程,请查看我们的博客文章:如何使用 Ultralytics Platform 训练自定义模型。
无论你是手动标注,还是使用自动化工具(例如第 1.2 节中提到的工具),最终标签都必须符合 YOLOv5 所需的特定 YOLO 格式:
- 为每张图像创建一个
.txt文件。文件名应与图像文件名一致(例如,image1.jpg对应image1.txt)。将这些文件放在与你的images/目录同级的labels/目录中(例如../datasets/mydataset/labels/train/)。 .txt文件中的每一行表示一个对象标注,格式如下:class_index center_x center_y width height。- 坐标(
center_x、center_y、width、height)必须相对于图像尺寸进行归一化(取值在 0.0 到 1.0 之间)。 - 类别索引从 0 开始(第一个类别是
0,第二个类别是1,依此类推)。
许多手动标注工具都支持直接导出为 YOLO 格式。如果使用自动化模型,你需要通过脚本或流程将其输出(例如边界框坐标、分割掩码)转换为这种特定的归一化文本格式。确保最终数据集结构符合指南中的示例。详情请参阅我们的数据收集和标注指南。
- 为每张图像创建一个
Ultralytics 提供灵活的许可方案,以满足不同需求:
- AGPL-3.0 许可证:此开源许可证适用于学术研究、个人项目,以及可以接受遵守开源要求的场景。它要求修改内容和衍生作品也必须在 AGPL-3.0 许可下开源。请查看 AGPL-3.0 许可证详情。
- 企业许可证:面向将 YOLOv5 集成到专有产品或服务中的企业的商业许可证。此许可证免除 AGPL-3.0 的开源义务,允许闭源分发。访问我们的许可页面了解详情,或申请企业许可证。
选择最符合你的项目需求和分发模式的许可证。


评论
提出问题、分享结果,或帮助其他人。