掌握在 Google Cloud Platform (GCP) 深度学习虚拟机上部署 YOLOv5#
Google Cloud Platform (GCP) 是一个云计算平台,其深度学习 VM 已预先配置,可用于数据科学和机器学习(ML)任务。本教程将介绍如何在 GCP 深度学习 VM 上设置 Ultralytics YOLOv5。无论你是刚开始接触 ML,还是经验丰富的从业者,本教程都将清晰地指导你使用 YOLOv5 训练和运行目标检测模型。
GCP 新用户还可以领取 $300 免费额度优惠,开始使用。
YOLOv5 的其他快速入门选项包括我们的 Google Colab Notebook  ,可在浏览器中使用;或者选择具备可扩展性的 Amazon AWS。你也可以使用我们在 Docker Hub 上提供的官方 Docker 镜像

步骤 1:创建并配置深度学习虚拟机#
首先创建一台针对深度学习优化的虚拟机:
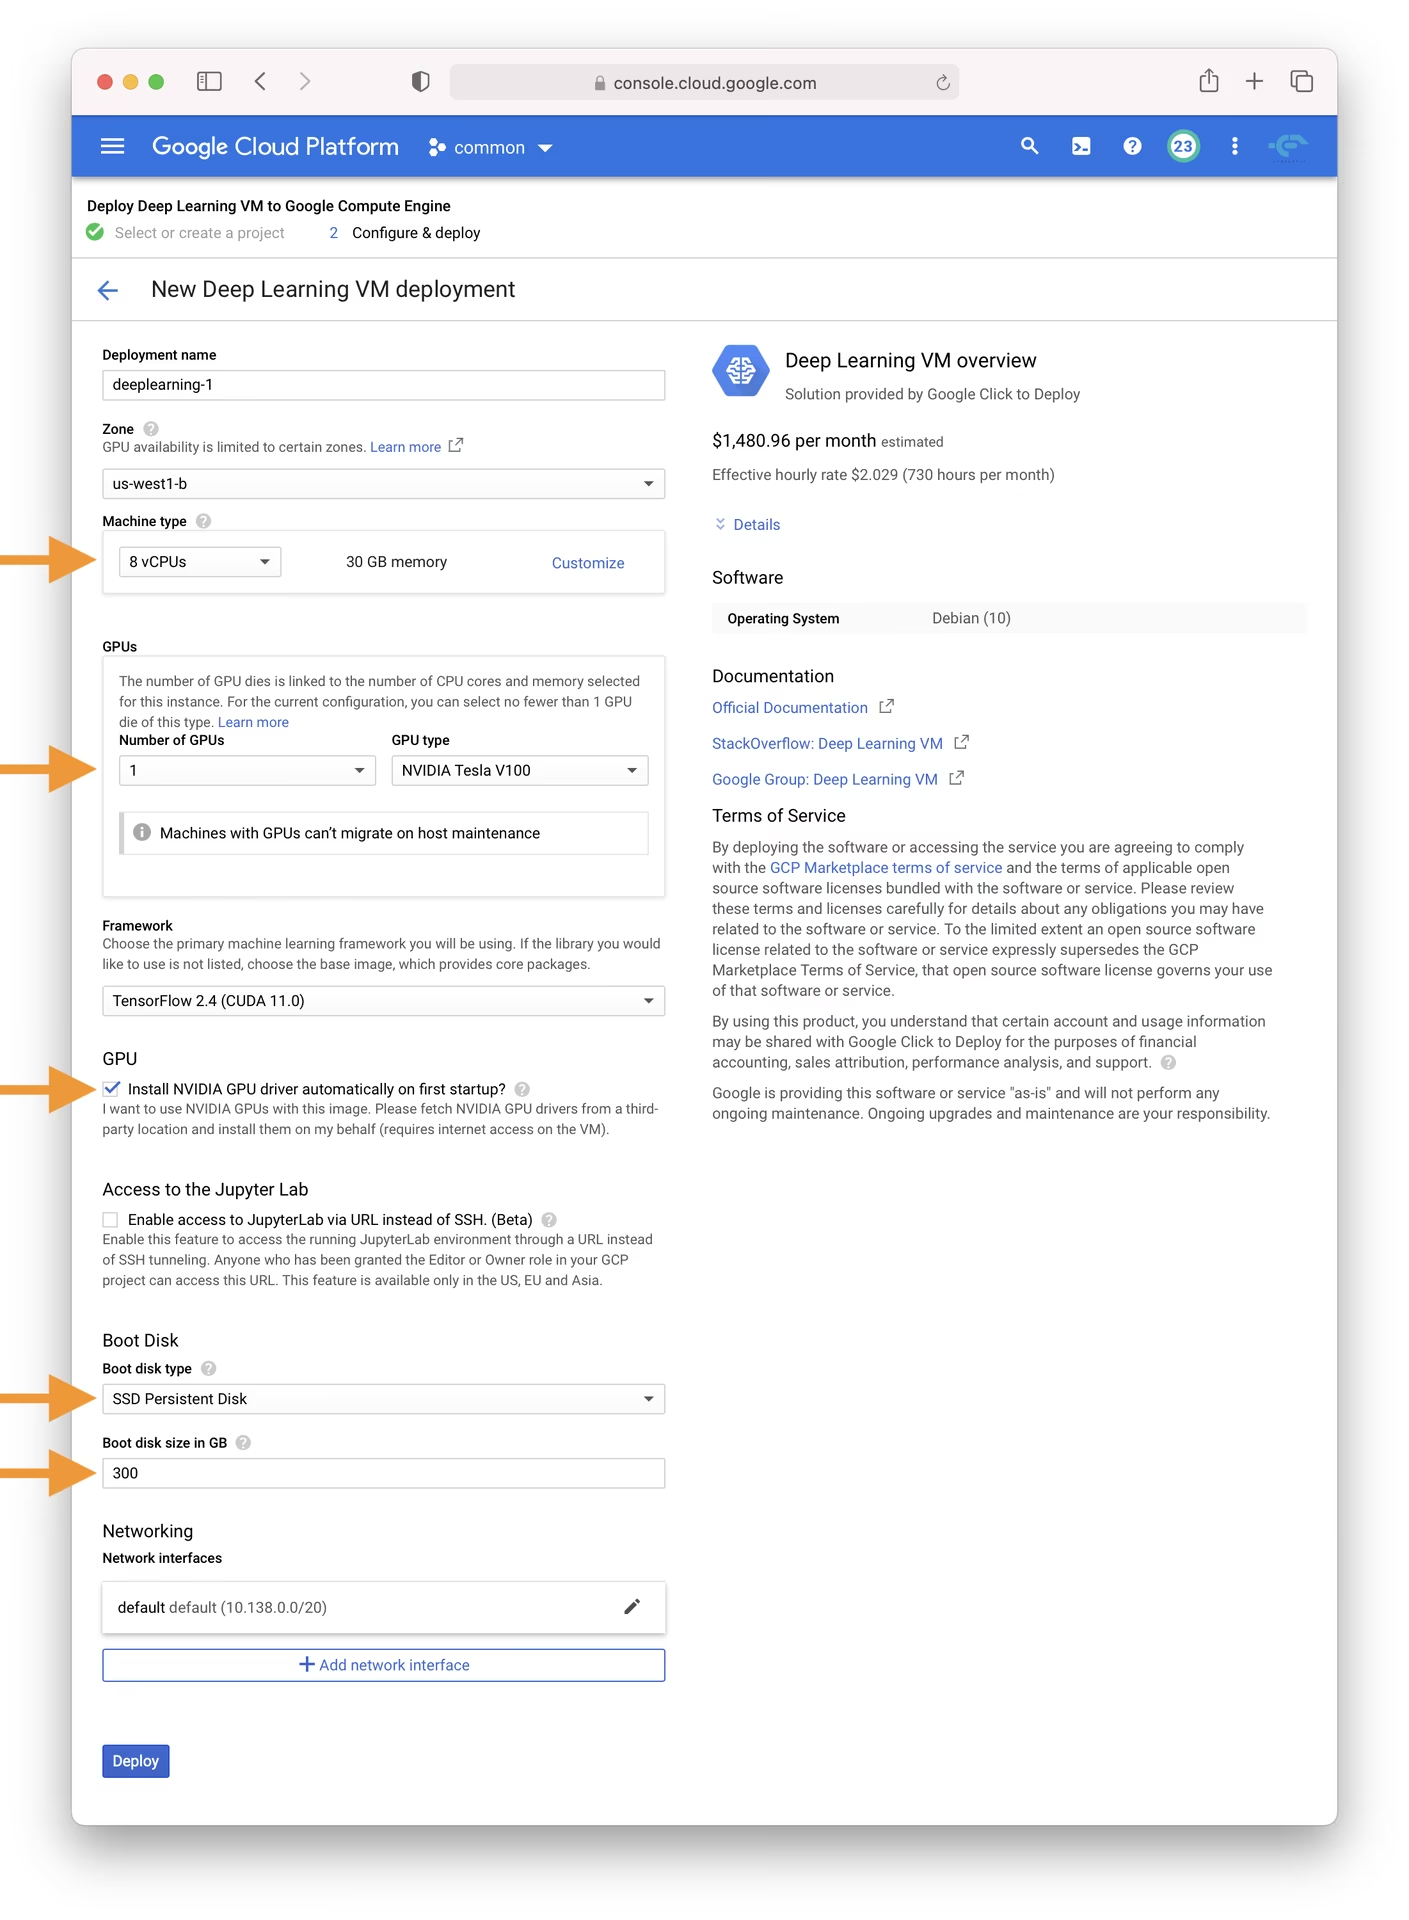
- 前往 GCP Marketplace,然后选择 Deep Learning VM。
- 选择 n1-standard-8 实例;它配备 8 个 vCPU 和 30 GB 内存,适用于许多 ML 任务。
- 选择一个 GPU。具体选择取决于你的工作负载;即使是基础款 T4 GPU,也能显著加快模型训练。
- 勾选“首次启动时自动安装 NVIDIA GPU 驱动程序?”复选框。
- 分配一块 300 GB SSD 持久磁盘,以避免 I/O 瓶颈。
- 点击“Deploy”,等待 GCP 配置你的自定义深度学习虚拟机。
这台虚拟机预装了多种必要工具和框架,包括 Anaconda Python 发行版,其中集成了 YOLOv5 所需的许多依赖项。
步骤 2:为 YOLOv5 准备虚拟机#
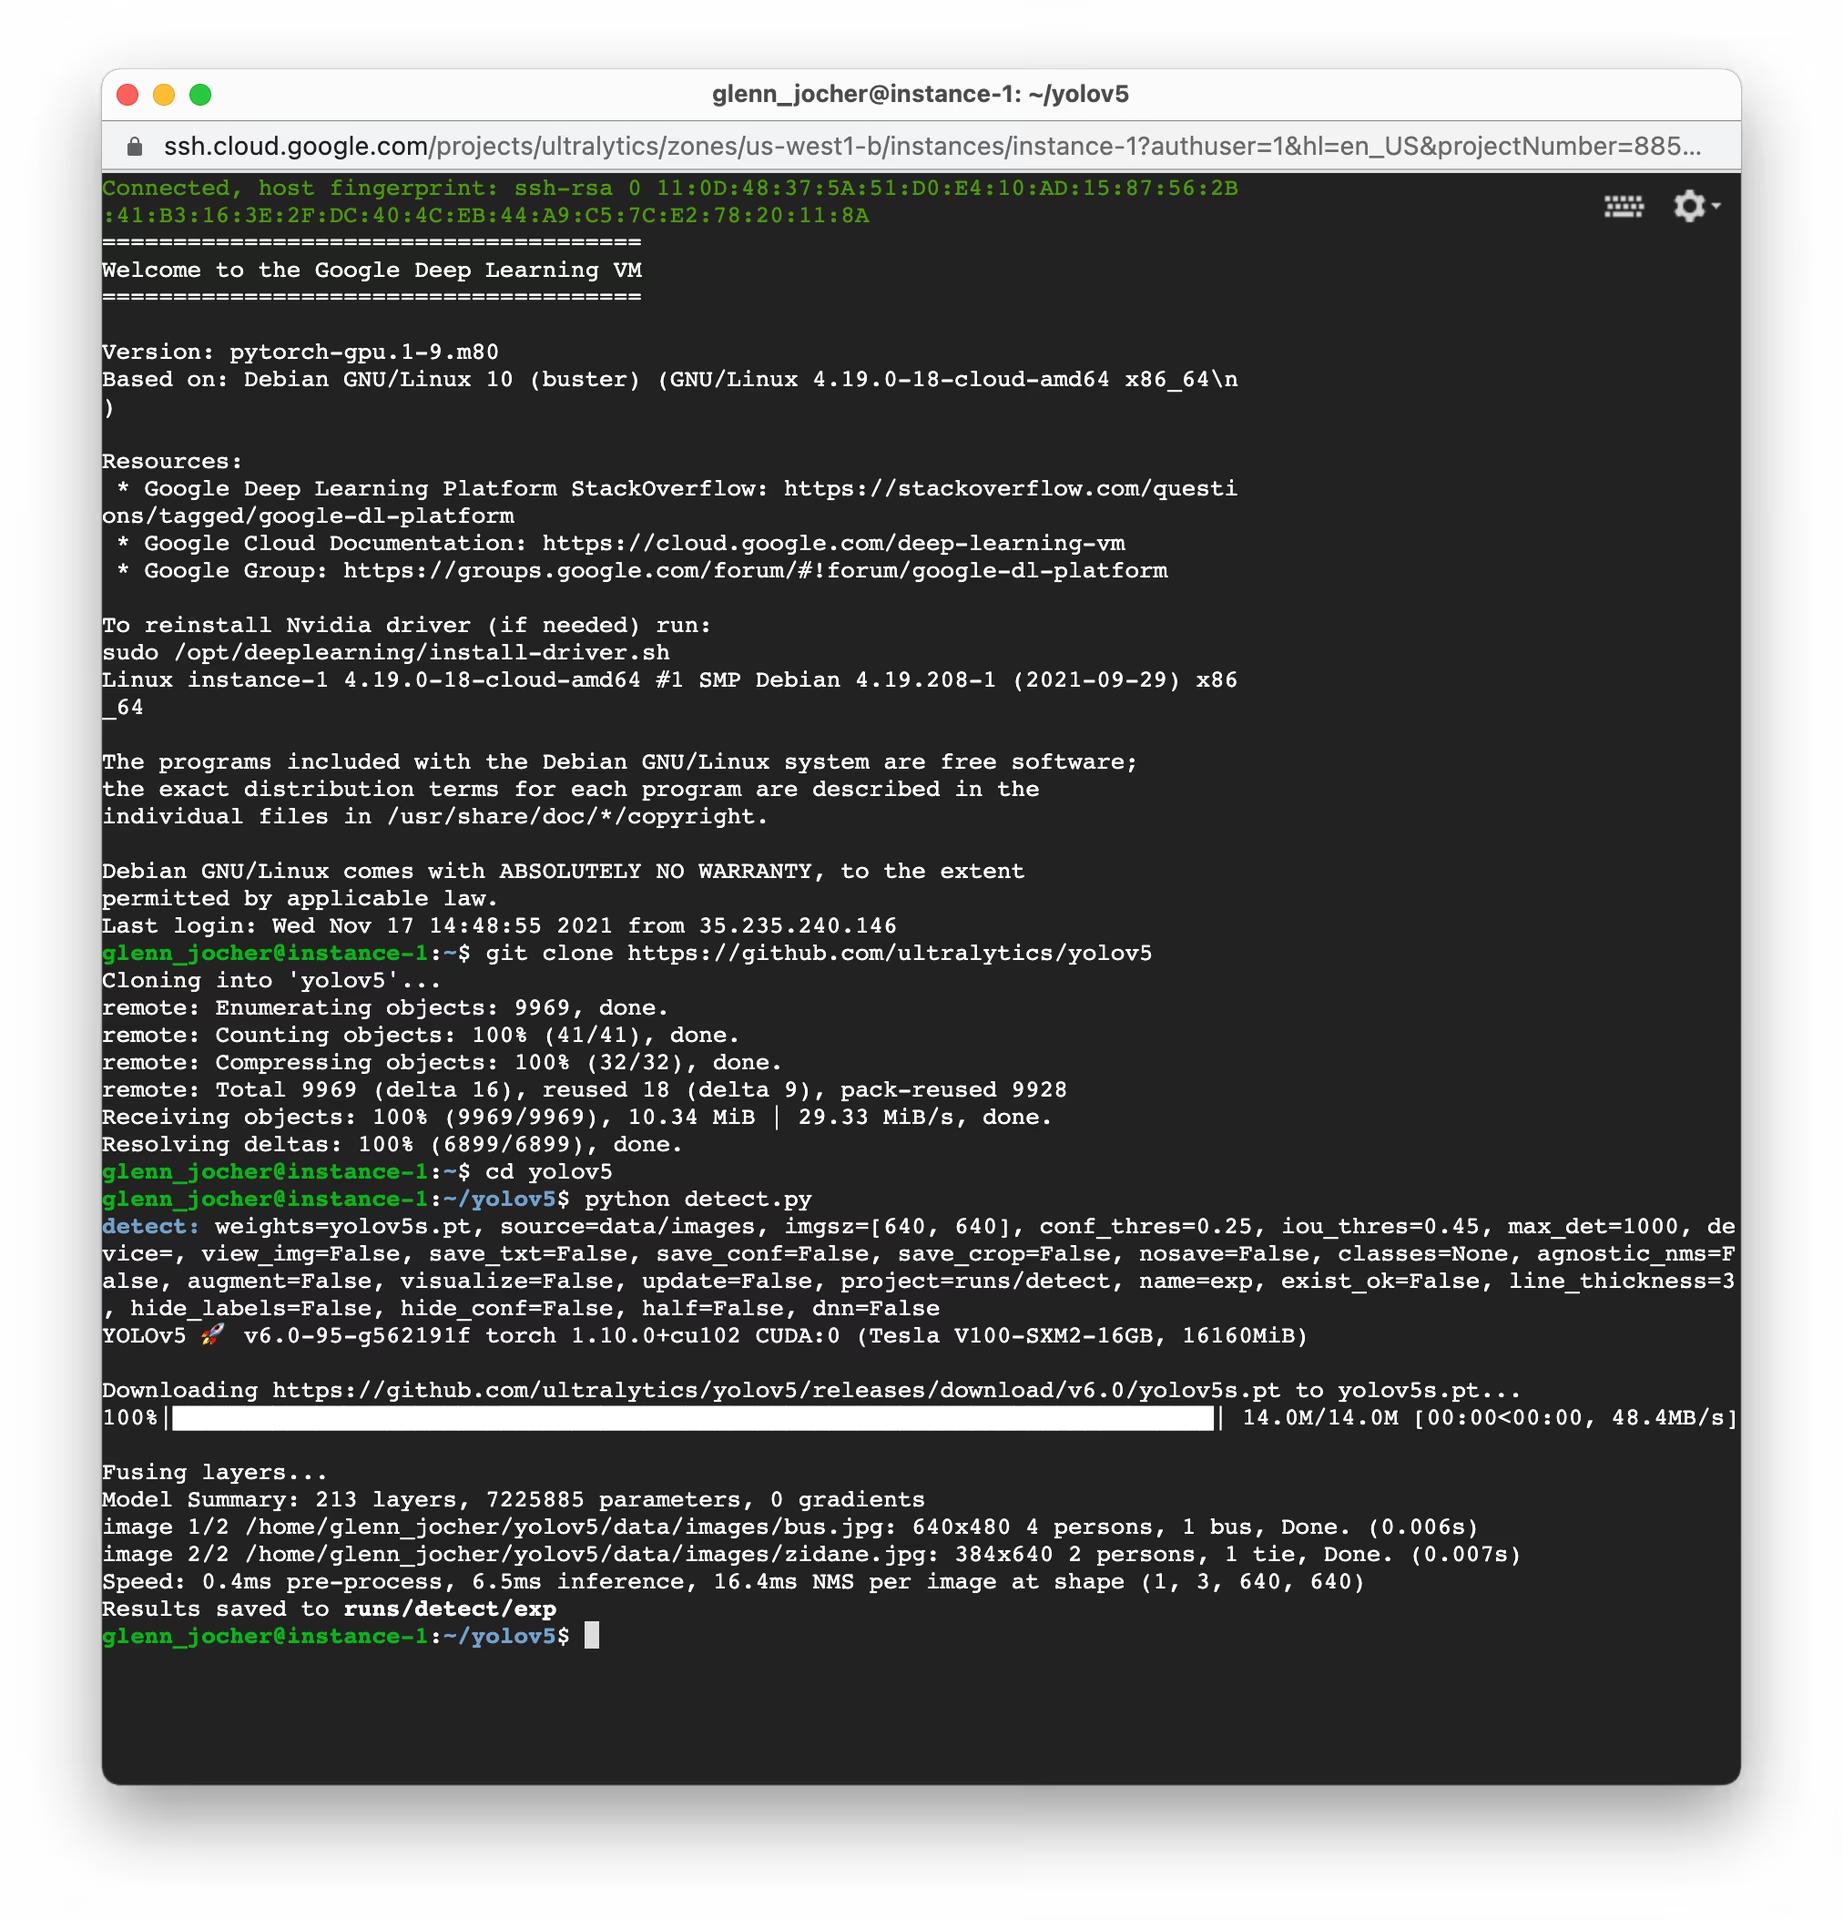
接下来,安装 YOLOv5 及其依赖项:
# Clone the YOLOv5 repository
git clone https://github.com/ultralytics/yolov5
cd yolov5

# Install dependencies
pip install -r requirements.txt
YOLOv5 需要 Python 3.8.0 或更高版本以及 PyTorch 1.8 或更高版本。脚本会自动从最新 YOLOv5 版本下载模型和数据集,简化模型训练的启动流程。
步骤 3:训练并部署 YOLOv5 模型#
配置完成后,你就可以在 GCP 虚拟机上使用 YOLOv5 进行训练、验证、预测和导出:
# Train a YOLOv5 model on your dataset (e.g., yolov5s)
python train.py --data coco128.yaml --weights yolov5s.pt --img 640

# Validate the trained model to check Precision, Recall, and mAP
python val.py --weights yolov5s.pt --data coco128.yaml

# Run inference using the trained model on images or videos
python detect.py --weights yolov5s.pt --source path/to/your/images_or_videos

# Export the trained model to various formats like ONNX, CoreML, TFLite for deployment
python export.py --weights yolov5s.pt --include onnx coreml tflite只需几条命令,你就可以训练符合需求的自定义目标检测模型,也可以从预训练权重开始,快速获得结果。
分配交换空间(可选)#
如果你使用的数据集特别大,可能超出虚拟机的 RAM 容量,可以考虑添加交换空间,以避免内存错误:
# Allocate a 64GB swap file
sudo fallocate -l 64G /swapfile

# Set the correct permissions for the swap file
sudo chmod 600 /swapfile

# Set up the Linux swap area
sudo mkswap /swapfile

# Enable the swap file
sudo swapon /swapfile

# Verify the swap space allocation (should show increased swap memory)
free -h训练自定义数据集#
要在 GCP 上使用自定义数据集训练 YOLOv5,请按照以下一般步骤操作:
-
按照 YOLOv5 格式准备数据集(图像及其对应的标签文件)。如需指导,请参阅我们的数据集概览。
-
使用
gcloud compute scp或网页控制台的 SSH 功能,将数据集上传到 GCP 虚拟机。 -
创建数据集配置 YAML 文件(
custom_dataset.yaml),指定训练数据和验证数据的路径、类别数量以及类别名称。 -
使用自定义数据集 YAML 开始训练流程,也可以选择从预训练权重开始训练:
# Example: Train YOLOv5s on a custom dataset for 100 epochs
python train.py --img 640 --batch 16 --epochs 100 --data custom_dataset.yaml --weights yolov5s.pt
有关准备数据和使用自定义数据集进行训练的完整说明,请参阅训练自定义数据教程。
利用云存储#
为了高效管理数据,尤其是在处理大型数据集或大量实验时,可以将 YOLOv5 工作流与 Google Cloud Storage 集成:
# Ensure Google Cloud SDK is installed and initialized
# If not installed: curl https://sdk.cloud.google.com/ | bash
# Then initialize: gcloud init

# Example: Copy your dataset from a GCS bucket to your VM
gsutil cp -r gs://your-data-bucket/my_dataset ./datasets/

# Example: Copy trained model weights from your VM to a GCS bucket
gsutil cp -r ./runs/train/exp/weights gs://your-models-bucket/yolov5_custom_weights/
这种方法可以让你在云端安全、经济高效地存储大型数据集和训练完成的模型,减少虚拟机实例所需的存储空间。
总结#
你现在已在 Google Cloud Platform 深度学习 VM 上运行 Ultralytics YOLOv5,可用于各种目标检测项目,涵盖个人实验、学术研究和工业解决方案。
你可以考虑使用 Ultralytics Platform,以免编写代码的方式训练和管理模型。
如有问题或希望合作,请加入 GitHub 讨论区。
常见问题#
配备单块 T4 GPU 的
n1-standard-8机器足以满足大多数 YOLOv5 训练和推理需求。对于大型数据集或更大的模型,请升级到 L4 或 A100;并且务必勾选在首次启动时自动安装 NVIDIA 驱动程序的选项。VM 空闲时,请从 Compute Engine 控制台停止 VM。已挂载的磁盘仍会产生费用,因此项目完成且权重已安全复制到 Cloud Storage 后,请删除 VM 和磁盘。
小型数据集可使用
gcloud compute scp。对于更大的数据集,请上传到 Cloud Storage 存储桶,再使用gsutil cp -r gs://your-bucket/dataset ./datasets/拉取;在 Google 网络内部,这种方式快得多。可以。Deep Learning VM 已预装 PyTorch,因此
pip install ultralytics可通过yoloCLI 添加 YOLO26训练和导出功能。
评论
提出问题、分享结果,或帮助其他人。