AWS 深度学习实例上的 Ultralytics YOLOv5 🚀:完整指南#
搭建高性能深度学习环境可能令人望而生畏,尤其是对新手而言。不过别担心!🛠️ 本指南将逐步介绍如何在 AWS 深度学习实例上运行 Ultralytics YOLOv5。借助 Amazon Web Services (AWS) 的强大功能,即使是刚接触机器学习 (ML) 的人,也能快速、经济高效地开始使用。AWS 平台的可扩展性使其非常适合实验和生产部署。
YOLOv5 的其他快速入门方式包括我们的 Google Colab Notebook  、Kaggle 环境
 、GCP 深度学习虚拟机,以及我们在 Docker Hub 上提供的预构建 Docker 镜像

步骤 1:登录 AWS 控制台#
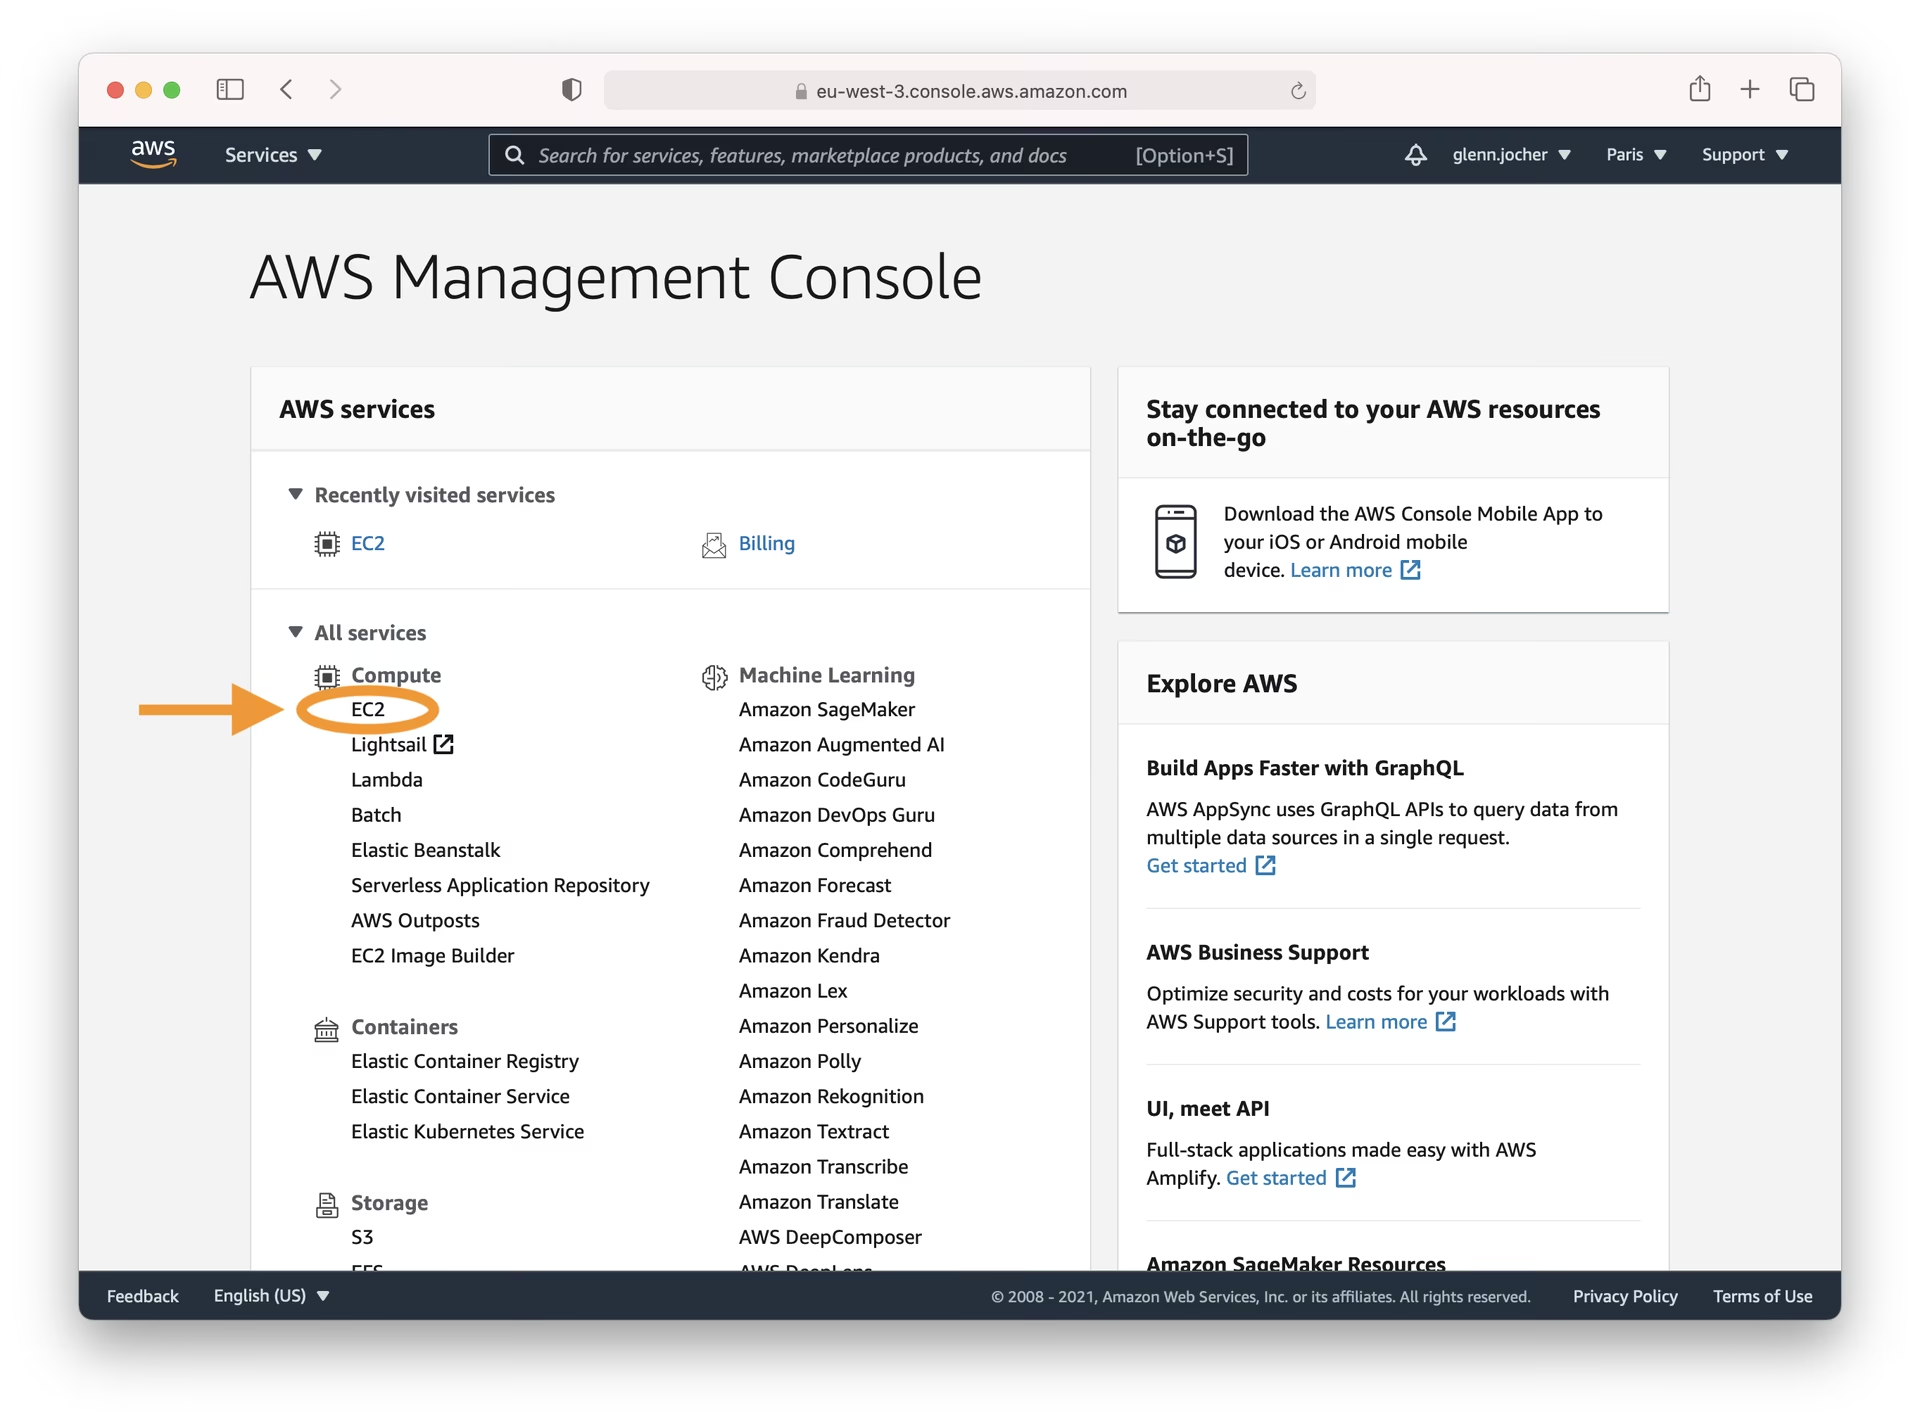
首先创建账户或登录 AWS 管理控制台。登录后,前往 EC2 服务仪表板,在此可以管理虚拟服务器(实例)。
步骤 2:启动实例#
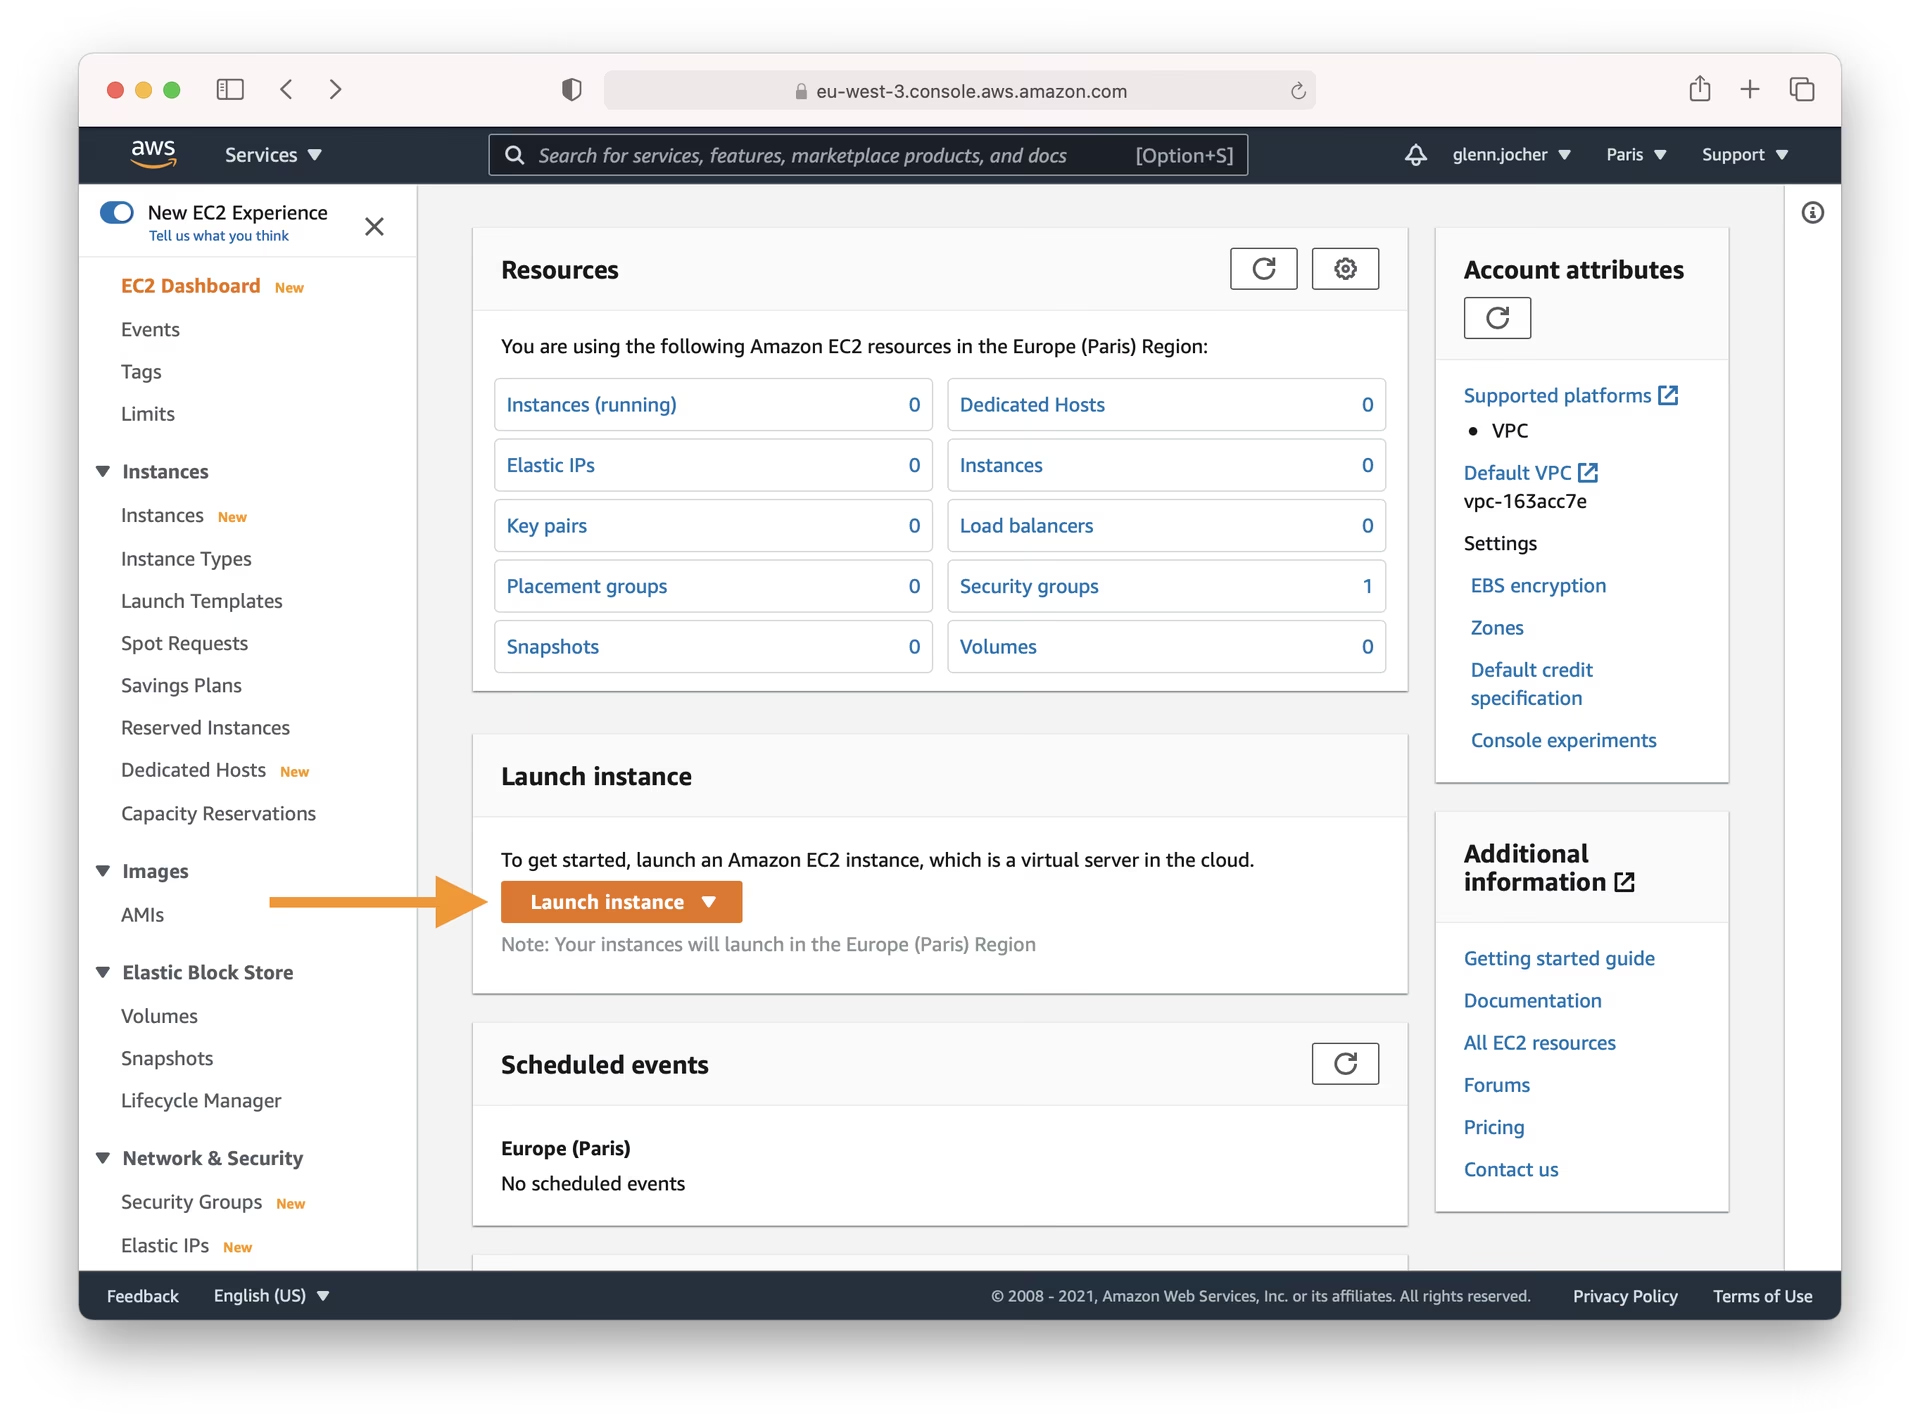
在 EC2 仪表板中,点击 Launch Instance 按钮。这将启动创建新虚拟服务器的流程,你可以根据自身需求进行配置。
选择合适的 Amazon Machine Image (AMI)#
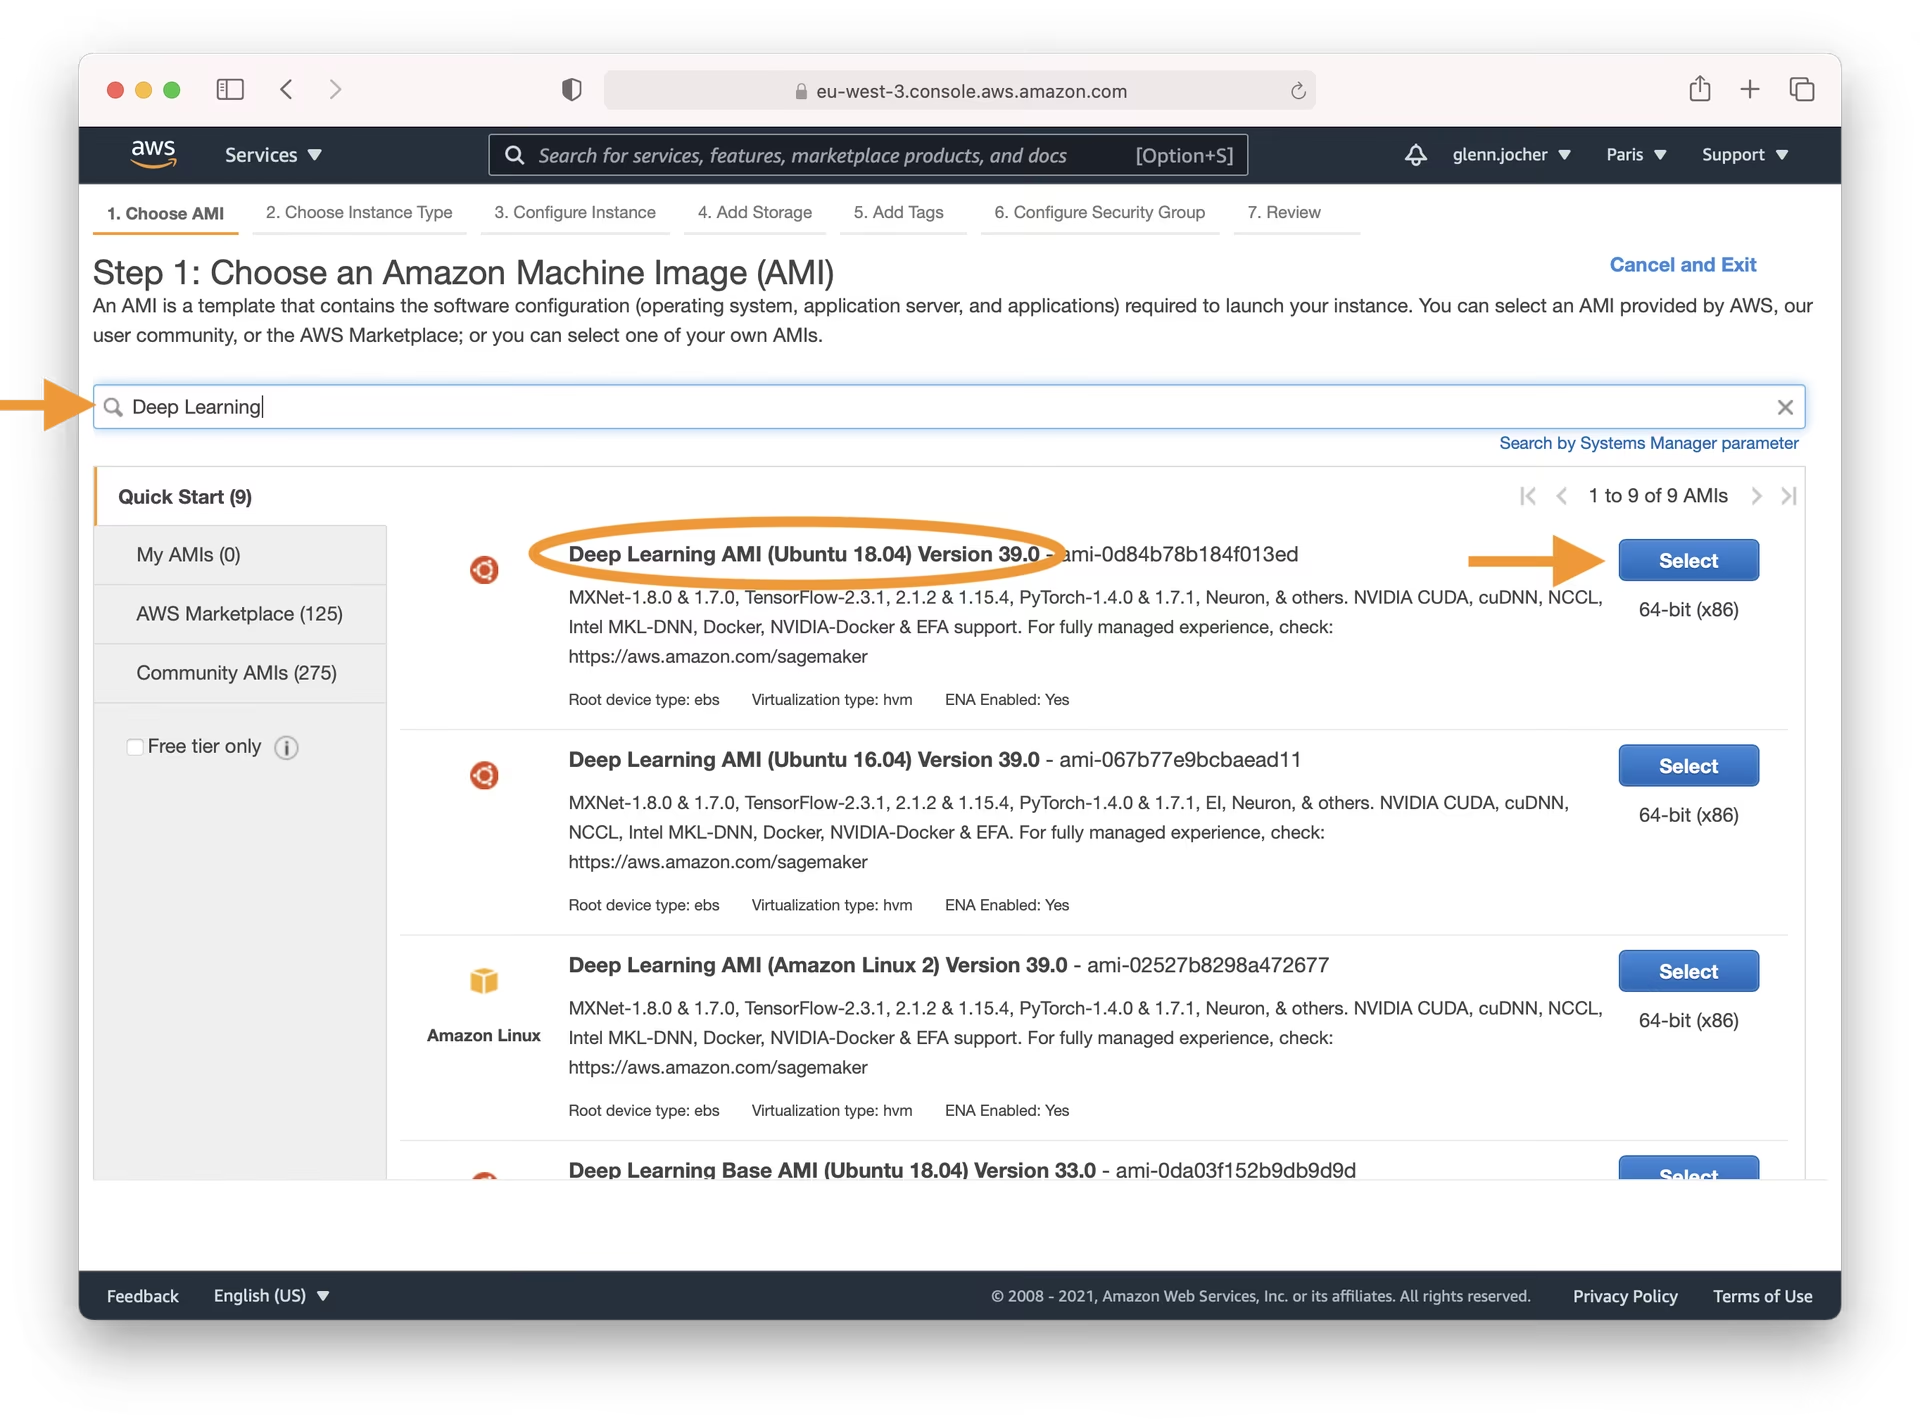
选择正确的 AMI 至关重要,因为它决定了实例的操作系统和预装软件。在搜索栏中输入“深度学习”,然后选择最新的基于 Ubuntu 的深度学习 AMI(除非你对其他操作系统有特定需求)。Amazon 的深度学习 AMI 已预先配置常用的深度学习框架(例如 YOLOv5 使用的 PyTorch)和必要的 GPU 驱动程序,大大简化了配置流程。
选择实例类型#
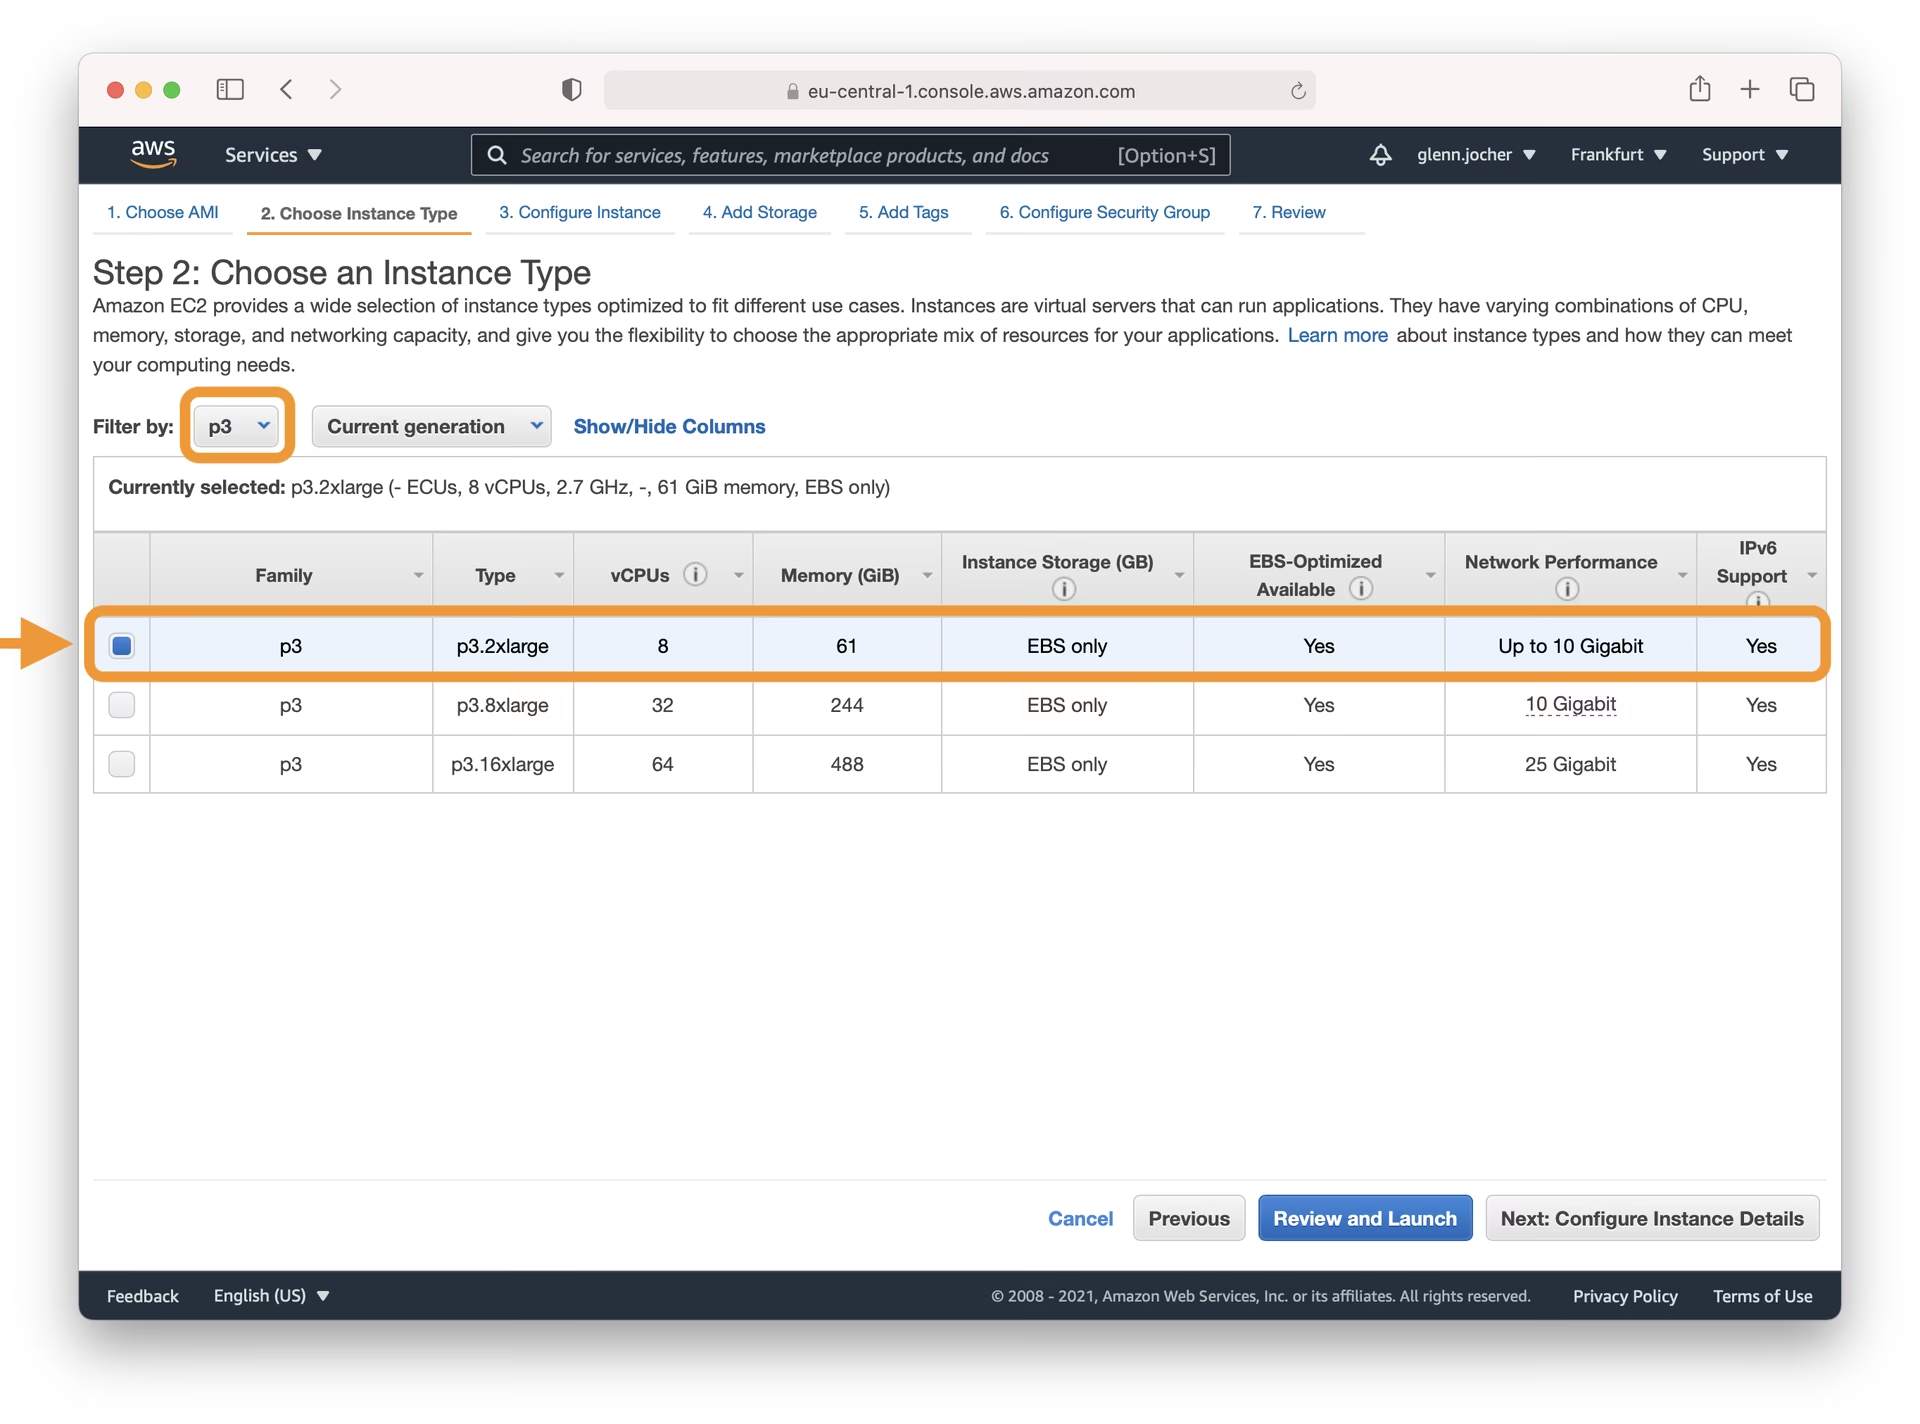
对于训练深度学习模型等高要求任务,强烈建议选择由 GPU 加速的实例类型。与 CPU 相比,GPU 可以大幅缩短模型训练所需时间。选择实例规格时,请确保其内存容量 (RAM) 足以满足模型和数据集的需求。
注意: 模型和数据集的大小是关键因素。如果你的 ML 任务需要的内存超过所选实例提供的容量,就需要选择更大的实例类型,以避免性能问题或错误。
在 EC2 实例类型页面查看可用的 GPU 实例类型,特别是 Accelerated Computing 类别下的实例。
有关监控和优化 GPU 使用情况的详细信息,请参阅 AWS 的 GPU 监控与优化指南。使用按需定价比较成本,并了解通过 Spot 实例定价节省开支的可能性。
配置实例#
你可以考虑使用 Amazon EC2 Spot 实例,以更经济高效地使用资源。Spot 实例让你能够使用闲置的 EC2 容量,价格通常比按需价格低很多。如果训练任务需要在中断后继续运行,请选择持久请求,并将中断行为设为停止而不是终止,这样 EBS 卷和训练输出就会保留,实例也会在容量恢复后重新启动。
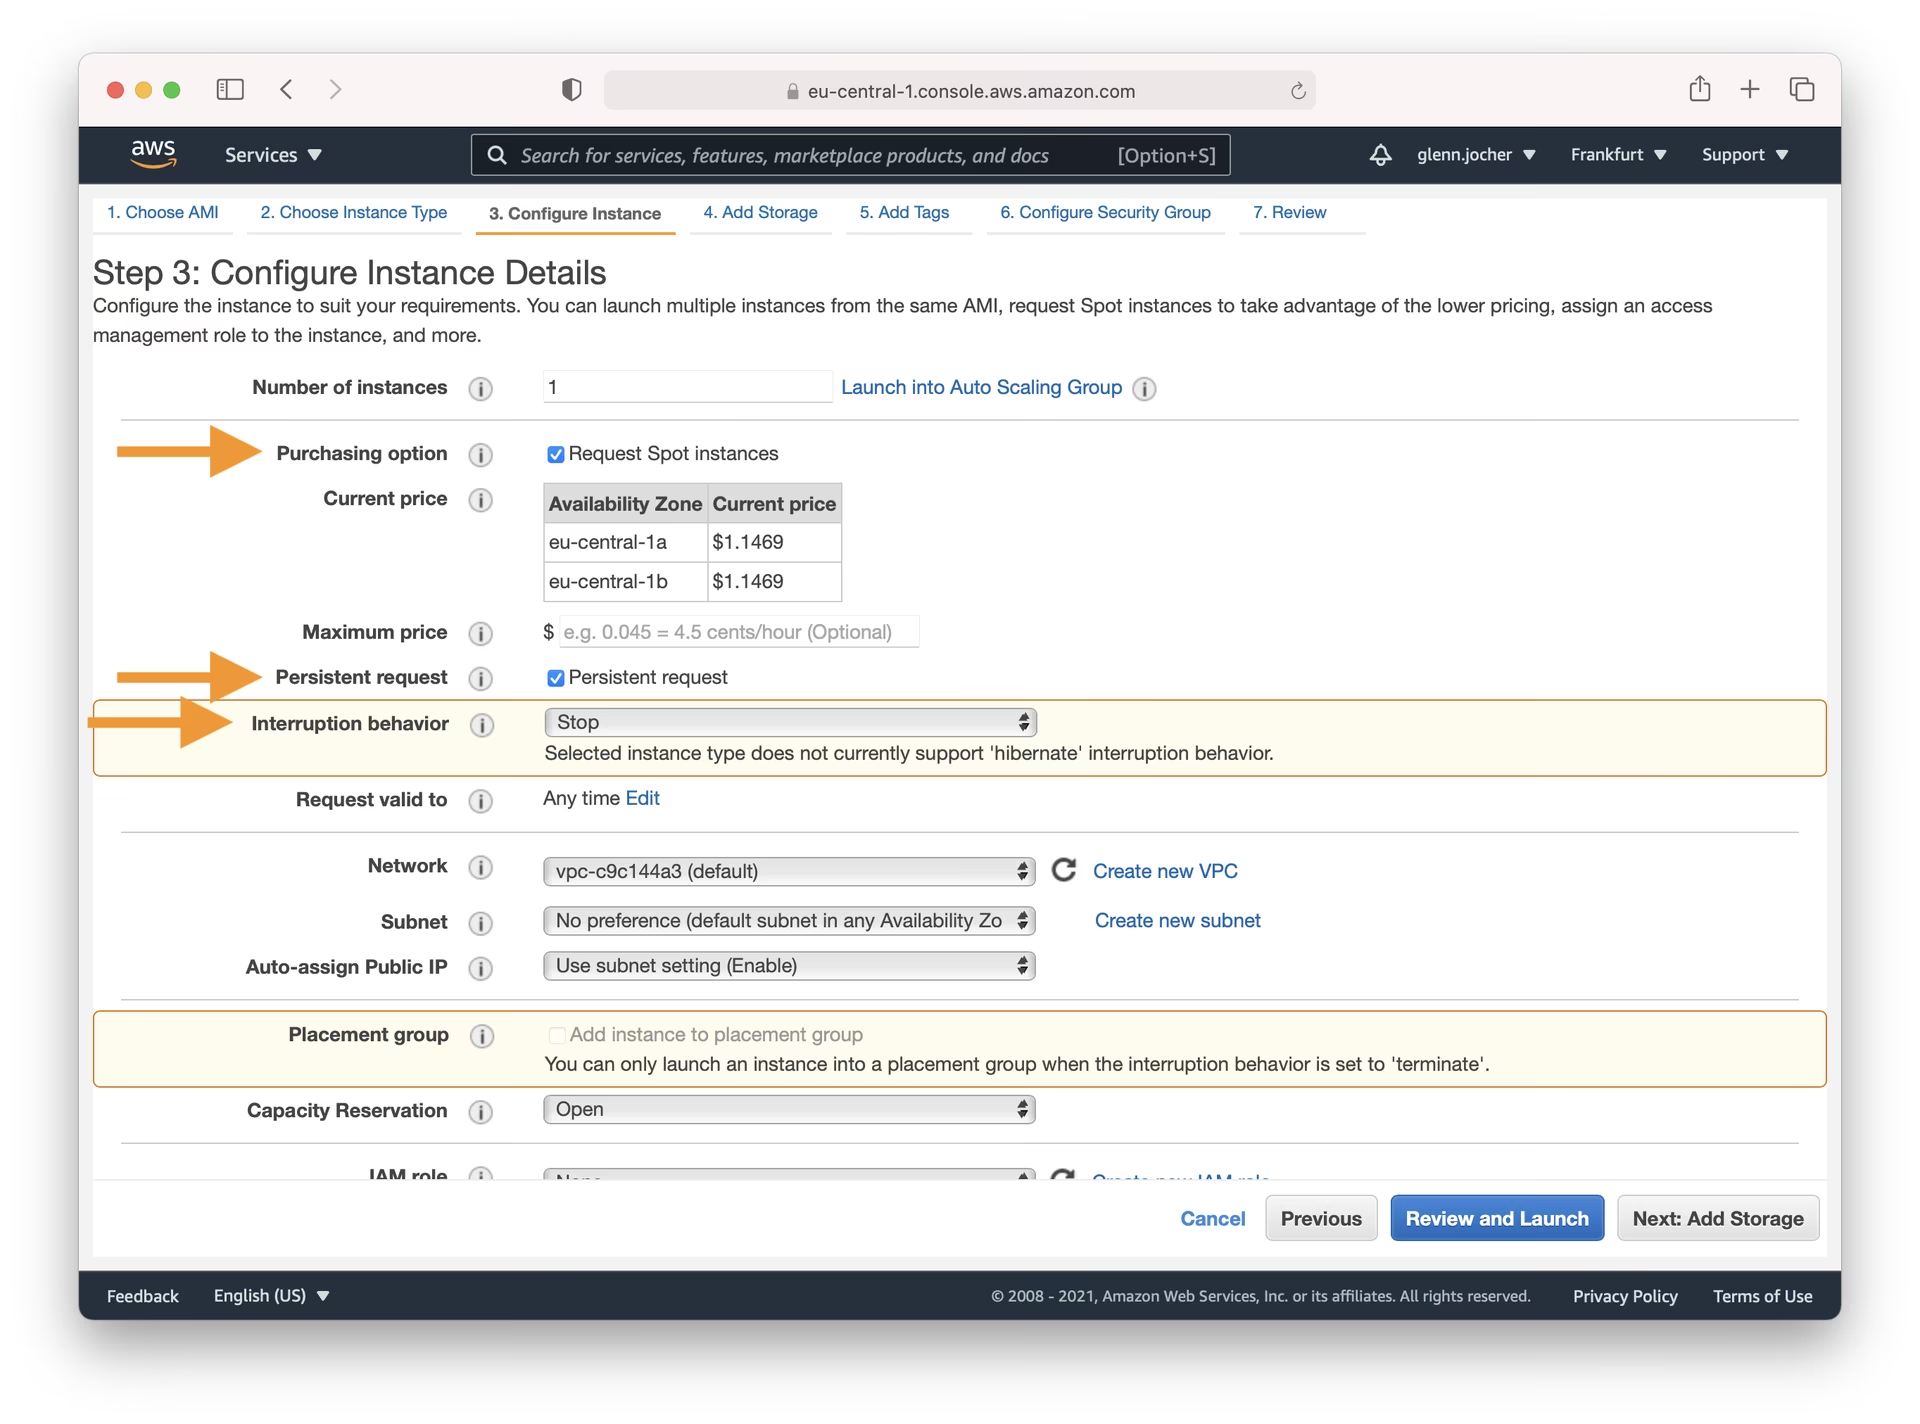
继续完成其余启动设置,包括配置存储、添加标签、设置安全组(确保从你的 IP 地址开放 SSH 端口 22),并在点击 Launch 前检查设置。你还需要创建或选择现有密钥对,以便通过 SSH 安全访问实例。
步骤 3:连接到实例#
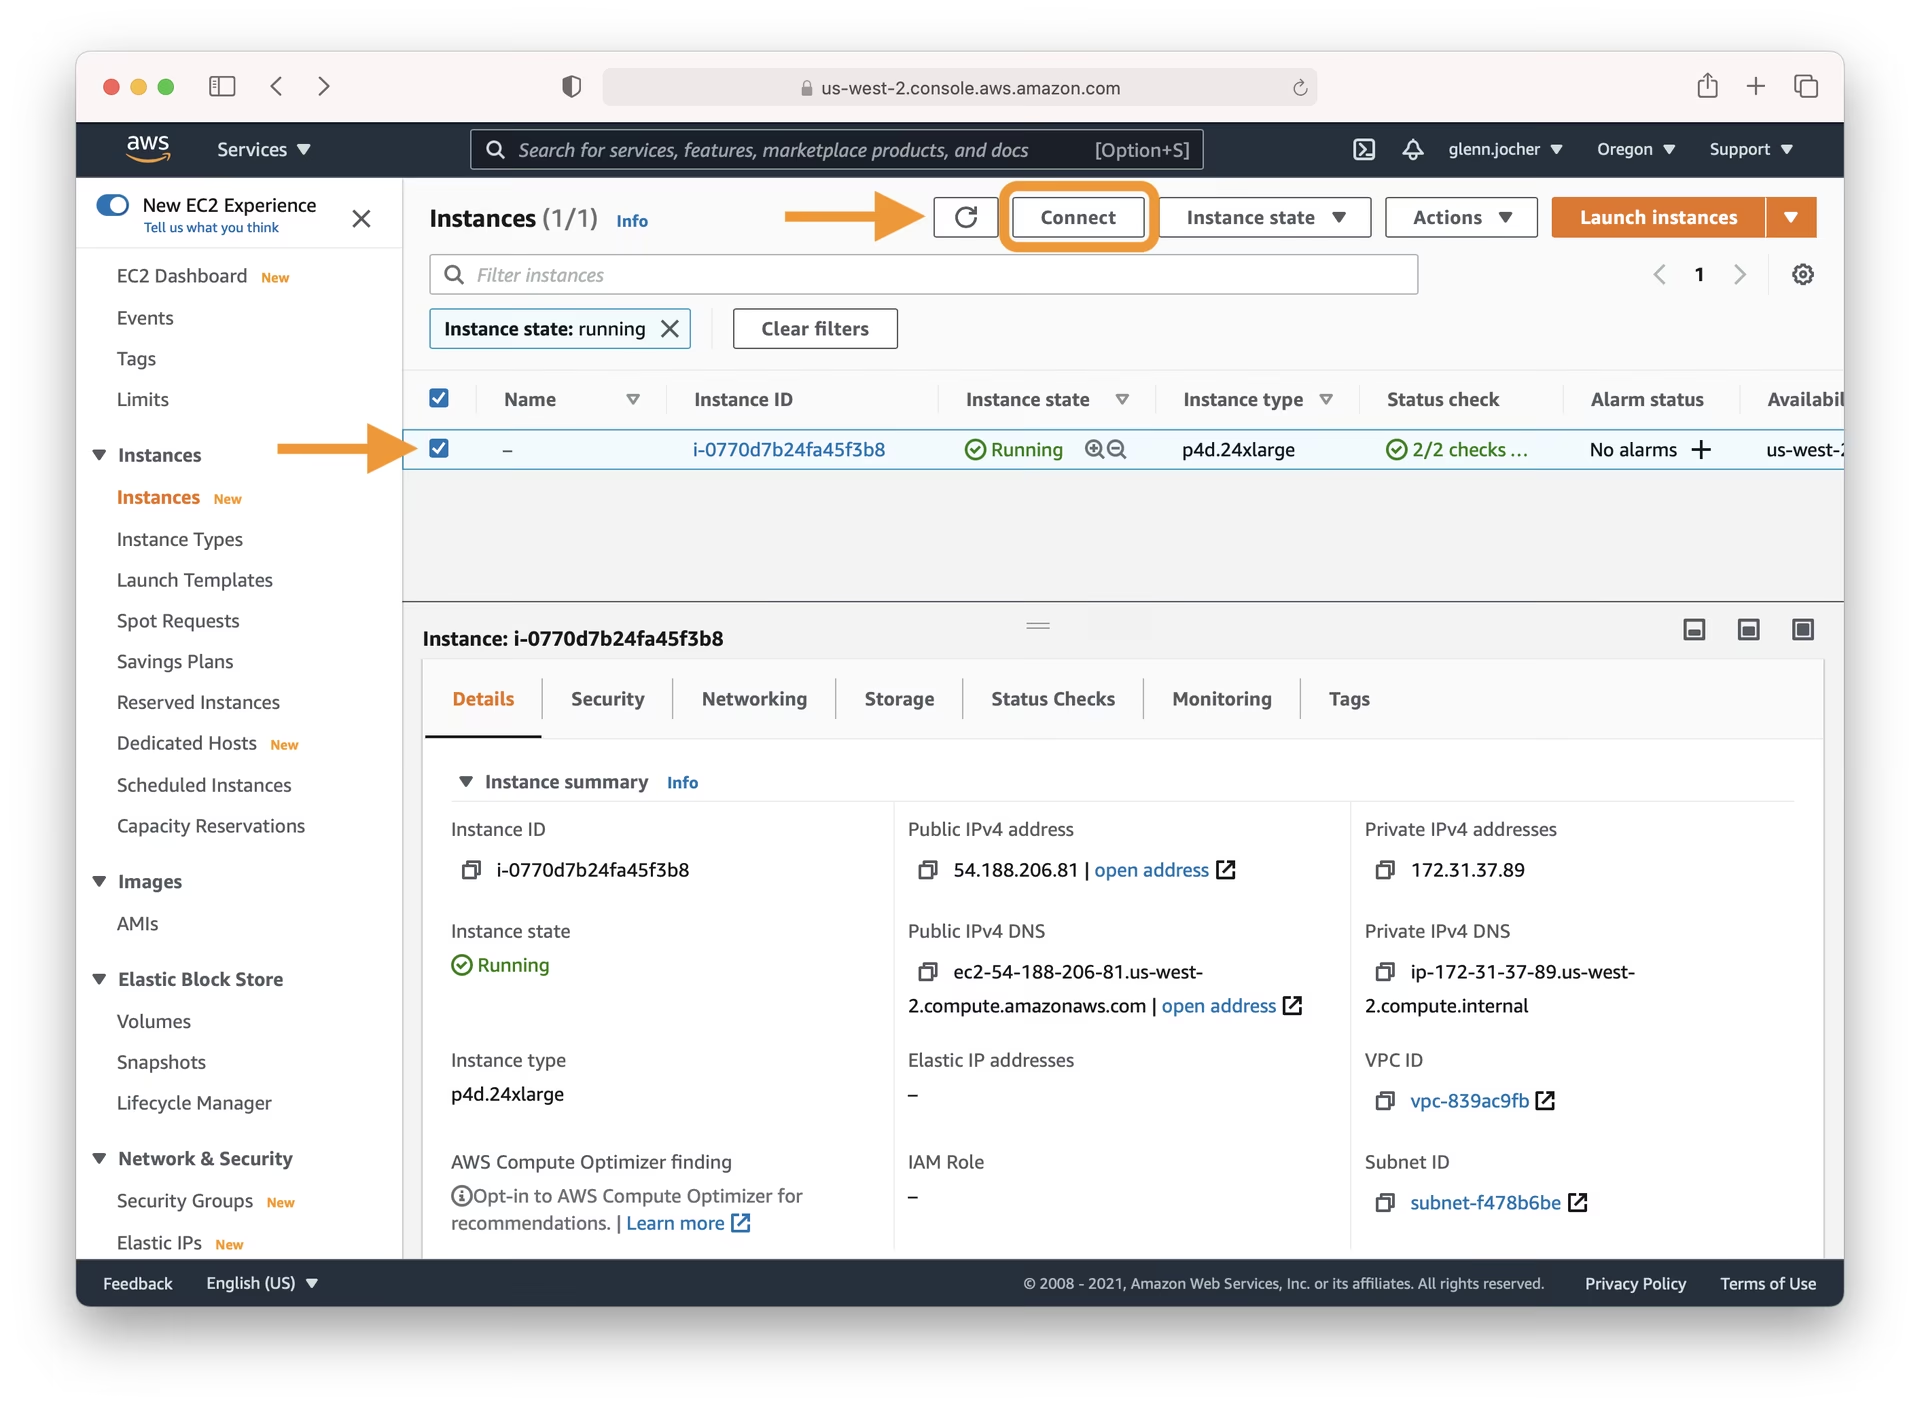
当实例状态显示为“running”后,在 EC2 仪表板中选择该实例。点击 Connect 按钮查看连接选项。使用本地终端中提供的 SSH 命令示例(例如 macOS/Linux 上的 Terminal,或 Windows 上的 PuTTY/WSL)建立安全连接。你需要使用启动时创建或选择的私钥文件(.pem)。
步骤 4:运行 Ultralytics YOLOv5#
现在你已通过 SSH 连接,可以配置并运行 YOLOv5。首先,从 GitHub 克隆官方 YOLOv5 仓库,并进入该目录。然后,使用 pip 安装所需依赖。建议使用 Python 3.8 或更高版本的环境。运行训练或检测等命令时,系统会自动从最新的 YOLOv5 发布版本下载所需的模型和数据集。
# Clone the YOLOv5 repository
git clone https://github.com/ultralytics/yolov5
cd yolov5

# Install required packages
pip install -r requirements.txt
环境准备就绪后,你可以开始使用 YOLOv5 执行各种任务:
# Train a YOLOv5 model on a custom dataset (e.g., coco128.yaml)
python train.py --data coco128.yaml --weights yolov5s.pt --img 640

# Validate the performance (Precision, Recall, mAP) of a trained model (e.g., yolov5s.pt)
python val.py --weights yolov5s.pt --data coco128.yaml --img 640

# Run inference (object detection) on images or videos using a trained model
python detect.py --weights yolov5s.pt --source path/to/your/images_or_videos/ --img 640

# Export the trained model to various formats like ONNX, CoreML, TFLite for deployment
python export.py --weights yolov5s.pt --include onnx coreml tflite --img 640可选项:增加交换内存#
如果你使用非常大的数据集,或在训练期间遇到内存限制,增加实例的交换内存有时会有所帮助。交换空间允许系统将磁盘空间用作虚拟 RAM。
# Allocate a 64GB swap file (adjust size as needed)
sudo fallocate -l 64G /swapfile

# Set correct permissions
sudo chmod 600 /swapfile

# Set up the file as a Linux swap area
sudo mkswap /swapfile

# Enable the swap file
sudo swapon /swapfile

# Verify the swap memory is active
free -h
恭喜!🎉 你已成功配置 AWS 深度学习实例并安装 Ultralytics YOLOv5,现在可以执行目标检测任务了。无论是试用预训练模型,还是使用自己的数据进行训练,这套强大的配置都能为你的计算机视觉项目提供可扩展的基础。如果遇到问题,请查阅详尽的 AWS 文档以及 Ultralytics 社区的实用资源,例如常见问题。祝你检测愉快!
常见问题#
选择最新的基于 Ubuntu 的 AWS 深度学习 AMI。它预装了 NVIDIA 驱动程序、CUDA 和 PyTorch,因此你只需克隆仓库并安装
requirements.txt即可完成剩余配置。Accelerated Computing 系列中的任意 GPU 实例都适用,例如
g4dn、g5或p3实例。根据批次大小和图像尺寸选择具有足够 GPU 内存的实例,并使用--batch-size -1让 YOLOv5 自动选择能够容纳的最大批次。少量传输可使用
scp和你的.pem密钥;也可以先将数据存放在 Amazon S3 中,再使用aws s3 sync进行复制。训练输出位于runs/train/,权重位于runs/train/exp/weights/。使用持久 Spot 请求,并将中断行为设为停止,这样 EBS 卷就会保留。实例重新启动后,使用
python train.py --resume从上一个检查点恢复运行。如果无法承受进度丢失,请定期将last.pt和best.pt复制到 S3。