机器学习最佳实践与模型训练技巧
简介#
开展计算机视觉项目时,最重要的步骤之一就是模型训练。在进入这一步之前,你需要明确目标,并收集和标注数据。预处理数据,确保数据干净且一致之后,就可以开始训练模型了。
模型训练是教模型识别视觉模式并根据数据进行预测的过程,它会直接影响应用的准确性。本指南将介绍最佳实践、优化技巧和故障排查建议,帮助你有效训练计算机视觉模型。
观看: 模型训练技巧 | 如何处理大型数据集 | 批次大小、GPU 利用率和混合精度
如何训练机器学习模型#
训练计算机视觉模型时,会调整模型的内部参数以尽量减少错误。首先,向模型输入大量带标签的图像。模型会预测图像中的内容,再将预测结果与实际标签或内容进行比较,以计算误差。这些误差反映了模型的预测与真实值之间的差距。
训练期间,模型会通过称为反向传播的过程反复进行预测、计算误差并更新参数。在此过程中,模型会调整内部参数(权重和偏置)以减少误差。多次重复这一循环后,模型的准确性会逐渐提高。随着训练推进,模型会学会识别形状、颜色和纹理等复杂模式。
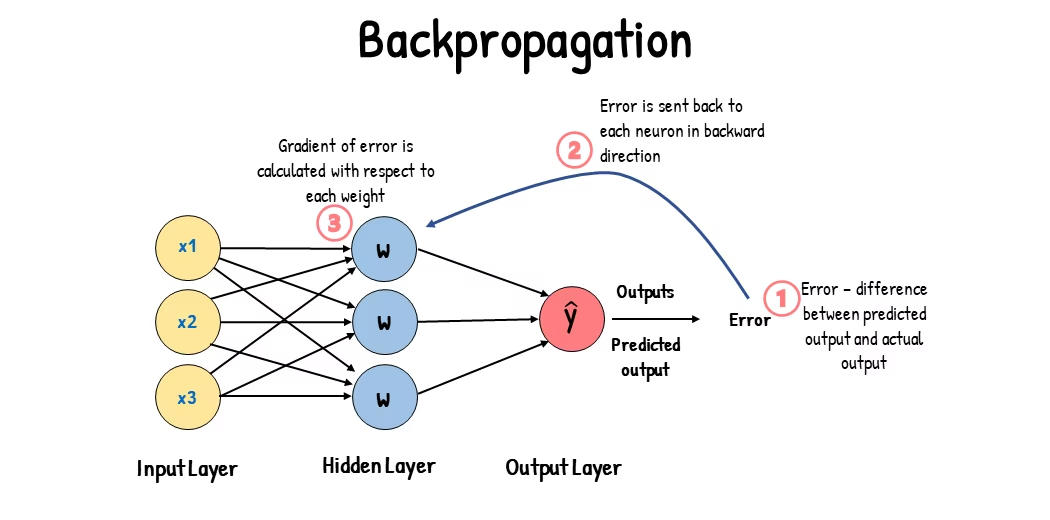
这一学习过程使计算机视觉模型能够执行各种任务,包括目标检测、实例分割、语义分割和图像分类。最终目标是创建一个能够将所学知识泛化到新的、未见过的图像上的模型,从而使其能够在实际应用中准确理解视觉数据。
了解了训练模型背后的原理后,接下来看看训练模型时需要考虑的事项。
使用大型数据集训练#
计划使用大型数据集训练模型时,有几个方面需要考虑。例如,你可以调整批量大小、控制 GPU 利用率、选择使用多尺度训练等。下面逐一详细介绍这些选项。
批量大小与 GPU 利用率#
使用大型数据集训练模型时,高效利用 GPU 至关重要。批量大小是一个重要因素,它指机器学习模型在一次训练迭代中处理的数据样本数量。 使用 GPU 所支持的最大批量大小,可以充分发挥 GPU 的能力,并缩短模型训练时间。不过,你需要避免 GPU 内存耗尽。如果遇到内存错误,请逐步减小批量大小,直到模型能够顺利训练。
观看: 如何通过批处理将 Ultralytics YOLO26 推理速度提升 2 倍 | Python 和 GPU | MLOps 🚀
对于 YOLO26,你可以在训练模式参数中设置 batch 参数,以适应 GPU 容量。在单个加速器上,batch=-1 会分析模型,并选择一个批次大小,使内存利用率达到约 60%;像 batch=0.70 这样的分数则会以不同的占比为目标。多 GPU 运行需要显式设置全局批次大小,且该值至少要等于设备数量。在 CPU 和 Apple 芯片上,AutoBatch 会发出警告并回退到 batch=16。
子集训练#
子集训练是一种实用策略:使用能够代表大型数据集的较小数据集来训练模型。它可以节省时间和资源,尤其适用于模型开发和测试的初期阶段。如果时间紧张,或正在尝试不同的模型配置,子集训练是一个不错的选择。
说到 YOLO26,你可以使用 fraction 参数来实现子集训练。使用比例(例如 fraction=0.1)可选取 10% 的训练数据,使用整数(例如 fraction=300)可精确选取 300 张训练图像,也可以使用 [train, val, test] 列表(例如 fraction=[300, 100, 0])来限制每个数据集划分并跳过测试图像。像 [300, 100] 这样的双元素列表会保留完整的测试集划分。NDJSON 数据集会在下载前选择间隔均匀的记录,因此重复运行会使用完全相同的子集。图像文件夹分类数据集也会选择间隔均匀的样本。对于其他图像文件夹数据集,fraction 会按图像路径排序后选取前 N 张图像,而不是随机抽样,因此如果排序可能导致某些来源或类别被排除,请手动整理子集。准备训练集/验证集划分时,请确保近重复组完全位于同一个划分中。
多尺度训练#
多尺度训练是一种通过使用不同尺寸的图像进行训练来提升模型泛化能力的技术。模型可以学会检测不同尺度和距离下的目标,从而变得更加稳健。
训练 YOLO26 时,你可以通过设置 scale 参数启用尺度增强。该参数会按指定系数调整训练图像的尺寸,以模拟不同距离下的物体。例如,设置 scale=0.5 后,训练期间图像会随机以 0.5 到 1.5 倍的系数缩放。配置该参数后,模型可以接触不同尺度的图像,从而提升其在不同物体尺寸和场景下的检测能力。
Ultralytics 还支持通过 multi_scale 参数进行图像尺寸多尺度训练。与 scale 不同,后者会缩放图像,然后填充或裁剪回 imgsz;multi_scale 则会在每个批次中直接改变 imgsz 本身(并按模型步长取整)。例如,设置 imgsz=640 和 multi_scale=0.25 后,训练尺寸会以步长为单位在 480 到 800 之间采样(例如 480、512、544、……、800);而 multi_scale=0.0 则保持固定尺寸。
缓存#
缓存是提升机器学习模型训练效率的重要技术。将预处理后的图像存储在内存中,可以减少 GPU 等待从磁盘加载数据的时间。模型能够持续接收数据,不会因磁盘 I/O 操作而延迟。
使用 YOLO26 训练时,可以通过 cache 参数控制缓存:
cache=True:将数据集图像存储在 RAM 中,访问速度最快,但会占用更多内存。cache='disk':将图像存储在磁盘上,速度比 RAM 慢,但比每次都重新加载数据快。cache=False:禁用缓存,完全依赖磁盘 I/O,这是速度最慢的选项。
混合精度训练#
混合精度训练同时使用 16 位 (FP16) 和 32 位 (FP32) 浮点类型:FP16 用于加速计算,FP32 则在需要时保持精度。神经网络的大多数运算都使用 FP16,以加快计算速度并降低内存占用。不过,模型权重还会保留一份 FP32 主副本,以确保权重更新步骤的准确性。在相同的硬件限制下,你可以处理更大的模型或使用更大的批次。
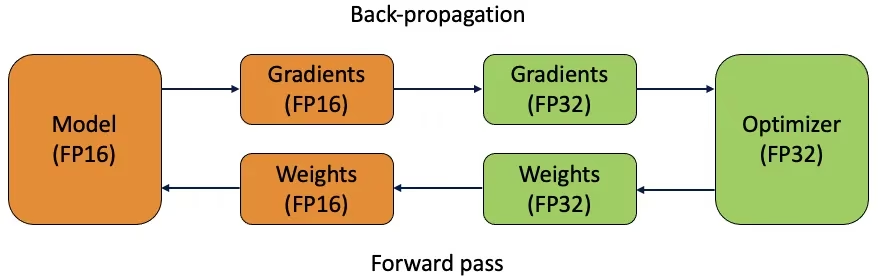
要实现混合精度训练,你需要修改训练脚本,并确保硬件(例如 GPU)支持该功能。许多现代深度学习框架,例如 PyTorch 和 TensorFlow,都内置了混合精度支持。
使用 YOLO26 进行混合精度训练很简单:AMP 默认已启用(amp=True)。在 CUDA GPU 上,YOLO 会在训练开始时进行一次能力检查;如果检查失败,就会退回到完整 FP32 精度。在 CPU 和 Apple 芯片上则会完全跳过 AMP。将 amp=False 设为强制使用 FP32,或将 amp="bf16" 设为在受支持的 GPU 上使用 bfloat16 训练。
预训练权重#
使用预训练权重是加快模型训练的有效方法。预训练权重来自已在大型数据集上训练过的模型,能让你的模型快速起步。迁移学习会将预训练模型适配到相关的新任务。微调预训练模型时,你可以从这些权重开始,再使用自己的数据集继续训练。这种训练方法速度更快,通常也能获得更好的性能,因为模型一开始就具备扎实的基础特征理解能力。
预训练权重来自 model 参数,因此 model=yolo26n.pt 已经会从 COCO 权重开始训练。pretrained 参数用于控制是否保留这些权重(True,默认值)、丢弃这些权重(False),或替换为另一个检查点(pretrained=path/to/best.pt)。在 *.yaml 模型上设置 pretrained=True 本身并不会获取权重。完整的迁移学习工作流请参阅如何在自定义数据集上微调 YOLO。
处理大型数据集时还需考虑的其他技巧#
处理大型数据集时,还可以考虑另外几种技巧:
- 学习率调度器:通过实现学习率调度器,可以在训练期间动态调整学习率。合理调优的学习率可以防止模型越过极小值,并提升稳定性。训练 YOLO26 时,
lrf参数通过将最终学习率设置为初始学习率的一定比例,帮助管理学习率调度。对于参数未提供的功能(例如逐层学习率或梯度裁剪),请继承训练器。 - 分布式训练:处理大型数据集时,分布式训练可以将工作负载分配到多块 GPU或多台机器,从而缩短训练时间。对于拥有大量计算资源的企业级项目,这种方法尤其有价值。
- Channels-last 内存格式:在 PyTorch 1.11 及更高版本中,CUDA 训练会自动使用更快的 NHWC 内存布局,但 Windows 除外,因为实测发现该布局在 Windows 上速度更慢。设置
channels_last=True可强制启用该格式,设置channels_last=False则可保持 NCHW;PyTorch 1.10 及更早版本、CPU 和 MPS 默认仍使用 NCHW。
训练轮数#
训练模型时,一个 epoch 指完整遍历一次整个训练数据集。在一个 epoch 中,模型会处理训练集中的每个样本一次,并根据学习算法更新参数。通常需要训练多个 epoch,模型才能逐步学习并调整参数。
一个常见问题是:应该将模型训练多少个 epoch?一个不错的起点是 300 个 epoch。如果模型过早过拟合,可以减少 epoch 数。如果训练 300 个 epoch 后仍未出现过拟合,可以将训练延长至 600、1200 个或更多 epoch。
不过,理想的 epoch 数会因数据集大小和项目目标而异。较大的数据集可能需要更多 epoch,模型才能有效学习;较小的数据集则可能需要较少 epoch,以避免过拟合。对于 YOLO26,你可以在训练脚本中设置 epochs 参数。
提前停止#
提前停止是优化模型训练的有效技巧。通过监控验证性能,当模型不再提升时,你可以停止训练。这样可以节省计算资源并防止过拟合。
该过程需要设置一个耐心值参数,用于确定在停止训练前,等待验证指标提升的 epoch 数。如果模型在这些 epoch 内没有提升性能,就会停止训练,以免浪费时间和资源。
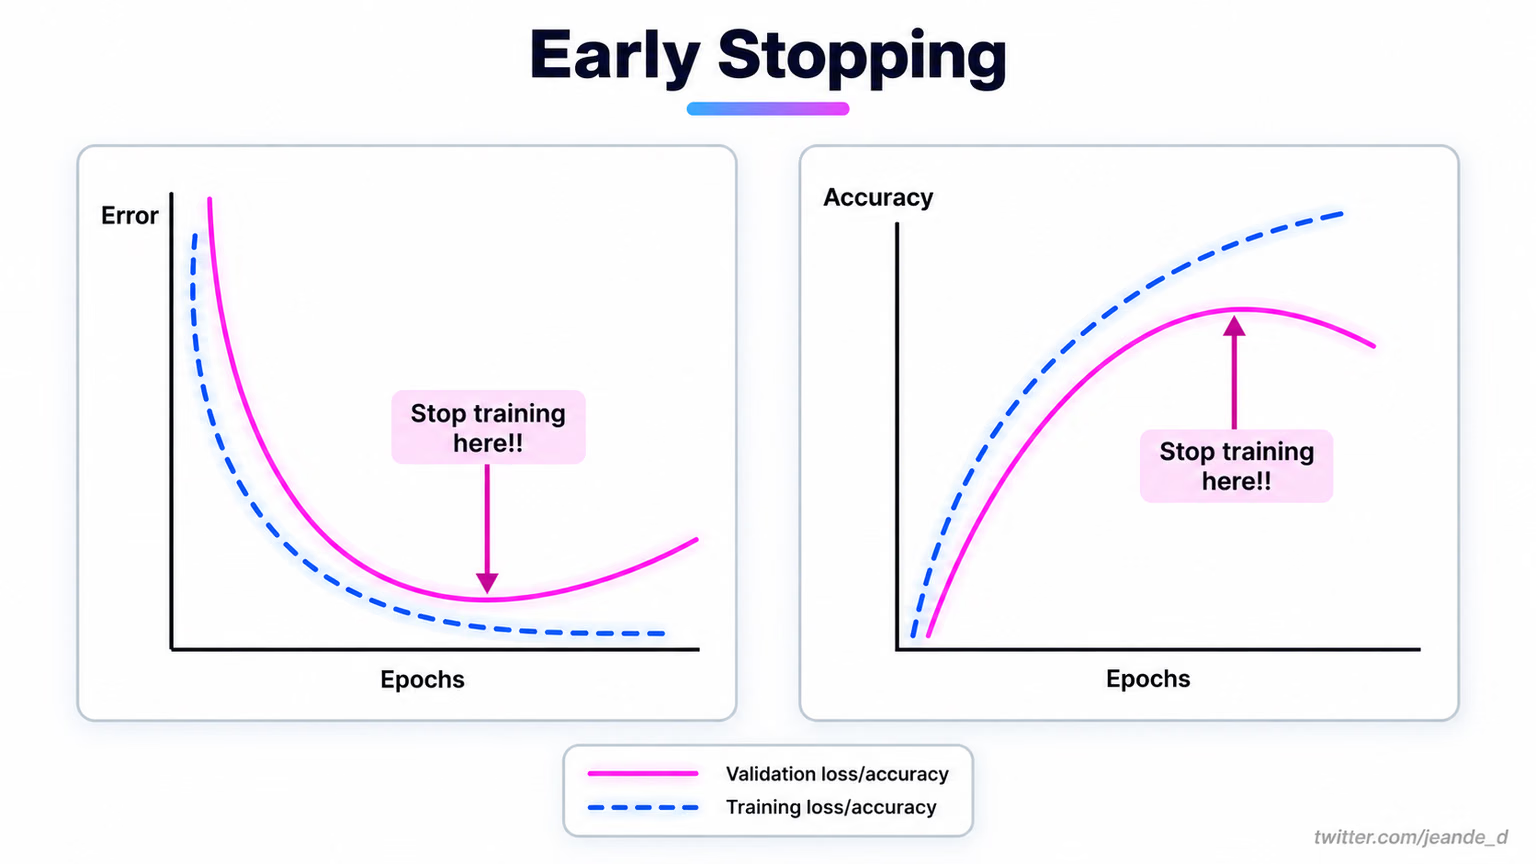
对于 YOLO26,你可以在训练配置中设置 patience 参数来启用早停。例如,patience=5 表示如果验证指标连续 5 个 epoch 没有提升,训练就会停止。这样既能提高训练效率,也能避免不必要的计算。
选择云端还是本地训练#
训练模型有两种选择:云端训练和本地训练。
云端训练具有可扩展性,并能提供强大的硬件,非常适合处理大型数据集和复杂模型。Google Cloud、AWS 和 Azure 等平台提供按需使用高性能 GPU 和 TPU 的能力,从而缩短训练时间,并支持使用更大的模型进行实验。Ultralytics Platform 也为 YOLO 模型提供托管云端训练服务。不过,云端训练可能成本高昂,尤其是长时间使用时;数据传输也会增加成本和延迟。
本地训练能提供更高的控制力和定制灵活性,让你根据具体需求调整环境,并避免持续的云端费用。对于长期项目,本地训练可能更经济;由于数据保留在本地,安全性也更高。不过,本地硬件可能存在资源限制并需要维护,这可能导致大型模型的训练时间更长。
选择优化器#
优化器是一种算法,可调整神经网络的权重以最小化损失函数,损失函数用于衡量模型的表现。简单来说,优化器通过调整模型参数来减少错误,帮助模型学习。选择合适的优化器会直接影响模型学习的速度和准确性。
你还可以微调优化器参数来提升模型性能。调整学习率可以设置更新参数时的步长。为了保持稳定,你可以先采用适中的学习率,然后逐渐降低学习率,以改善长期学习效果。此外,设置动量可以决定过去的更新对当前更新的影响程度。动量的常见取值约为 0.9,通常能取得不错的平衡。
常见优化器#
不同优化器各有优缺点。以下是一些常见的优化器。
-
随机梯度下降 (SGD):
- 根据损失函数相对于参数的梯度更新模型参数。
- 简单高效,但收敛可能较慢,也可能陷入局部最小值。
-
Adam(自适应矩估计):
- 结合了带动量的 SGD 和 RMSProp 的优点。
- 根据梯度一阶矩和二阶矩的估计值,为每个参数调整学习率。
- 适用于噪声较大的数据和稀疏梯度。
- 效率高,通常所需的调参较少。对于较短的训练任务,YOLO26 的
optimizer=auto会选择与 Adam 密切相关的 AdamW,而不是 Adam 本身。
-
RMSProp(均方根传播):
- 通过用梯度除以近期梯度幅值的移动平均值,为每个参数调整学习率。
- 有助于处理梯度消失问题,并且适用于循环神经网络。
-
Muon + SGD 混合优化器 (MuSGD):
- 结合了 SGD 风格的更新和受 Muon 启发的行为,从而提升大规模训练的稳定性。
- 如果你希望获得类似 SGD 的泛化能力,同时需要比原始 SGD 更平稳的收敛效果,那么 MuSGD 是不错的选择。
- 这对 YOLO26 训练方案尤其重要;如果不确定该选什么,可以从
optimizer=auto开始,并在你的数据集上与 MuSGD 进行比较。
对于 YOLO26,optimizer 参数支持你从多种优化器中进行选择,包括 SGD、MuSGD、Adam、Adamax、AdamW、NAdam、RAdam 和 RMSProp;你也可以将其设为 auto,根据训练迭代次数自动选择(较短的训练使用 AdamW,超过 10,000 次迭代则使用 MuSGD)。
yolo train model=yolo26n.pt data=coco8.yaml optimizer=MuSGD融入社区#
加入计算机视觉爱好者社区,可以帮助你解决问题并更快地学习。以下是一些交流、获取帮助和分享想法的方式。
社区资源#
- GitHub Issues:访问 YOLO26 GitHub 仓库,使用 Issues 标签页提问、报告错误并建议新功能。社区成员和维护者都非常活跃,随时乐于提供帮助。
- Ultralytics Discord 服务器:加入 Ultralytics Discord 服务器,与其他用户和开发者交流、获取支持并分享经验。
使用这些资源可以帮助你解决问题,并及时了解计算机视觉社区的最新趋势和实践。
要点总结#
训练计算机视觉模型需要遵循良好实践、优化策略,并在问题出现时及时解决。调整批次大小、混合精度训练和从预训练权重开始等技术可以提升模型效果并加快训练速度。子集训练和早停等方法能帮助你节省时间和资源。保持与社区的联系并跟进新趋势,有助于你持续提升模型训练技能。
常见问题#
为提高 GPU 利用率,请将
batch参数设为 GPU 支持的最大值。在单个加速器上,batch=-1会分析模型,并以约 60% 的内存利用率为目标。在 CPU 和 Apple 芯片上,它会回退到batch=16;而多 GPU 运行需要显式设置全局批次大小,且该值至少要等于设备数量。更多信息请参阅训练模式参数。混合精度训练同时使用 16 位(FP16)和 32 位(FP32)浮点类型,以平衡计算速度和精度。在 YOLO26 中,混合精度默认通过
amp=True启用;将amp=False设置为强制使用 FP32。CPU 和 Apple 芯片上会跳过 AMP。多尺度训练通过使用不同尺寸的图像进行训练来提升模型性能,使模型能够更好地泛化到不同尺度和距离的目标。YOLO26 为此提供了两个独立参数。
scale=0.5会在 0.5 到 1.5 之间采样缩放因子,然后通过填充或裁剪恢复为固定的imgsz;而multi_scale=0.25会在每个批次中以步幅为单位改变imgsz本身。有关设置和更多详情,请查看训练模式文档。使用预训练权重可以利用模型已经学到的基础视觉特征,大幅加快训练并提升模型准确率。通过
model参数加载权重,例如model=yolo26n.pt;随后,pretrained会决定保留这些权重(默认值为True)、丢弃这些权重(False),还是替换为另一个检查点(pretrained=path/to/best.pt,这是将权重迁移到model=*.yaml架构的方法)。更多信息请参阅训练模式文档。轮次指模型训练期间对训练数据集进行完整遍历的次数。通常可以从 300 个轮次开始。如果模型过早过拟合,可以减少轮次数。反之,如果没有观察到过拟合,可以将训练延长至 600、1200 个或更多轮次。在 YOLO26 中,可在训练脚本中使用
epochs参数进行设置。有关如何确定理想轮次数的更多建议,请参阅轮次数部分。


评论12
提出问题、分享结果,或帮助其他人。
puzzlemindgames
Hello
I'm working on a browser-based puzzle solver that uses a custom YOLO model to detect visible objects from game screenshots.
Some examples include: Transparent ice/frost overlays on the lower part of objects Semi-transparent cloth or curtain overlays Small decorative objects inside larger objects (for example, keys inside containers) The visible objects are usually detected correctly, but these overlays often cause false negatives or incorrect class predictions.
At the moment I'm considering a few approaches: Training with many more occlusion-heavy examples Splitting the detection into multiple stages instead of one larger model
python results = model.predict( source="level_512.png", conf=0.25, iou=0.45, imgsz=1280 ) for box in results[0].boxes: print(box.cls, box.conf)
For anyone who has trained YOLO models on UI or game screenshots which approach gave you the biggest improvement? Or is there another strategy that tends to work better for partially occluded objects?
I'd really appreciate hearing about real-world experiences before I spend time retraining the dataset.
 Glenn JocherUltralytics
Start with targeted data: add representative occluded examples, keep annotations consistent for partially visible objects, and synthetically composite the actual frost/cloth overlays at realistic opacity and placement. Measure recall per class on a dedicated occlusion-heavy validation split, then tune
mosaic,mixup, orcutmixconservatively; higherimgszor tiled inference can help nested small objects. A multi-stage pipeline is usually worthwhile only if the first stage can reliably isolate containers or overlay regions. Please continue sharing results and questions here so the Ultralytics team and community can see them.1Thanks! I followed your suggestions and added more occluded samples. The main objects/tubes are much more stable as well as the colors now but I'm still struggling with very small objects.
i cant able to attach model training screenshots here for you to review.
For example, tiny keys or tags inside transparent containers are often missed or detected as the wrong class. For context the screenshots come from a puzzle game with objects similar to these shown in sample pictures embedded at product homepage: https://aimagicsortsolver.com/
results = model.predict( source="level.png", imgsz=1280, conf=0.35, iou=0.45 ) Would you recommend keep improving a single model or train a second YOLO model just for these small objects?
- Glenn JocherUltralytics(已编辑)
Keep the single model first: audit tiny-object annotations, add more balanced close-up examples, and test cropped or SAHI tiled inference so keys and tags occupy more pixels; also compare
conf=0.15–0.25, since higher thresholds may suppress weak detections. Train a second specialized model only if the first model reliably detects each container, allowing its crop to be passed to the small-object model at higher effective resolution.1 Thank you for your suggestions. I'll tweak it as per the recommendations.
TSHSLU
What is the minimum Dataset Size required if i use a pretrained model for custom projects. i barely find any sources online which recommend a minimum dataset size.
- Glenn JocherUltralytics
There isn’t a fixed “minimum” dataset size when fine-tuning a pretrained model; if your domain is close to the pretrained data and labels are clean, you can often start getting useful signal with ~50–200 images per class (or a few hundred labeled object instances), but for reliably robust results across different lighting/viewpoints/backgrounds you’ll usually want 500–2000+ images per class with good diversity—one practical way to find your true minimum is to train on a small pilot subset, check validation failures, then add data specifically where the model breaks (the
fractionworkflow in the Model training tips guide helps iterate quickly).from ultralytics import YOLO model = YOLO("yolo26n.pt") model.train(data="data.yaml", epochs=100, fraction=0.1)1
VeeranjaneyuluToka
Hi, I just noticed a thing, looks like the optimizer is getting chosen based on no.of iterations, would you mind telling me the reason for the same? I mean how does iterations matter when we choose optimizer?
Imran-ml
First of all its great to have another powerful model and congratulations. I have fine tuned and trained yolo11x.pt for my custom objects but I'm facing some issues. My images data resolution is around 6000 x 2000 but while trained the model I set the imgsz=(1280, 640). It work well when I adjust the video stream by zoom in-out and detect all my 60 objects well (objects are small) but when there is some zoom or squeezed then it completely dont detect any object or few only.
Please let me know if I'm missing something or I have to do something else? I have labelled the data on my original images so resizing making any issues? any ratio issues? Please guide me properly so I can use this power yolo11 model effectively.
- Glenn JocherUltralytics
@Imran-ml it sounds like the issue might be related to image resizing affecting object detection. Consider enabling multiscale training by adjusting the
scaleparameter to help the model generalize better across different image sizes. This can improve detection performance when objects appear at varying scales. For more detailed guidance, you can refer to our model training tips at https://docs.ultralytics.com/guides/model-training-tips/.
Taufiq-Ahmed
Hi I have a question. I am using Yolov8s for trained a dataset that has four class. fire, smoke, person, animal. all the images has areal view to detect forest fire . In my dataset I have forest fire images from drone so after training it detect fire smoke quite accurately. however, I do not have any dataset that has person or animal in forest fire. so I have to collect some other dataset from roboflow that has person and animal and the n I have merged them with my own dataset ( have changed the label of animal and person accordingly so 0 means smoke, 1 means fire, 2 means person and 3 means animal and also updated the data.yaml file) . this time the problem is it could not detect the animal and person properly some times it can detect them. The main reasons seems to me is that the drone is flying in a high altitude so it does not detect person and animal properly because in the dataset of person and animal the view of the drone is not that much high. is there any technique to solve this problem and detect all the objects as many as possible?
- Glenn JocherUltralytics
@Taufiq-Ahmed it sounds like the altitude difference between your training and test datasets is causing the detection issues. To address this, consider using data augmentation techniques to simulate higher altitude views in your training data. You can also try multiscale training to help the model generalize better across different scales. Additionally, fine-tuning the model with a mix of high-altitude and low-altitude images might improve its performance. For more detailed strategies, you can refer to our model training tips.