测试时增强(TTA)#
📚 本指南介绍如何在 YOLOv5 🚀 的测试和推理过程中使用测试时增强 (TTA),以提升 mAP 和召回率。
开始之前#
克隆仓库,并在包含 PyTorch>=1.8 的 Python>=3.8.0 环境中安装 requirements.txt。模型和数据集会从 YOLOv5 最新版本自动下载。
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install正常测试#
在尝试 TTA 之前,我们先确定基准性能,以便进行比较。此命令会在 COCO val2017 上以 640 像素的图像尺寸测试 YOLOv5x。yolov5x.pt 是可用模型中最大、精度最高的一个。其他选项包括 yolov5n.pt、yolov5s.pt、yolov5m.pt 和 yolov5l.pt,也可以使用你在自定义数据集上训练得到的检查点,例如 runs/train/exp/weights/best.pt。有关所有可用模型的详情,请参阅我们的 YOLOv5 文档。
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --half输出:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients

val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2846.03it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [02:30<00:00,  1.05it/s]
                 all       5000      36335      0.746      0.626       0.68       0.49
Speed: 0.1ms pre-process, 22.4ms inference, 1.4ms NMS per image at shape (32, 3, 640, 640)  # <--- baseline speed

Evaluating pycocotools mAP... saving runs/val/exp/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.504  # <--- baseline mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.688
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.546
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.351
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.551
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.644
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.382
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.628
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.681  # <--- baseline mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.524
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.735
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.826
使用 TTA 测试#
在任何现有的 val.py 命令后添加 --augment 即可启用 TTA,并将图像尺寸增大约 30%,以获得更好的结果。请注意,启用 TTA 后,推理通常需要正常推理时间的约 2-3 倍,因为图像会进行左右翻转,并以 3 种不同分辨率处理,然后在 NMS 前合并输出。速度下降的部分原因仅仅是图像尺寸变大了(832 对比 640),另一部分则来自 TTA 操作本身,因此在增大 --img 之前,请确保 GPU 有足够的可用显存。
python val.py --weights yolov5x.pt --data coco.yaml --img 832 --augment --half输出:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=832, conf_thres=0.001, iou_thres=0.6, task=val, device=, single_cls=False, augment=True, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
/usr/local/lib/python3.7/dist-packages/torch/nn/functional.py:718: UserWarning: Named tensors and all their associated APIs are an experimental feature and subject to change. Please do not use them for anything important until they are released as stable. (Triggered internally at  /pytorch/c10/core/TensorImpl.h:1156.)
  return torch.max_pool2d(input, kernel_size, stride, padding, dilation, ceil_mode)
Model Summary: 476 layers, 87730285 parameters, 0 gradients
val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2885.61it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [07:29<00:00,  2.86s/it]
                 all       5000      36335      0.718      0.656      0.695      0.503
Speed: 0.2ms pre-process, 80.6ms inference, 2.7ms NMS per image at shape (32, 3, 832, 832)  # <--- TTA speed

Evaluating pycocotools mAP... saving runs/val/exp2/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.516  # <--- TTA mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.701
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.562
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.361
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.564
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.656
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.388
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.640
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.696  # <--- TTA mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.553
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.744
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.833
使用 TTA 进行推理#
detect.py 的 TTA 推理与 val.py 的 TTA 推理完全相同:只需在任何现有的 detect.py 命令后添加 --augment:
python detect.py --weights yolov5s.pt --img 832 --source data/images --augment输出:
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Downloading https://github.com/ultralytics/yolov5/releases/download/v5.0/yolov5s.pt to yolov5s.pt...
100% 14.1M/14.1M [00:00<00:00, 81.9MB/s]

Fusing layers...
Model Summary: 224 layers, 7266973 parameters, 0 gradients
image 1/2 /content/yolov5/data/images/bus.jpg: 832x640 4 persons, 1 bus, 1 fire hydrant, Done. (0.029s)
image 2/2 /content/yolov5/data/images/zidane.jpg: 480x832 3 persons, 3 ties, Done. (0.024s)
Results saved to runs/detect/exp
Done. (0.156s)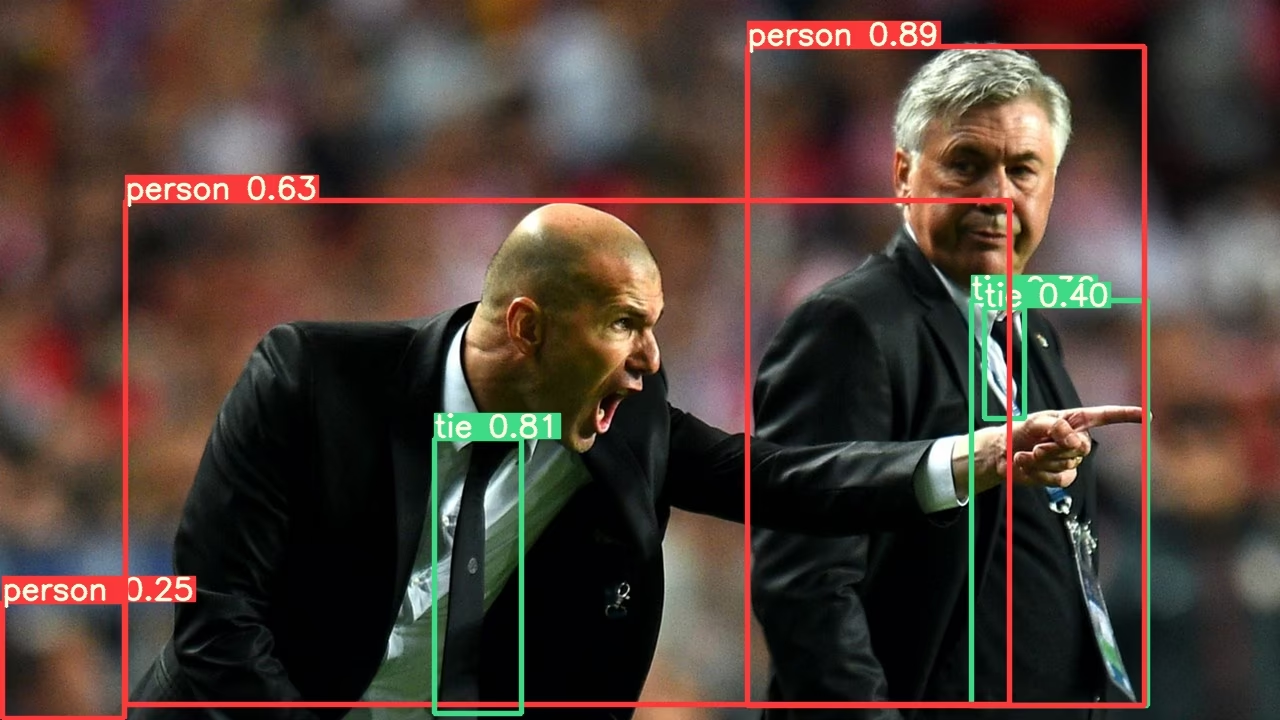
PyTorch Hub TTA#
TTA 已自动集成到所有 YOLOv5 PyTorch Hub 模型中,只需在推理时传入 augment=True 即可使用。
import torch

# Model
model = torch.hub.load("ultralytics/yolov5", "yolov5s")  # 或 yolov5m、yolov5x、自定义

# Images
img = "https://ultralytics.com/images/zidane.jpg"  # 或文件、PIL、OpenCV、numpy、多个

# Inference
results = model(img, augment=True)  # <--- TTA 推理

# Results
results.print() # 或 .show(), .save(), .crop(), .pandas() 等。自定义#
你可以自定义应用于 YOLOv5 forward_augment() 方法的 TTA 操作。
测试时增强的优势#
测试时增强为目标检测任务带来了几个主要优势:
- 精度更高:如上方结果所示,TTA 将 mAP 从 0.504 提升至 0.516,并将 mAR 从 0.681 提升至 0.696。
- 小目标检测效果更好:TTA 尤其能提升小目标的检测效果,小面积目标的 AP 从 0.351 提升至 0.361。
- 鲁棒性更强:通过测试每张图像的多种变化,TTA 降低了视角、光照和其他环境因素的影响。
- 实现简单:只需在现有命令中添加
--augment标志。
代价是推理时间增加,因此 TTA 更适用于优先考虑精度而非速度的应用。
支持的环境#
Ultralytics 提供多种开箱即用的环境,每种环境都预装了 CUDA、CUDNN、Python 和 PyTorch 等必备依赖,助你快速启动项目。
- 免费 GPU 笔记本:


- Google Cloud:GCP 快速入门指南
- Amazon:AWS 快速入门指南
- Azure:AzureML 快速入门指南
- Docker:Docker 快速入门指南

项目状态#

此徽章表示所有 YOLOv5 GitHub Actions 持续集成 (CI) 测试均已成功通过。这些 CI 测试会严格检查 YOLOv5 在多个关键方面的功能和性能:训练、验证、推理、导出和基准测试。这些测试每 24 小时以及每次提交新代码后运行一次,确保 YOLOv5 在 macOS、Windows 和 Ubuntu 上保持稳定可靠地运行。
常见问题#
每张图像会以三种尺度运行,并进行左右翻转,预测结果会在 NMS 前合并。额外的视图能提高召回率,尤其是小目标的召回率,但需要更多计算资源。
预计推理时间约为正常情况下的 2-3 倍。部分开销来自更大的
--img尺寸,因此在增大尺寸之前,请确保 GPU 有足够的显存。将分辨率增大约 30%,例如从 640 提高到 832,可以让多尺度处理获得更多细节;上述基准测试表明,这样的效果最好。
增强前向传播位于 PyTorch
DetectionModel中,因此--augment只影响.pt检查点。导出的 ONNX、TensorRT 和其他格式会忽略它。