تحسين الاستدلال باستخدام OpenVINO لـ YOLO#
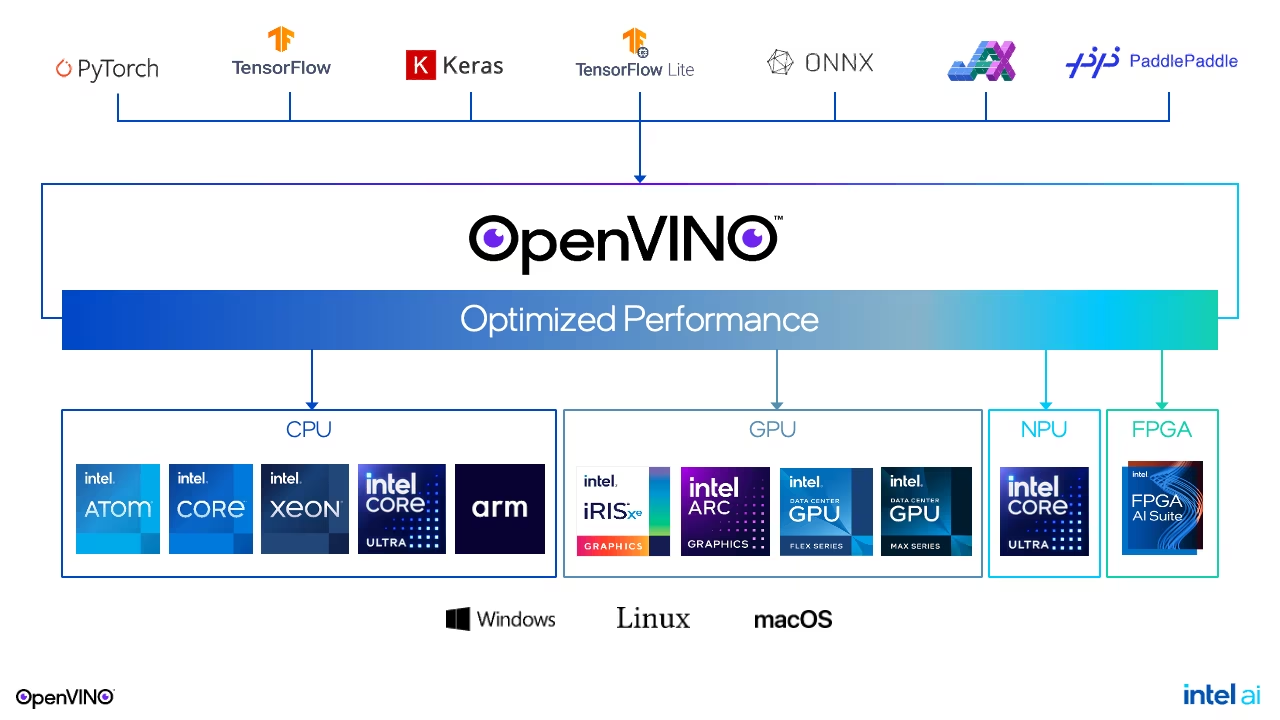
مقدمة#
عند نشر نماذج التعلم العميق، ولا سيما نماذج اكتشاف الكائنات مثل نماذج Ultralytics YOLO، يُعد تحقيق الأداء الأمثل أمراً بالغ الأهمية. يتناول هذا الدليل بالتفصيل كيفية الاستفادة من مجموعة أدوات OpenVINO من Intel لتحسين الاستدلال، مع التركيز على زمن الاستجابة ومعدل الإنتاجية. سواء أكنت تعمل على تطبيقات موجهة للمستهلكين أم عمليات نشر واسعة النطاق، فإن فهم استراتيجيات التحسين هذه وتطبيقها يضمن تشغيل نماذجك بكفاءة على مختلف الأجهزة.
التحسين لزمن الاستجابة#
يُعد تحسين زمن الاستجابة أمراً أساسياً للتطبيقات التي تتطلب استجابة فورية من نموذج واحد عند تزويده بمدخل واحد، وهو أمر شائع في سيناريوهات الاستخدام الاستهلاكي. والهدف هو تقليل التأخير بين إدخال البيانات وظهور نتيجة الاستدلال. ومع ذلك، يتطلب تحقيق زمن استجابة منخفض دراسة متأنية، خصوصاً عند تشغيل عمليات استدلال متزامنة أو إدارة نماذج متعددة.
الاستراتيجيات الأساسية لتحسين زمن الاستجابة#
- استدلال واحد لكل جهاز: أبسط طريقة لتحقيق زمن استجابة منخفض هي قصر كل جهاز على عملية استدلال واحدة في كل مرة. وغالباً ما يؤدي التزامن الإضافي إلى زيادة زمن الاستجابة.
- الاستفادة من الأجهزة الفرعية: يمكن للأجهزة مثل وحدات CPU متعددة المقابس أو وحدات GPU متعددة الشرائح تنفيذ طلبات متعددة مع زيادة طفيفة في زمن الاستجابة، وذلك بالاستفادة من أجهزتها الفرعية الداخلية.
- تلميحات أداء OpenVINO: يؤدي استخدام
ov::LATENCYمن OpenVINO لخاصيةov::performance_modeأثناء تجميع النموذج إلى تبسيط ضبط الأداء، ويوفر نهجاً مستقلاً عن الجهاز ومواكباً للمستقبل.
إدارة زمن استجابة الاستدلال الأول#
- التخزين المؤقت للنموذج: للحد من تأثير وقت تحميل النموذج وتجميعه في زمن الاستجابة، استخدم التخزين المؤقت للنموذج متى أمكن. وفي الحالات التي يتعذر فيها التخزين المؤقت، توفر وحدات CPU عموماً أسرع أوقات تحميل للنماذج.
- تعيين النموذج مقابل قراءته: لتقليل أوقات التحميل، استبدل OpenVINO قراءة النموذج بتعيينه إلى الذاكرة. ومع ذلك، إذا كان النموذج على محرك أقراص قابل للإزالة أو محرك شبكي، فاستخدم
ov::enable_mmap(false)للعودة إلى القراءة. - اختيار الجهاز AUTO: يبدأ هذا الوضع الاستدلال على CPU، ثم ينتقل إلى مسرّع بمجرد أن يصبح جاهزاً، ما يقلل بسلاسة زمن استجابة الاستدلال الأول.
التحسين لمعدل الإنتاجية#
يُعد تحسين معدل الإنتاجية بالغ الأهمية للسيناريوهات التي تخدم العديد من طلبات الاستدلال في الوقت نفسه، إذ يحقق أقصى استفادة من الموارد دون التضحية بشكل كبير بأداء الطلبات الفردية.
أساليب تحسين معدل الإنتاجية#
-
تلميحات أداء OpenVINO: طريقة عالية المستوى ومواكبة للمستقبل لتعزيز معدل الإنتاجية عبر الأجهزة باستخدام تلميحات الأداء.
import openvino as ov import openvino.properties.hint as hints core = ov.Core() model = core.read_model("yolo26n_openvino_model/yolo26n.xml") config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT} compiled_model = core.compile_model(model, "GPU", config) -
التجميع الصريح وتدفقات التنفيذ: نهج أكثر تفصيلاً يتضمن التجميع الصريح واستخدام تدفقات التنفيذ لضبط الأداء المتقدم.
تصميم التطبيقات الموجّهة لمعدل الإنتاجية#
لتحقيق أقصى معدل إنتاجية، ينبغي للتطبيقات أن:
- تعالج المدخلات بالتوازي، مع الاستفادة الكاملة من إمكانات الجهاز.
- تقسّم تدفق البيانات إلى طلبات استدلال متزامنة، تُجدول للتنفيذ بالتوازي.
- تستخدم Async API مع عمليات الاستدعاء اللاحقة للحفاظ على الكفاءة وتجنب ترك الجهاز دون عمل.
التنفيذ على أجهزة متعددة#
يسهّل وضع الأجهزة المتعددة في OpenVINO توسيع معدل الإنتاجية من خلال توزيع طلبات الاستدلال تلقائياً بين الأجهزة، دون الحاجة إلى إدارة الأجهزة على مستوى التطبيق.
تحسينات الأداء في الاستخدام الفعلي#
يمكن أن يؤدي تطبيق تحسينات OpenVINO مع نماذج Ultralytics YOLO إلى تحسينات كبيرة في الأداء. وكما توضح الاختبارات المعيارية، يمكن للمستخدمين تحقيق استدلال أسرع بما يصل إلى 3 أضعاف على وحدات CPU من Intel، مع إمكانية تحقيق تسريع أكبر عبر نطاق عتاد Intel، بما في ذلك وحدات GPU المدمجة ووحدات GPU المخصصة ووحدات NPU.
على سبيل المثال، عند تشغيل نماذج YOLO26 على وحدات CPU من Intel Xeon، تتفوق الإصدارات المحسّنة باستخدام OpenVINO باستمرار على نظيراتها في PyTorch من حيث زمن الاستدلال لكل صورة، دون المساس بـالدقة.
التطبيق العملي#
لتصدير نموذج Ultralytics YOLO وتحسينه للعمل مع OpenVINO، يمكنك استخدام وظيفة التصدير:
from ultralytics import YOLO
# تحميل نموذج
model = YOLO("yolo26n.pt")
# تصدير النموذج بتنسيق OpenVINO
model.export(format="openvino", quantize=16) # التصدير بدقة FP16بعد التصدير، يمكنك تشغيل الاستدلال باستخدام النموذج المحسّن:
# تحميل نموذج OpenVINO
ov_model = YOLO("yolo26n_openvino_model/")
# تشغيل الاستدلال (تجمع Ultralytics نماذج OpenVINO باستخدام تلميح الأداء LATENCY)
results = ov_model("https://ultralytics.com/images/bus.jpg", verbose=True)الخلاصة#
يمكن أن يؤدي تحسين نماذج Ultralytics YOLO لزمن الاستجابة ومعدل الإنتاجية باستخدام OpenVINO إلى تعزيز أداء تطبيقك بشكل كبير. ومن خلال تطبيق الاستراتيجيات الموضحة في هذا الدليل بعناية، يمكن للمطورين ضمان تشغيل نماذجهم بكفاءة وتلبية متطلبات مختلف سيناريوهات النشر. تذكّر أن الاختيار بين التحسين لزمن الاستجابة أو لمعدل الإنتاجية يعتمد على احتياجات تطبيقك المحددة وخصائص بيئة النشر.
للحصول على معلومات تقنية أكثر تفصيلاً وأحدث التحديثات، راجع وثائق OpenVINO ومستودع Ultralytics YOLO. توفر هذه الموارد أدلة وشروحات مفصلة ودعماً من المجتمع لمساعدتك على تحقيق أقصى استفادة من نماذج التعلم العميق.
لا يقتصر ضمان تحقيق نماذجك للأداء الأمثل على تعديل الإعدادات فحسب؛ بل يتطلب فهم احتياجات تطبيقك واتخاذ قرارات مدروسة. سواء أكنت تحسّن الاستجابات في الوقت الفعلي أم تزيد معدل الإنتاجية إلى أقصى حد للمعالجة واسعة النطاق، فإن الجمع بين نماذج Ultralytics YOLO وOpenVINO يوفر للمطورين مجموعة أدوات قوية لنشر حلول ذكاء اصطناعي عالية الأداء.
الأسئلة الشائعة#
يتطلب تحسين نماذج Ultralytics YOLO لزمن استجابة منخفض تطبيق عدة استراتيجيات أساسية:
- استدلال واحد لكل جهاز: اقتصر على عملية استدلال واحدة في كل مرة لكل جهاز لتقليل التأخير.
- الاستفادة من الأجهزة الفرعية: استخدم أجهزة مثل وحدات CPU متعددة المقابس أو وحدات GPU متعددة الشرائح، التي يمكنها معالجة طلبات متعددة مع زيادة طفيفة في زمن الاستجابة.
- تلميحات أداء OpenVINO: استخدم
ov::LATENCYمن OpenVINO أثناء تجميع النموذج لإجراء ضبط مبسط ومستقل عن الجهاز.
للاطلاع على مزيد من النصائح العملية لتحسين زمن الاستجابة، راجع قسم تحسين زمن الاستجابة في دليلنا.
يعزز OpenVINO معدل إنتاجية نماذج Ultralytics YOLO من خلال زيادة الاستفادة من موارد الجهاز إلى أقصى حد دون التضحية بالأداء. وتشمل الفوائد الأساسية:
- تلميحات الأداء: ضبط أداء بسيط وعالي المستوى عبر الأجهزة.
- التجميع الصريح وتدفقات التنفيذ: ضبط دقيق لتحسين الأداء المتقدم.
- التنفيذ على أجهزة متعددة: موازنة تلقائية لأحمال الاستدلال، ما يسهّل الإدارة على مستوى التطبيق.
مثال على الإعداد:
import openvino as ov
import openvino.properties.hint as hints

core = ov.Core()
model = core.read_model("yolo26n_openvino_model/yolo26n.xml")
config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT}
compiled_model = core.compile_model(model, "GPU", config)
تعرّف على المزيد حول تحسين معدل الإنتاجية في قسم تحسين معدل الإنتاجية من دليلنا المفصل.
لتقليل زمن استجابة الاستدلال الأول، ضع في اعتبارك الممارسات التالية:
- التخزين المؤقت للنموذج: استخدم التخزين المؤقت للنموذج لتقليل وقت التحميل والتجميع.
- تعيين النموذج مقابل قراءته: استخدم التعيين (
ov::enable_mmap(true)) افتراضياً، وانتقل إلى القراءة (ov::enable_mmap(false)) إذا كان النموذج على محرك أقراص قابل للإزالة أو محرك شبكي. - اختيار الجهاز AUTO: استخدم وضع AUTO لبدء الاستدلال على CPU والانتقال بسلاسة إلى مسرّع.
للاطلاع على استراتيجيات مفصلة لإدارة زمن استجابة الاستدلال الأول، راجع قسم إدارة زمن استجابة الاستدلال الأول.
يتطلب تحقيق التوازن بين تحسين زمن الاستجابة ومعدل الإنتاجية فهم احتياجات تطبيقك:
- تحسين زمن الاستجابة: مثالي للتطبيقات الآنية التي تتطلب استجابات فورية (مثل تطبيقات المستهلكين).
- تحسين معدل الإنتاجية: الأنسب للسيناريوهات التي تتضمن العديد من عمليات الاستدلال المتزامنة، مع زيادة الاستفادة من الموارد إلى أقصى حد (مثل عمليات النشر واسعة النطاق).
يمكن أن يساعد استخدام تلميحات الأداء عالية المستوى وأوضاع الأجهزة المتعددة في OpenVINO على تحقيق التوازن المناسب. اختر تلميحات أداء OpenVINO المناسبة وفقاً لمتطلباتك المحددة.
نعم، تتميز نماذج Ultralytics YOLO بمرونة كبيرة ويمكن دمجها مع أطر عمل متنوعة للذكاء الاصطناعي. ومن الخيارات المتاحة:
- TensorRT: لتحسين الأداء على وحدات GPU من NVIDIA، اتبع دليل تكامل TensorRT.
- CoreML: لأجهزة Apple، راجع تعليمات التصدير إلى CoreML.
- LiteRT.js: لتطبيقات الويب وNode.js، راجع دليل تكامل LiteRT وبيئة تشغيل LiteRT.js للويب.
استكشف مزيداً من عمليات التكامل في صفحة عمليات تكامل Ultralytics.