ImageNet-Datensatz#
Der Ultralytics ImageNet-Datensatz (data="imagenet") ist die ImageNet-1k-/ILSVRC-2012-Teilmenge, die zum Trainieren und Bewerten von Bildklassifizierungs-Modellen verwendet wird. Sie umfasst 1.000 Objektklassen mit 1.281.167 Trainingsbildern und 50.000 Validierungsbildern, wird üblicherweise mit einer Bildgröße von 224x224 trainiert und erfordert einen Download von ungefähr 144 GB. Die umfassendere ImageNet-Datenbank ist wesentlich größer: Sie umfasst über 14 Millionen hochauflösende Bilder, die mit WordNet-Synsets aus mehr als 20.000 Kategorien annotiert sind. Ultralytics trainiert jedoch mit der standardisierten ILSVRC-Teilmenge mit 1.000 Klassen, die sich als De-facto-Benchmark für Deep Learning im Bereich Computer Vision etabliert hat.
Mit ImageNet vortrainierte Modelle#
| Modell | Größe (Pixel) | acc top1 | acc top5 | Geschwindigkeit CPU ONNX (ms) | Geschwindigkeit T4 TensorRT10 (ms) | Parameter (M) | FLOPs (B) bei 224 |
|---|---|---|---|---|---|---|---|
| YOLO26n-cls | 224 | 71.4 | 90.1 | 5.0 ± 0.3 | 1.1 ± 0.0 | 2.8 | 0.4 |
| YOLO26s-cls | 224 | 76.0 | 92.9 | 7.9 ± 0.2 | 1.3 ± 0.0 | 6.7 | 1.5 |
| YOLO26m-cls | 224 | 78.1 | 94.2 | 17.2 ± 0.4 | 2.0 ± 0.0 | 11.6 | 4.8 |
| YOLO26l-cls | 224 | 79.0 | 94.6 | 23.2 ± 0.3 | 2.8 ± 0.0 | 14.1 | 6.0 |
| YOLO26x-cls | 224 | 79.9 | 95.0 | 41.4 ± 0.9 | 3.8 ± 0.0 | 29.6 | 13.5 |
Wichtige Funktionen#
- Der Ultralytics-Datensatz
imagenetumfasst 1.000 Klassen mit 1.281.167 Trainings- und 50.000 Validierungsbildern (ILSVRC-2012) und ist der Standardbenchmark für das Vortraining von Bildklassifizierungsmodellen. - Die Klassen sind gemäß der WordNet-Hierarchie organisiert. Jede Klasse entspricht einem Synset (einer Menge bedeutungsgleicher Begriffe).
- Die Bilder werden mit einer Größe von 224x224 trainiert. Der vollständige Datensatz umfasst einen großen Download von ~144 GB.
- Der jährlich stattfindende ImageNet-Wettbewerb zur groß angelegten visuellen Erkennung (ILSVRC) hat maßgeblich zur Weiterentwicklung der Computer-Vision-Forschung beigetragen.
Datensatzstruktur#
Der Ultralytics-ImageNet-Datensatz verwendet die ILSVRC-2012-Aufteilung:
| Aufteilung | Bilder | Klassen |
|---|---|---|
| Trainieren | 1,281,167 | 1,000 |
| Validierung | 50,000 | 1,000 |
Die Bilder befinden sich in Klassenordnern, die nach der WordNet-Synset-ID benannt sind (zum Beispiel n01440764) – so ist es für das Klassifizierungstraining von Ultralytics erforderlich. Jede der 1.000 Klassen ist einem WordNet-Synset zugeordnet. Da es keine separate Testaufteilung gibt, wird der Validierungssatz mit 50.000 Bildern verwendet, um die Genauigkeit zu messen.
ImageNet-1k umfasst einen Download von ~144 GB. Stelle daher vor dem Training sicher, dass ausreichend Speicherplatz vorhanden ist. Für schnelle Experimente kannst du die kleineren Teilmengen ImageNette und ImageNet10 verwenden. Sie haben dasselbe Ordnerformat und lassen sich in einem Bruchteil der Zeit trainieren.
ImageNet-Wettbewerb zur groß angelegten visuellen Erkennung (ILSVRC)#
Der jährlich stattfindende ImageNet-Wettbewerb zur groß angelegten visuellen Erkennung (ILSVRC) ermöglichte Forschenden, Algorithmen anhand eines umfangreichen, standardisierten Datensatzes mit einheitlichen Bewertungsmetriken zu vergleichen. Er trieb wichtige Fortschritte im Deep Learning für Bildklassifizierung, Objekterkennung und andere Bildverarbeitungsaufgaben voran. Besonders hervorzuheben ist AlexNets Sieg im Jahr 2012, der den Beginn der modernen Deep-Learning-Ära mitprägte.
Anwendungsfälle#
Der ImageNet-Datensatz wird häufig zum Trainieren und Evaluieren von Deep-Learning-Modellen für Bildklassifizierung, Objekterkennung und Objektlokalisierung verwendet. Bedeutende Architekturen wie AlexNet, VGG und ResNet wurden allesamt auf ImageNet entwickelt und bewertet. Mit ImageNet vortrainierte Gewichte sind nach wie vor ein gängiger Ausgangspunkt für Transfer Learning bei verschiedenen Bildverarbeitungsaufgaben.
Verwendung#
Verwende die folgenden Codeausschnitte, um ein YOLO-Klassifizierungsmodell auf ImageNet für 100 Epochen mit einer Bildgröße von 224x224 zu trainieren. Eine umfassende Liste der verfügbaren Argumente findest du auf der Seite Training des Modells.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n-cls.pt")  # ein vortrainiertes Modell laden (für das Training empfohlen)

# Das Modell trainieren
results = model.train(data="imagenet", epochs=100, imgsz=224)
Mit der Ultralytics Platform kannst du außerdem Klassifizierungsdatensätze verwalten und Trainingsläufe in der Cloud ausführen.
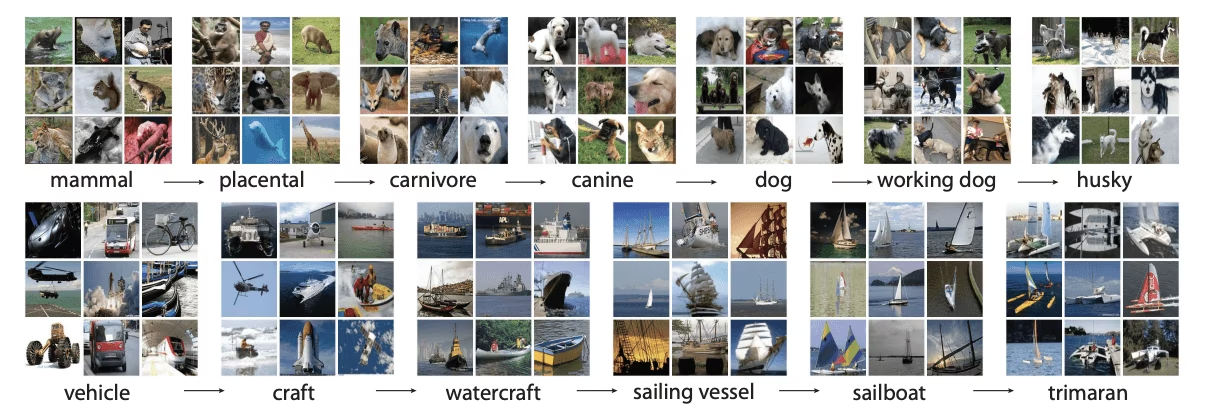
Beispielbilder und Annotationen#
Der ImageNet-Datensatz umfasst die 1.000 ILSVRC-2012-Klassen und bietet eine vielfältige, umfangreiche Ressource zum Trainieren und Evaluieren von Computer-Vision-Modellen. Hier sind einige Beispielbilder aus dem Datensatz:
Zitate und Danksagungen#
Wenn du den ImageNet-Datensatz in deiner Forschung oder Entwicklungsarbeit verwendest, zitiere bitte die folgende Arbeit:
@article{ILSVRC15,
         author = {Olga Russakovsky and Jia Deng and Hao Su and Jonathan Krause and Sanjeev Satheesh and Sean Ma and Zhiheng Huang and Andrej Karpathy and Aditya Khosla and Michael Bernstein and Alexander C. Berg and Li Fei-Fei},
         title={ImageNet Large Scale Visual Recognition Challenge},
         year={2015},
         journal={International Journal of Computer Vision (IJCV)},
         volume={115},
         number={3},
         pages={211-252}
}
Wir möchten dem ImageNet-Team unter der Leitung von Olga Russakovsky, Jia Deng und Li Fei-Fei dafür danken, dass es den ImageNet-Datensatz erstellt und gepflegt und ihn so der Forschungscommunity für maschinelles Lernen und Computer Vision als wertvolle Ressource zur Verfügung gestellt hat. Weitere Informationen zum ImageNet-Datensatz und seinen Erstellern findest du auf der ImageNet-Website.
Häufig gestellte Fragen#
Der ImageNet-Datensatz ist eine umfangreiche Bilddatenbank, deren vollständige Sammlung über 14 Millionen hochauflösende Bilder mit WordNet-Synset-Annotationen umfasst. Bei Ultralytics wird mit
data="imagenet"die standardisierte ILSVRC-2012-Teilmenge mit 1.000 Klassen trainiert, die der De-facto-Benchmark für das Vortraining von Bildklassifizierungs-Modellen ist. Bedeutende Modelle wie AlexNet, VGG und ResNet wurden auf ImageNet trainiert und bewertet. Das unterstreicht die wichtige Rolle des Datensatzes für die Weiterentwicklung von Computer Vision.Der Ultralytics-Datensatz
imagenetverwendet die ILSVRC-2012-Teilmenge mit 1.000 Klassen, 1.281.167 Trainingsbildern und 50.000 Validierungsbildern. Üblicherweise wird mit einer Bildgröße von 224x224 trainiert; der Download umfasst ungefähr 144 GB. Die vollständige ImageNet-Datenbank ist wesentlich größer und enthält über 14 Millionen Bilder aus mehr als 20.000 WordNet-Synsets. Für das Klassifizierungstraining und Benchmarking wird jedoch die Teilmenge mit 1.000 Klassen verwendet.Um ein Ultralytics-YOLO-Modell auf ImageNet zu trainieren, lade ein vortrainiertes Klassifizierungsmodell und verweise
dataaufimagenet:Trainingsbeispielfrom ultralytics import YOLO # Ein Modell laden model = YOLO("yolo26n-cls.pt") # ein vortrainiertes Modell laden (für das Training empfohlen) # Das Modell trainieren results = model.train(data="imagenet", epochs=100, imgsz=224)Ausführlichere Anweisungen zum Training findest du auf unserer Seite Training.
Vortrainierte Ultralytics-YOLO26-Modelle bieten bei verschiedenen Computer-Vision-Aufgaben eine Spitzenleistung in Bezug auf Geschwindigkeit und Genauigkeit. Das Modell YOLO26n-cls ist beispielsweise mit einer Top-1-Genauigkeit von 71,4 % und einer Top-5-Genauigkeit von 90,1 % für Echtzeitanwendungen optimiert. Vortrainierte Modelle reduzieren den Rechenaufwand, der beim Training von Grund auf nötig wäre, und beschleunigen die Entwicklungszyklen. Mehr zu den Leistungsmetriken der YOLO26-Modelle erfährst du im Abschnitt Mit ImageNet vortrainierte Modelle.
Der jährlich stattfindende ImageNet-Wettbewerb zur groß angelegten visuellen Erkennung (ILSVRC) trieb die Weiterentwicklung von Computer Vision voran, indem er eine Wettbewerbsplattform bot, auf der Algorithmen anhand eines umfangreichen, standardisierten Datensatzes bewertet werden konnten. Die einheitlichen Bewertungsmetriken förderten Innovationen bei Bildklassifizierung, Objekterkennung und Bildsegmentierung und verschoben die Grenzen von Deep Learning und Computer Vision kontinuierlich.