SKU-110K-Datensatz
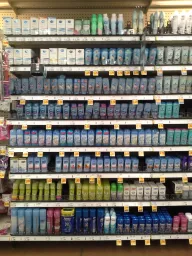
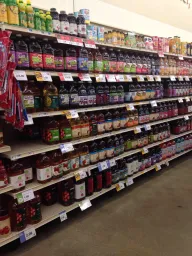
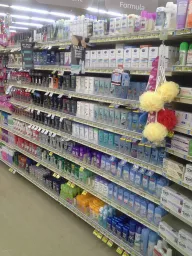
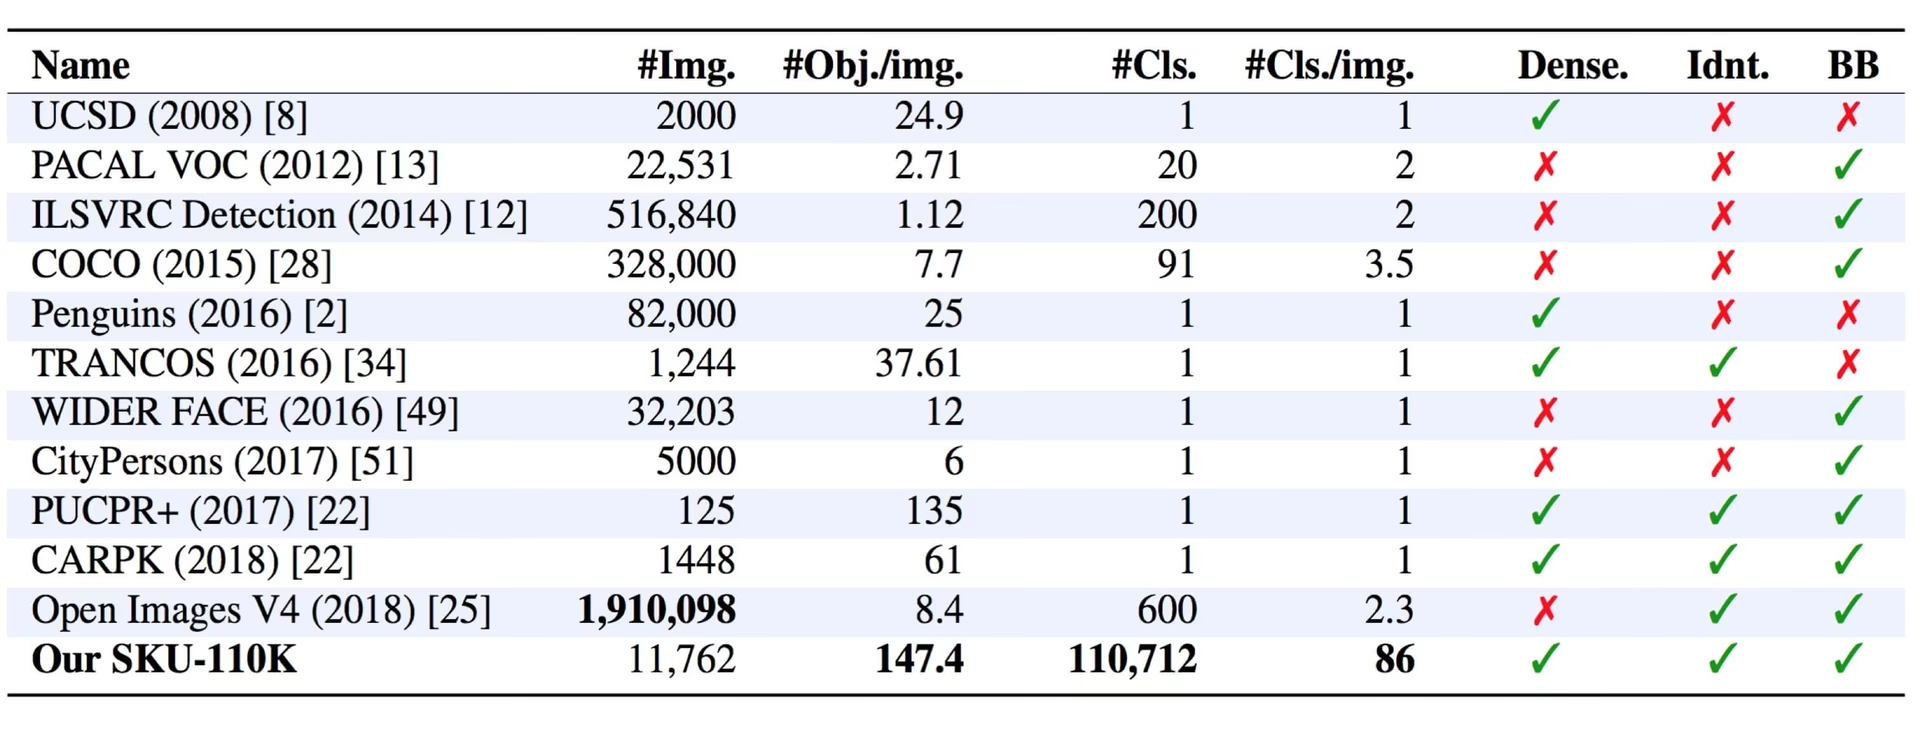
Der SKU-110K-Datensatz ist ein Datensatz mit einer Klasse zur Objekterkennung. Er umfasst 11.743 Bilder dicht bestückter Verkaufsregale, aufgeteilt in 8.219 Trainings-, 588 Validierungs- und 2.936 Testbilder. Jedes Produkt ist mit einer einzelnen Bounding Box und einer einzigen Klasse annotiert: object – der Name bezieht sich auf die mehr als 110.000 einzigartigen gelagerten Artikel (SKUs), die auf den Bildern zu sehen sind, und nicht auf 110.000 Erkennungsklassen. Eran Goldman et al. erstellten den Datensatz für die CVPR-Arbeit von 2019 Precise Detection in Densely Packed Scenes. Er enthält mehr als 1,7 Millionen annotierte Produkte – durchschnittlich etwa 147 pro Bild – und ist damit ein anspruchsvoller Benchmark für Computer Vision-Modelle in belebten Einzelhandelsumgebungen.
Ansehen: So trainierst du Ultralytics YOLO26, damit alle Produkte in einem Verkaufsregal erkannt werden | SKU-110K 🛒
Wichtige Funktionen#
- Erkennung mit einer Klasse: Jedes Produkt wird mit einer Bounding Box einer einzigen Klasse zugeordnet,
object(names: {0: object}) – die Annotationen enthalten keine SKU-spezifischen Kategorien. - Extrem hohe Objektdichte: Die Bilder von Verkaufsregalen aus aller Welt zeigen durchschnittlich etwa 147 dicht gepackte Produkte, wobei die Objekte oft ähnlich oder sogar identisch aussehen und dicht beieinanderliegen.
- Großer Umfang: Mehr als 110.000 einzigartige SKUs und über 1,7 Millionen annotierte Bounding Boxes auf 11.743 Bildern stellen hochmoderne Objektdetektoren auf die Probe.
Datensatzstruktur#
Der SKU-110K-Datensatz ist in drei Teilmengen aufgeteilt, die alle dieselbe Klasse object verwenden:
| Aufteilung | Bilder | Beschreibung |
|---|---|---|
| Trainieren | 8,219 | Bilder und Annotationen zum Trainieren des Modells |
| Validierung | 588 | Zurückgehaltene Bilder zur Auswertung während des Trainings |
| Test | 2,936 | Bilder zur abschließenden Auswertung des trainierten Modells |
Anwendungsfälle#
Der SKU-110K-Datensatz wird häufig zum Trainieren und Auswerten von Deep-Learning-Modellen für Aufgaben der Objekterkennung verwendet, insbesondere in dicht gepackten Szenen wie Verkaufsregalen. Zu den Anwendungsbereichen gehören:
- Einzelhandels-Bestandsverwaltung und Automatisierung
- Produkterkennung auf E-Commerce-Plattformen
- Überprüfung der Planogrammkonformität
- Selbstbedienungskassen in Geschäften
- Robotergestütztes Kommissionieren und Sortieren in Lagern
Um eigene Regalbilder zu annotieren, Modelle zu trainieren und Datensätze zur Einzelhandelserkennung im Browser zu verwalten, kannst du den gesamten Arbeitsablauf mit der Ultralytics Platform ausführen.
YAML-Datei des Datensatzes#
Die Datei SKU-110K.yaml legt die Datensatzkonfiguration fest – die Datensatzpfade, Klassennamen und weitere Metadaten. Sie wird im Ultralytics-Repository unter https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/SKU-110K.yaml gepflegt.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# SKU-110K retail items dataset https://github.com/eg4000/SKU110K_CVPR19 by Trax Retail
# Documentation: https://docs.ultralytics.com/datasets/detect/sku-110k
# Example usage: yolo train data=SKU-110K.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── SKU-110K ← downloads here (13.6 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: SKU-110K # dataset root dir
train: train.txt # train images (relative to 'path') 8219 images
val: val.txt # val images (relative to 'path') 588 images
test: test.txt # test images (optional) 2936 images

# Classes
names:
  0: object

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import shutil
  from pathlib import Path

  import numpy as np
  import polars as pl

  from ultralytics.utils import TQDM
  from ultralytics.utils.downloads import download
  from ultralytics.utils.ops import xyxy2xywh

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  parent = Path(dir.parent)  # download dir
  urls = ["http://trax-geometry.s3.amazonaws.com/cvpr_challenge/SKU110K_fixed.tar.gz"]
  download(urls, dir=parent)

  # Rename directories
  if dir.exists():
      shutil.rmtree(dir)
  (parent / "SKU110K_fixed").rename(dir)  # rename dir
  (dir / "labels").mkdir(parents=True, exist_ok=True)  # create labels dir

  # Convert labels
  names = "image", "x1", "y1", "x2", "y2", "class", "image_width", "image_height"  # column names
  for d in "annotations_train.csv", "annotations_val.csv", "annotations_test.csv":
      x = pl.read_csv(dir / "annotations" / d, has_header=False, new_columns=names, infer_schema_length=None).to_numpy()  # annotations
      images, unique_images = x[:, 0], np.unique(x[:, 0])
      with open((dir / d).with_suffix(".txt").__str__().replace("annotations_", ""), "w", encoding="utf-8") as f:
          f.writelines(f"./images/{s}\n" for s in unique_images)
      for im in TQDM(unique_images, desc=f"Converting {dir / d}"):
          cls = 0  # single-class dataset
          with open((dir / "labels" / im).with_suffix(".txt"), "a", encoding="utf-8") as f:
              for r in x[images == im]:
                  w, h = r[6], r[7]  # image width, height
                  xywh = xyxy2xywh(np.array([[r[1] / w, r[2] / h, r[3] / w, r[4] / h]]))[0]  # instance
f.write(f"{cls} {xywh[0]:.5f} {xywh[1]:.5f} {xywh[2]:.5f} {xywh[3]:.5f}\n") # write labelVerwendung#
Der SKU-110K-Datensatz wird beim ersten Training automatisch heruntergeladen und benötigt für seine 11.743 Bilder etwa 13.6 GB freien Speicherplatz. Das Downloadskript lädt auch die Originalannotationen herunter und konvertiert sie ins YOLO-Format. Dieser Vorgang kann einige Minuten dauern.
Um ein YOLO26n-Modell 100 Epochen lang mit Bildgröße 640 auf dem SKU-110K-Datensatz zu trainieren, kannst du die folgenden Codeausschnitte verwenden.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n.pt")  # ein vortrainiertes Modell laden (für das Training empfohlen)

# Das Modell trainieren
results = model.train(data="SKU-110K.yaml", epochs=100, imgsz=640)
Beispieldaten und Annotationen#
Die Bilder des SKU-110K-Datensatzes zeigen dicht gepackte Produkte in echten Verkaufsregalen, in denen Dutzende nahezu identischer Artikel nebeneinanderstehen. Hier siehst du ein Beispielbild mit seinen Annotationen:
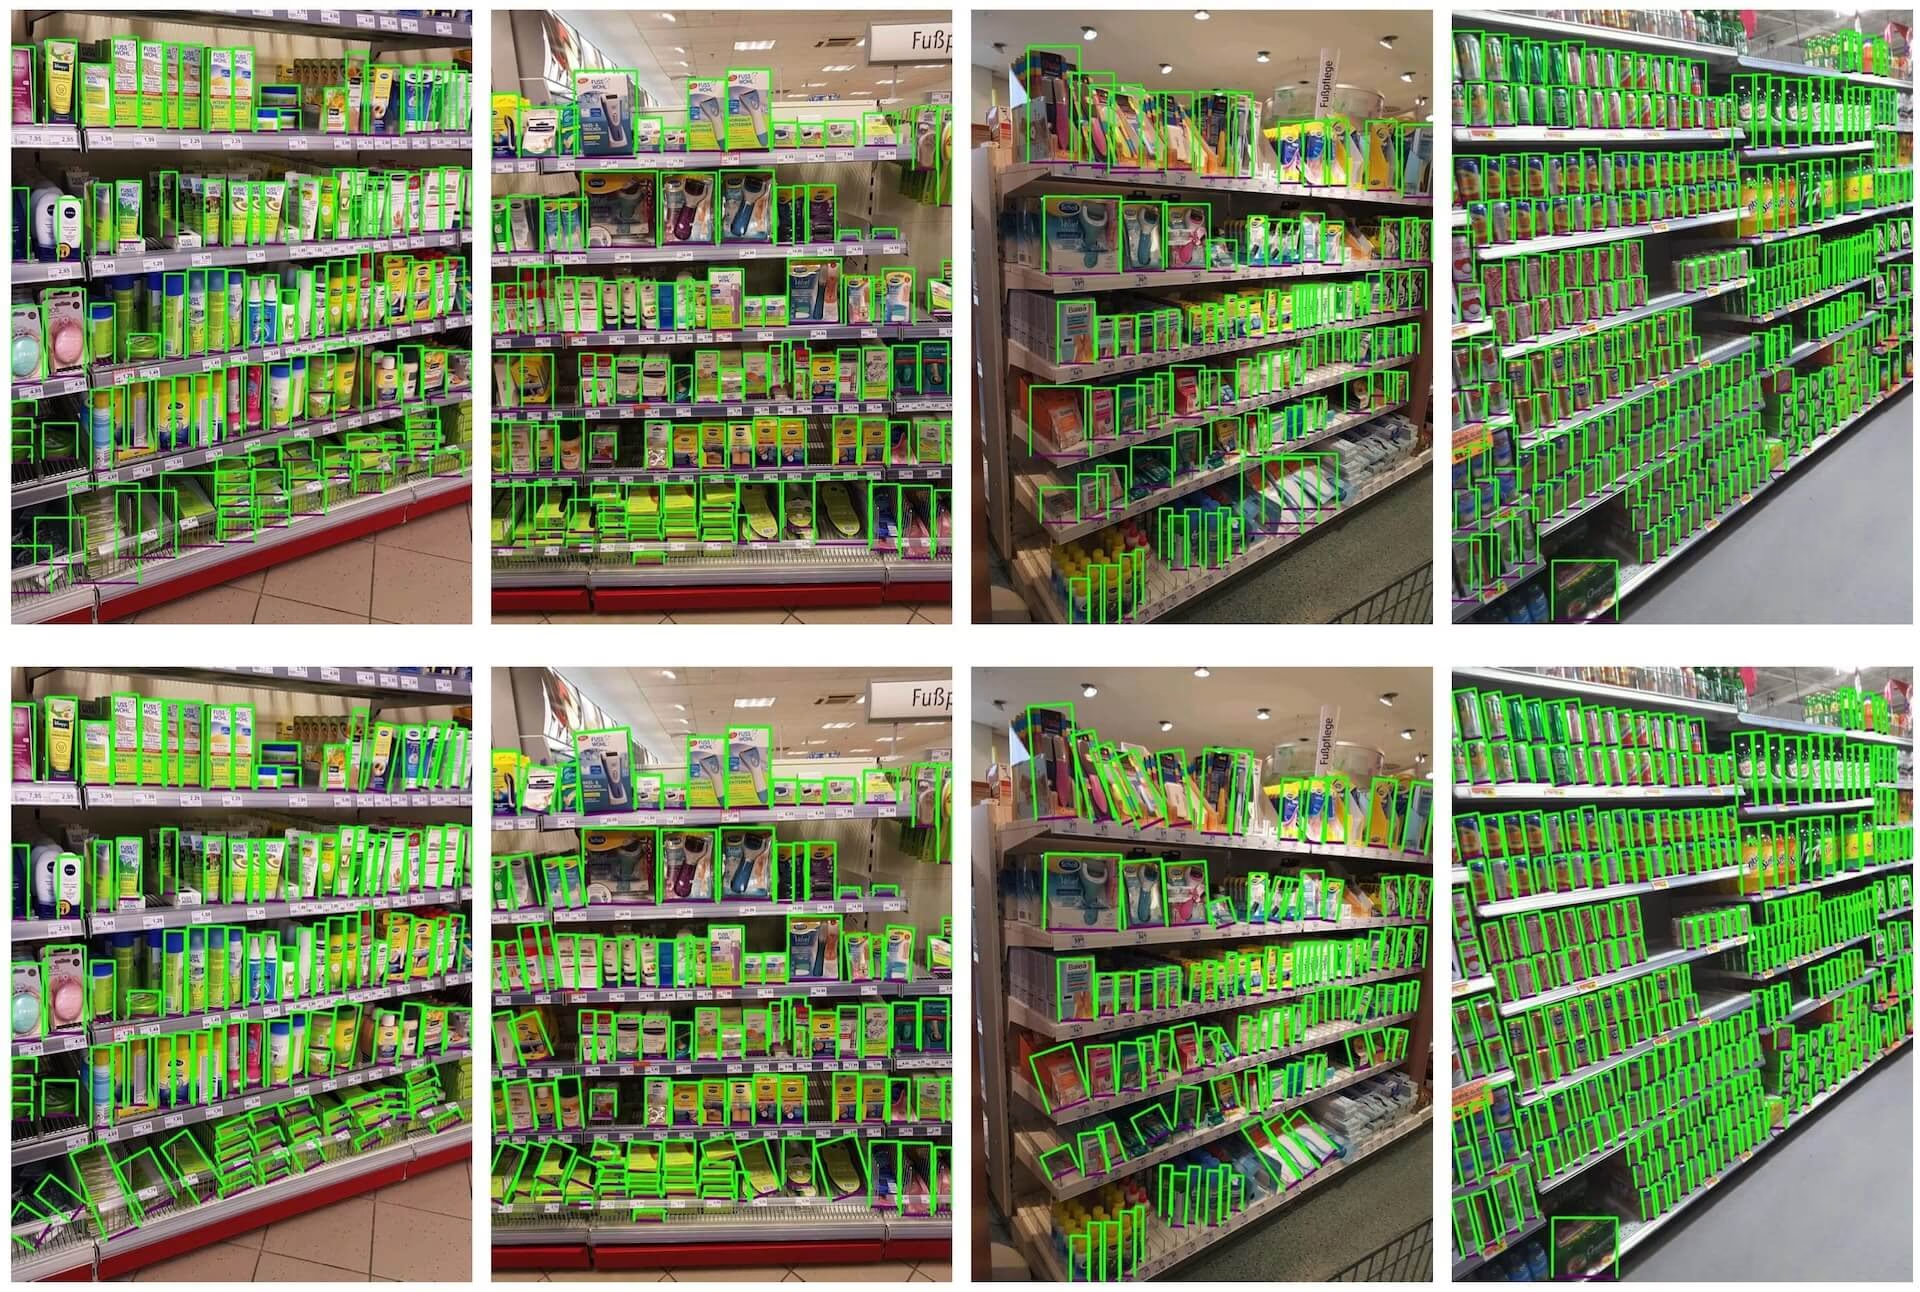
- Bild eines dicht bestückten Verkaufsregals: Das Bild zeigt beispielhaft dicht gepackte Objekte in einem Verkaufsregal. Die Objekte sind mit Bounding Boxes der einzigen Klasse
objectannotiert.
Die dichte Anordnung der Produkte macht den SKU-110K-Datensatz besonders wertvoll für die Entwicklung robuster Computer-Vision-Lösungen für den Einzelhandel, denn die hohe Objektzahl pro Bild stellt Detektoren vor deutlich größere Herausforderungen als typische Benchmarks.
Zitate und Danksagungen#
Wenn du den SKU-110K-Datensatz in deiner Forschungs- oder Entwicklungsarbeit verwendest, zitiere bitte die folgende Arbeit:
@inproceedings{goldman2019dense,
  author    = {Eran Goldman and Roei Herzig and Aviv Eisenschtat and Jacob Goldberger and Tal Hassner},
  title     = {Precise Detection in Densely Packed Scenes},
  booktitle = {Proc. Conf. Comput. Vision Pattern Recognition (CVPR)},
  year      = {2019}
}
Wir möchten Eran Goldman et al. dafür danken, dass sie den SKU-110K-Datensatz als wertvolle Ressource für die Computer-Vision-Forschungsgemeinschaft erstellt haben und pflegen. Weitere Informationen zum SKU-110K-Datensatz und seinen Erstellern findest du im GitHub-Repository des SKU-110K-Datensatzes.
Häufig gestellte Fragen#
Der SKU-110K-Datensatz zur Objekterkennung mit einer Klasse umfasst 11.743 Bilder dicht bestückter Verkaufsregale. Er wurde von Eran Goldman und anderen für ihre CVPR-2019-Studie erstellt. Jedes Produkt ist mit einem Begrenzungsrahmen der Klasse
objectmarkiert. Die Bilder zeigen mehr als 110.000 verschiedene Lagerhaltungseinheiten (SKUs), wodurch der Datensatz ein aussagekräftiger Benchmark für die Erkennung von Objekten in überfüllten Szenen und den Aufbau von Computer-Vision-Systemen für den Einzelhandel ist.Nein. SKU-110K hat nur eine Klasse: Jedes Produkt ist mit einer Bounding Box der Klasse
object(names: {0: object}) annotiert. „110K“ im Namen bezieht sich auf die Anzahl der einzigartigen gelagerten Artikel (SKUs) auf den Bildern und nicht auf die Anzahl der Erkennungsklassen.Der SKU-110K-Datensatz umfasst 11.743 Bilder – 8.219 Trainings-, 588 Validierungs- und 2.936 Testbilder – sowie eine einzige Erkennungsklasse:
object. Einzelheiten findest du im Abschnitt Datensatzstruktur und in der KonfigurationSKU-110K.yaml.Der SKU-110K-Datensatz ist etwa 13.6 GB groß und wird beim ersten Training mit
data="SKU-110K.yaml"automatisch heruntergeladen – ein manueller Download ist nicht erforderlich. Kleinere Alternativen findest du in der Übersicht der Erkennungsdatensätze.Ein YOLO26-Modell mit dem SKU-110K-Datensatz zu trainieren, ist unkompliziert. Hier ein Beispiel, wie du ein YOLO26n-Modell 100 Epochen lang mit einer Bildgröße von 640 trainierst:
Trainingsbeispielfrom ultralytics import YOLO # Ein Modell laden model = YOLO("yolo26n.pt") # ein vortrainiertes Modell laden (für das Training empfohlen) # Das Modell trainieren results = model.train(data="SKU-110K.yaml", epochs=100, imgsz=640)


Kommentare6
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
syafiqmuda
Hi, newbie here, I try to use this dataset to compare and see the accuracy for this dataset with my own, but during training almost all the file were show
Corrupt JPEG data: 786 extraneous bytes before marker 0xd9and sometimesCorrupt JPEG data: premature end of data segment. can I know why? my code look like this:training.py
from ultralytics import YOLO, checks, hub checks() def main(): hub.login('something') model = YOLO('https://hub.ultralytics.com/models/ukr3hHHq88WJASNn3aUz') results = model.train(device=[0,1,2,3]) if __name__ == '__main__': main() Glenn JocherUltralytics
Those messages are PIL JPEG warnings from a handful of non-standard images in SKU-110K; Ultralytics usually auto-recovers/filters these during dataloading via
ultralytics.data.utils.verify_image()(see theverify_image()reference), so if training continues it’s safe to ignore—if it actually crashes, re-download/re-extract the dataset (or re-encode the specific bad JPGs), then delete any*.cacheunder yourlabels/folder and rerun; if you share the text output ofyolo checksplus the full traceback (not a screenshot) we can pinpoint whether it’s data corruption or an environment issue.
ApodiAlsurihi
Hi, thank you for this amazing and detailed explanation! Your work is incredibly helpful and inspiring. I would deeply appreciate it if you could share the trained model after the training process. It would make a significant difference in advancing my project and learning. Thank you so much for your generosity and support!
- Glenn JocherUltralytics
@ApodiAlsurihi thank you for your kind words! Unfortunately, we cannot share trained models directly. However, you can train your own model using the SKU-110K dataset by following the instructions provided in the documentation.
serna01
Are this warnings OK, when training? the batch=0.1 I used it to avoid a memory error. yolo detect train data=SKU-110K.yaml model=yolov8n.pt epochs=50 imgsz=640 batch=0.1
AutoBatch: Using batch-size 2 for CUDA:0 0.49G/3.81G (13%) ✅ train: Scanning /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels... 8216 train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_1797.jpg: 3 duplicate labels removed train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_4222.jpg: ignoring corrupt image/label: image file is truncated (23 bytes not processed) train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_882.jpg: ignoring corrupt image/label: image file is truncated (3 bytes not processed) train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_924.jpg: ignoring corrupt image/label: image file is truncated (10 bytes not processed)
al: Scanning /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels... 588 ima val: New cache created: /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels.cache Corrupt JPEG data: 305 extraneous bytes before marker 0xd9 Corrupt JPEG data: 786 extraneous bytes before marker 0xd9 Plotting labels to runs/detect/train5/labels.jpg... optimizer: 'optimizer=auto' found, ignoring 'lr0=0.01' and 'momentum=0.937' and determining best 'optimizer', 'lr0' and 'momentum' automatically... optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups 57 weight(decay=0.0), 64 weight(decay=0.0005), 63 bias(decay=0.0) TensorBoard: model graph visualization added ✅ Image sizes 640 train, 640 val Using 8 dataloader workers Logging results to runs/detect/train5 Starting training for 50 epochs...
  Epoch    GPU_mem   box_loss   cls_loss   dfl_loss  Instances       Size
   1/50      1.14G      2.504      3.041       1.53        378        640:   5Corrupt JPEG data: premature end of data segment
   1/50      1.15G      2.382      2.658      1.454        331        640:   7Corrupt JPEG data: 562 extraneous bytes before marker 0xd9
   1/50      1.42G      2.273      2.314      1.382        314        640:  11Corrupt JPEG data: bad Huffman code
   1/50      1.42G      2.266      2.295      1.378        578        64       1/50      1.42G      2.266      2.293      1.377        678        64       1/50      1.42G      2.266      2.293      1.377        678        64       1/50      1.42G      2.265      2.292      1.377        723        64       1/50      1.42G      2.265      2.292      1.377        723        64       1/50      1.42G      2.266       2.29      1.377        695        64       1/50      1.42G      2.266          1/50      1.42G      2.255      2.2       1/50      1.42G      2.254      2.247       1.3       1/50      1       1/50              1/50                          1/50      1.42G      2.232      2.187      1.358        608        640:  13Corrupt JPEG data: bad Huffman code
   1/50      1.42G      2.216      2.138      1.347        437        640:  14Corrupt JPEG data: premature end of data segment
   1/50      1.42G      2.164      1.993      1.318        478        640:  17Corrupt JPEG data: 41 extraneous bytes before marker 0xd9
   1/50      1.42G      2.157      1.967      1.312        308        640:  17Corrupt JPEG data: premature end of data segment
   1/50      1.42G      2.011       1.61      1.239        173        640:  30Corrupt JPEG data: premature end of data segment
   1/50      1.42G      1.987      1.556      1.227        461        640:  33Corrupt JPEG data: 96 extraneous bytes before marker 0xd9
   1/50      1.42G      1.978      1.537      1.223        214        640:  34Corrupt JPEG data: bad Huffman code
   1/50      1.42G      1.959      1.497      1.215        250        640:  37Corrupt JPEG data: bad Huffman code
   1/50      1.42G      1.915      1.403      1.197        500        640:  46Corrupt JPEG data: premature end of data segment
   1/50      1.42G      1.888      1.345      1.185        616        640:  52Corrupt JPEG data: premature end of data segment
Thanks.
- Glenn JocherUltralytics
@serna01 the warnings you see are generally okay and indicate that the training process is handling issues like duplicate labels and corrupt images. Using
batch=0.1to avoid memory errors is fine, but consider adjusting your batch size to better utilize your GPU memory. If the warnings persist or cause issues, ensure you're using the latest version of the package. For more details on the SKU-110k dataset, visit SKU-110k Dataset Documentation.