Conjunto de datos Roboflow 100#
Roboflow 100, patrocinado por Intel, es un innovador conjunto de datos de referencia para la detección de objetos. Incluye 100 conjuntos de datos diversos. Este benchmark está diseñado específicamente para poner a prueba la adaptabilidad de los modelos de visión artificial, como los modelos Ultralytics YOLO, en distintos ámbitos, como la sanidad, las imágenes aéreas y los videojuegos.
Características principales#
- Diversidad de ámbitos: incluye 100 conjuntos de datos de siete ámbitos distintos: aéreo, videojuegos, microscópico, submarino, documentos, electromagnético y mundo real.
- Escala: el benchmark consta de 224.714 imágenes distribuidas en 805 clases y representa más de 11.170 horas de trabajo de etiquetado de datos.
- Estandarización: todas las imágenes están preprocesadas y redimensionadas a 640x640 píxeles para garantizar una evaluación coherente.
- Evaluación depurada: se centra en eliminar la ambigüedad entre clases y filtra las clases con poca representación para garantizar una evaluación del modelo más rigurosa.
- Anotaciones: incluye cuadros delimitadores para los objetos, adecuados para el entrenamiento y la evaluación de modelos de detección de objetos con métricas como mAP.
Estructura del conjunto de datos#
El conjunto de datos Roboflow 100 está organizado en siete categorías, cada una con una colección única de conjuntos de datos, imágenes y clases:
- Aéreo: 7 conjuntos de datos, 9.683 imágenes, 24 clases.
- Videojuegos: 7 conjuntos de datos, 11.579 imágenes, 88 clases.
- Microscópico: 11 conjuntos de datos, 13.378 imágenes, 28 clases.
- Submarino: 5 conjuntos de datos, 18.003 imágenes, 39 clases.
- Documentos: 8 conjuntos de datos, 24.813 imágenes, 90 clases.
- Electromagnético: 12 conjuntos de datos, 36.381 imágenes, 41 clases.
- Mundo real: 50 conjuntos de datos, 110.615 imágenes, 495 clases.
Esta estructura proporciona un entorno de prueba diverso y amplio para modelos de detección de objetos que refleja una gran variedad de situaciones de aplicación reales presentes en distintas soluciones de Ultralytics.
Evaluación comparativa#
La evaluación comparativa de conjuntos de datos consiste en evaluar el rendimiento de modelos de aprendizaje automático en conjuntos de datos específicos mediante métricas estandarizadas. Entre las métricas habituales se encuentran la precisión, la precisión media (mAP) y la puntuación F1. Puedes obtener más información en nuestra guía de métricas de rendimiento de YOLO.
Todos los resultados se agrupan en un único directorio runs/<task>/multitrain/: cada conjunto de datos se ajusta en su propio subdirectorio (con su propio results.png), y las métricas de cada conjunto y las medias se escriben en multitrain_results.json, junto con un gráfico de barras multitrain_results.png. La llamada a model.train() también devuelve un diccionario {dataset: metrics} para acceder a los resultados mediante programación.
El siguiente script descarga de Roboflow los conjuntos de datos de Roboflow 100 incluidos en datasets_links.txt y después ajusta un único modelo base (por ejemplo, YOLO26n) en toda la colección con una sola llamada a model.train(). Al pasar una lista de conjuntos de datos, el modelo base se ajusta en cada uno por orden y se visualizan automáticamente los resultados entre conjuntos de datos.
import re
from pathlib import Path

from roboflow import Roboflow

from ultralytics import YOLO
from ultralytics.utils import ASSETS_URL, LOGGER, YAML
from ultralytics.utils.downloads import safe_download

# Download the RF100 datasets (requires a Roboflow API key)
rf = Roboflow(api_key="YOUR_ROBOFLOW_API_KEY")
safe_download(f"{ASSETS_URL}/datasets_links.txt")  # list of RF100 dataset links

datasets = []
for line in Path("datasets_links.txt").read_text().splitlines():
    try:
        _, _url, workspace, project, version = re.split("/+", line.strip())
        location = f"rf-100/{project}-{version}"
        rf.workspace(workspace).project(project).version(version).download("yolov8", location=location)
        yaml = Path(location) / "data.yaml"
        cfg = YAML.load(yaml)  # point train/val at the downloaded image folders
        cfg["train"], cfg["val"] = "train/images", "valid/images"
        YAML.save(yaml, cfg)
        datasets.append(str(yaml))
    except Exception as e:
        LOGGER.warning(f"Failed to prepare dataset from {line!r}: {e}")

# Fine-tune one base model across all RF100 datasets and visualize the cross-dataset results
model = YOLO("yolo26n.pt")
results = model.train(data=datasets, epochs=100, imgsz=640)  # {dataset: metrics}

# Per-dataset runs, multitrain_results.json (per-dataset + mean), and multitrain_results.png are saved
# together under runs/detect/multitrain. Read results in-memory or from the JSON for custom post-processing.
for dataset, metrics in results.items():
    if metrics:  # None if that dataset failed to train
print(f"{dataset}: mAP50-95 = {metrics['metrics/mAP50-95(B)']:.4f}")Aplicaciones#
Roboflow 100 es muy útil para distintas aplicaciones relacionadas con la visión artificial y el aprendizaje profundo. Investigadores e ingenieros pueden aprovechar este benchmark para:
- Evaluar el rendimiento de modelos de detección de objetos en un contexto multidominio.
- Probar la adaptabilidad y la robustez de los modelos en situaciones reales, más allá de los conjuntos de datos de referencia habituales como COCO o PASCAL VOC.
- Evaluar las capacidades de los modelos de detección de objetos en diversos conjuntos de datos, incluidos ámbitos especializados como la sanidad, las imágenes aéreas y los videojuegos.
- Comparar el rendimiento de los modelos con distintas arquitecturas de redes neuronales y técnicas de optimización.
- Identificar desafíos específicos de cada ámbito que puedan requerir consejos especializados para entrenar modelos o métodos de ajuste fino, como el aprendizaje por transferencia.
Para encontrar más ideas e inspiración sobre aplicaciones reales, explora nuestras guías de proyectos prácticos o descubre Ultralytics Platform para agilizar el entrenamiento de modelos y su despliegue.
Uso#
El conjunto de datos Roboflow 100, incluidos sus metadatos y enlaces de descarga, está disponible en el repositorio oficial de Roboflow 100 en GitHub. Puedes acceder al conjunto de datos y utilizarlo directamente desde allí para tus evaluaciones comparativas. Una vez descargados y preparados los conjuntos de datos como se indica arriba, puedes ajustar los modelos de Ultralytics en toda la colección con una sola llamada a model.train(), pasando la lista de archivos YAML de los conjuntos de datos.
Datos de ejemplo y anotaciones#
Roboflow 100 consta de conjuntos de datos con imágenes diversas, capturadas desde distintos ángulos y en diferentes ámbitos. A continuación se muestran ejemplos de imágenes anotadas incluidas en el benchmark RF100, que ilustran la variedad de objetos y escenas. Técnicas como el aumento de datos pueden ampliar aún más la diversidad durante el entrenamiento.
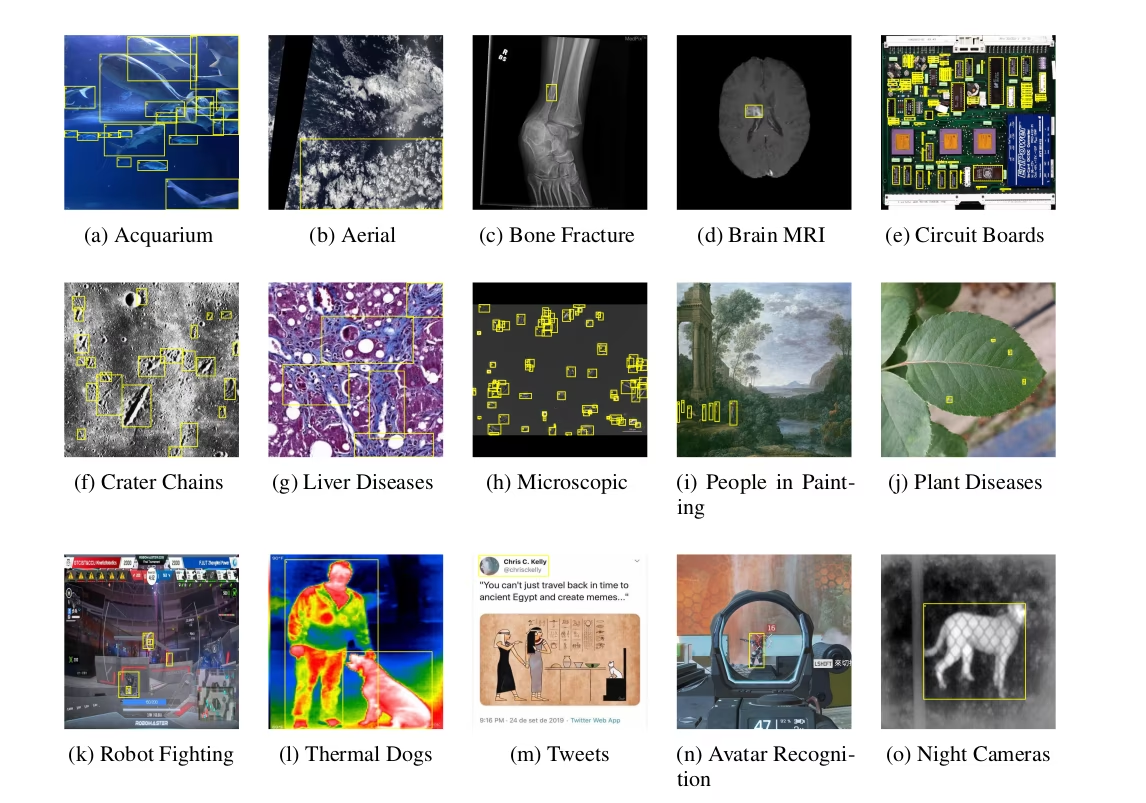
La diversidad del benchmark Roboflow 100 supone un avance importante respecto a los benchmarks tradicionales, que suelen centrarse en optimizar una sola métrica dentro de un ámbito limitado. Este enfoque integral ayuda a desarrollar modelos de visión artificial más robustos y versátiles, capaces de rendir bien en una gran variedad de situaciones.
Citas y agradecimientos#
Si utilizas el conjunto de datos Roboflow 100 en tus trabajos de investigación o desarrollo, cita el artículo original:
@misc{rf100benchmark,
    Author = {Floriana Ciaglia and Francesco Saverio Zuppichini and Paul Guerrie and Mark McQuade and Jacob Solawetz},
    Title = {Roboflow 100: A Rich, Multi-Domain Object Detection Benchmark},
    Year = {2022},
    Eprint = {arXiv:2211.13523},
    url = {https://arxiv.org/abs/2211.13523}
}
Agradecemos al equipo de Roboflow y a todas las personas colaboradoras sus importantes esfuerzos para crear y mantener el conjunto de datos Roboflow 100 como un recurso valioso para la comunidad de visión artificial.
Si te interesa explorar más conjuntos de datos para potenciar tus proyectos de detección de objetos y aprendizaje automático, visita nuestra colección completa de conjuntos de datos, que incluye otros conjuntos de datos de detección.
Preguntas frecuentes#
El conjunto de datos Roboflow 100 es un benchmark para modelos de detección de objetos. Consta de 100 conjuntos de datos diversos que abarcan ámbitos como la sanidad, las imágenes aéreas y los videojuegos. Su importancia radica en que ofrece una forma estandarizada de probar la adaptabilidad y la robustez de los modelos en una amplia variedad de situaciones reales, superando las limitaciones de ámbito habituales en los benchmarks tradicionales.
El conjunto de datos Roboflow 100 abarca siete ámbitos diversos que plantean desafíos específicos a los modelos de detección de objetos:
- Aéreo: 7 conjuntos de datos (por ejemplo, imágenes por satélite y vistas desde drones).
- Videojuegos: 7 conjuntos de datos (por ejemplo, objetos de distintos entornos de juego).
- Microscópico: 11 conjuntos de datos (por ejemplo, células y partículas).
- Submarino: 5 conjuntos de datos (por ejemplo, vida marina y objetos sumergidos).
- Documentos: 8 conjuntos de datos (por ejemplo, regiones de texto y elementos de formularios).
- Electromagnético: 12 conjuntos de datos (por ejemplo, firmas de radar y visualizaciones de datos espectrales).
- Mundo real: 50 conjuntos de datos (una categoría amplia que incluye objetos cotidianos, escenas, comercio minorista, etc.).
Esta variedad convierte RF100 en un excelente recurso para evaluar la capacidad de generalización de los modelos de visión artificial.
Al utilizar el conjunto de datos Roboflow 100, cita el artículo original para reconocer a sus creadores. Esta es la cita BibTeX recomendada:
Cita@misc{rf100benchmark, Author = {Floriana Ciaglia and Francesco Saverio Zuppichini and Paul Guerrie and Mark McQuade and Jacob Solawetz}, Title = {Roboflow 100: A Rich, Multi-Domain Object Detection Benchmark}, Year = {2022}, Eprint = {arXiv:2211.13523}, url = {https://arxiv.org/abs/2211.13523} }Para seguir explorando, visita nuestra colección completa de conjuntos de datos o consulta otros conjuntos de datos de detección compatibles con los modelos de Ultralytics.