Dataset COCO-Seg#
El dataset COCO-Seg proporciona máscaras de segmentación de instancias de COCO (objetos comunes en contexto): 118.287 imágenes de entrenamiento y 5.000 de validación con máscaras poligonales de 80 categorías de objetos, en el formato de etiquetas de Ultralytics YOLO. Utiliza las imágenes originales y las anotaciones de segmentación nativas de COCO, convertidas para el entrenamiento de YOLO, lo que lo convierte en un recurso esencial para investigadores y desarrolladores que trabajan en tareas de segmentación de instancias.
Modelos preentrenados de COCO-Seg#
| Modelo | tamaño (píxeles) | mAPcaja 50-95(e2e) | mAPmáscara 50-95(e2e) | Velocidad CPU ONNX (ms) | Velocidad T4 TensorRT10 (ms) | parámetros (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|
| YOLO26n-seg | 640 | 39.6 | 33.9 | 53.3 ± 0.5 | 2.1 ± 0.0 | 2.7 | 9.3 |
| YOLO26s-seg | 640 | 47.3 | 40.0 | 118.4 ± 0.9 | 3.3 ± 0.0 | 10.4 | 34.5 |
| YOLO26m-seg | 640 | 52.5 | 44.1 | 328.2 ± 2.4 | 6.7 ± 0.1 | 23.6 | 121.7 |
| YOLO26l-seg | 640 | 54.4 | 45.5 | 387.0 ± 3.7 | 8.0 ± 0.1 | 28.0 | 140.1 |
| YOLO26x-seg | 640 | 56.5 | 47.0 | 787.0 ± 6.8 | 16.4 ± 0.1 | 62.8 | 314.0 |
Características principales#
- COCO-Seg proporciona máscaras de segmentación de instancias para 123.287 imágenes etiquetadas de COCO train2017/val2017 (118.287 de entrenamiento + 5.000 de validación), de las aproximadamente ~330.000 imágenes de la distribución más amplia de COCO.
- El dataset consta de las mismas 80 categorías de objetos que se encuentran en el dataset COCO original.
- Las anotaciones proporcionan máscaras de segmentación de instancias en el formato de etiquetas poligonales de YOLO.
- COCO-Seg proporciona métricas mAP y mAR estandarizadas para evaluar el rendimiento de la segmentación de instancias, lo que permite comparar eficazmente el rendimiento de los modelos.
- Tamaño de descarga: ~20,3 GB en el primer uso (
train2017.zip+val2017.zip+ etiquetas). El archivo de 7 GBtest2017.zipno se descarga automáticamente, ya que esas imágenes tienen la verdad fundamental retenida y solo se necesitan para un envío a test-dev2017.
Estructura del dataset#
El dataset COCO-Seg está dividido en tres subconjuntos:
- Train2017: 118.287 imágenes para entrenar modelos de segmentación de instancias.
- Val2017: 5.000 imágenes utilizadas para la validación durante el desarrollo del modelo.
- Test-dev2017: 20.288 de las 40.670 imágenes de test2017, utilizadas para la evaluación comparativa. Las anotaciones de verdad fundamental de este subconjunto no están disponibles públicamente, por lo que debes enviar las predicciones al servidor de evaluación de COCO para obtener la puntuación.
Para necesidades de experimentación más pequeñas, consulta los subconjuntos COCO128-Seg (128 imágenes) y COCO8-Seg (8 imágenes).
Aplicaciones#
COCO-Seg se utiliza ampliamente para entrenar y evaluar modelos de aprendizaje profundo en tareas de segmentación de instancias, como los modelos YOLO. El gran número de imágenes anotadas, la diversidad de categorías de objetos y las métricas de evaluación estandarizadas lo convierten en un recurso indispensable para investigadores y profesionales de la visión por ordenador. Las anotaciones completas de COCO-Seg también se pueden explorar y gestionar en Ultralytics Platform.
YAML del dataset#
Se utiliza un archivo YAML para definir la configuración del dataset. Contiene información sobre las rutas del dataset, las clases y otros datos relevantes. En el caso del dataset COCO-Seg, el archivo coco.yaml se mantiene en https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO 2017 dataset https://cocodataset.org by Microsoft
# Documentation: https://docs.ultralytics.com/datasets/detect/coco
# Example usage: yolo train data=coco.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco ← downloads here (20.3 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco # dataset root dir
train: train2017.txt # train images (relative to 'path') 118287 images
val: val2017.txt # val images (relative to 'path') 5000 images
test: test-dev2017.txt # 20288 of 40670 images, submit via https://cocodataset.org/#detection-eval

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: |
  from pathlib import Path

  from ultralytics.utils import ASSETS_URL
  from ultralytics.utils.downloads import download

  # Download labels
  segments = True  # segment or box labels
  dir = Path(yaml["path"])  # dataset root dir
  urls = [ASSETS_URL + ("/coco2017labels-segments.zip" if segments else "/coco2017labels.zip")]  # labels
  download(urls, dir=dir.parent)

  # Download data (test2017.zip excluded: ground truth is withheld, only used for the eval-server test-dev split)
  urls = [
      "http://images.cocodataset.org/zips/train2017.zip",  # 19G, 118k images
      "http://images.cocodataset.org/zips/val2017.zip",  # 1G, 5k images
  ]
download(urls, dir=dir / "images", threads=3)Uso#
Para entrenar un modelo YOLO26n-seg en el dataset COCO-Seg durante 100 épocas con un tamaño de imagen de 640, puedes utilizar los siguientes fragmentos de código. Para consultar una lista completa de los argumentos disponibles, visita la página de entrenamiento del modelo.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-seg.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="coco.yaml", epochs=100, imgsz=640)
Imágenes de ejemplo y anotaciones#
COCO-Seg contiene las mismas imágenes diversas, categorías de objetos y escenas complejas que COCO, con máscaras de segmentación de instancias proporcionadas en el formato de etiquetas de YOLO. Estos son algunos ejemplos de imágenes del dataset, junto con sus correspondientes máscaras de segmentación de instancias:
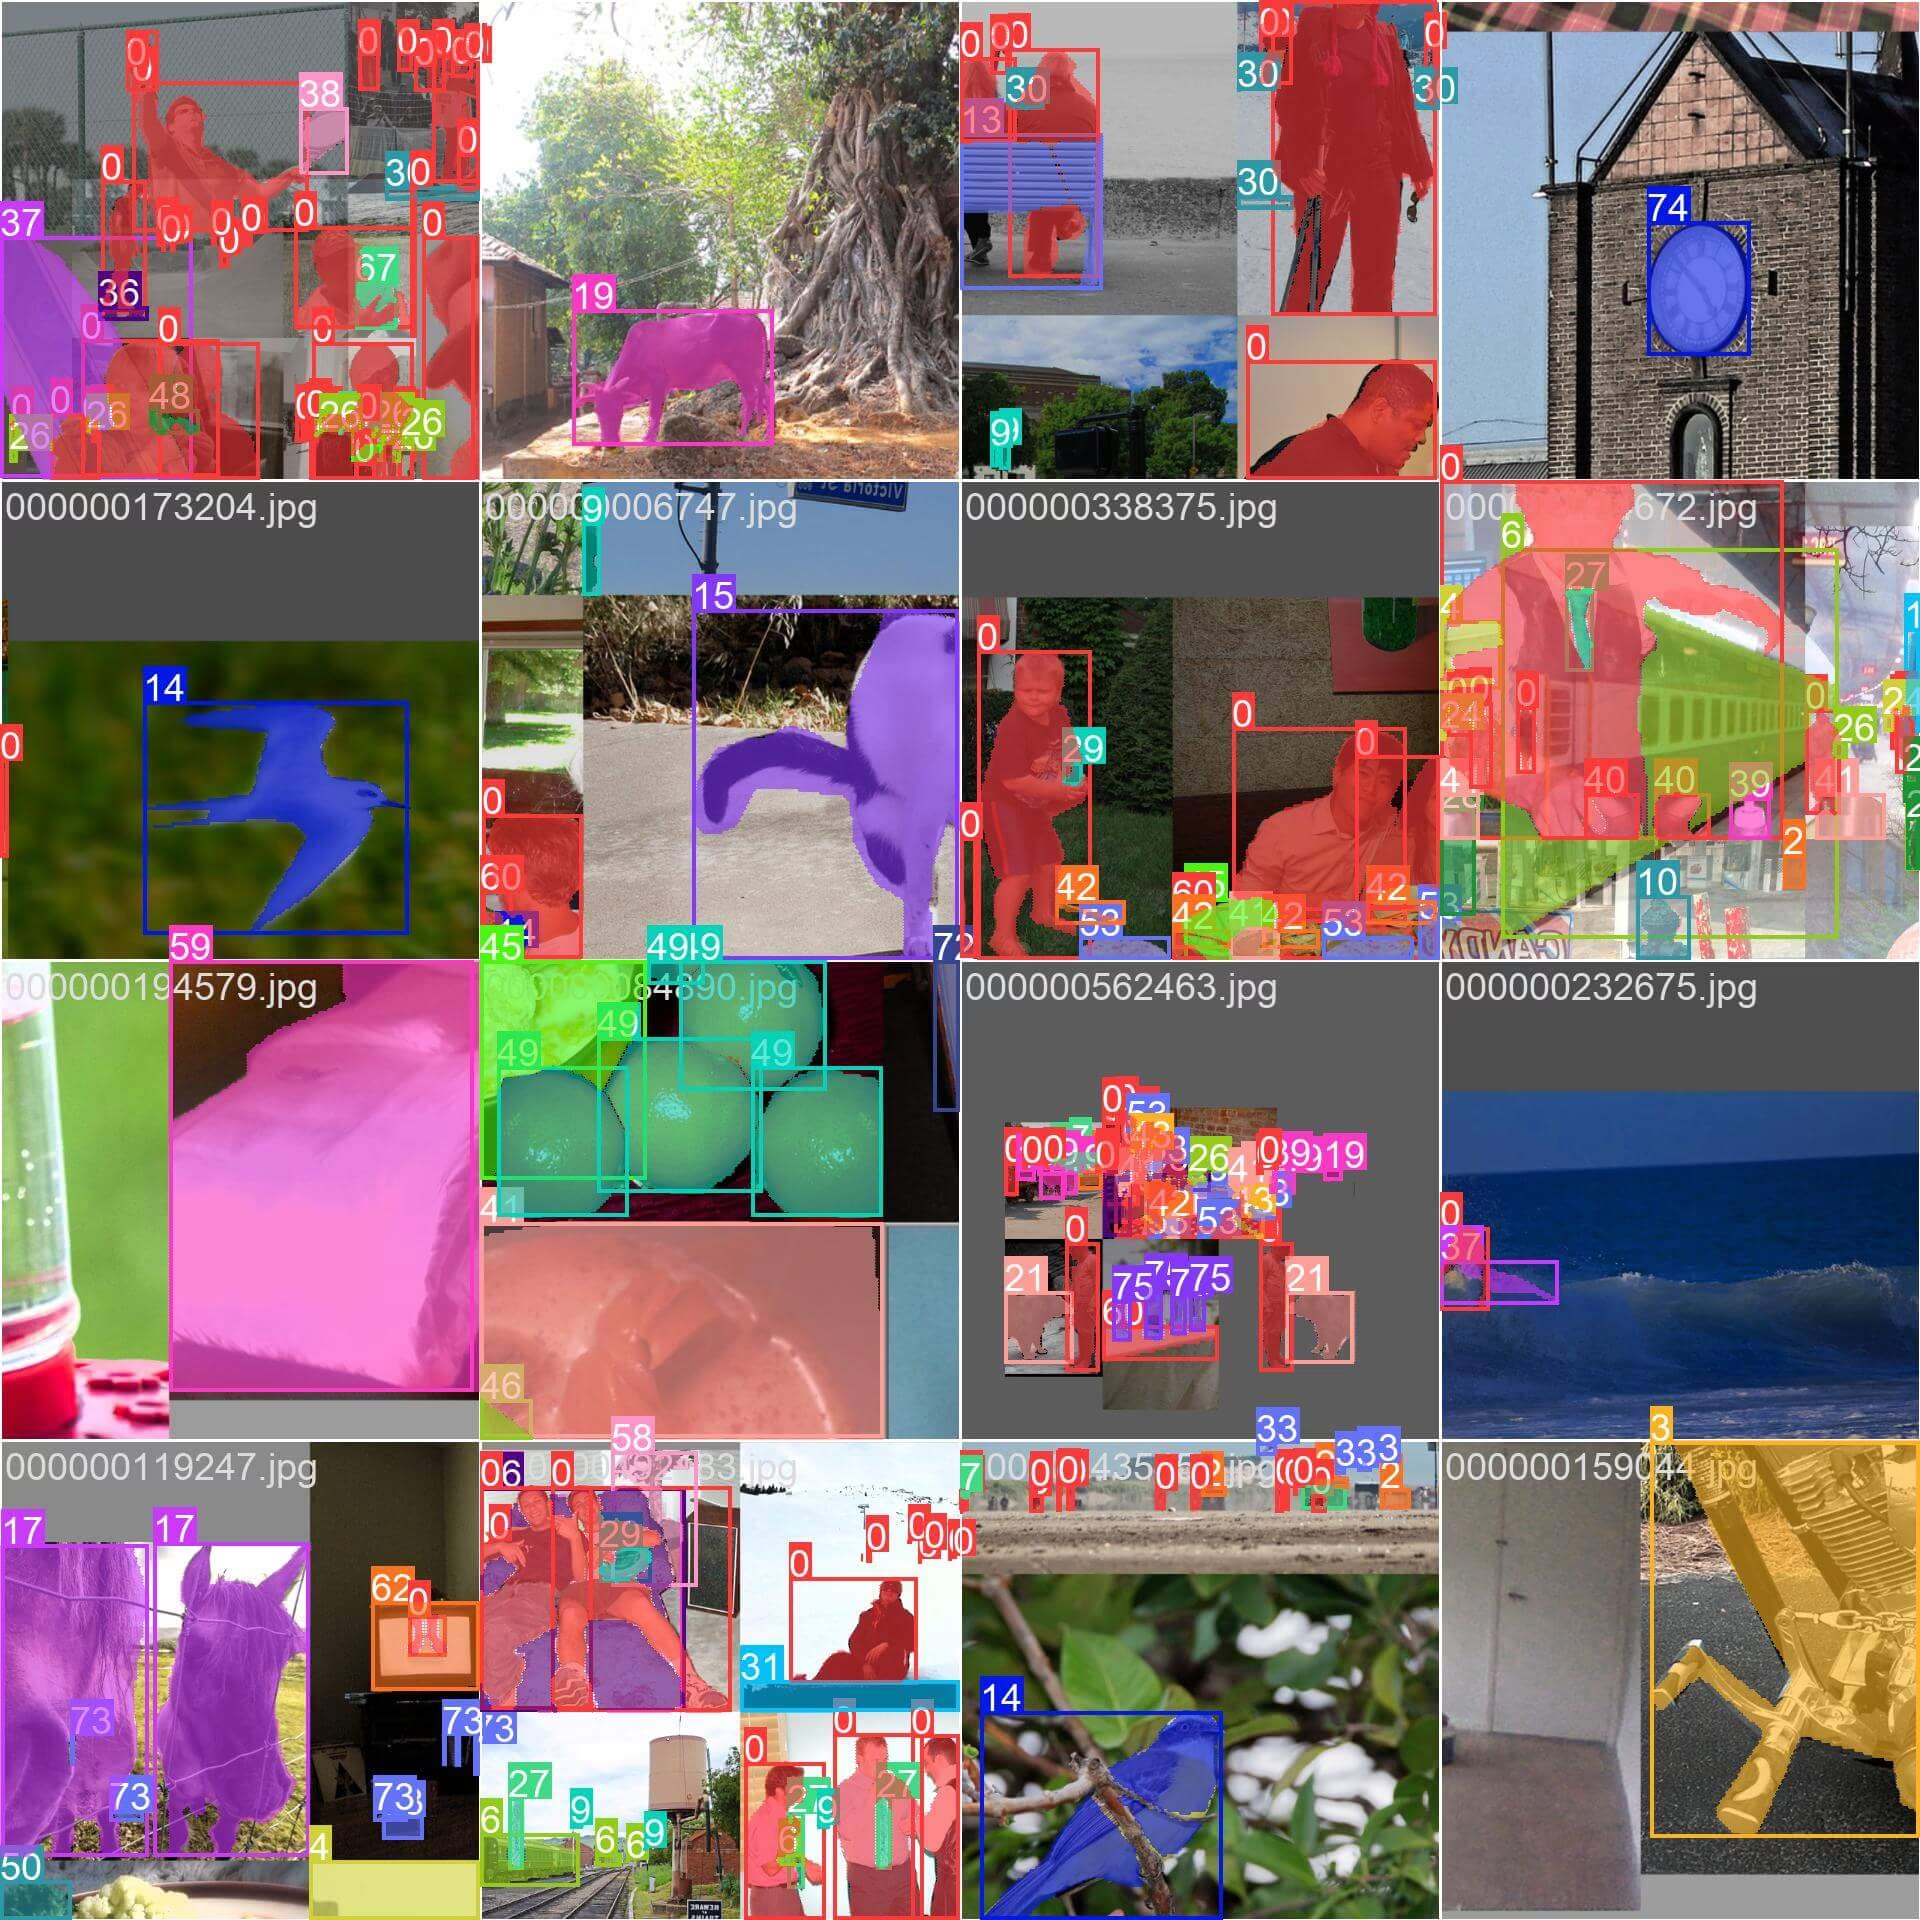
- Imagen con mosaico: Esta imagen muestra un lote de entrenamiento compuesto por imágenes del dataset combinadas en un mosaico. El mosaico es una técnica utilizada durante el entrenamiento que combina varias imágenes en una sola para aumentar la variedad de objetos y escenas de cada lote de entrenamiento. Esto ayuda al modelo a generalizar a distintos tamaños de objetos, relaciones de aspecto y contextos.
Citas y agradecimientos#
Si utilizas el dataset COCO-Seg en tus trabajos de investigación o desarrollo, cita el artículo original de COCO y reconoce la ampliación a COCO-Seg:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Agradecemos enormemente al Consorcio COCO la creación y el mantenimiento de este recurso tan valioso para la comunidad de visión por ordenador. Para obtener más información sobre el dataset COCO y sus creadores, visita el sitio web del dataset COCO.
Preguntas frecuentes#
COCO-Seg es el empaquetado en formato Ultralytics YOLO de las máscaras nativas de segmentación de instancias de COCO (objetos comunes en contexto) para las mismas 118.287 imágenes de train2017 y 5.000 de val2017. Las anotaciones originales de COCO ya incluyen estas máscaras poligonales para las 80 categorías de objetos; COCO-Seg las convierte al formato de etiquetas de YOLO utilizado para el entrenamiento de segmentación de instancias de objetos.
Para entrenar un modelo YOLO26n-seg en el dataset COCO-Seg durante 100 épocas con un tamaño de imagen de 640, puedes utilizar los siguientes fragmentos de código. Para consultar una lista detallada de los argumentos de entrenamiento disponibles, visita la página de entrenamiento del modelo.
Ejemplo de entrenamientofrom ultralytics import YOLO # Load a model model = YOLO("yolo26n-seg.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="coco.yaml", epochs=100, imgsz=640)El dataset COCO-Seg incluye varias características principales:
- Proporciona máscaras de segmentación de instancias para 123.287 imágenes etiquetadas de COCO train2017/val2017 (118.287 de entrenamiento + 5.000 de validación).
- Anota las mismas 80 categorías de objetos que se encuentran en el COCO original.
- Proporciona máscaras de segmentación de instancias en el formato de etiquetas poligonales de YOLO.
- Utiliza métricas de evaluación estandarizadas, como la precisión media Average (mAP) y el recall medio Average (mAR), para tareas de segmentación de instancias.
El dataset COCO-Seg es compatible con varios modelos de segmentación YOLO26 preentrenados, con distintas métricas de rendimiento. Este es un resumen de los modelos disponibles y sus métricas principales:
Modelo tamaño
(píxeles)mAPcaja
50-95(e2e)mAPmáscara
50-95(e2e)Velocidad
CPU ONNX
(ms)Velocidad
T4 TensorRT10
(ms)parámetros
(M)FLOPs
(B)YOLO26n-seg 640 39.6 33.9 53.3 ± 0.5 2.1 ± 0.0 2.7 9.3 YOLO26s-seg 640 47.3 40.0 118.4 ± 0.9 3.3 ± 0.0 10.4 34.5 YOLO26m-seg 640 52.5 44.1 328.2 ± 2.4 6.7 ± 0.1 23.6 121.7 YOLO26l-seg 640 54.4 45.5 387.0 ± 3.7 8.0 ± 0.1 28.0 140.1 YOLO26x-seg 640 56.5 47.0 787.0 ± 6.8 16.4 ± 0.1 62.8 314.0 Estos modelos van desde el ligero YOLO26n-seg hasta el más potente YOLO26x-seg, y ofrecen distintos compromisos entre velocidad y precisión para adaptarse a diversos requisitos de las aplicaciones. Para obtener más información sobre la selección de modelos, visita la página de modelos de Ultralytics.
El dataset COCO-Seg está dividido en tres subconjuntos para necesidades específicas de entrenamiento y evaluación:
- Train2017: Contiene 118.287 imágenes utilizadas principalmente para entrenar modelos de segmentación de instancias.
- Val2017: Consta de 5.000 imágenes utilizadas para la validación durante el proceso de entrenamiento.
- Test-dev2017: Incluye 20.288 de las 40.670 imágenes de test2017 reservadas para probar y evaluar comparativamente los modelos entrenados. Ten en cuenta que las anotaciones de verdad fundamental de este subconjunto no están disponibles públicamente y que los resultados de rendimiento se envían al servidor de evaluación de COCO para su evaluación.
Para necesidades de experimentación más pequeñas, también puedes considerar el dataset COCO128-Seg (128 imágenes) o el dataset COCO8-Seg, una versión compacta que contiene solo 8 imágenes del conjunto train 2017 de COCO.