Guía de inicio rápido: Seeed Studio reCamera con Ultralytics YOLO26
reCamera se presentó a la comunidad de IA en YOLO Vision 2024 (YV24), el evento híbrido anual de Ultralytics. Está diseñada principalmente para aplicaciones de IA en el perímetro, con procesamiento de IA en el dispositivo y un despliegue sencillo.
Gracias a su compatibilidad con diversas configuraciones de hardware y recursos de código abierto, es una opción muy adecuada para crear prototipos y desplegar soluciones de visión artificial en el perímetro.
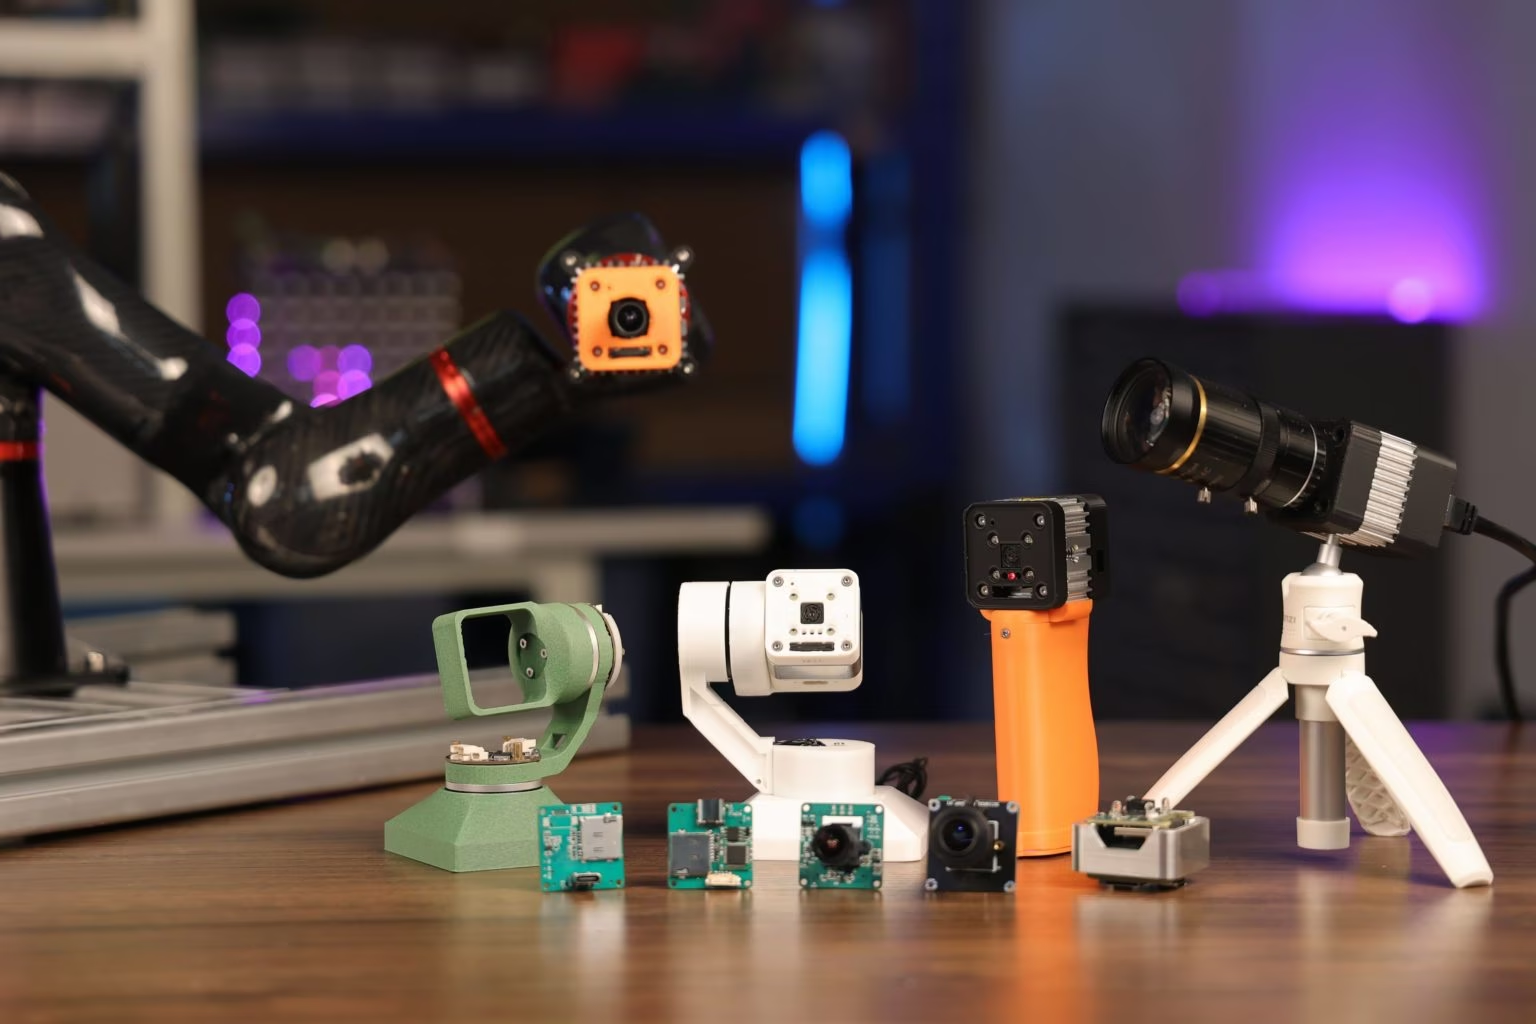
¿Por qué elegir reCamera?#
La serie reCamera está diseñada específicamente para aplicaciones de IA en el perímetro y adaptada a las necesidades de los desarrolladores. Entre sus características principales se incluyen:
-
Rendimiento con RISC-V: su núcleo es el procesador SG200X, basado en la arquitectura RISC-V, que ofrece un rendimiento eficiente para tareas de IA en el perímetro. Con capacidad para ejecutar 1 billón de operaciones por segundo (1 TOPS), puede realizar tareas como la detección de objetos en tiempo real.
-
Tecnologías de vídeo optimizadas: admite estándares avanzados de compresión de vídeo, como H.264 y H.265, para reducir las necesidades de almacenamiento y ancho de banda sin sacrificar la calidad. Funciones como la imagen HDR, la reducción de ruido 3D y la corrección de lente mantienen la calidad de imagen incluso en entornos difíciles.
-
Procesamiento dual de bajo consumo: mientras el SG200X se encarga de las tareas complejas de IA, un microcontrolador más pequeño de 8 bits gestiona las operaciones sencillas para ahorrar energía. Esto convierte a reCamera en una opción ideal para configuraciones alimentadas por batería o de bajo consumo.
-
Diseño modular y actualizable: reCamera está construido con una estructura modular compuesta por tres componentes principales: la placa principal, la placa del sensor y la placa base. Este diseño permite a los desarrolladores sustituir o actualizar componentes a medida que evolucionan los proyectos.
Configuración rápida del hardware de reCamera#
Sigue la página Introducción a reCamera y selecciona tu dispositivo (como reCamera 2002 Series, Gimbal o HQ POE) para abrir su guía de inicio rápido y realizar la configuración inicial, por ejemplo, conectar el dispositivo a una red y acceder a la interfaz web de Node-RED para previsualizar rápidamente los resultados de detección.
Inferencia con modelos YOLO preinstalados#
reCamera viene con cuatro modelos de Ultralytics YOLO preinstalados, y puedes elegir el modelo que quieras en el panel de Node-RED.
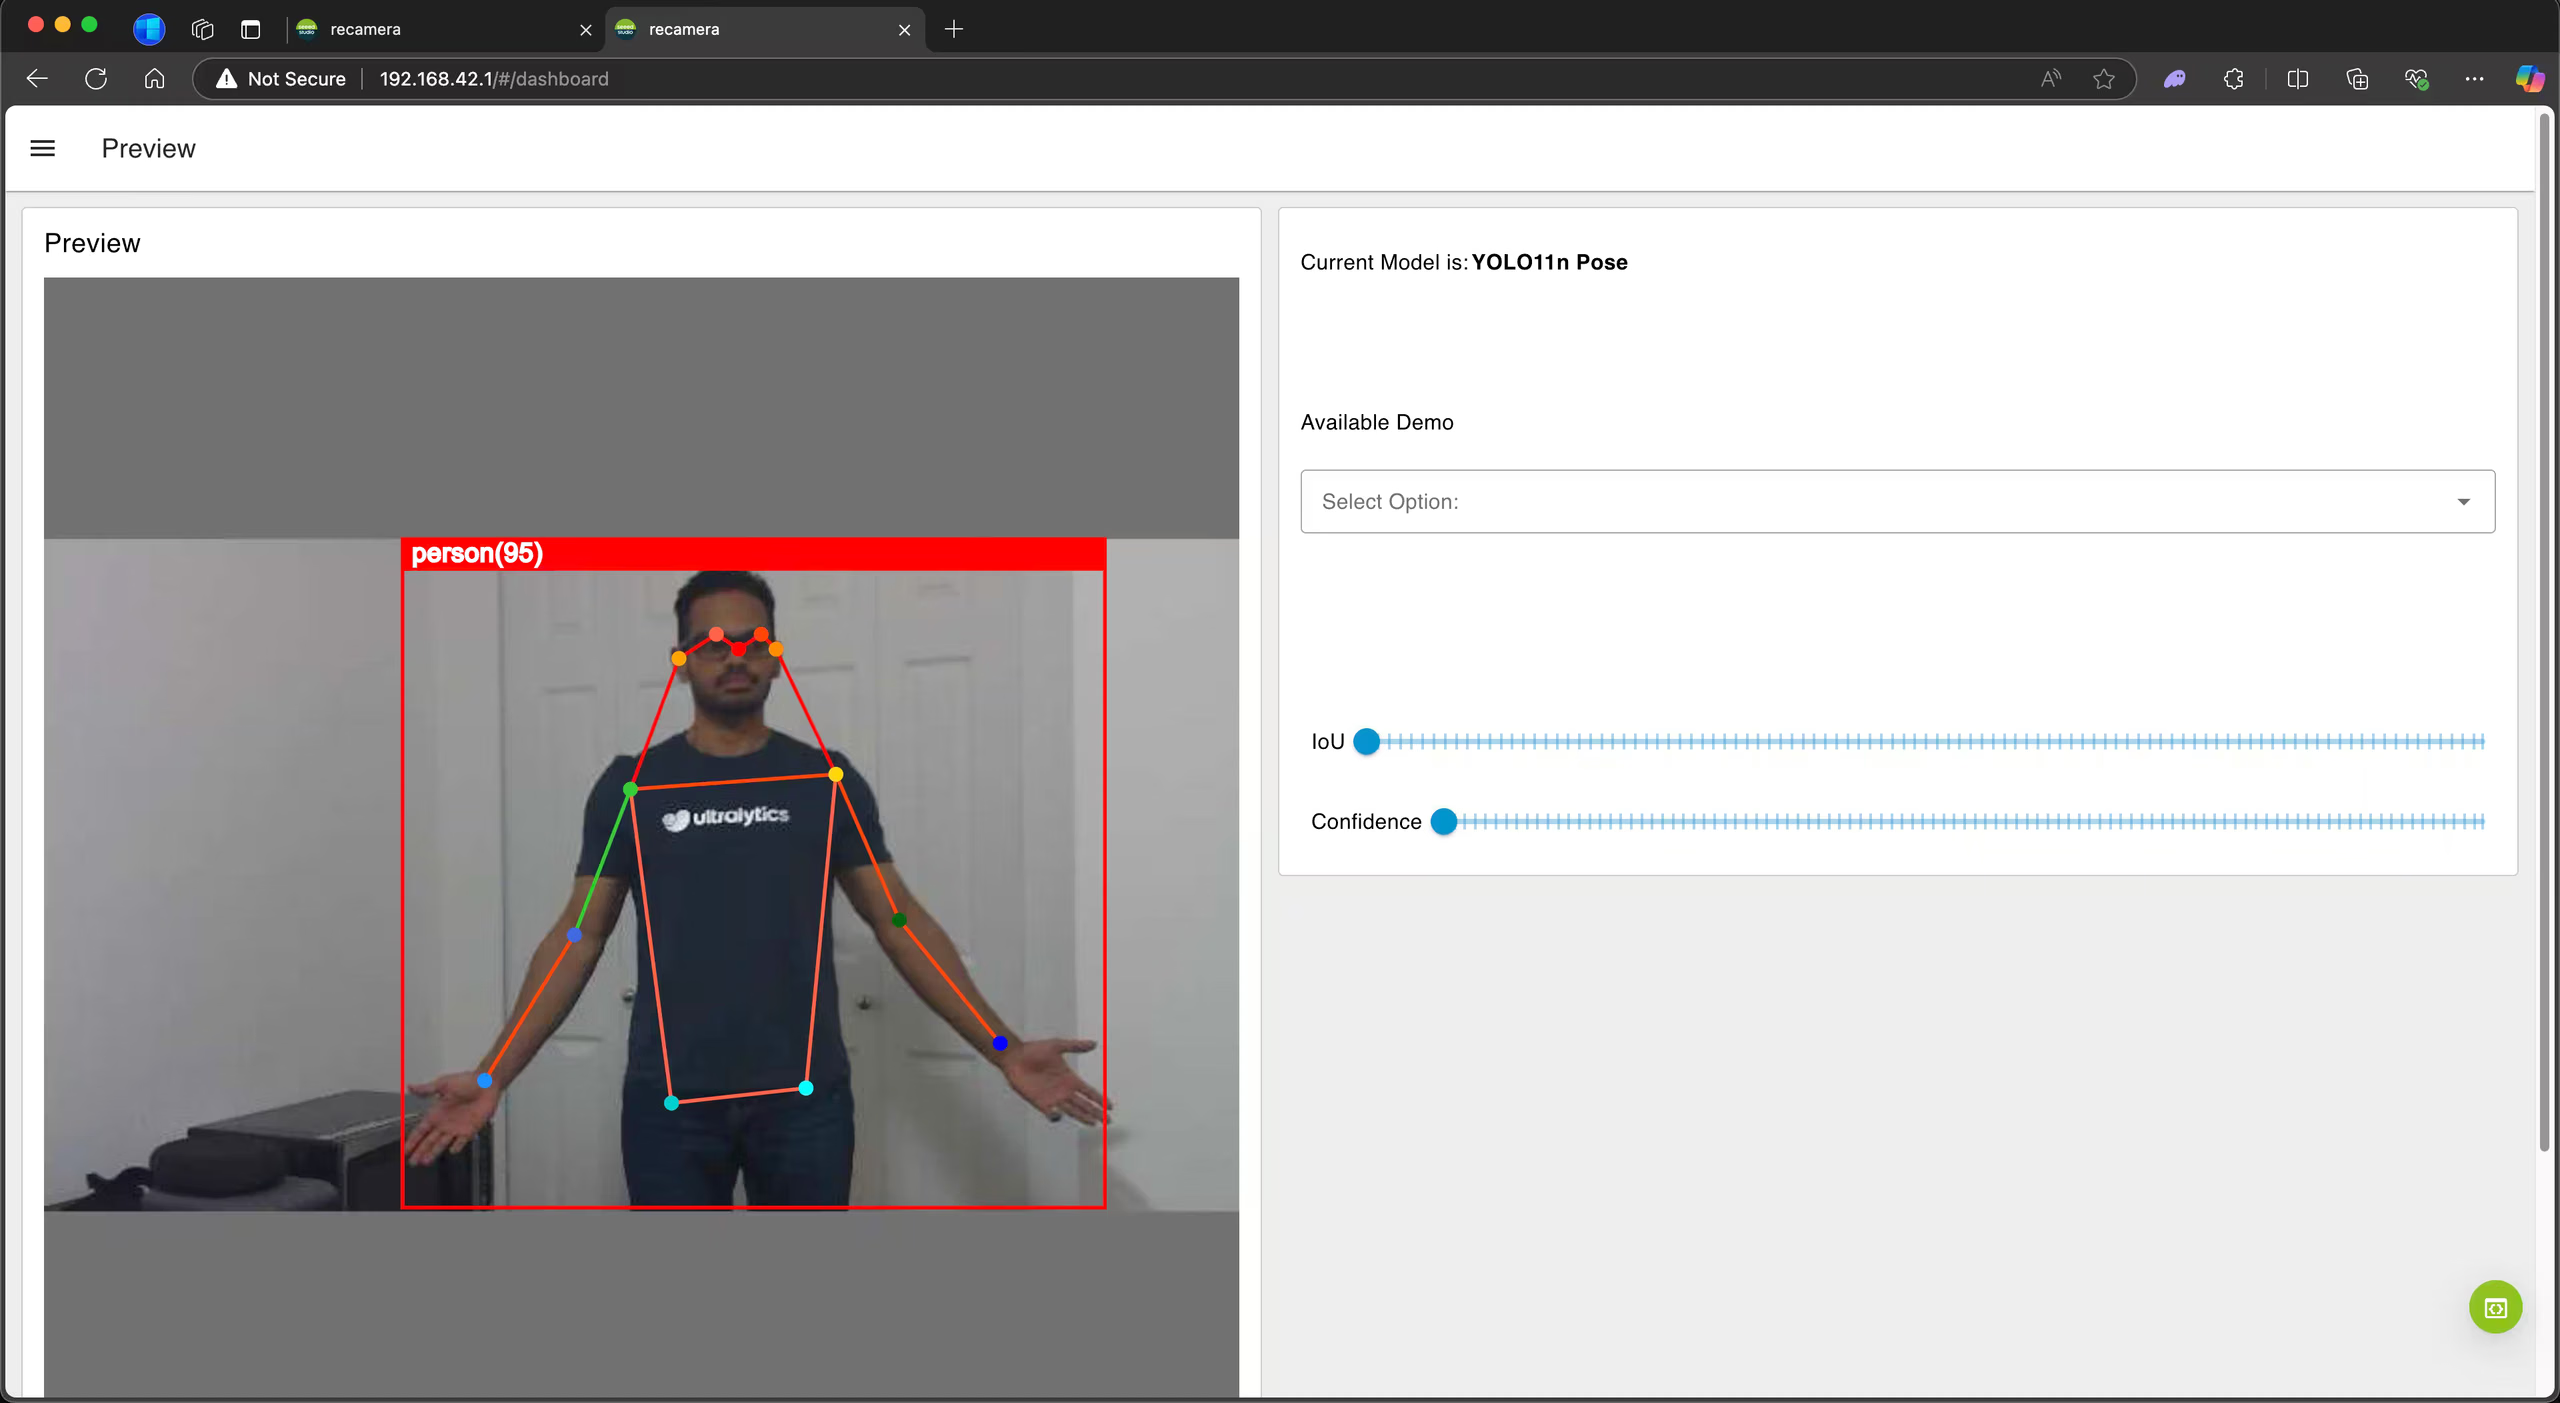
Paso 1: Si has conectado reCamera a una red, introduce su dirección IP en un navegador web para abrir el panel de Node-RED. Si has conectado reCamera a un PC mediante USB, puedes introducir 192.168.42.1. El modelo de detección se carga de forma predeterminada.
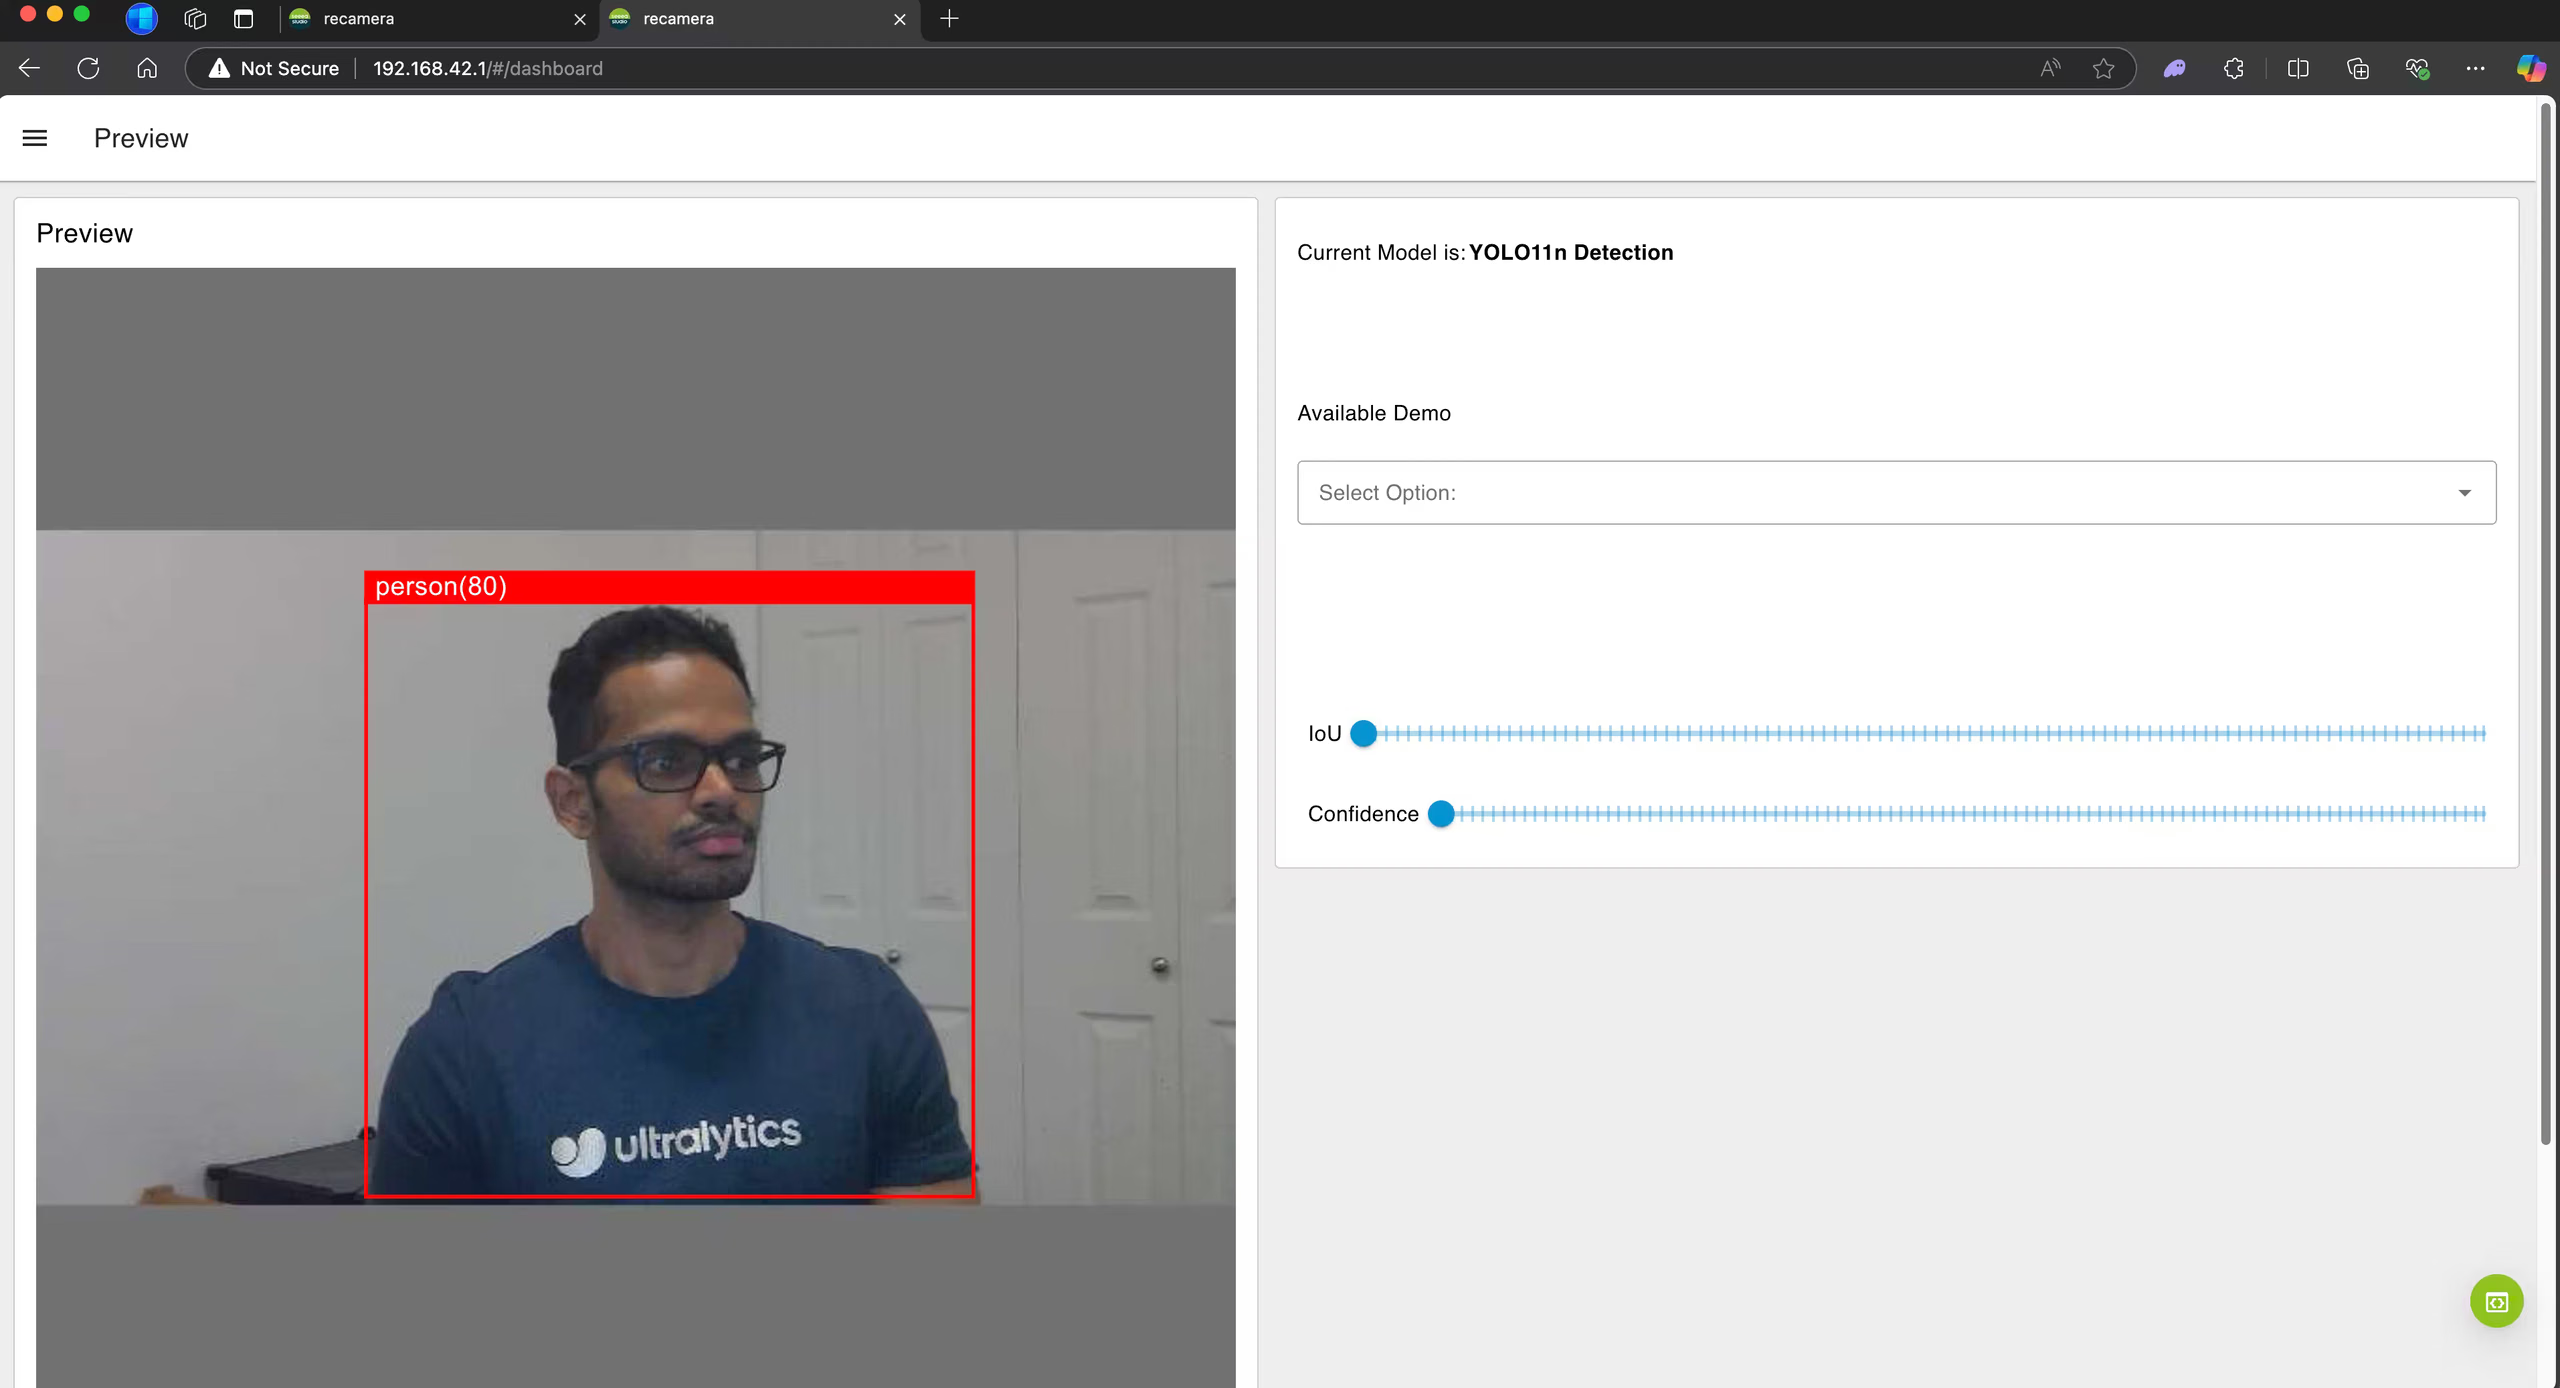
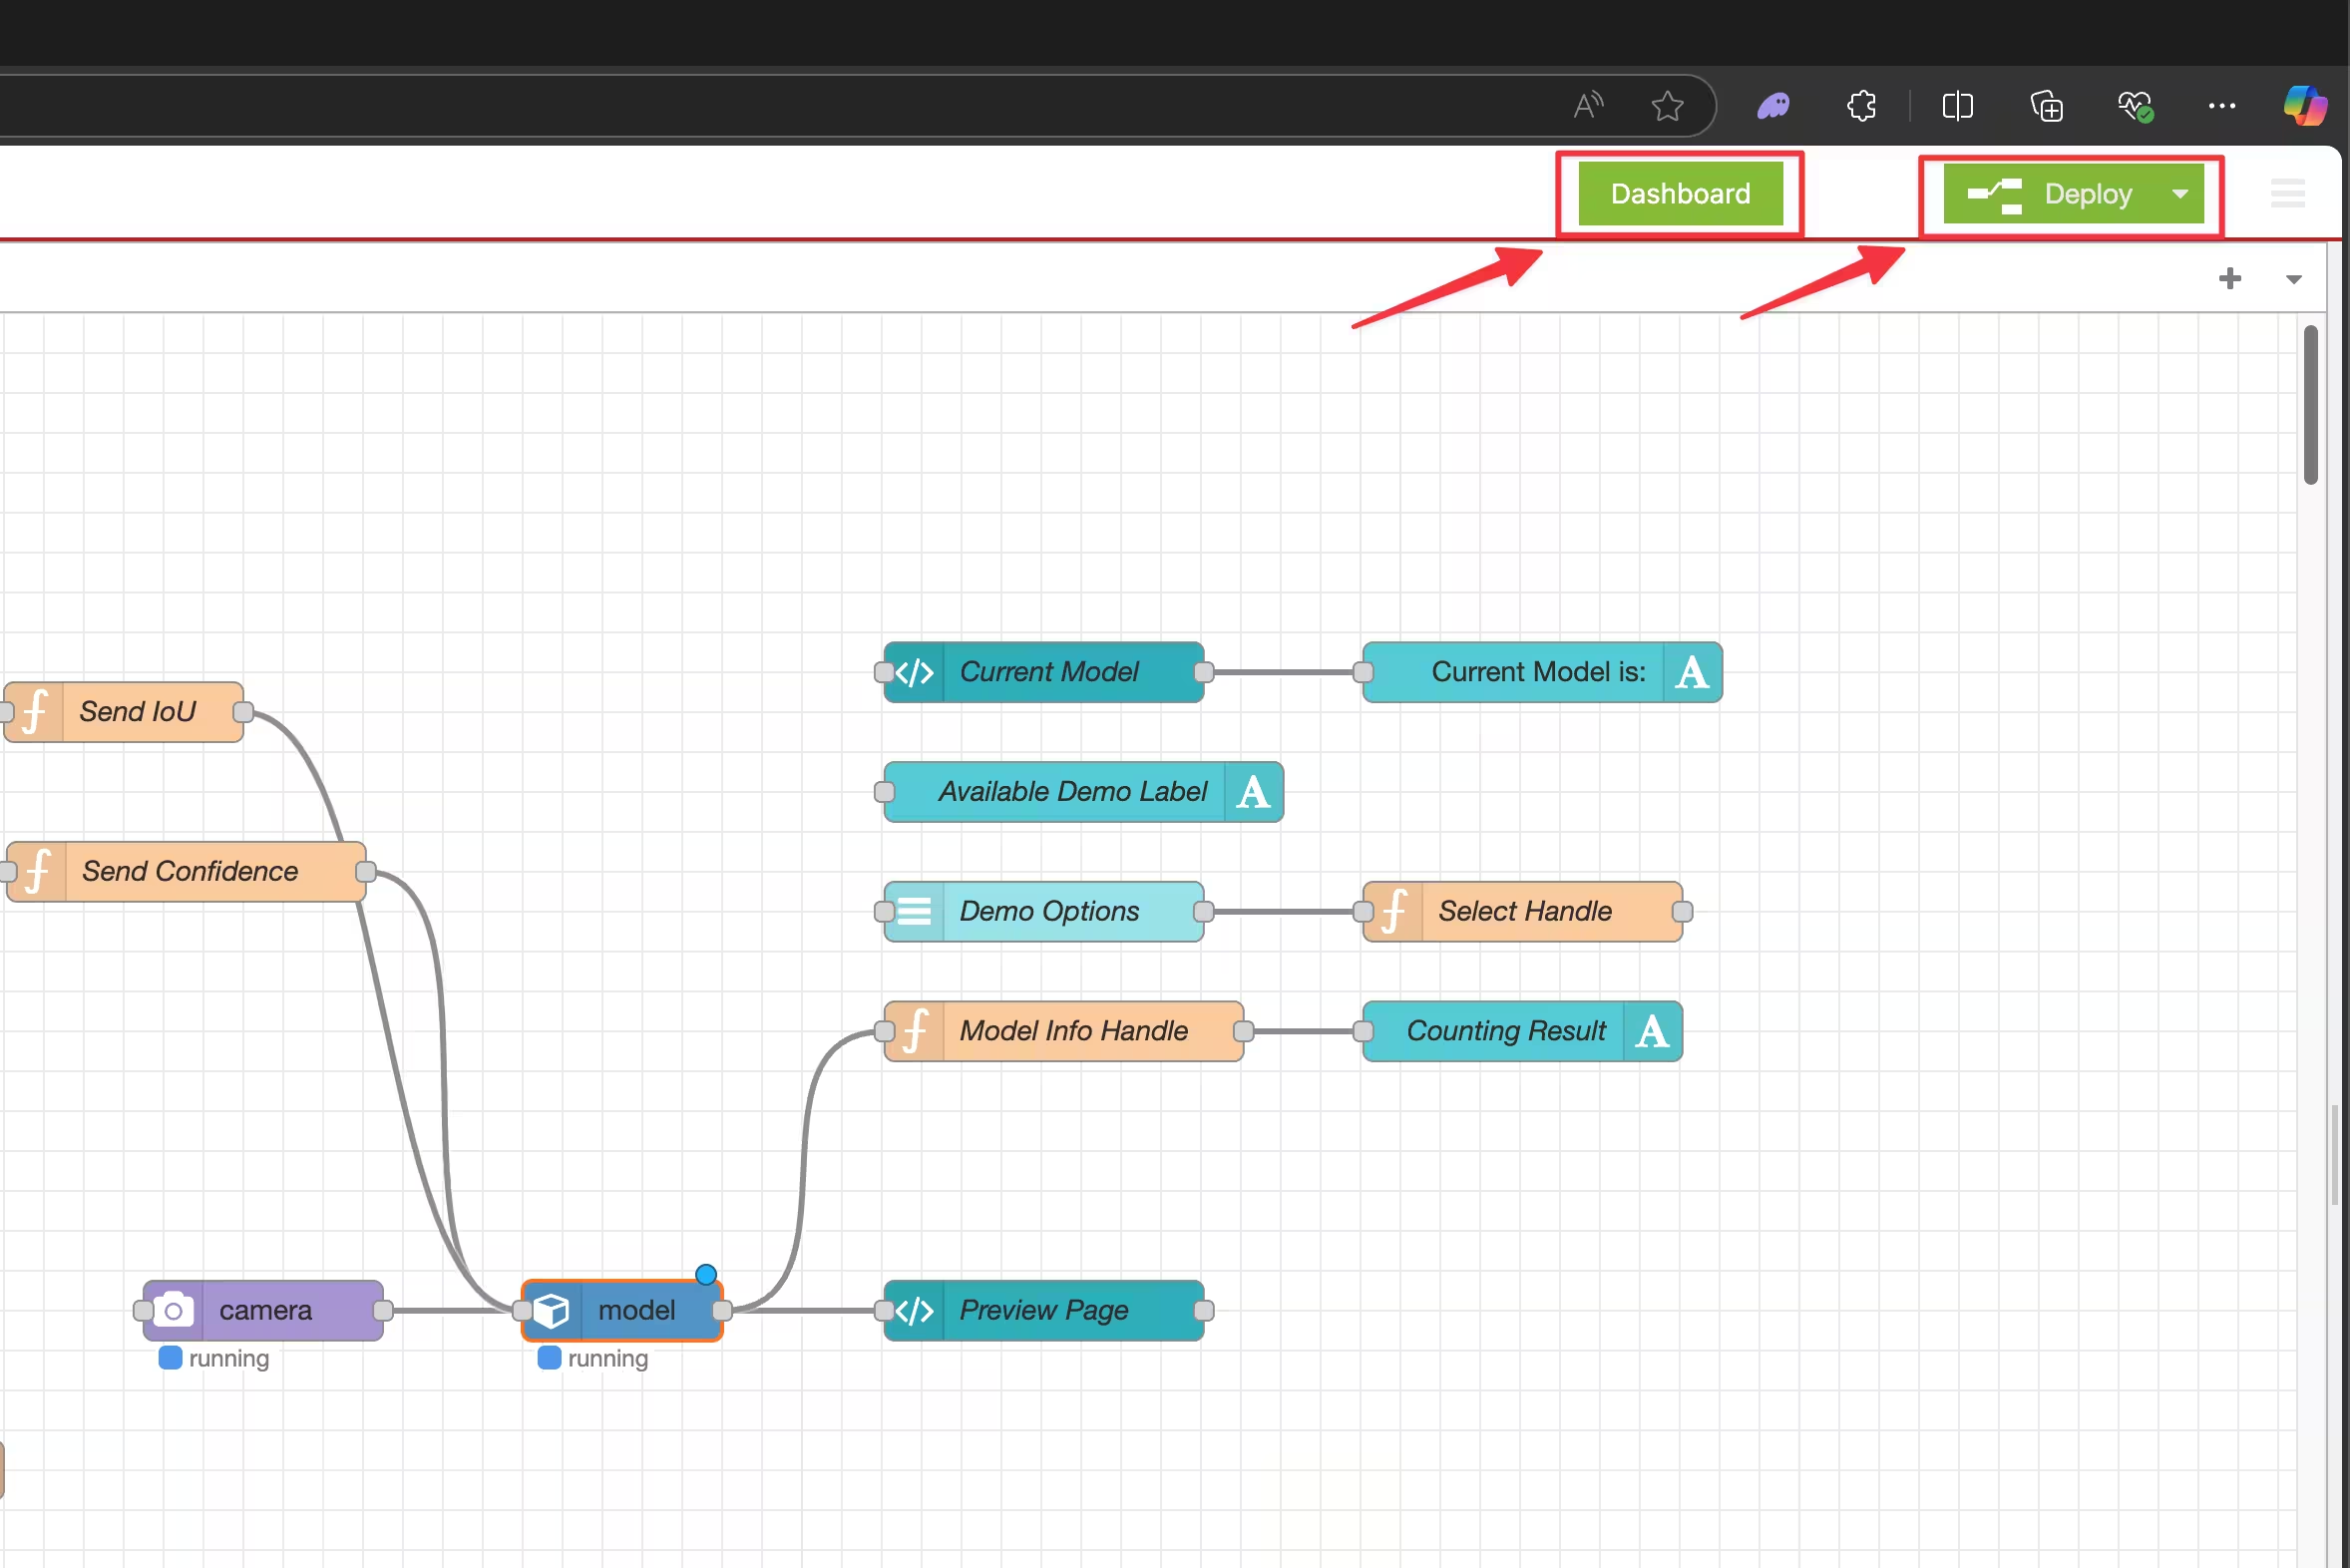
Paso 2: Haz clic en el círculo verde de la esquina inferior derecha para acceder al editor de flujos de Node-RED.
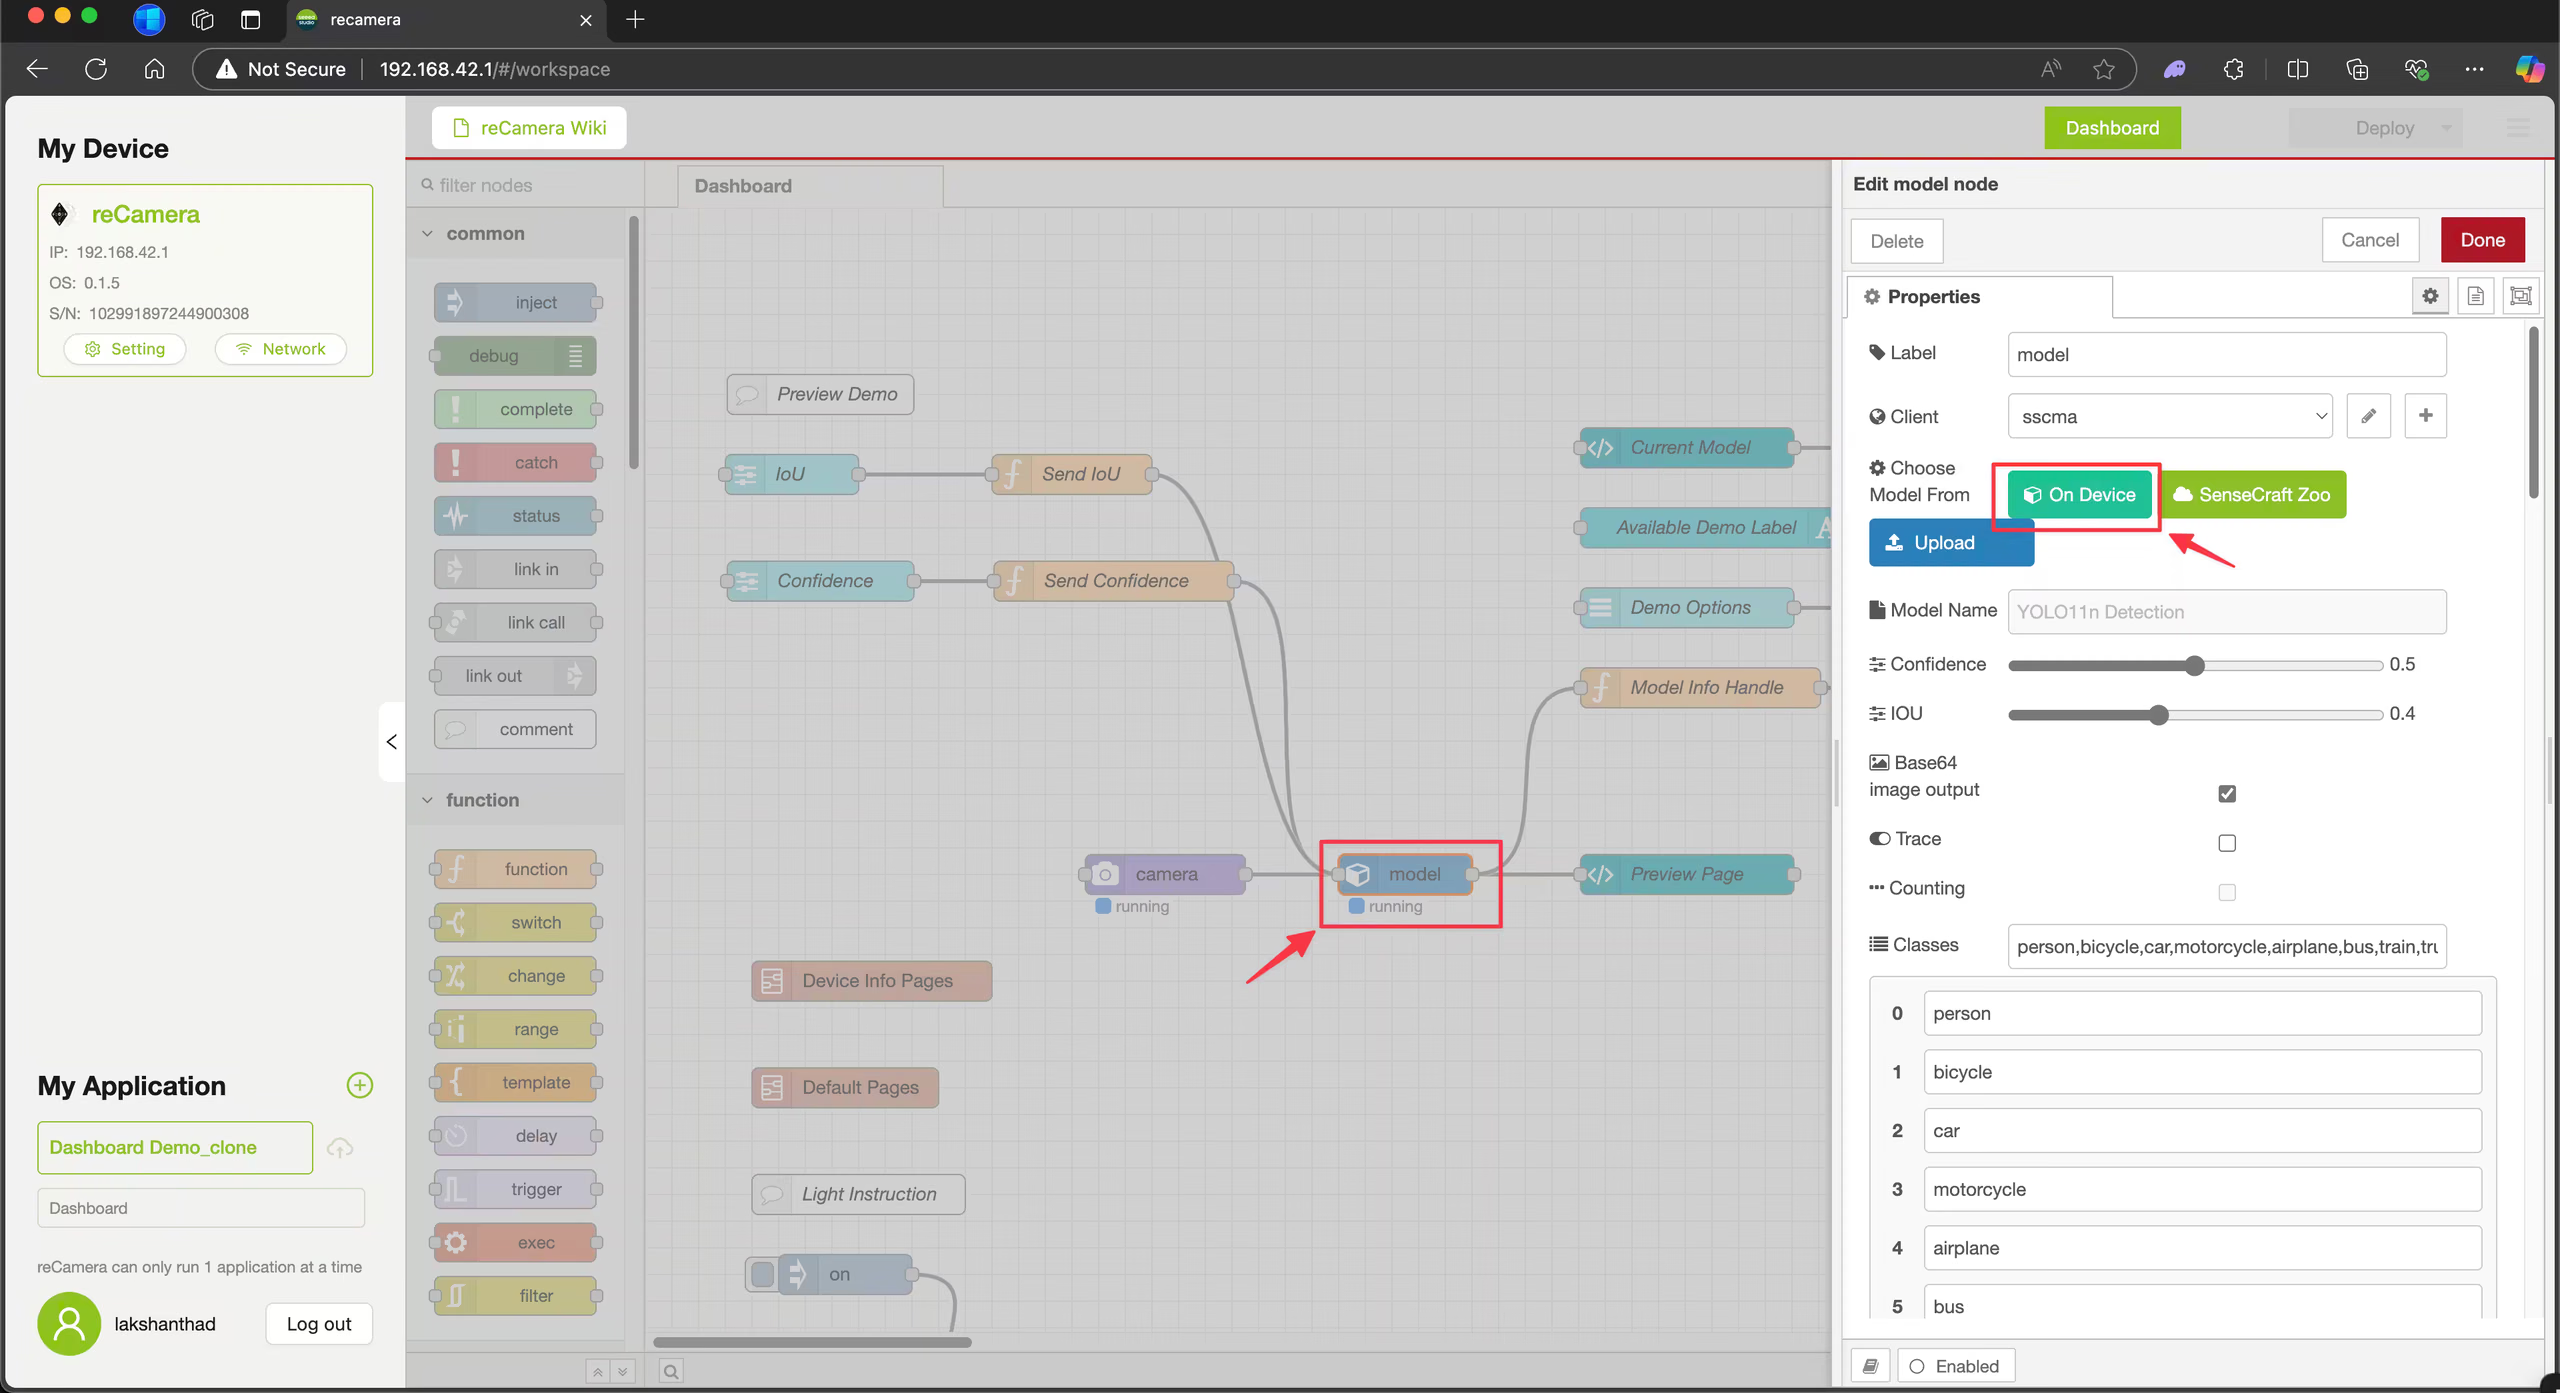
Paso 3: haz clic en el nodo model y, después, en On Device.
Paso 4: Elige uno de los cuatro modelos preinstalados y haz clic en Done. En este ejemplo se selecciona el modelo de estimación de pose.
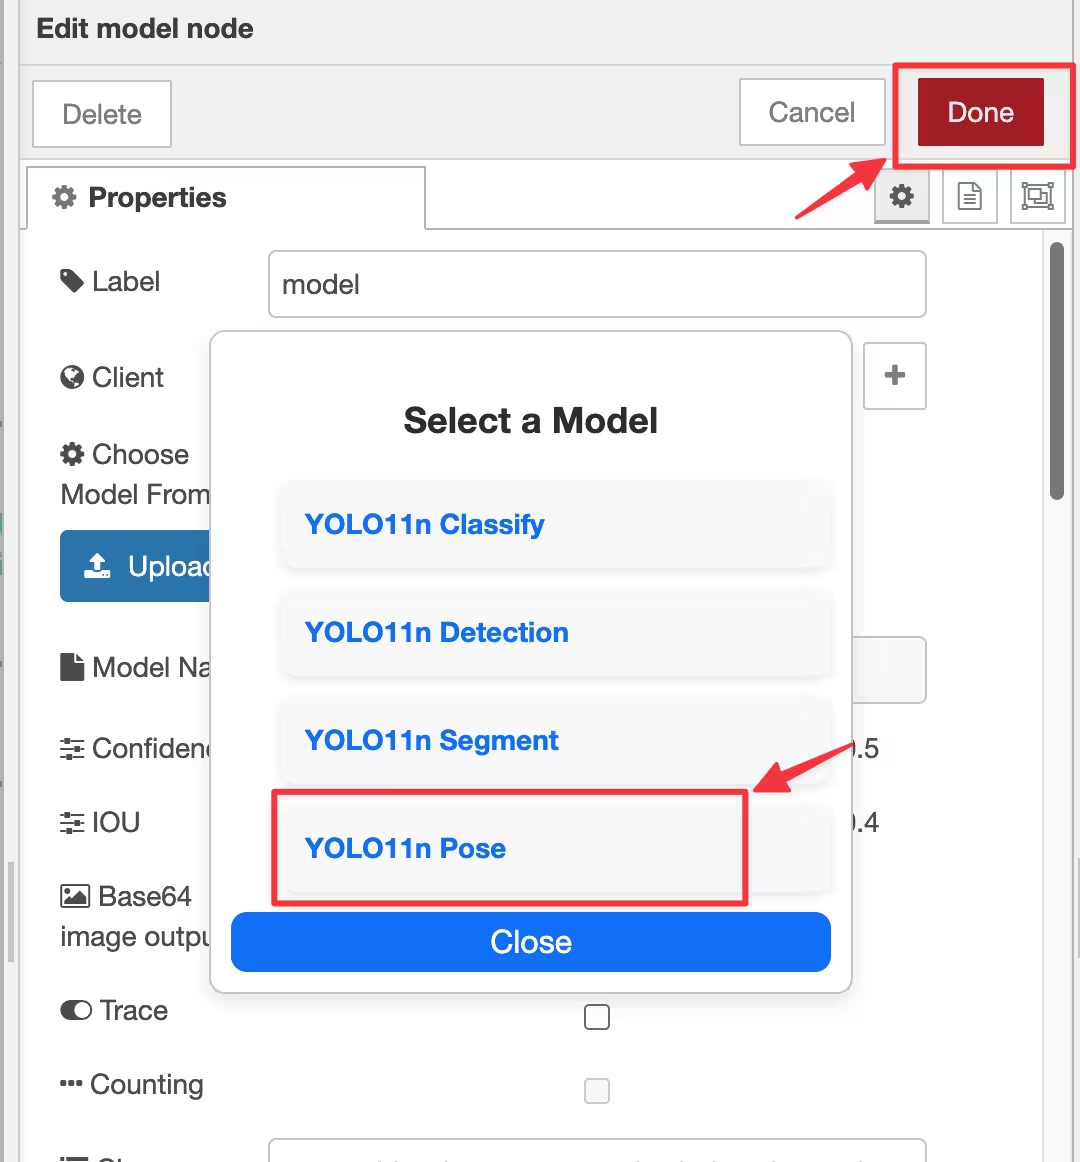
Paso 5: haz clic en Deploy y, cuando termine de implementarse, haz clic en Dashboard.
El panel muestra ahora el modelo de estimación de pose ejecutándose sobre la señal de vídeo de la cámara.
Exportar a cvimodel: convertir tu modelo YOLO26#
Si quieres usar un modelo YOLO26 entrenado a medida con reCamera, sigue estos pasos.
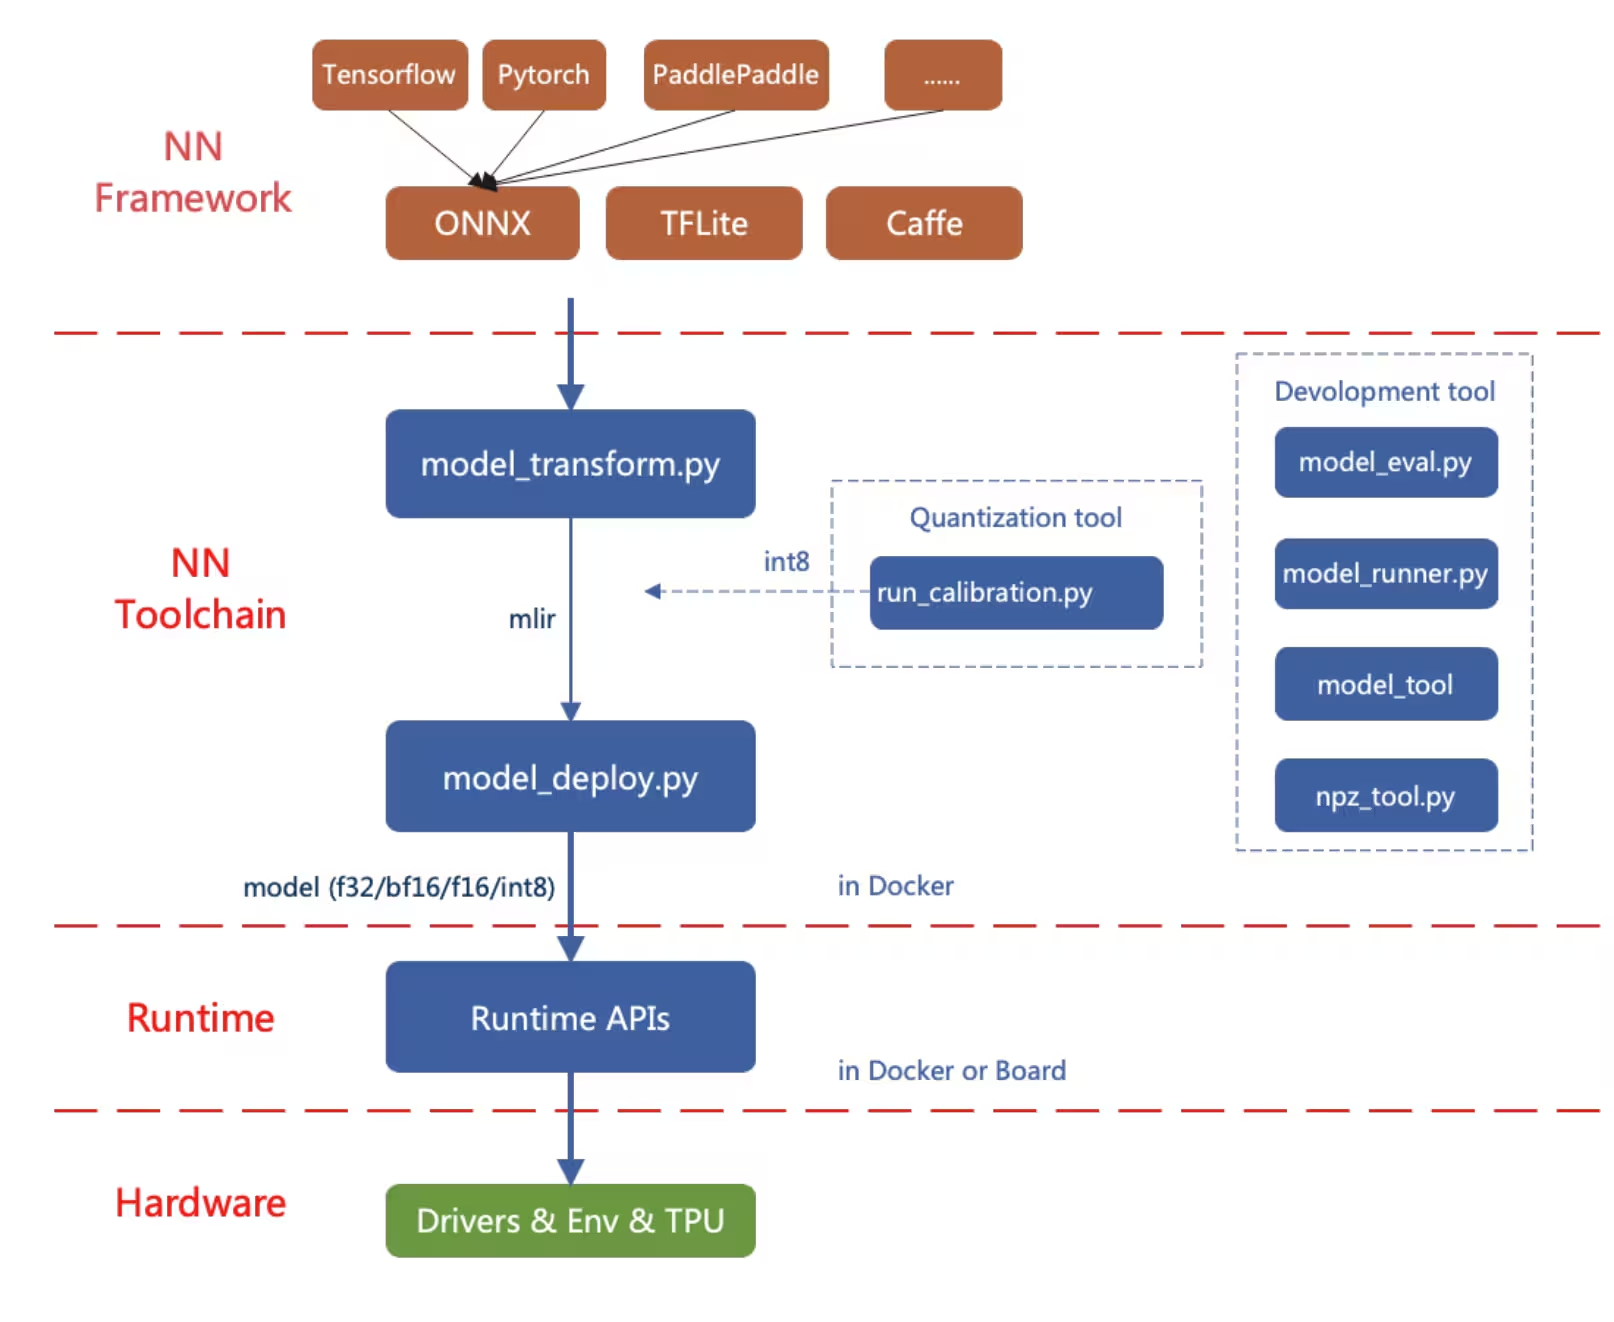
La conversión primero exporta un modelo PyTorch a ONNX, después lo convierte al formato de modelo MLIR y, por último, convierte MLIR a cvimodel para ejecutar la inferencia en el dispositivo.
Exportar a ONNX#
Exporta un modelo Ultralytics YOLO26 al formato de modelo ONNX.
Instalación#
Para instalar los paquetes necesarios, ejecuta:
pip install ultralyticsPara obtener instrucciones detalladas y buenas prácticas relacionadas con el proceso de instalación, consulta nuestra guía de instalación de Ultralytics. Si tienes dificultades al instalar los paquetes necesarios para YOLO26, consulta nuestra guía sobre problemas habituales, donde encontrarás soluciones y consejos.
Uso#
from ultralytics import YOLO

# Carga un modelo YOLO26
model = YOLO("yolo26n.pt")

# Exporta el modelo al formato ONNX
model.export(format="onnx", opset=14)  # crea 'yolo26n.onnx'
Para obtener más información sobre el proceso de exportación, visita la página de documentación de Ultralytics sobre exportación.
Exportar ONNX a MLIR y cvimodel#
Tras obtener un modelo ONNX, consulta la página Conversión y cuantización de modelos de IA para convertir el modelo ONNX a MLIR y, después, a cvimodel.
Aplicaciones de reCamera en el mundo real#
La visión artificial en el dispositivo y el diseño modular de reCamera la hacen adecuada para una amplia variedad de situaciones reales.
-
Detección de caídas: reCamera, diseñada para aplicaciones de seguridad y atención sanitaria, puede detectar caídas en tiempo real, por lo que resulta muy adecuada para el cuidado de personas mayores, hospitales y entornos industriales donde es fundamental responder con rapidez.
-
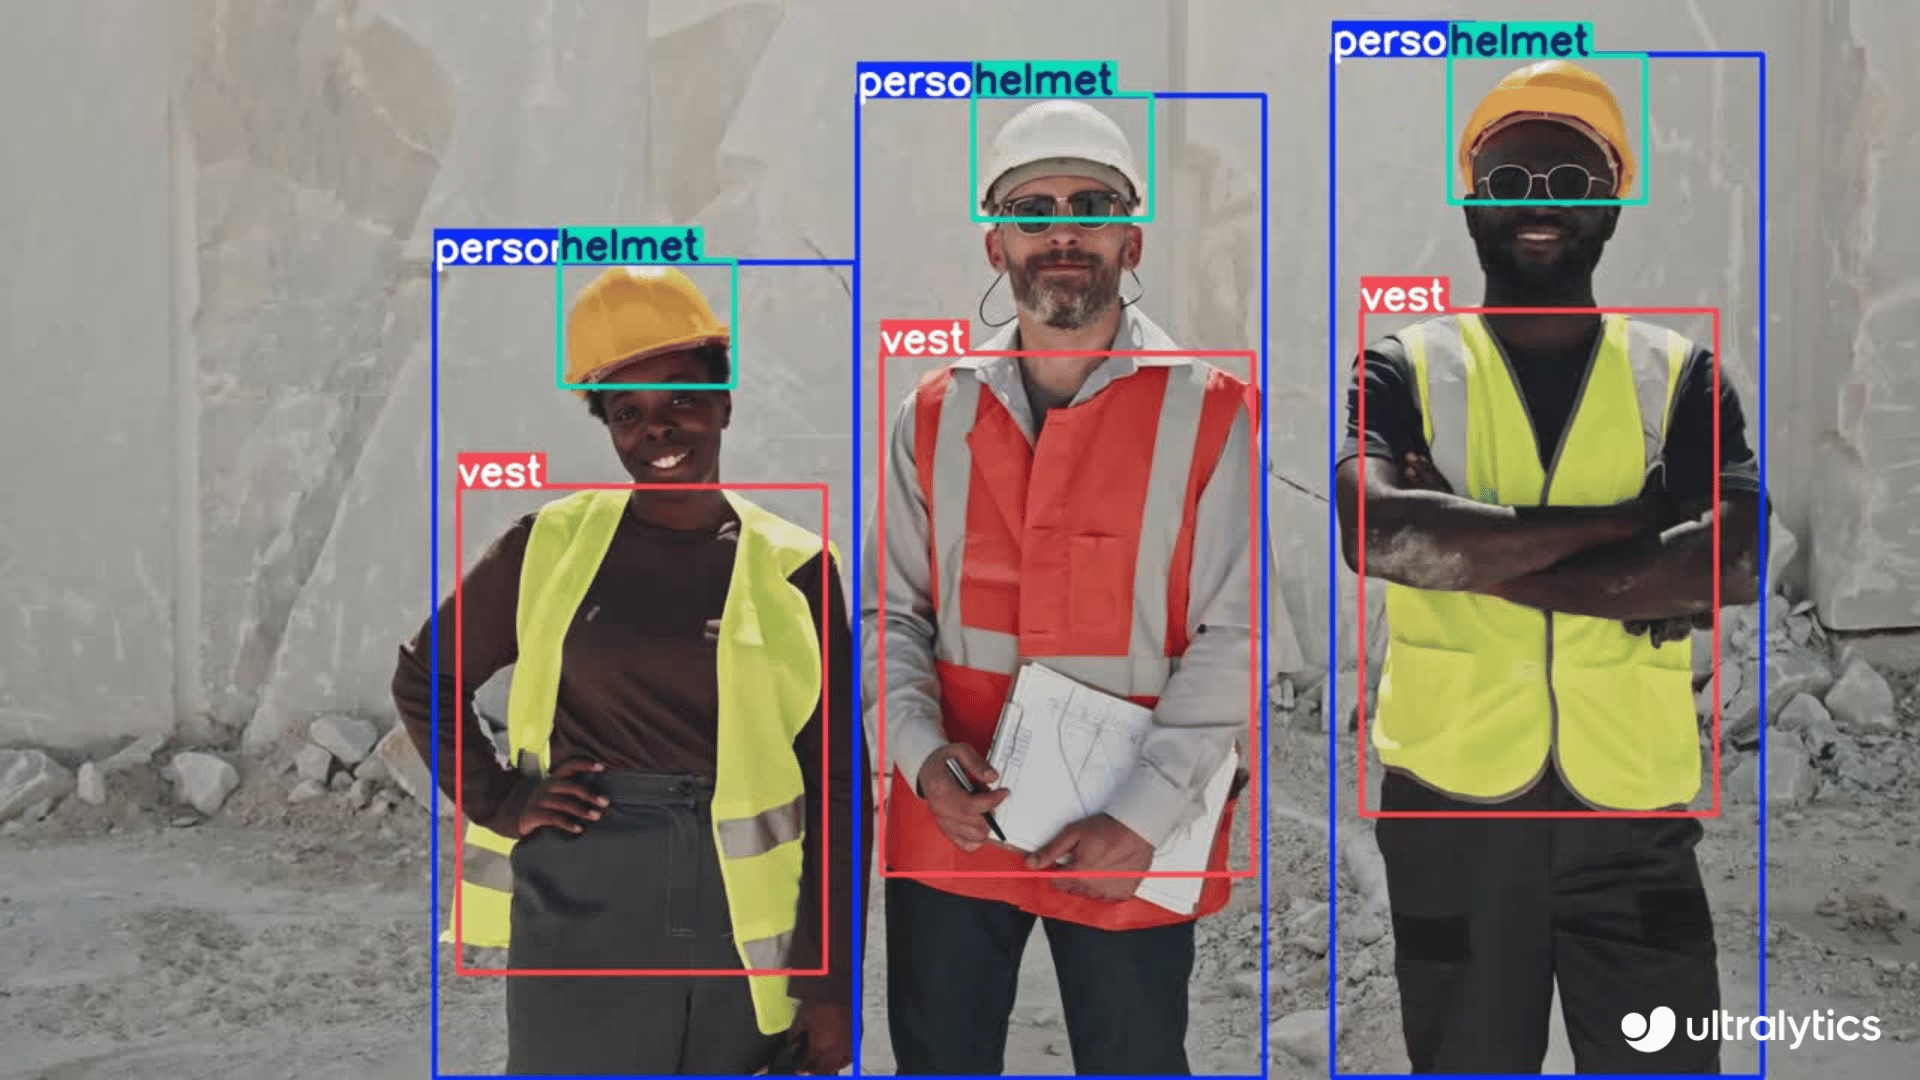
Detección de equipos de protección individual: reCamera puede contribuir a la seguridad en el trabajo mediante la detección del cumplimiento de las normas sobre equipos de protección en tiempo real. Ayuda a identificar si los trabajadores llevan cascos, guantes u otros equipos de seguridad, reduciendo los riesgos en entornos industriales.
-
Detección de incendios: las capacidades de procesamiento en tiempo real de reCamera la hacen muy adecuada para la detección de incendios en zonas industriales y residenciales, ya que proporciona alertas tempranas para prevenir posibles catástrofes.
-
Detección de residuos: también se puede utilizar para detectar residuos en tareas de vigilancia medioambiental y gestión de residuos con YOLO11.
-
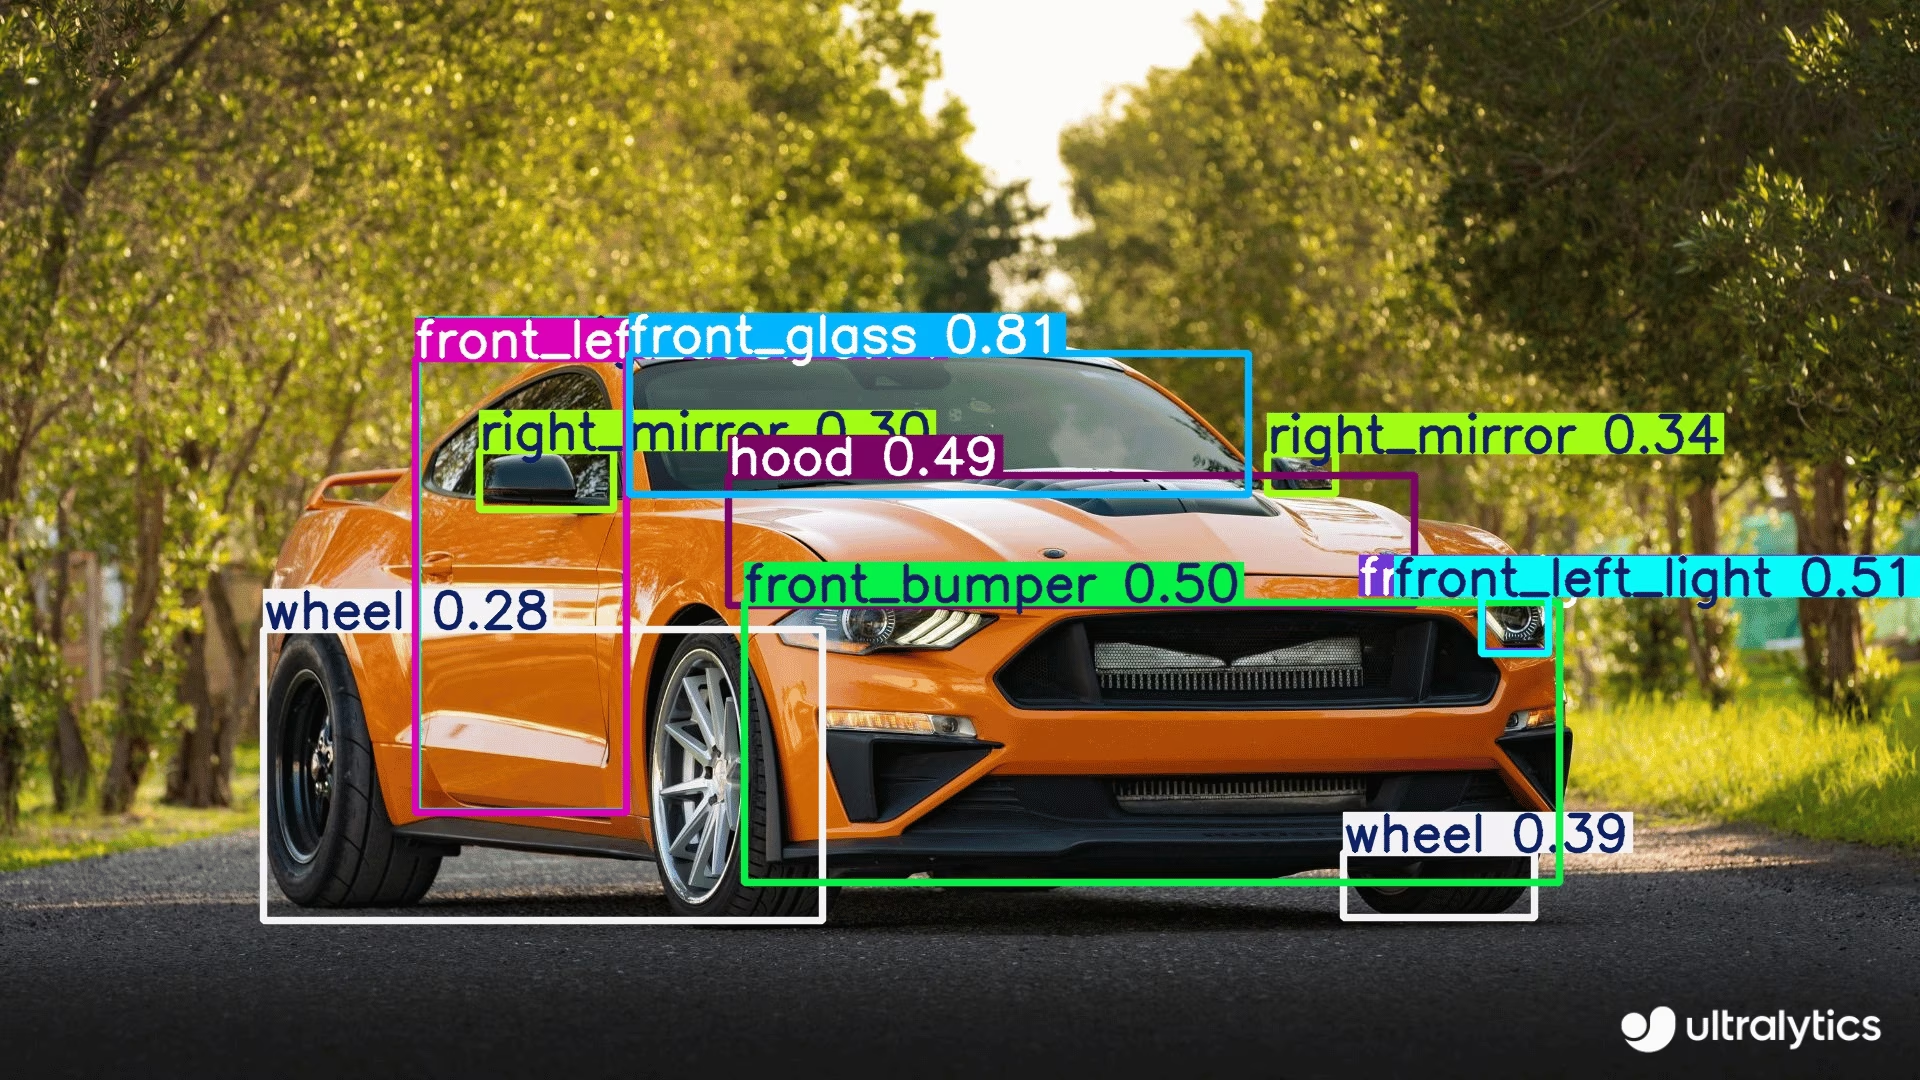
Detección de piezas de automóviles: En los sectores de la fabricación y la automoción, ayuda a detectar y analizar piezas de automóviles para el control de calidad, la supervisión de las líneas de montaje y la gestión del inventario.
Preguntas frecuentes#
Para configurar reCamera por primera vez, sigue estos pasos:
- Conecta reCamera a una fuente de alimentación
- Conéctala a tu red mediante la página Introducción a reCamera (selecciona tu dispositivo para abrir su guía de inicio rápido)
- Accede a la interfaz web de Node-RED introduciendo la dirección IP del dispositivo en un navegador web (o utiliza
192.168.42.1si está conectado por USB) - Empieza a usar de inmediato los modelos YOLO preinstalados desde la interfaz del panel
Sí, puedes utilizar modelos YOLO26 entrenados a medida con reCamera. El proceso incluye:
- Exporta tu modelo PyTorch al formato ONNX con
model.export(format="onnx", opset=14) - Convierte el modelo ONNX al formato MLIR
- Convierte el modelo MLIR al formato cvimodel para ejecutar inferencias en el dispositivo
- Carga el modelo convertido en reCamera
Para obtener instrucciones detalladas, consulta la guía Convertir y cuantizar modelos de IA.
- Exporta tu modelo PyTorch al formato ONNX con
A diferencia de las cámaras IP tradicionales, que requieren hardware externo para el procesamiento, reCamera:
- Integra el procesamiento de IA directamente en el dispositivo con su procesador RISC-V SG200X
- Ofrece 1 TOPS de potencia de cálculo para aplicaciones de IA en el edge en tiempo real
- Tiene un diseño modular que permite actualizar y personalizar los componentes
- Admite tecnologías de vídeo avanzadas, como la compresión H.264/H.265, la captura de imágenes HDR y la reducción de ruido 3D
- Incluye modelos Ultralytics YOLO preinstalados y listos para usar
Estas características convierten reCamera en una solución independiente para aplicaciones de IA en el edge, sin necesidad de hardware de procesamiento externo adicional.


Comentarios50
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
tcpipchip
we wrote a book and trainned to yolo26 on ultralytics...i recall that works
 Glenn JocherUltralytics
Yes, a custom-trained
YOLO26model can run onreCamerausing theONNX -> MLIR -> cvimodelworkflow in the reCamera guide; if you hit a blocker, please share the exact step and full error here so the Ultralytics team can help.
HanJammer
This site mentions recamera comes with YOLO26 (which is why I bought two of them) yet YOLO11 is installed (which is visible on screenshots as well) and I can't load YOLO26 - how to do that? I can't find reliable guide :(
Ah nevermind, I think I got it, still it would be better not to advertise the camera "reCamera comes pre-installed with four Ultralytics YOLO26 models" which is basically not true.
I whipped out some 'single click' tool to convert YOLO26 onnx-es which makes it a bit easier... I need to test it a bit, for now it supports the base model. Perhaps I will push it to my github later this week.
This is fantastic.
When you finish it, i will add to the BOOK.
Here is the first version of the converter util (it's just GUI and few scripts over the actual workflow). For now it was tested with a base detection model under Windows. More to come.
https://github.com/HanJammer/reCamera_YOLO26
Video presentation here: https://youtu.be/XgPjyj2U8YQ
Here is the first version of the converter util (it's just GUI and few scripts over the actual workflow). For now it was tested with a base detection model under Windows. More to come.
https://github.com/HanJammer/reCamera_YOLO26
Video presentation here: https://youtu.be/XgPjyj2U8YQ
wow!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!
i will test soon!
- Glenn JocherUltralytics
Thanks for sharing this; for anyone testing, the supported path today is still the reCamera integration guide together with Seeed’s model conversion guide, and we’ll review the docs wording around preinstalled models since some devices appear to ship with YOLO11 rather than YOLO26.
@glenn-jocher Have you a recamera ?
- Glenn JocherUltralytics
I don’t personally keep a reCamera on my desk, but the workflow in the Seeed Studio reCamera guide is the supported path; if you have a specific setup or export question, please drop it here and the Ultralytics team can take a look.
I tested on recamera with my trainned pose keypoint model... Same problem...no keypoint
Need to test on yolo8 on tdl sdk
- Glenn JocherUltralytics
Thanks for checking this; for custom pose models on reCamera, please drop the exact export and conversion steps here in the discussion so the Ultralytics team can take a look, since keypoints should work only after a correct
ONNX -> MLIR -> cvimodelpipeline as outlined in the reCamera guide and Seeed’s conversion guide, and it’s worth first confirming your exportedONNXmodel still produces keypoints before converting.
did you do calibration ? where the images to me to the calibration :(
- Glenn JocherUltralytics
Calibration isn’t done in the Ultralytics export step; for reCamera, you export to ONNX first with the reCamera guide, then calibration happens during Seeed’s ONNX→MLIR→
cvimodelflow using a small representative set of your own images, as described in Seeed’s Convert and Quantize AI Models guide. If you hit an error in that step, please drop the full log here and we’ll take a look.
still waiting...
send me your cvimodel too...yolo11 and yolo8
please, send me arguments used in your scripts...
did you train keypoints on animals and persons, right ?
tiruvijayakumar
NOO, i didnt train on animals, i trained on these classes for pose detection for persons using yolov11n-pose.pt weights. I fine‑tuned the YOLOv11n‑pose.pt model on my custom classes:
Running Walking Golf Skate Horse riding Kicking Diving I just uploaded animal detection model to justify that custom model deployment with quantization for object detection(yolo11n.pt) on recamera has no issues, it was another cvi model which i had no issues, it worked PERFECTLY. i only issue what i am facing is the pose detection quantized model where i am not able to see the keypoints on the inference output but bounding box is drawn along with predicted class label refer below:
now just trying to train the model for pose detection using yolov8 and then i would try quantizing the model and check if the keypoints are shown in the inference output
- Glenn JocherUltralytics
Thanks, that helps narrow it down — since detection
cvimodels work and only the quantized pose model loses keypoints, this looks more like a pose conversion or postprocessing issue in the ONNX → MLIR →cvimodelstep than a training problem. Please keep the details here so the Ultralytics team can see them, and share the exact conversion commands and full text logs from the reCamera guide and Seeed model conversion guide, plus whether the same pre-quantized ONNX shows keypoints before conversion. i ran predictions on ultralytics hub on the .pt model format, i attached the whole problem scenario and image content :https://github.com/orgs/ultralytics/discussions/22090?sort=new#discussioncomment-16346206 Any ways uploading the prediction on ultralytics hub in this thread also :
so on the model.pt file inference shows this data, this confirms that pose estimation model works. { "images": [ { "shape": [ 426, 640 ], "speed": { "preprocess": 1.41517, "inference": 130.14456, "postprocess": 0.99221 }, "results": [ { "name": "Kicking", "class": 5, "confidence": 0.80929, "box": { "x1": 0.26068, "y1": 0.10738, "x2": 0.55882, "y2": 0.85426 }, "keypoints": { "x": [ 0.41923001408576965, 0.42656999826431274, 0.4166699945926666, 0.45181000232696533, 0.42857998609542847, 0.488209992647171, 0.43380001187324524, 0.543470025062561, 0.41604000329971313, 0.5516700148582458, 0.4164600074291229, 0.46198999881744385, 0.4427199959754944, 0.357340008020401, 0.427839994430542, 0.29197001457214355, 0.43891000747680664 ], "y": [ 0.2315099984407425, 0.21907000243663788, 0.21740999817848206, 0.21602000296115875, 0.21322999894618988, 0.2783600091934204, 0.2824600040912628, 0.3255299925804138, 0.35097000002861023, 0.32879000902175903, 0.3619599938392639, 0.5179499983787537, 0.5104399919509888, 0.6517800092697144, 0.6389099955558777, 0.7586100101470947, 0.7324900031089783 ], "visible": [ 0.9994300007820129, 0.9990299940109253, 0.9990000128746033, 0.999019980430603, 0.9988300204277039, 0.9995700120925903, 0.9996600151062012, 0.998960018157959, 0.9992700219154358, 0.9985499978065491, 0.997439980506897, 0.9995700120925903, 0.9995700120925903, 0.9988800287246704, 0.9989299774169922, 0.982990026473999, 0.9852499961853027 ] } } ] } ], "metadata": { "imageCount": 1, "functionTimeAlive": 78321.917, "functionTimeCall": 0.138, "model": "best.pt", "version": { "ultralytics": "8.4.30", "torch": "2.11.0+cpu", "torchvision": "0.26.0+cpu", "python": "3.14.3" } }, "networkTime": 1.214 }
I didnt capture the conversion commands and text logs during the onnx->mlir->cvimodel, would repeat the same steps and paste the images in this thread itself.
Exported the yolov11n-pose.pt(finetuned) on google colab to onnx format
Uploaded the model on netron to view the structure, onnx is in the format IRv9 ,opset v20(would downgrade it). Classes are running, walking, golf-swing, skateboarding, riding-horse and kicking
Seeed studio guide for downgrading
Initial structure of workspace folder
Step1: pull sopho/tpuc_dev:v3.1
Step2: starting the container
Step3: installing onnx
Step4: Clone Downgrade Script
Step5: Downgrade Script settings IR v8 and Opset v17
Step6: Install TPU-MLIR tools inside container:
Step7: clone tpu-mlir
Step8: setup environment tpu-mlir(long step)
Step9: according to seeed studio guide, i have to include outputs before the model's head as the parameter for this particular step model_transform
--model_name yolo11n
--model_def yolo11n.onnx
--input_shapes "[[1,3,640,640]]"
--mean "0.0,0.0,0.0"
--scale "0.0039216,0.0039216,0.0039216"
--keep_aspect_ratio
--pixel_format rgb
--output_names "/model.23/cv2.0/cv2.0.2/Conv_output_0,/model.23/cv3.0/cv3.0.2/Conv_output_0,/model.23/cv2.1/cv2.1.2/Conv_output_0,/model.23/cv3.1/cv3.1.2/Conv_output_0,/model.23/cv2.2/cv2.2.2/Conv_output_0,/model.23/cv3.2/cv3.2.2/Conv_output_0"
--test_input ../image/dog.jpg
--test_result yolo11n_top_outputs.npz
--mlir yolo11n.mlir i have the onnx file, could someone of the team help me identify the outputs before the model's head? @glenn-jocher here is the onnx file https://drive.google.com/file/d/1UF25DK2zXx0GCWdcx55SPYHL71SylDeg/view?usp=sharing
and some animal pictures...