Jeu de données Caltech-256#
Le jeu de données Caltech-256 est un benchmark classique de classification d’images, composé de 30 607 images réparties dans 256 catégories d’objets et une classe d’arrière-plan. Chaque catégorie contient au moins 80 images d’objets du monde réel — animaux, véhicules, articles ménagers et personnes —, ce qui en fait un successeur plus vaste et plus exigeant de Caltech-101 pour les modèles de reconnaissance d’objets.
Explore Caltech-256 sur Ultralytics Platform pour prévisualiser des exemples, consulter les statistiques du jeu de données et le cloner afin de l’utiliser pour l’entraînement.
Regarder : Comment entraîner un modèle de classification d’images avec le jeu de données Caltech-256 et Ultralytics YOLO26
Caltech-256 ne propose aucune répartition prédéfinie entre entraînement et validation. Les commandes d’entraînement ci-dessous le répartissent automatiquement à 80 % pour l’entraînement et 20 % pour la validation ; aucune préparation manuelle n’est donc nécessaire.
Fonctionnalités clés#
- Caltech-256 contient 30 607 images couleur réparties dans 256 catégories d’objets et une classe d’arrière-plan
257.clutter(soit 257 dossiers de classes au total). - Les catégories couvrent une grande variété d’objets du monde réel, notamment des animaux, des véhicules, des articles ménagers et des personnes.
- Chaque catégorie contient au moins 80 images, et la plus grande en compte environ 800, ce qui entraîne un déséquilibre entre les classes.
- Les images ont des tailles et des résolutions variables.
- Caltech-256 est largement utilisé pour évaluer les algorithmes de classification d’images et de reconnaissance d’objets.
Structure du jeu de données#
Caltech-256 est distribué sous la forme de 257 dossiers — un par classe, couvrant 256 catégories d’objets et une classe d’arrière-plan 257.clutter —, sans répartition prédéfinie entre entraînement et validation. Au lancement de l’entraînement, Ultralytics répartit automatiquement les images afin que les modèles s’entraînent sur les 257 classes, sans configuration manuelle :
- Classes : 257 (256 catégories d’objets + 1 classe d’arrière-plan)
- Nombre total d’images : 30 607
- Répartition entraînement/validation : automatique, 80 % / 20 % (≈24 385 pour l’entraînement, ≈6 222 pour la validation)
- Images par classe : au moins 80 (répartition déséquilibrée, jusqu’à environ 800)
Applications#
Le jeu de données Caltech-256 est largement utilisé pour entraîner et évaluer des modèles de classification d’images et de reconnaissance d’objets, notamment les réseaux de neurones convolutifs (CNNs) et les machines à vecteurs de support (SVMs). Le grand nombre de catégories et la qualité des images en font un benchmark populaire pour la recherche et le prototypage en apprentissage automatique et en vision par ordinateur.
Utilisation#
Entraîne un modèle YOLO sur Caltech-256 pendant 100 époques, avec une taille d’image de 416. Pour consulter la liste complète des arguments disponibles, reporte-toi à la page Entraînement et au guide de la tâche de classification d’images.
from ultralytics import YOLO

# Charger un modèle
model = YOLO("yolo26n-cls.pt")  # charger un modèle préentraîné (recommandé pour l’entraînement)

# Entraîner le modèle
results = model.train(data="caltech256", epochs=100, imgsz=416)
Exemples d’images et annotations#
Le jeu de données Caltech-256 contient des images couleur de haute qualité représentant divers objets. Il constitue un jeu de données bien structuré pour les tâches de classification d’images. Voici quelques exemples d’images du jeu de données (crédit) :
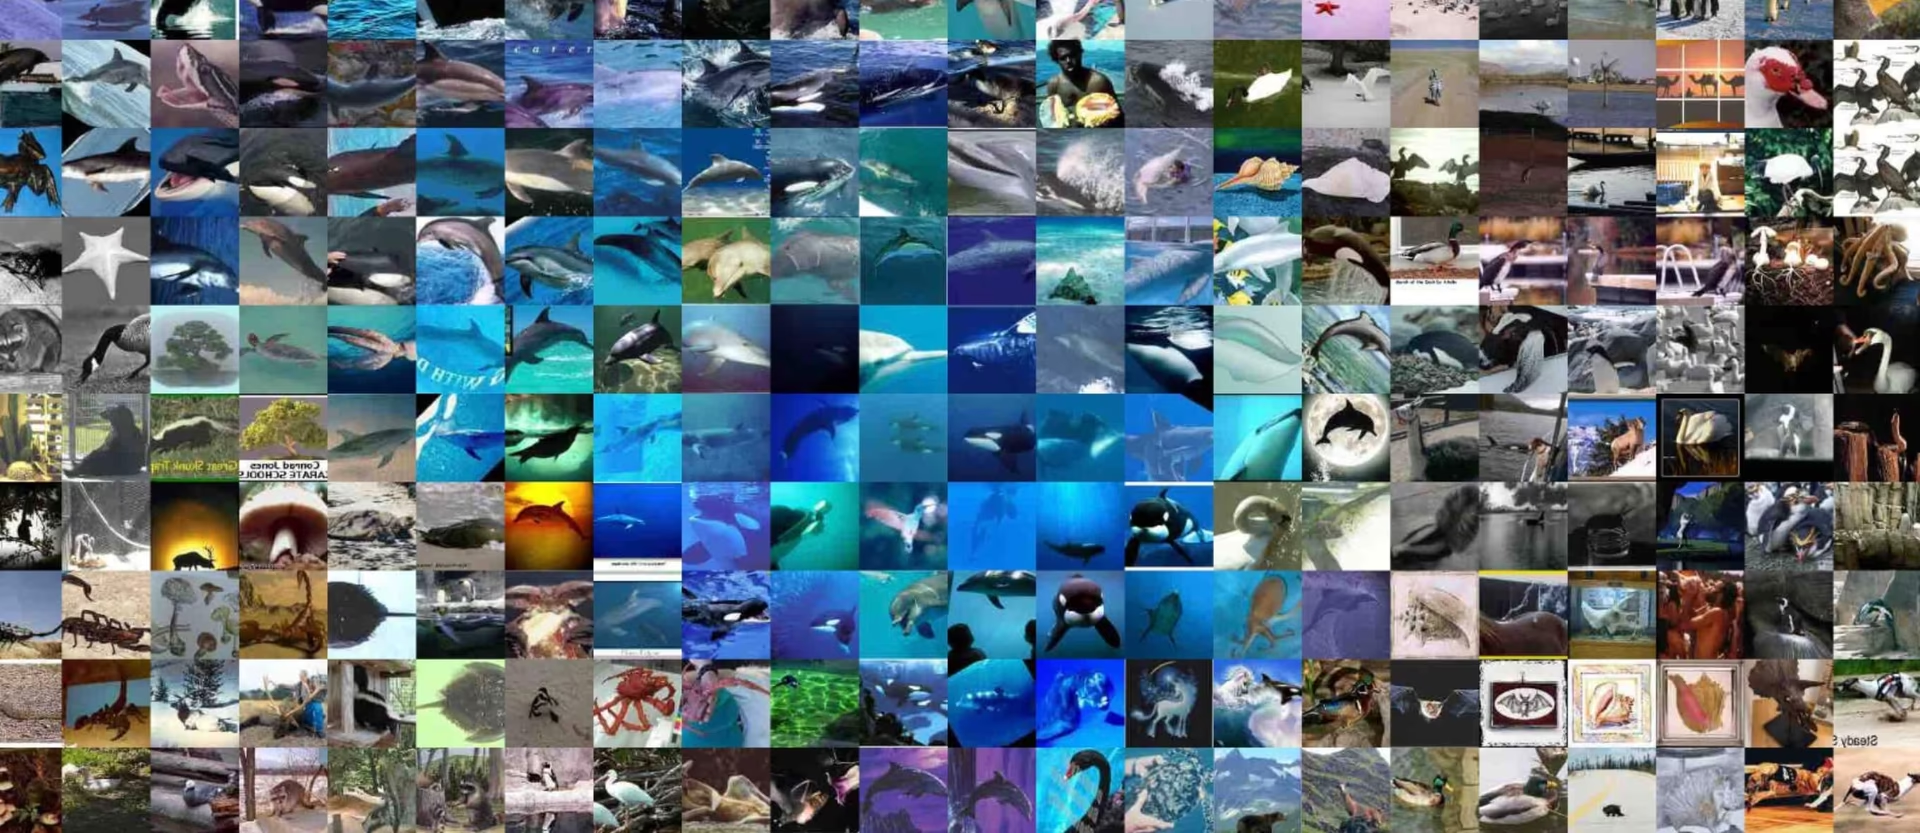
Les exemples illustrent la diversité et la complexité des objets du jeu de données Caltech-256, soulignant l’intérêt d’un jeu de données varié pour entraîner des modèles robustes de reconnaissance d’objets.
Citations et remerciements#
Si tu utilises le jeu de données Caltech-256 dans tes travaux de recherche ou de développement, cite l’article suivant :
@article{griffin2007caltech,
         title={Caltech-256 object category dataset},
         author={Griffin, Gregory and Holub, Alex and Perona, Pietro},
         year={2007}
}
Nous tenons à remercier Gregory Griffin, Alex Holub et Pietro Perona d’avoir créé et maintenu le jeu de données Caltech-256, une ressource précieuse pour la communauté de recherche en apprentissage automatique et en vision par ordinateur. Pour en savoir plus sur le jeu de données Caltech-256 et ses créateurs, consulte le site web du jeu de données Caltech-256.
FAQ#
Le jeu de données Caltech-256 est largement utilisé pour entraîner et évaluer des modèles de classification d’images et de reconnaissance d’objets. Il contient 30 607 images réparties dans 256 catégories d’objets, auxquelles s’ajoute une classe d’arrière-plan. Il constitue un benchmark plus vaste et plus exigeant que Caltech-101 pour évaluer des algorithmes tels que les réseaux de neurones convolutifs (CNNs) et les machines à vecteurs de support (SVMs).
Pour entraîner un modèle Ultralytics YOLO sur Caltech-256, utilise les extraits de code ci-dessous. Le jeu de données est téléchargé automatiquement lors de sa première utilisation. Pour consulter la liste complète des arguments, reporte-toi à la page d’entraînement du modèle.
Exemple d’entraînementfrom ultralytics import YOLO # Charger un modèle model = YOLO("yolo26n-cls.pt") # charger un modèle préentraîné (recommandé pour l’entraînement) # Entraîner le modèle results = model.train(data="caltech256", epochs=100, imgsz=416)Caltech-256 contient 256 catégories d’objets et une classe d’arrière-plan
257.clutter, soit 257 dossiers de classes et 30 607 images au total. Lors de l’entraînement avec Ultralytics, le modèle apprend les 257 classes. Chaque catégorie contient au moins 80 images, mais la répartition entre les classes est déséquilibrée : la plus grande en compte environ 800.Caltech-256 ne dispose d’aucune répartition prédéfinie. Lors du premier entraînement, Ultralytics le répartit automatiquement entre 80 % pour l’entraînement et 20 % pour la validation — soit environ 24 385 images d’entraînement et 6 222 images de validation —, tu n’as donc pas besoin de créer les partitions manuellement. Pour contrôler toi-même la répartition, organise les images dans les dossiers
train/etval/avant l’entraînement.Oui. Ultralytics Platform te permet de gérer des jeux de données, d’entraîner des modèles de classification d’images et de les déployer sans avoir à écrire beaucoup de code. C’est une solution pratique pour mener des expériences sur Caltech-256 dans le cloud. Tu trouveras d’autres options dans notre aperçu des jeux de données de classification.