Dataset Roboflow 100#
Roboflow 100 (RF100), sponsorizzato da Intel, è un benchmark di rilevamento di oggetti composto da 100 dataset diversi. È progettato per verificare quanto bene i modelli di visione artificiale, come i modelli Ultralytics YOLO, si adattino a vari ambiti, tra cui l'assistenza sanitaria, le immagini aeree e i videogiochi.
Funzionalità principali#
- Ambiti diversi: include 100 dataset distribuiti in sette ambiti distinti: aereo, videogiochi, microscopico, subacqueo, documenti, elettromagnetico e mondo reale.
- Dimensioni: il benchmark comprende 224.714 immagini appartenenti a 805 classi e rappresenta oltre 11.170 ore di attività di etichettatura dei dati.
- Standardizzazione: tutte le immagini vengono preelaborate e ridimensionate a 640x640 pixel per garantire una valutazione coerente.
- Valutazione pulita: si concentra sull'eliminazione dell'ambiguità tra le classi ed esclude quelle sottorappresentate per garantire una valutazione del modello più chiara.
- Annotazioni: include riquadri per gli oggetti, adatti all'addestramento e alla valutazione dei modelli di rilevamento degli oggetti con metriche come mAP.
Struttura del dataset#
Il dataset Roboflow 100 è organizzato in sette categorie, ognuna delle quali contiene una raccolta esclusiva di dataset, immagini e classi:
- Aereo: 7 dataset, 9.683 immagini, 24 classi.
- Videogiochi: 7 dataset, 11.579 immagini, 88 classi.
- Microscopico: 11 dataset, 13.378 immagini, 28 classi.
- Subacqueo: 5 dataset, 18.003 immagini, 39 classi.
- Documenti: 8 dataset, 24.813 immagini, 90 classi.
- Elettromagnetico: 12 dataset, 36.381 immagini, 41 classi.
- Mondo reale: 50 dataset, 110.615 immagini, 495 classi.
Questa struttura offre un terreno di prova ampio e diversificato per i modelli di rilevamento degli oggetti e rispecchia un'ampia gamma di scenari applicativi reali presenti nelle varie soluzioni Ultralytics.
Benchmark#
Il benchmarking di un dataset consiste nel valutare le prestazioni dei modelli di apprendimento automatico su dataset specifici utilizzando metriche standardizzate. Tra le metriche più comuni figurano accuratezza, media della precisione media (mAP) e punteggio F1. Puoi approfondire questi argomenti nella nostra guida alle metriche di prestazione di YOLO.
Tutti i risultati vengono raggruppati in un'unica directory runs/<task>/multitrain/: ogni dataset viene sottoposto a fine-tuning nella propria sottodirectory (con il proprio results.png), mentre le metriche per dataset e quelle medie vengono salvate in multitrain_results.json, insieme a un grafico a barre multitrain_results.png. Anche la chiamata model.train() restituisce un dizionario {dataset: metrics} per l'accesso programmatico.
Lo script seguente scarica da Roboflow i dataset Roboflow 100 elencati in datasets_links.txt, quindi esegue il fine-tuning di un singolo modello di base (ad esempio, YOLO26n) sull'intera raccolta con un'unica chiamata model.train(). Passando un elenco di dataset, il modello di base viene sottoposto a fine-tuning su ciascun dataset in sequenza e i risultati tra i dataset vengono visualizzati automaticamente.
import re
from pathlib import Path

from roboflow import Roboflow

from ultralytics import YOLO
from ultralytics.utils import ASSETS_URL, LOGGER, YAML
from ultralytics.utils.downloads import safe_download

# Download the RF100 datasets (requires a Roboflow API key)
rf = Roboflow(api_key="YOUR_ROBOFLOW_API_KEY")
safe_download(f"{ASSETS_URL}/datasets_links.txt")  # list of RF100 dataset links

datasets = []
for line in Path("datasets_links.txt").read_text().splitlines():
    try:
        _, _url, workspace, project, version = re.split("/+", line.strip())
        location = f"rf-100/{project}-{version}"
        rf.workspace(workspace).project(project).version(version).download("yolov8", location=location)
        yaml = Path(location) / "data.yaml"
        cfg = YAML.load(yaml)  # point train/val at the downloaded image folders
        cfg["train"], cfg["val"] = "train/images", "valid/images"
        YAML.save(yaml, cfg)
        datasets.append(str(yaml))
    except Exception as e:
        LOGGER.warning(f"Failed to prepare dataset from {line!r}: {e}")

# Fine-tune one base model across all RF100 datasets and visualize the cross-dataset results
model = YOLO("yolo26n.pt")
results = model.train(data=datasets, epochs=100, imgsz=640)  # {dataset: metrics}

# Per-dataset runs, multitrain_results.json (per-dataset + mean), and multitrain_results.png are saved
# together under runs/detect/multitrain. Read results in-memory or from the JSON for custom post-processing.
for dataset, metrics in results.items():
    if metrics:  # None if that dataset failed to train
print(f"{dataset}: mAP50-95 = {metrics['metrics/mAP50-95(B)']:.4f}")Applicazioni#
Roboflow 100 è utile per un'ampia gamma di attività di visione artificiale e deep learning. Ricercatori e ingegneri possono usare questo benchmark per:
- Valutare le prestazioni dei modelli di rilevamento degli oggetti in un contesto multidominio.
- Verificare l'adattabilità e la robustezza dei modelli in scenari reali, andando oltre i comuni dataset benchmark come COCO o PASCAL VOC.
- Valutare le capacità dei modelli di rilevamento degli oggetti su dataset eterogenei, compresi ambiti specialistici come la sanità, le immagini aeree e i videogiochi.
- Confrontare le prestazioni dei modelli tra diverse architetture di reti neurali e tecniche di ottimizzazione.
- Individuare le sfide specifiche dei singoli ambiti che potrebbero richiedere consigli specializzati per l'addestramento dei modelli o approcci di fine-tuning come il transfer learning.
Utilizzo#
Il dataset Roboflow 100, con i relativi metadati e link per il download, è disponibile nel repository GitHub ufficiale di Roboflow 100. Dopo aver scaricato e preparato i dataset come indicato sopra, puoi eseguire il fine-tuning dei modelli Ultralytics sull'intera raccolta con un'unica chiamata model.train(), passando l'elenco dei file YAML dei dataset.
Dati di esempio e annotazioni#
Roboflow 100 comprende dataset con immagini eterogenee, acquisite da diverse angolazioni e in vari ambiti. Di seguito sono riportati alcuni esempi di immagini annotate incluse nel benchmark RF100, che illustrano la varietà di oggetti e scene. Tecniche come l'aumento dei dati possono ampliare ulteriormente la varietà durante l'addestramento.
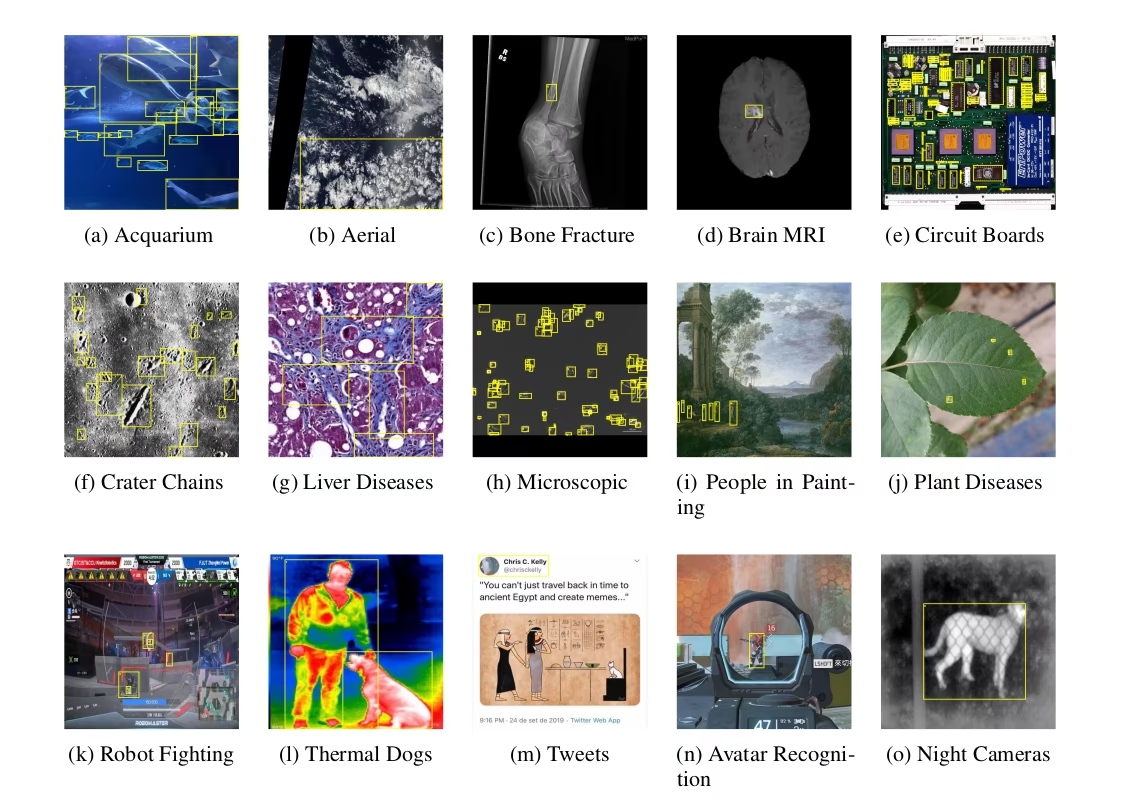
A differenza dei benchmark tradizionali, che spesso si concentrano sull'ottimizzazione di una singola metrica in un ambito limitato, Roboflow 100 copre molti ambiti. Questa varietà aiuta a sviluppare modelli di visione artificiale più robusti, capaci di funzionare bene in scenari molto diversi.
Citazioni e ringraziamenti#
Se utilizzi il dataset Roboflow 100 nelle tue attività di ricerca o sviluppo, cita l'articolo originale:
@misc{rf100benchmark,
    Author = {Floriana Ciaglia and Francesco Saverio Zuppichini and Paul Guerrie and Mark McQuade and Jacob Solawetz},
    Title = {Roboflow 100: A Rich, Multi-Domain Object Detection Benchmark},
    Year = {2022},
    Eprint = {arXiv:2211.13523},
    url = {https://arxiv.org/abs/2211.13523}
}
Ringraziamo il team Roboflow e tutti i collaboratori per l'impegno profuso nella creazione e nella manutenzione del dataset Roboflow 100, una risorsa preziosa per la comunità della visione artificiale.
Domande frequenti#
Il dataset Roboflow 100 è un benchmark per i modelli di rilevamento degli oggetti. Comprende 100 dataset eterogenei che coprono ambiti come la sanità, le immagini aeree e i videogiochi. La sua importanza deriva dal fatto che offre un metodo standardizzato per verificare adattabilità e robustezza dei modelli in un'ampia gamma di scenari reali, superando i benchmark tradizionali, spesso limitati a un singolo ambito.
Il dataset Roboflow 100 copre sette ambiti diversi e presenta sfide specifiche per i modelli di rilevamento di oggetti:
- Aereo: 7 dataset (ad esempio, immagini satellitari e viste da droni).
- Videogiochi: 7 dataset (ad esempio, oggetti provenienti da diversi ambienti di gioco).
- Microscopico: 11 dataset (ad esempio, cellule e particelle).
- Subacqueo: 5 dataset (ad esempio, fauna marina e oggetti sommersi).
- Documenti: 8 dataset (ad esempio, aree di testo ed elementi di moduli).
- Elettromagnetico: 12 dataset (ad esempio, segnali radar e visualizzazioni di dati spettrali).
- Mondo reale: 50 dataset (una categoria ampia che comprende oggetti di uso quotidiano, scene, commercio al dettaglio e altro).
Questa varietà rende RF100 un'ottima risorsa per valutare la generalizzabilità dei modelli di visione artificiale.
Quando utilizzi il dataset Roboflow 100, cita l'articolo originale per riconoscere il merito dei creatori. Ecco la citazione BibTeX consigliata:
Citazione@misc{rf100benchmark, Author = {Floriana Ciaglia and Francesco Saverio Zuppichini and Paul Guerrie and Mark McQuade and Jacob Solawetz}, Title = {Roboflow 100: A Rich, Multi-Domain Object Detection Benchmark}, Year = {2022}, Eprint = {arXiv:2211.13523}, url = {https://arxiv.org/abs/2211.13523} }