Dataset DOTA8
Introduzione#
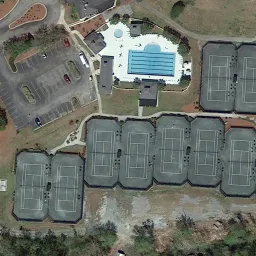
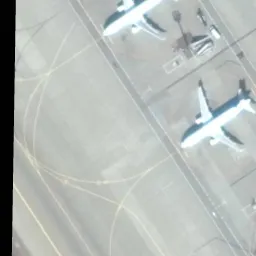
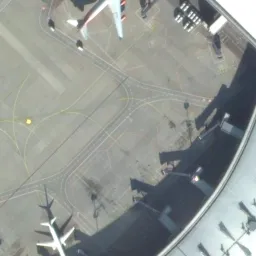
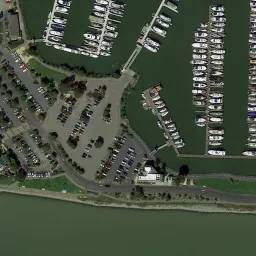
Ultralytics DOTA8 è un piccolo dataset di rilevamento orientato degli oggetti composto dalle prime 8 immagini del set DOTAv1 suddiviso: 4 per l'addestramento e 4 per la convalida. Il dataset Ultralytics è ideale per testare e correggere errori nei modelli di rilevamento degli oggetti o per sperimentare nuovi approcci di rilevamento. Con sole 8 immagini, è facile da gestire ma abbastanza vario da testare la presenza di errori nelle pipeline di addestramento e fungere da controllo di coerenza prima di addestrare dataset più grandi.
Struttura del dataset#
-
Immagini: 8 ritagli aerei (4 train, 4 val) provenienti da DOTAv1.
-
Classi: eredita le 15 categorie di DOTAv1, come aereo, nave e veicolo grande.
-
Etichette: riquadri di delimitazione orientati in formato YOLO, salvati in file
.txtaccanto a ciascuna immagine. -
Download: 1 MB, scaricato automaticamente dagli asset GitHub di Ultralytics al primo addestramento.
-
Struttura consigliata:
datasets/dota8/
├── images/
│   ├── train/
│   └── val/
└── labels/
    ├── train/
    └── val/
Esplora DOTA8 sulla piattaforma Ultralytics per sfogliare i ritagli aerei con le sovrapposizioni dei riquadri orientati, visualizzare la distribuzione delle classi e le mappe di calore delle annotazioni nella scheda Grafici e clonare il dataset per addestrare il tuo modello nel cloud.
YAML del dataset#
Per definire la configurazione del dataset si usa un file YAML. Il file contiene informazioni sui percorsi del dataset, sulle classi e su altri dettagli pertinenti. Per il dataset DOTA8, il file dota8.yaml è gestito in https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dota8.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# DOTA8 dataset (8 images from the DOTAv1 split) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/obb/dota8
# Example usage: yolo train model=yolov8n-obb.pt data=dota8.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── dota8 ← downloads here (1 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: dota8 # dataset root dir
train: images/train # train images (relative to 'path') 4 images
val: images/val # val images (relative to 'path') 4 images

# Classes for DOTA 1.0
names:
  0: plane
  1: ship
  2: storage tank
  3: baseball diamond
  4: tennis court
  5: basketball court
  6: ground track field
  7: harbor
  8: bridge
  9: large vehicle
  10: small vehicle
  11: helicopter
  12: roundabout
  13: soccer ball field
  14: swimming pool

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/dota8.zipUtilizzo#
Per addestrare un modello YOLO26n-obb sul dataset DOTA8 per 100 epoche con una dimensione delle immagini di 640, puoi usare i seguenti frammenti di codice.
from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n-obb.pt")  # carica un modello preaddestrato (consigliato per l'addestramento)

# Addestra il modello
results = model.train(data="dota8.yaml", epochs=100, imgsz=640)
Immagini di esempio e annotazioni#
Ecco alcuni esempi di immagini del dataset DOTA8, con le relative annotazioni:
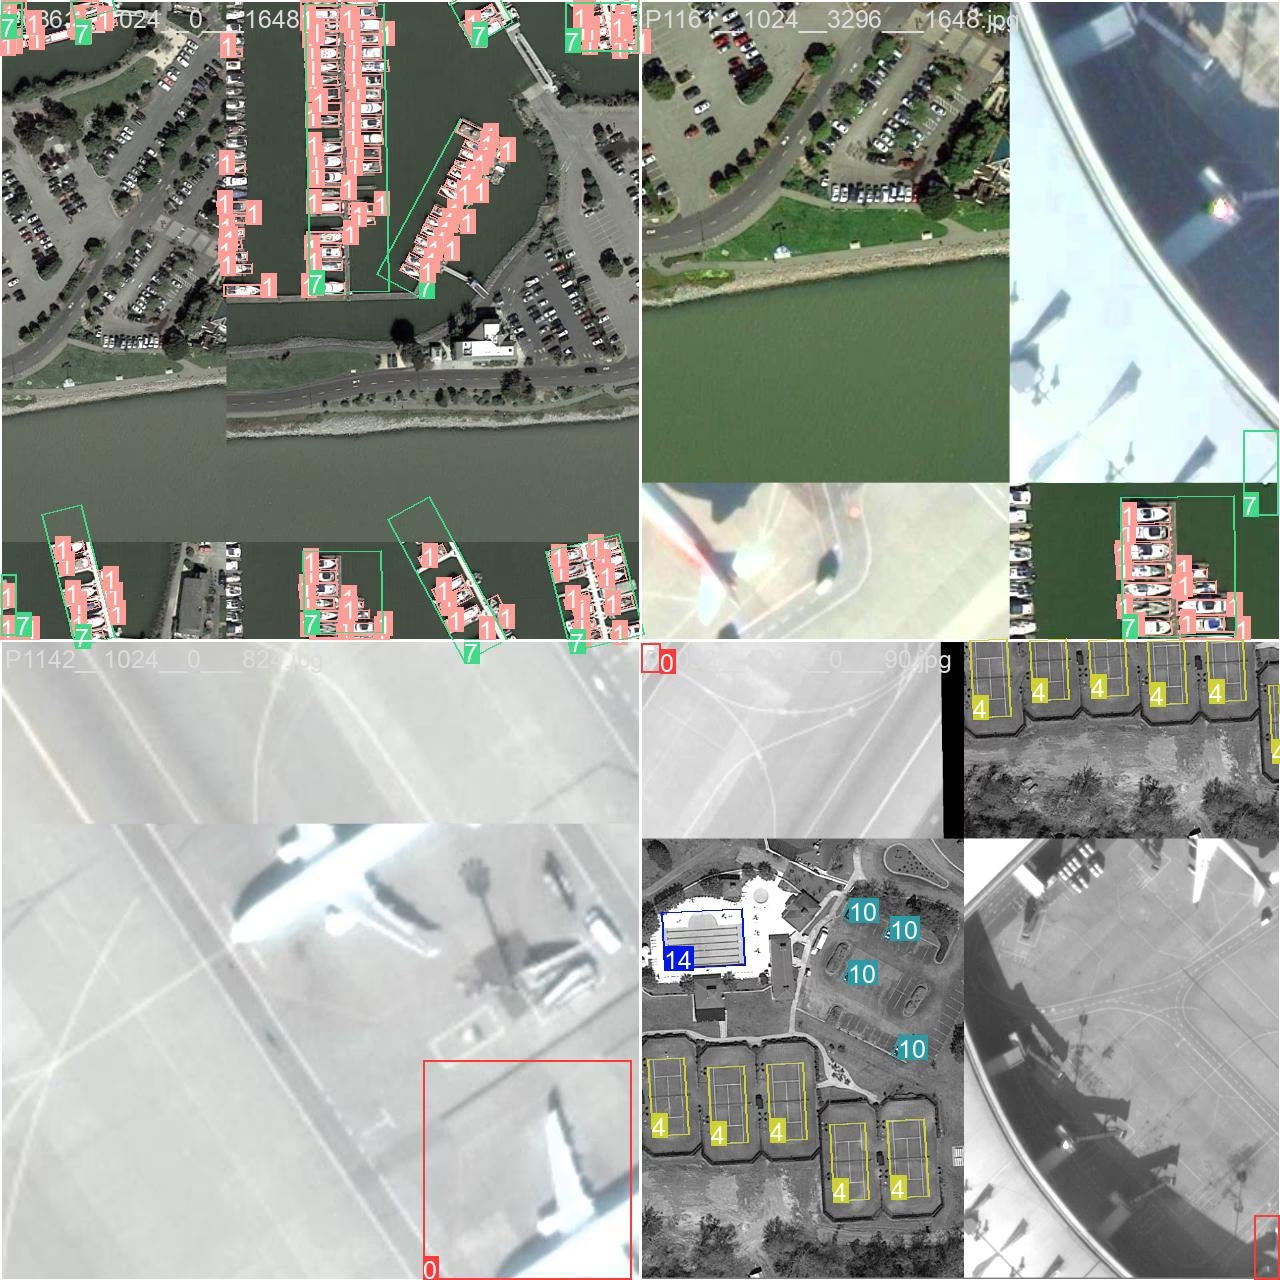
- Immagine a mosaico: questa immagine mostra un batch di addestramento composto da immagini del dataset unite in un mosaico. La creazione di mosaici è una tecnica utilizzata durante l'addestramento che combina più immagini in una sola per aumentare la varietà di oggetti e scene in ogni batch di addestramento. Questo aiuta a migliorare la capacità del modello di generalizzare a oggetti di dimensioni e proporzioni diverse e a contesti differenti.
L'esempio mostra la varietà e la complessità delle immagini nel dataset DOTA8 e i vantaggi dell'uso del mosaico durante l'addestramento.
Citazioni e ringraziamenti#
Se usi il dataset DOTA nel tuo lavoro di ricerca o sviluppo, cita il seguente articolo:
@article{9560031,
  author={Ding, Jian and Xue, Nan and Xia, Gui-Song and Bai, Xiang and Yang, Wen and Yang, Michael and Belongie, Serge and Luo, Jiebo and Datcu, Mihai and Pelillo, Marcello and Zhang, Liangpei},
  journal={IEEE Transactions on Pattern Analysis and Machine Intelligence},
  title={Object Detection in Aerial Images: A Large-Scale Benchmark and Challenges},
  year={2022},
  volume={44},
  number={11},
  pages={7778-7796},
  doi={10.1109/TPAMI.2021.3117983}
}
Ringraziamo il team che cura i dataset DOTA. Per tutti i dettagli sul dataset, visita il sito ufficiale di DOTA.
Domande frequenti#
Il dataset DOTA8 è un piccolo dataset di rilevamento orientato degli oggetti, composto dalle prime 8 immagini del set DOTAv1 suddiviso, con 4 immagini destinate all'addestramento e 4 alla convalida. È ideale per testare e correggere errori nei modelli di rilevamento degli oggetti come Ultralytics YOLO26. Grazie alle dimensioni gestibili e alla varietà, aiuta a individuare errori nelle pipeline e a eseguire controlli di coerenza prima dell'addestramento su dataset più grandi.
Per addestrare un modello YOLO26n-obb sul dataset DOTA8 per 100 epoche con una dimensione dell'immagine di 640, puoi usare i seguenti frammenti di codice. Per le opzioni complete degli argomenti, consulta la pagina Addestramento del modello.
Esempio di addestramentofrom ultralytics import YOLO # Carica un modello model = YOLO("yolo26n-obb.pt") # carica un modello preaddestrato (consigliato per l'addestramento) # Addestra il modello results = model.train(data="dota8.yaml", epochs=100, imgsz=640)Il dataset DOTA è noto per il suo benchmark su larga scala e per le sfide che pone al rilevamento degli oggetti nelle immagini aeree. Il sottoinsieme DOTA8 è un dataset più piccolo e gestibile, ideale per i test iniziali. Il file di configurazione
dota8.yaml, che contiene percorsi, classi e dettagli di configurazione, è mantenuto nel repository GitHub di Ultralytics.La mosaicatura combina più immagini in una durante l'addestramento, aumentando la varietà di oggetti e contesti in ogni batch. Questo migliora la capacità del modello di generalizzare a dimensioni diverse degli oggetti, rapporti d'aspetto e scene.
Ultralytics YOLO26 supporta il rilevamento degli oggetti in tempo reale, inclusi i riquadri di delimitazione orientati (OBB), e altre attività come la segmentazione delle istanze, tutto tramite un'unica pipeline di addestramento. I suoi modelli preaddestrati rendono efficiente la messa a punto.


Commenti2
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
expen6ve
How do you create a dataset for OBB? can i use the visdrone dataset to train an obb model?
 Glenn JocherUltralytics
@expen6ve yes, you can use VisDrone with YOLO OBB by converting your annotations to YOLO OBB format (four corner points with normalized coordinates). Create a dataset YAML file following our DOTA8 example structure, and ensure annotations match the required
class_index x1 y1 x2 y2 x3 y3 x4 y4format. For conversion tools and format details, see our OBB Dataset Guide.