Tecniche di pre-elaborazione dei dati annotati per la visione artificiale#
La pre-elaborazione dei dati trasforma le immagini grezze annotate negli input puliti e coerenti di cui un modello di visione artificiale ha bisogno per addestrarsi efficacemente. Con Ultralytics YOLO26, le operazioni fondamentali sui pixel — conversione RGB, ridimensionamento a [0, 1] e ridimensionamento delle immagini — vengono eseguite automaticamente nella pipeline di addestramento; il lavoro che resta consiste quindi nel suddividere correttamente il dataset, bilanciare le classi e scegliere le trasformazioni di aumento dei dati. Questa guida illustra queste tecniche essenziali: ridimensionamento, normalizzazione, suddivisione del dataset, aumento dei dati e analisi esplorativa dei dati (EDA).
Guarda: Come usare il preprocessing e l'aumento dei dati per migliorare la precisione dei modelli in scenari reali 🚀
Questo passaggio si svolge dopo aver definito gli obiettivi del tuo progetto e raccolto e annotato i tuoi dati, e si colloca nelle fasi iniziali del flusso di lavoro di un progetto di visione artificiale.
Perché la pre-elaborazione è importante#
La pre-elaborazione prepara i dati in un formato che riduce il carico computazionale e migliora le prestazioni del modello. Risolve tre problemi comuni dei dati grezzi:
- Rumore: variazioni irrilevanti o casuali nei dati.
- Incoerenza: differenze nelle dimensioni, nei formati e nella qualità delle immagini.
- Squilibrio: distribuzione disomogenea di classi o categorie nel dataset.
Tecniche di pre-elaborazione#
Le tecniche principali sono il ridimensionamento, la normalizzazione, la suddivisione del dataset e l'aumento dei dati. Con YOLO26, le prime due operazioni sono automatiche, mentre le scelte più importanti riguardano la suddivisione e l'aumento dei dati.
Ridimensionamento delle immagini#
Molti modelli richiedono una dimensione di input uniforme; il ridimensionamento rende quindi le immagini omogenee e riduce la complessità computazionale. Due metodi di interpolazione comuni sono:
- Interpolazione bilineare: attenua i valori dei pixel calcolando la media ponderata dei quattro pixel più vicini.
- Interpolazione del vicino più prossimo: copia il valore del pixel più vicino senza calcolare la media; è più rapida, ma produce immagini più sgranate.
Librerie come OpenCV e PIL (Pillow) forniscono queste funzioni, ma con YOLO26 in genere non devi ridimensionare manualmente le immagini. Se ne occupa l'argomento imgsz. Nel percorso a dimensione quadrata fissa, validazione e inferenza adattano le immagini con il letterboxing a un input imgsz × imgsz, come 640 × 640, mantenendo le proporzioni e aggiungendo padding grigio (valore 114). Le immagini più grandi vengono ridotte per adattarle, mentre quelle più piccole non vengono ingrandite se l'aumento di scala è disabilitato. Nel percorso predefinito di addestramento, invece, mosaic=1.0 dispone quattro immagini su una tela più grande e ritaglia l'immagine risultante a imgsz; quando close_mosaic disabilita il mosaico nelle ultime epoche, le immagini vengono adattate con il letterboxing e poi sottoposte comunque a trasformazioni casuali, anziché essere usate senza modifiche. I batch rettangolari (rect=True) e multi_scale usano forme di input diverse.
Normalizzazione dei valori dei pixel#
La normalizzazione ridimensiona i valori dei pixel a un intervallo standard, aiutando il modello a convergere più rapidamente durante l'addestramento. Due tecniche comuni sono:
- Ridimensionamento min-max: ridimensiona i valori dei pixel a un intervallo compreso tra 0 e 1.
- Normalizzazione z-score: ridimensiona i valori dei pixel in base alla media e alla deviazione standard.
YOLO26 gestisce automaticamente la normalizzazione nella propria pipeline di pre-elaborazione: converte le immagini in RGB e ridimensiona i valori dei pixel all'intervallo [0, 1] dividendoli per 255 (ridimensionamento min-max). Per impostazione predefinita, YOLO non applica la normalizzazione media/deviazione standard in stile ImageNet (z-score), quindi non è necessario alcun passaggio di normalizzazione manuale.
Suddivisione del dataset#
Suddividere i dati in set di addestramento, validazione e test ti permette di valutare il modello su dati mai visti e misurarne la generalizzazione. Una suddivisione comune prevede il 70% per l'addestramento, il 20% per la validazione e il 10% per il test. Strumenti come scikit-learn o TensorFlow rendono semplice questa operazione.
Tieni presenti questi aspetti quando suddividi i dati:
- Mantieni la distribuzione delle classi: assicurati che ciascuna classe sia rappresentata proporzionalmente nei set di addestramento, validazione e test.
- Bilancia le classi: se i dataset sono sbilanciati, valuta il sovracampionamento della classe minoritaria o il sottocampionamento di quella maggioritaria, ma solo nel set di addestramento.
Suddividi il dataset prima di applicare qualsiasi aumento dei dati o altra pre-elaborazione e applica queste trasformazioni solo al set di addestramento. Se aumenti i dati prima della suddivisione, le informazioni delle immagini di validazione o test possono influenzare l'addestramento, producendo punteggi fuorvianti che crollano con i dati del mondo reale.
Aumento dei dati del dataset#
L'aumento dei dati incrementa artificialmente le dimensioni di un dataset creando versioni modificate delle immagini esistenti. Aiuta a ridurre l'overfitting e migliora la generalizzazione, offrendo diversi vantaggi:
- Modelli più robusti: le variazioni di illuminazione, orientamento e scala rendono il modello più resistente alle distorsioni del mondo reale.
- Conveniente: ampli il set di addestramento senza raccogliere ed etichettare nuovi dati.
- Migliore utilizzo dei dati: ogni immagine annotata genera molteplici varianti di addestramento.
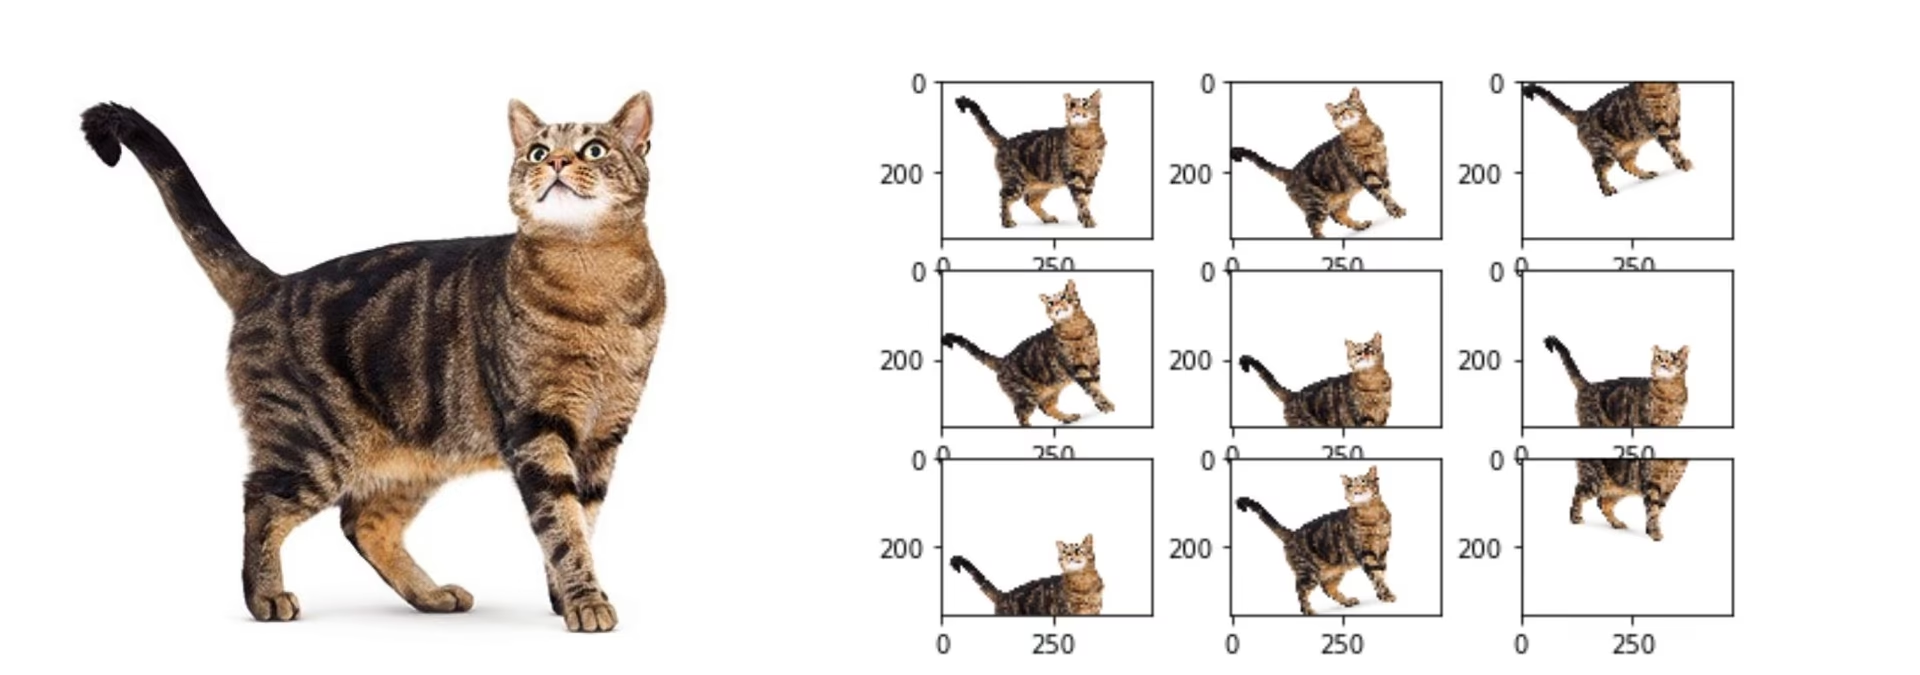
Con YOLO26, l'intensità dell'aumento dei dati si controlla tramite gli argomenti di addestramento passati a model.train() o tramite i flag CLI equivalenti, non modificando il file YAML del dataset, che definisce metadati come percorsi, nomi delle classi e suddivisioni. L'unica eccezione è flip_idx: i dataset di pose lo dichiarano nel file YAML del dataset per mappare le coppie di punti chiave sinistra/destra e, se manca, YOLO disabilita del tutto fliplr e flipud. Le trasformazioni di aumento dei dati integrate includono:
- Mosaico, MixUp e CutMix (
mosaic,mixup,cutmix): combinano più immagini in un unico campione di addestramento. - Ribaltamenti (
fliplr,flipud): riflettono le immagini orizzontalmente o verticalmente. - Trasformazioni geometriche (
degrees,translate,scale,shear,perspective): ruotano, traslano, ingrandiscono e deformano le immagini. - Variazioni cromatiche HSV (
hsv_h,hsv_s,hsv_v): modificano tonalità, saturazione e luminosità. - Copia e incolla (
copy_paste): incolla copie aggiuntive di oggetti segmentati, specchiandole per impostazione predefinita all'interno della stessa immagine oppure prelevandole da un'altra immagine concopy_paste_mode=mixup. - Scambio dei canali (
bgr): scambia l'ordine dei canali RGB con BGR. - Trasformazioni per la classificazione (
auto_augment,erasing): applicano una politica automatica di aumento dei dati e la cancellazione casuale durante l'addestramento di un classificatore.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# L'aumento dei dati si configura tramite gli argomenti di addestramento, non nel file YAML del dataset
model.train(data="coco8.yaml", epochs=10, hsv_h=0.015, fliplr=0.5, mosaic=1.0, degrees=10.0)
Per l'elenco completo degli argomenti di aumento dei dati e dei relativi valori predefiniti, consulta il riferimento alle impostazioni di aumento dei dati e la guida dedicata all'aumento dei dati in YOLO. Se è installato il pacchetto albumentations, YOLO attiva automaticamente anche le trasformazioni integrate basate su Albumentations.
Caso di studio: pre-elaborazione per il rilevamento dei veicoli#
Immagina un progetto che usa YOLO26 per rilevare e classificare veicoli nelle immagini del traffico, partendo da immagini annotate con riquadri di delimitazione ed etichette. Ecco come si presenta ciascuna decisione di pre-elaborazione:
- Ridimensionamento: nessun intervento manuale; YOLO26 ridimensiona le immagini a
imgszdurante l'addestramento. - Normalizzazione: nessun intervento manuale; YOLO26 ridimensiona automaticamente i valori dei pixel a
[0, 1]. - Suddivisione: suddividi il dataset in 70% per l'addestramento, 20% per la validazione e 10% per il test, mantenendo coerente la distribuzione delle classi tra le suddivisioni.
- Aumento dei dati: imposta argomenti di addestramento adatti alle scene di traffico, per esempio
fliplrper l'invarianza direzionale,hsv_vper l'illuminazione diurna e notturna emosaicper densità variabili degli oggetti.
Una volta definite queste scelte, il dataset è pronto per l'analisi esplorativa dei dati (EDA).
Analisi esplorativa dei dati (EDA)#
L'EDA usa statistiche e visualizzazioni per rivelare schemi e distribuzioni nei dati, aiutandoti a individuare problemi come lo squilibrio tra classi o i valori anomali prima dell'addestramento.
Tecniche statistiche di EDA#
L'EDA statistica parte da metriche di base — media, mediana, deviazione standard e intervallo — calcolate su proprietà come la distribuzione dell'intensità dei pixel. Queste metriche forniscono una rapida panoramica della qualità del dataset e fanno emergere presto eventuali irregolarità.
Tecniche di EDA visiva#
Le visualizzazioni rivelano schemi che le statistiche riassuntive non mostrano, come lo squilibrio tra classi e i valori anomali. Tra gli strumenti più comuni troviamo:
- Istogrammi e diagrammi a scatola e baffi: mostrano la distribuzione dei valori dei pixel e segnalano valori anomali nelle distribuzioni dell'intensità o delle caratteristiche.
- Grafici a barre: rivelano lo squilibrio tra classi confrontando il numero di esempi di ciascuna classe.
- Grafici a dispersione: esplorano le relazioni tra caratteristiche delle immagini o annotazioni.
- Mappe di calore: visualizzano la distribuzione dell'intensità dei pixel o la distribuzione spaziale delle annotazioni nelle immagini.
Ultralytics Platform per l'EDA#
Per eseguire l'EDA senza scrivere codice, carica il tuo dataset su Ultralytics Platform. La scheda Charts del dataset genera automaticamente visualizzazioni EDA fondamentali: distribuzione delle suddivisioni, conteggio delle classi più frequenti, istogrammi di larghezza e altezza delle immagini e mappe di calore 2D delle posizioni delle annotazioni e delle dimensioni delle immagini. La scheda Images ti permette di esplorare i dati in una griglia, in modalità compatta o in una tabella, con sovrapposizioni delle annotazioni; è così facile individuare esempi etichettati in modo errato o classi sbilanciate senza scrivere codice.
Conclusione#
Suddividere, normalizzare e aumentare correttamente i dati riduce il rumore e migliora la generalizzazione, trasformando una raccolta grezza di immagini in un set di addestramento affidabile. Una volta completata la pre-elaborazione del dataset, il passaggio successivo è addestrare il tuo modello. Se hai domande, chiedi alla community nel repository GitHub di Ultralytics o nel server Discord di Ultralytics.
Domande frequenti#
La pre-elaborazione assicura che i dati siano puliti, coerenti e in un formato ottimizzato per l'addestramento. Affrontando il rumore, l'incoerenza e lo squilibrio tra classi nei dati grezzi, passaggi come il ridimensionamento, la normalizzazione, l'aumento dei dati e la suddivisione del dataset riducono il carico computazionale e migliorano le prestazioni del modello. Consulta i passaggi di un progetto di visione artificiale per scoprire come si inserisce nel flusso di lavoro complessivo.
Configura l'aumento dei dati tramite gli argomenti di addestramento anziché nel file YAML del dataset. Passa a
model.train()argomenti comefliplr,mosaic,hsv_hedegrees(o i flag CLI equivalenti) per impostare la probabilità e l'intensità di ciascuna trasformazione. Gli argomenti sono elencati nelle impostazioni di aumento dei dati e descritti nella guida all'aumento dei dati in YOLO. I dataset di pose fanno eccezione: la mappatura dei punti chiaveflip_idxsi trova nel file YAML del dataset e, se manca, i ribaltamenti vengono disabilitati.Le due tecniche più comuni sono il ridimensionamento min-max (che riporta i pixel a un intervallo compreso tra 0 e 1) e la normalizzazione z-score (che ridimensiona i valori in base alla media e alla deviazione standard). YOLO26 applica automaticamente il ridimensionamento min-max — converte le immagini in RGB e divide i valori dei pixel per 255 — quindi non è necessario normalizzare manualmente i dati. Per impostazione predefinita, non applica la normalizzazione z-score.
Una suddivisione comune prevede il 70% per l'addestramento, il 20% per la validazione e il 10% per il test. Mantieni la distribuzione delle classi in tutte e tre le suddivisioni ed evita la contaminazione dei dati applicando l'aumento dei dati solo al set di addestramento, dopo la suddivisione. Strumenti come scikit-learn o TensorFlow gestiscono la suddivisione in modo efficiente. Consulta la guida alla raccolta e all'annotazione dei dati per la preparazione preliminare del dataset.
Sì. L'argomento
imgszcontrolla la dimensione di input desiderata senza bisogno di interventi manuali. Nel percorso a dimensione quadrata fissa, validazione e inferenza adattano le immagini alla forma specificata con il letterboxing, mantenendo le proporzioni; le immagini più grandi vengono ridotte per adattarle, mentre quelle più piccole non vengono ingrandite se l'aumento di scala è disabilitato. Durante l'addestramento, l'aumento dei dati con mosaico, attivo per impostazione predefinita, raggiunge la dimensione desiderata disponendo quattro immagini in mosaico e ritagliandole. I batch rettangolari (rect=True) emulti_scaleusano forme di input diverse. Per maggiori dettagli, consulta la documentazione sull'addestramento dei modelli.