Comprendere i passaggi fondamentali di un progetto di computer vision#
Realizzare un progetto di computer vision significa seguire una chiara sequenza di fasi: definire gli obiettivi, raccogliere e annotare i dati, addestrare e valutare un modello, quindi distribuirlo e mantenerlo in produzione. Questa guida illustra ogni passaggio nell'ordine e ne spiega l'importanza, così puoi pianificare e gestire il tuo progetto con sicurezza.
La computer vision è una branca dell'intelligenza artificiale (AI) che aiuta i computer a vedere e comprendere il mondo come fanno gli esseri umani. Elabora e analizza immagini o video per estrarre informazioni, riconoscere schemi e prendere decisioni basate su quei dati.
Le tecniche di computer vision, come il rilevamento degli oggetti, la classificazione delle immagini e la segmentazione delle istanze, possono essere applicate in vari settori, dalla guida autonoma all'imaging medico, per ottenere informazioni preziose.
Panoramica di un progetto di computer vision#
Prima di esaminare nel dettaglio ogni passaggio di un progetto di computer vision, diamo uno sguardo al processo complessivo. Se iniziassi oggi un progetto di computer vision, seguiresti questi passaggi:
- La tua prima priorità è comprendere i requisiti del tuo progetto.
- Poi raccogli e annoti accuratamente le immagini che serviranno ad addestrare il modello.
- Quindi ripulisci e aumenti i tuoi dati per prepararli all'addestramento del modello.
- Dopo l'addestramento, valuti e testi accuratamente il modello per assicurarti che offra prestazioni costanti in condizioni diverse.
- Infine, distribuisci il modello nel mondo reale e lo monitori e mantieni sulla base di nuove informazioni e feedback.
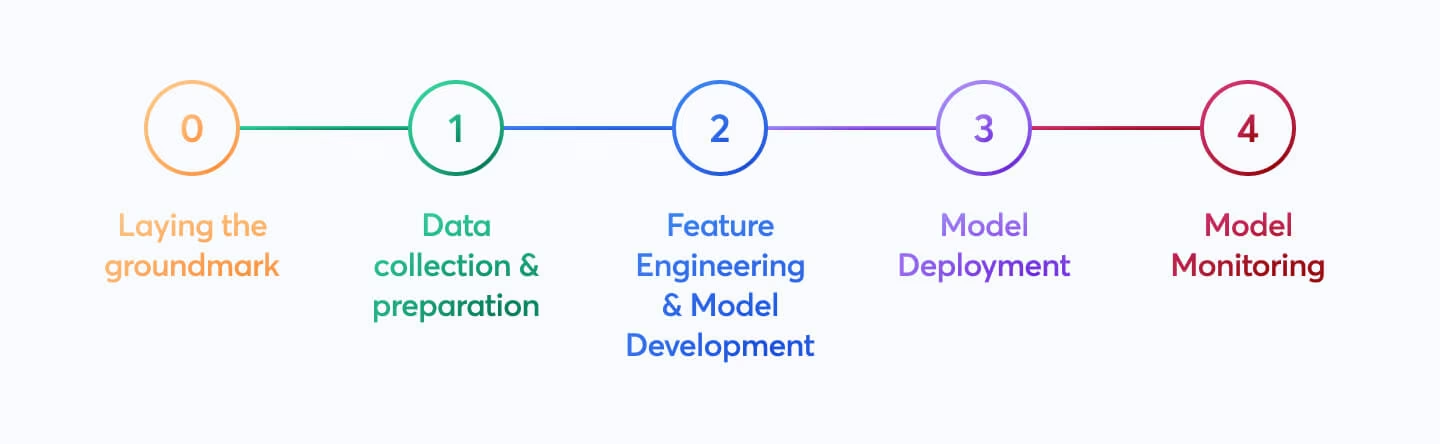
Ora che sappiamo cosa aspettarci, entriamo nel vivo dei passaggi e portiamo avanti il progetto.
Passaggio 1: definire gli obiettivi del progetto#
Il primo passaggio di qualsiasi progetto di computer vision consiste nel definire chiaramente il problema da risolvere. Conoscere l'obiettivo finale ti aiuta a iniziare a costruire una soluzione. Questo è particolarmente importante nella computer vision, perché l'obiettivo del progetto influisce direttamente sul task di computer vision su cui dovrai concentrarti.
Ecco alcuni esempi di obiettivi di progetto e dei task di computer vision che possono essere utilizzati per raggiungerli:
-
Obiettivo: sviluppare un sistema in grado di monitorare e gestire il flusso di diversi tipi di veicoli sulle autostrade, migliorando la gestione del traffico e la sicurezza.
- Task di computer vision: il rilevamento degli oggetti è ideale per il monitoraggio del traffico, perché individua e identifica in modo efficiente più veicoli. Richiede meno risorse computazionali della segmentazione delle immagini, che fornirebbe dettagli non necessari per questo task, consentendo un'analisi più rapida in tempo reale.
-
Obiettivo: sviluppare uno strumento che assista i radiologi fornendo contorni precisi, a livello di pixel, dei tumori nelle scansioni di imaging medico.
- Attività di visione artificiale: la segmentazione delle immagini è adatta all'imaging medico perché fornisce contorni accurati e dettagliati dei tumori, fondamentali per valutarne le dimensioni e la forma e pianificare il trattamento.
-
Obiettivo: creare un sistema digitale che classifichi diversi documenti (ad es. fatture, ricevute, documenti legali) per migliorare l'efficienza organizzativa e il reperimento dei documenti.
- Attività di visione artificiale: la classificazione delle immagini è ideale in questo caso, perché elabora un documento alla volta senza doverne considerare la posizione nell'immagine. Questo approccio semplifica e accelera il processo di smistamento.
Scegliere il modello e l'approccio di addestramento giusti#
Dopo aver compreso l'obiettivo del progetto e le attività di visione artificiale più adatte, una parte essenziale della definizione dell'obiettivo consiste nel selezionare il modello giusto e l'approccio di addestramento.
A seconda dell'obiettivo, potresti scegliere il modello prima oppure dopo aver visto quali dati riesci a raccogliere nel Passaggio 2. Per esempio, se il tuo progetto dipende molto dalla disponibilità di specifici tipi di dati, potrebbe essere più pratico raccogliere e analizzare i dati prima di selezionare un modello. Se invece conosci chiaramente i requisiti del modello, puoi scegliere prima il modello e poi raccogliere dati che soddisfino tali specifiche.
Scegliere se addestrare un modello da zero o usare il transfer learning influisce sulla preparazione dei dati. L'addestramento da zero richiede un dataset diversificato per costruire da zero le conoscenze del modello. Il transfer learning, invece, ti permette di usare un modello preaddestrato e adattarlo con un dataset più piccolo e specifico. Inoltre, la scelta di un modello specifico da addestrare determina come preparare i dati, ad esempio ridimensionando le immagini o aggiungendo annotazioni, in base ai requisiti del modello.
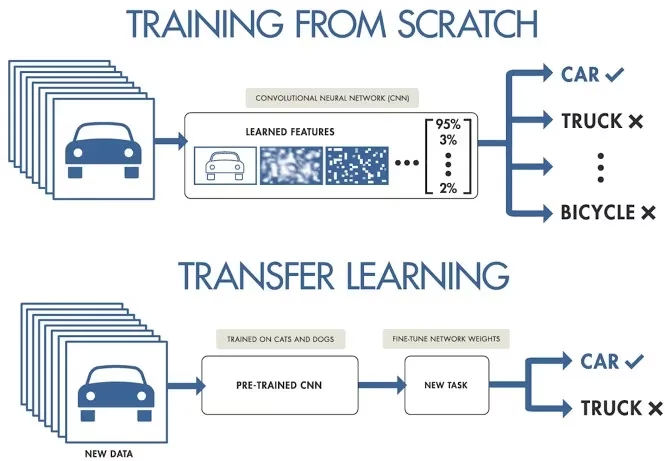
Considera la destinazione di distribuzione di un modello per garantirne compatibilità e prestazioni. Per esempio, i modelli leggeri sono ideali per l'edge computing, grazie alla loro efficienza sui dispositivi con risorse limitate.
Per saperne di più, leggi la nostra guida su come definire gli obiettivi del progetto e selezionare il modello giusto.
Prima di passare alla parte pratica di un progetto di visione artificiale, è importante avere le idee chiare su questi aspetti. Prima di procedere al Passaggio 2, verifica di aver considerato quanto segue:
- Definisci chiaramente il problema che vuoi risolvere.
- Determina l'obiettivo finale del progetto.
- Individua l'attività specifica di visione artificiale necessaria (ad es. rilevamento degli oggetti, classificazione delle immagini, segmentazione delle immagini).
- Decidi se addestrare un modello da zero o usare il transfer learning.
- Seleziona il modello adatto all'attività e alle esigenze di distribuzione.
Passaggio 2: raccolta e annotazione dei dati#
La qualità dei modelli di visione artificiale dipende dalla qualità del dataset. Puoi raccogliere immagini da Internet, scattare foto tu stesso oppure usare dataset già esistenti. Ecco alcune ottime risorse da cui scaricare dataset di alta qualità: Google Dataset Search Engine, UC Irvine Machine Learning Repository e Kaggle Datasets.
Alcune librerie, come Ultralytics, offrono supporto integrato per diversi dataset, facilitando l'avvio con dati di alta qualità. Spesso queste librerie includono utilità che consentono di usare senza difficoltà dataset popolari, facendoti risparmiare tempo e lavoro nelle fasi iniziali del progetto.
Se però scegli di raccogliere immagini o scattare foto tu stesso, dovrai annotare i dati. L'annotazione dei dati consiste nell'assegnare etichette ai dati per fornire informazioni al modello. Il tipo di annotazione da usare dipende dalla specifica tecnica di visione artificiale. Ecco alcuni esempi:
- Classificazione delle immagini: assegnerai un'unica classe all'intera immagine.
- Rilevamento degli oggetti: disegnerai riquadri di delimitazione attorno a ogni oggetto nell'immagine e assegnerai un'etichetta a ciascun riquadro.
- Segmentazione delle immagini: assegnerai a ogni pixel dell'immagine un'etichetta in base all'oggetto a cui appartiene, creando contorni dettagliati degli oggetti.
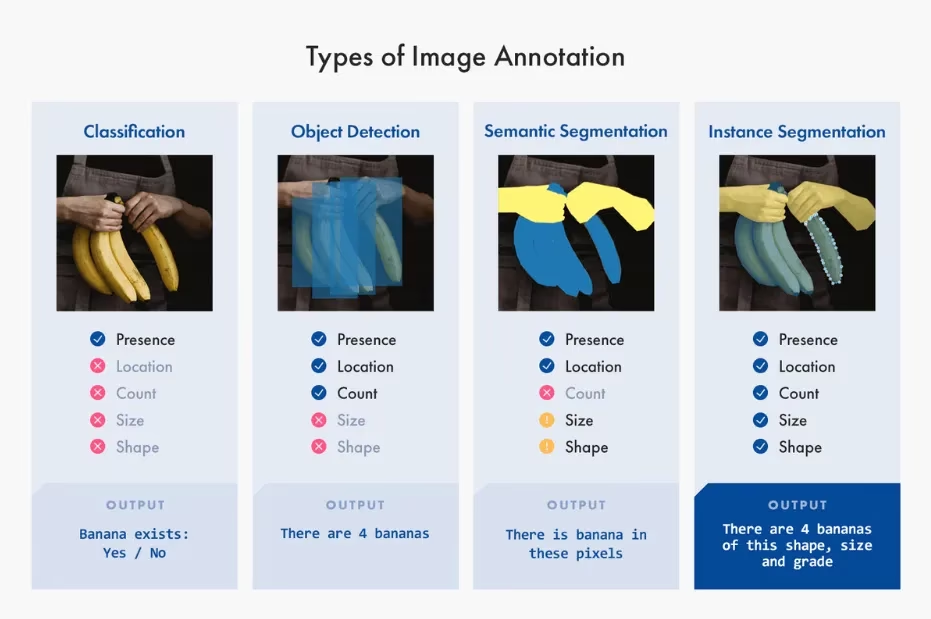
La raccolta e annotazione dei dati può richiedere molto tempo se svolta manualmente. Uno strumento di annotazione dedicato velocizza il lavoro: Ultralytics Platform offre un editor di annotazioni integrato con annotazione intelligente basata su SAM per dati di rilevamento, segmentazione e OBB, salvando le etichette direttamente in formato YOLO.
Passaggio 3: aumento dei dati e suddivisione del dataset#
Dopo aver raccolto e annotato le immagini, è importante suddividere prima il dataset in set di addestramento, convalida e test, quindi eseguire l'aumento dei dati. Suddividere il dataset prima dell'aumento è fondamentale per testare e convalidare il modello su dati originali e non modificati. Questo ti permette di valutare con precisione quanto bene il modello generalizza su dati nuovi e mai visti.
Ecco come suddividere i dati:
- Set di addestramento: è la porzione più ampia dei dati, in genere il 70-80% del totale, usata per addestrare il modello.
- Set di convalida: solitamente rappresenta circa il 10-15% dei dati; viene usato per ottimizzare gli iperparametri e convalidare il modello durante l'addestramento, contribuendo a prevenire l'overfitting.
- Set di test: il restante 10-15% dei dati viene riservato al set di test. Serve a valutare le prestazioni del modello su dati mai visti, al termine dell'addestramento.
Dopo aver suddiviso i dati, puoi eseguire l'aumento dei dati applicando trasformazioni come rotazione, ridimensionamento e ribaltamento delle immagini per aumentare artificialmente le dimensioni del dataset. L'aumento dei dati rende il modello più robusto alle variazioni e ne migliora le prestazioni su immagini mai viste.
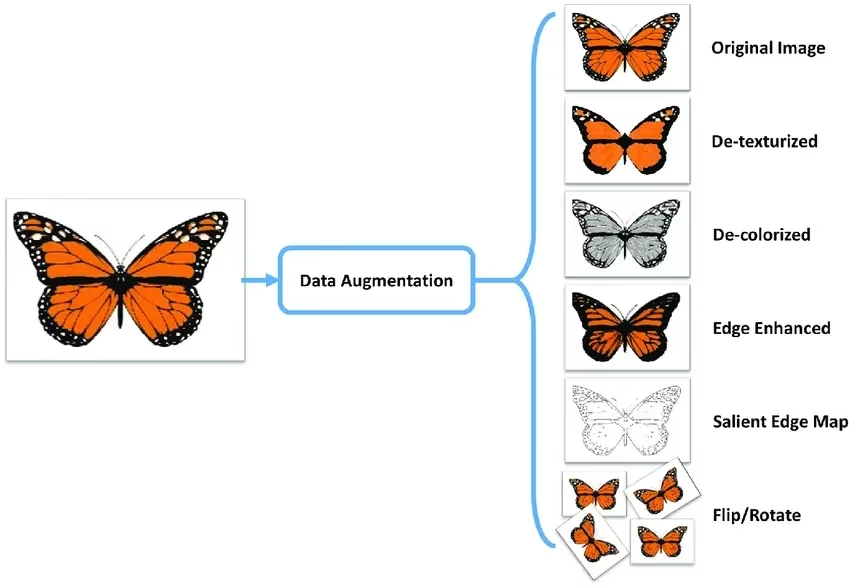
Librerie come OpenCV, Albumentations e TensorFlow offrono funzioni flessibili per l'aumento dei dati. Inoltre, alcune librerie, come Ultralytics, includono impostazioni integrate per l'aumento dei dati direttamente nella funzione di addestramento del modello, semplificando il processo.
Per comprendere meglio i dati, puoi usare strumenti come Matplotlib o Seaborn per visualizzare le immagini e analizzarne la distribuzione e le caratteristiche. La visualizzazione dei dati aiuta a individuare schemi, anomalie e l'efficacia delle tecniche di aumento. La scheda Charts di Ultralytics Platform può mostrare molti di questi risultati senza scrivere codice, generando automaticamente, per ogni dataset caricato, la distribuzione delle suddivisioni, il conteggio delle classi, gli istogrammi delle dimensioni delle immagini e le mappe di calore della posizione delle annotazioni.
Comprendendo, suddividendo e aumentando correttamente i dati, puoi sviluppare un modello ben addestrato, convalidato e testato, che offre buone prestazioni nelle applicazioni del mondo reale.
Passaggio 4: addestramento del modello#
Quando il dataset è pronto per l'addestramento, puoi concentrarti sulla configurazione dell'ambiente necessario, sulla gestione dei dataset e sull'addestramento del modello.
Per prima cosa, dovrai assicurarti che l'ambiente sia configurato correttamente. In genere, questo comporta quanto segue:
- Installare librerie e framework essenziali come TensorFlow, PyTorch o Ultralytics.
- Se usi una GPU, installare librerie come CUDA e cuDNN ti aiuterà ad abilitare l'accelerazione GPU e a velocizzare l'addestramento.
Poi puoi caricare i dataset di addestramento e convalida nell'ambiente. Normalizza e preprocessa i dati ridimensionandoli, convertendone il formato o applicando l'aumento. Dopo aver selezionato il modello, configura i livelli e specifica gli iperparametri. Compila il modello impostando la funzione di perdita, l'ottimizzatore e le metriche di prestazione.
Librerie come Ultralytics semplificano l'addestramento. Puoi avviare l'addestramento fornendo i dati al modello con pochissimo codice. Queste librerie gestiscono automaticamente la regolazione dei pesi, la retropropagazione e la convalida. Offrono anche strumenti per monitorare i progressi e regolare facilmente gli iperparametri. Al termine dell'addestramento, puoi salvare il modello e i relativi pesi con pochi comandi.
È importante ricordare che una corretta gestione dei dataset è fondamentale per un addestramento efficiente. Usa il controllo delle versioni dei dataset per tenere traccia delle modifiche e garantire la riproducibilità. Strumenti come DVC (controllo delle versioni dei dati) possono aiutarti a gestire dataset di grandi dimensioni.
Passaggio 5: valutazione e perfezionamento del modello#
È importante valutare le prestazioni del modello usando diverse metriche e perfezionarlo per migliorarne l'accuratezza. La valutazione aiuta a individuare gli ambiti in cui il modello eccelle e quelli che potrebbero richiedere miglioramenti. Il perfezionamento garantisce che il modello sia ottimizzato per ottenere le migliori prestazioni possibili.
- Metriche di prestazione: usa metriche come accuratezza, precisione, richiamo e punteggio F1 per valutare le prestazioni del modello. Queste metriche forniscono indicazioni sulla qualità delle previsioni del modello.
- Ottimizzazione degli iperparametri: regola gli iperparametri per ottimizzare le prestazioni del modello. Tecniche come la ricerca a griglia o casuale possono aiutarti a trovare i valori migliori per gli iperparametri.
- Perfezionamento: apporta piccole modifiche all'architettura del modello o al processo di addestramento per migliorarne le prestazioni. Potrebbe essere necessario ritoccare i tassi di apprendimento, le dimensioni dei batch o altri parametri del modello.
Per approfondire la valutazione dei modelli e le tecniche di perfezionamento, consulta la nostra guida agli approfondimenti sulla valutazione dei modelli.
Passaggio 6: test del modello#
Il test del modello conferma che il modello funziona bene su dati completamente nuovi e verifica che sia pronto per la distribuzione. La differenza tra test e valutazione del modello è che il test verifica le prestazioni del modello finale, invece di migliorarle iterativamente.
È importante testare accuratamente il modello ed eseguire il debug degli eventuali problemi comuni. Testa il modello su un dataset di test separato, non usato durante l'addestramento o la convalida. Questo dataset dovrebbe rappresentare scenari del mondo reale per assicurare prestazioni costanti e affidabili.
Inoltre, affronta problemi comuni come overfitting, underfitting e perdita di dati. Usa tecniche come la convalida incrociata e il rilevamento delle anomalie per individuare e risolvere questi problemi. Per strategie di test complete, consulta la nostra guida al test dei modelli.
Passaggio 7: distribuzione del modello#
Dopo aver testato accuratamente il modello, è il momento di distribuirlo. La distribuzione del modello consiste nel renderlo disponibile in un ambiente di produzione. Ecco i passaggi per distribuire un modello di visione artificiale:
- Configurazione dell'ambiente: configura l'infrastruttura necessaria per l'opzione di distribuzione scelta, sia essa basata sul cloud (AWS, Google Cloud, Azure) o sull'edge (dispositivi locali, IoT).
- Esportazione del modello: esporta il modello nel formato appropriato (ad es. ONNX, TensorRT, CoreML per YOLO26) per garantirne la compatibilità con la piattaforma di distribuzione.
- Distribuzione del modello: distribuisci il modello configurando API o endpoint e integrandolo nell'applicazione.
- Garanzia di scalabilità: implementa bilanciatori del carico, gruppi di scalabilità automatica e strumenti di monitoraggio per gestire le risorse e far fronte all'aumento dei dati e delle richieste degli utenti.
Per indicazioni più dettagliate sulle strategie di distribuzione e sulle procedure consigliate, consulta la nostra guida alle procedure di distribuzione dei modelli. Ultralytics Platform offre anche endpoint di distribuzione gestiti, con scalabilità automatica in 42 regioni globali e configurazione automatica dell'infrastruttura.
Passaggio 8: monitoraggio, manutenzione e documentazione#
Dopo aver distribuito il modello, è importante monitorarne continuamente le prestazioni, mantenerlo per risolvere eventuali problemi e documentare l'intero processo per future consultazioni e miglioramenti.
Gli strumenti di monitoraggio possono aiutarti a tenere traccia degli indicatori chiave di prestazione (KPI) e a rilevare anomalie o cali di accuratezza. Monitorando il modello, puoi rilevare la deriva del modello, cioè il calo delle prestazioni nel tempo dovuto a cambiamenti nei dati di input. Riaddestra periodicamente il modello con dati aggiornati per mantenerne l'accuratezza e la pertinenza.
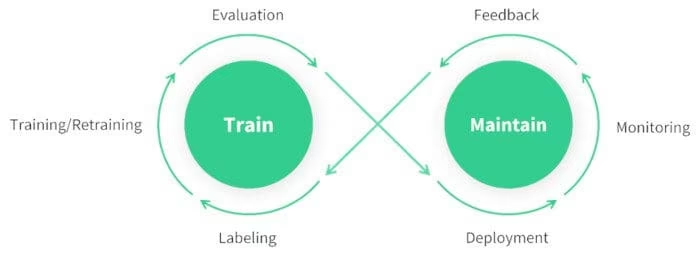
Oltre al monitoraggio e alla manutenzione, anche la documentazione è fondamentale. Documenta accuratamente l'intero processo, compresi l'architettura del modello, le procedure di addestramento, gli iperparametri, i passaggi di preprocessamento dei dati e tutte le modifiche apportate durante la distribuzione e la manutenzione. Una buona documentazione garantisce la riproducibilità e semplifica gli aggiornamenti futuri e la risoluzione dei problemi. Monitorando, mantenendo e documentando efficacemente il modello, puoi assicurarti che resti accurato, affidabile e facile da gestire durante tutto il suo ciclo di vita.
Partecipare alla community#
Entrare in contatto con una community di appassionati di visione artificiale può aiutarti ad affrontare con sicurezza i problemi che incontri nel tuo progetto. Ecco alcuni modi per imparare, risolvere problemi e ampliare la tua rete di contatti.
Risorse della community#
- Problemi su GitHub: visita il repository GitHub di YOLO26 e usa la scheda Issues per porre domande, segnalare bug e suggerire nuove funzionalità. La community attiva e i responsabili del progetto sono a disposizione per aiutarti con problemi specifici.
- Server Discord di Ultralytics: unisciti al server Discord di Ultralytics per interagire con altri utenti e sviluppatori, ricevere assistenza e condividere informazioni.
Documentazione ufficiale#
- Documentazione di Ultralytics YOLO26: consulta la documentazione ufficiale di YOLO26 per guide dettagliate con consigli utili su diversi progetti e attività di visione artificiale.
Queste risorse ti aiuteranno a superare le difficoltà e a rimanere aggiornato sulle ultime tendenze e sulle procedure consigliate nella community della visione artificiale.
Prossimi passaggi#
Ora hai una tabella di marcia per ogni fase di un progetto di visione artificiale, dalla definizione degli obiettivi al monitoraggio di un modello distribuito. Mettila in pratica addestrando il tuo primo modello YOLO oppure approfondisci una singola fase consultando le guide riportate sopra. Per eseguire l'intera pipeline senza scrivere codice, esplora Ultralytics Platform.
Domande frequenti#
La scelta dell'attività di visione artificiale giusta dipende dall'obiettivo finale del progetto. Per esempio, se vuoi monitorare il traffico, il rilevamento degli oggetti è adatto perché può localizzare e identificare diversi tipi di veicoli in tempo reale. Per l'imaging medico, la segmentazione delle immagini è ideale per delineare in dettaglio i tumori e aiutare nella diagnosi e nella pianificazione del trattamento. Scopri di più su attività specifiche come il rilevamento degli oggetti, la segmentazione di istanze, la segmentazione semantica e la classificazione delle immagini.
L'annotazione dei dati è fondamentale per insegnare al modello a riconoscere gli schemi. Il tipo di annotazione varia in base all'attività:
- Classificazione delle immagini: l'intera immagine viene etichettata con un'unica classe.
- Rilevamento degli oggetti: vengono disegnati riquadri di delimitazione attorno agli oggetti.
- Segmentazione delle immagini: ogni pixel viene etichettato in base all'oggetto a cui appartiene.
L'editor di annotazioni integrato in Ultralytics Platform può aiutarti in questo processo. Per maggiori dettagli, consulta la nostra guida alla raccolta e annotazione dei dati.
Suddividere il dataset prima dell'aumento aiuta a convalidare le prestazioni del modello su dati originali e non modificati. Segui questi passaggi:
- Set di addestramento: il 70-80% dei dati.
- Set di convalida: il 10-15% per l'ottimizzazione degli iperparametri.
- Set di test: il restante 10-15% per la valutazione finale.
Dopo la suddivisione, applica tecniche di aumento dei dati come rotazione, ridimensionamento e ribaltamento per aumentare la diversità del dataset. Puoi usare librerie come Albumentations e OpenCV. Ultralytics offre anche impostazioni integrate per l'aumento dei dati per semplificare il processo.
Esporta il modello addestrato con il metodo
export, scegliendo un formato adatto alla destinazione di distribuzione. Ultralytics supporta diversi formati, tra cui ONNX, TensorRT e CoreML. Per esportare il modello YOLO26, segui questi passaggi:- Usa il metodo
exportspecificando il parametro del formato desiderato. - Assicurati che il modello esportato rispetti le specifiche dell'ambiente di distribuzione (ad es. dispositivi edge o cloud).
Per maggiori informazioni, consulta la guida all'esportazione dei modelli.
- Usa il metodo
Il monitoraggio e la manutenzione continui sono essenziali per il successo a lungo termine di un modello. Implementa strumenti per tenere traccia degli indicatori chiave di prestazione (KPI) e rilevare anomalie. Riaddestra regolarmente il modello con dati aggiornati per contrastare la deriva del modello. Documenta l'intero processo, compresi l'architettura del modello, gli iperparametri e le modifiche, per garantire la riproducibilità e facilitare gli aggiornamenti futuri. Scopri di più nella nostra guida al monitoraggio e alla manutenzione.