Come definire gli obiettivi del tuo progetto di computer vision#
Per definire un progetto di computer vision, scrivi una dichiarazione del problema che identifichi la questione centrale, l'ambito, gli stakeholder e i vincoli; stabilisci obiettivi misurabili e con scadenze definite; quindi associa il problema al task di computer vision che determinerà le scelte relative a modello, dataset e deployment. Questa guida illustra ogni passaggio con un esempio pratico.
Watch: How to define Computer Vision Project's Goal | Problem Statement and VisionAI Tasks Connection 🚀
Per una panoramica dell'intero workflow, dalla raccolta dei dati al deployment, consulta la nostra guida sui passaggi chiave di un progetto di computer vision.
Come scrivere una dichiarazione del problema per un progetto di computer vision#
Una dichiarazione del problema chiara è il primo passo importante verso la ricerca della soluzione più efficace. È composta da quattro parti:
- Identifica la questione centrale: individua la sfida specifica che il tuo progetto di computer vision mira a risolvere.
- Definisci l'ambito: stabilisci i confini del problema.
- Considera gli utenti finali e gli stakeholder: identifica chi sarà interessato dalla soluzione.
- Analizza i requisiti e i vincoli del progetto: valuta le risorse disponibili (tempo, budget, personale) e identifica eventuali vincoli tecnici o normativi.
Esempio di dichiarazione di un problema aziendale#
Considera un progetto di computer vision in cui vuoi stimare la velocità dei veicoli su un'autostrada. La questione centrale è che gli attuali metodi di monitoraggio della velocità sono inefficienti e soggetti a errori a causa di sistemi radar obsoleti e processi manuali. Il progetto mira a sviluppare un sistema di computer vision in tempo reale in grado di sostituire i sistemi obsoleti di stima della velocità.
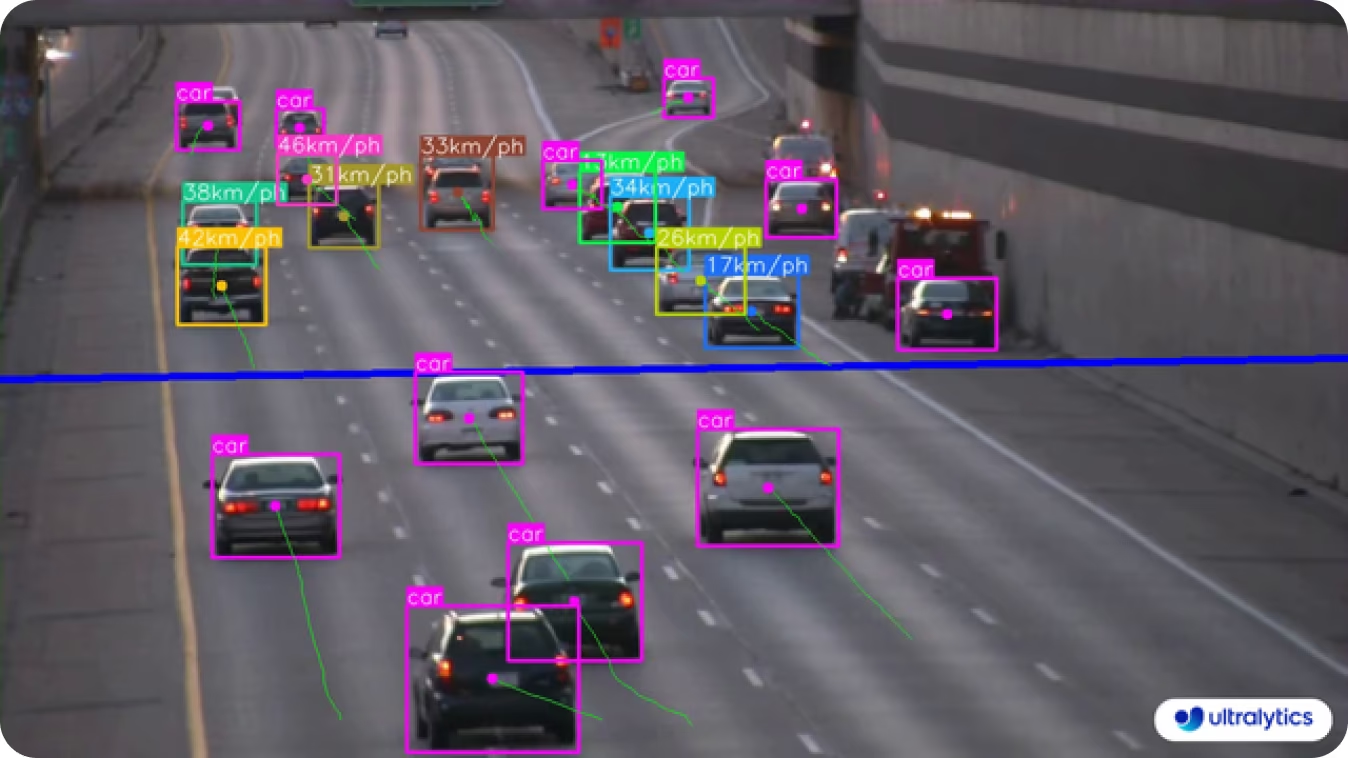
Gli utenti principali includono le autorità di gestione del traffico e le forze dell'ordine, mentre gli stakeholder secondari sono i progettisti autostradali e il pubblico, che beneficerà di strade più sicure. I requisiti principali riguardano la valutazione di budget, tempi e personale, oltre alla gestione di esigenze tecniche come telecamere ad alta risoluzione e l'elaborazione dei dati in tempo reale. Inoltre, è necessario considerare i vincoli normativi relativi alla privacy e alla sicurezza dei dati.
Definizione di obiettivi misurabili#
Definire obiettivi misurabili è fondamentale per il successo di un progetto di computer vision. Gli obiettivi efficaci seguono i criteri SMART:
| Criterio | Significato |
|---|---|
| Specifico | Definisci obiettivi chiari e dettagliati. |
| Misurabile | Assicurati che gli obiettivi siano quantificabili. |
| Raggiungibile | Stabilisci traguardi realistici e compatibili con le tue capacità. |
| Rilevante | Allinea gli obiettivi agli obiettivi generali del progetto. |
| Vincolato nel tempo | Stabilisci scadenze per ogni obiettivo. |
Per l'esempio della stima della velocità in autostrada, gli obiettivi SMART potrebbero essere:
- Raggiungere almeno il 95% di accuratezza nel rilevamento della velocità entro sei mesi, utilizzando un dataset di 10.000 immagini di veicoli.
- Il sistema dovrebbe essere in grado di elaborare flussi video in tempo reale a 30 fotogrammi al secondo con un ritardo minimo.
Stabilendo obiettivi specifici e quantificabili, puoi monitorare efficacemente i progressi, individuare le aree di miglioramento e assicurarti che il progetto rimanga in linea con i piani.
Come scegliere il task di computer vision più adatto#
La dichiarazione del problema ti aiuta a concettualizzare quale task di computer vision può risolvere il problema. I task più diffusi includono la classificazione delle immagini, il rilevamento degli oggetti e la segmentazione delle immagini: consulta la pagina dei task di Ultralytics per un confronto dettagliato.
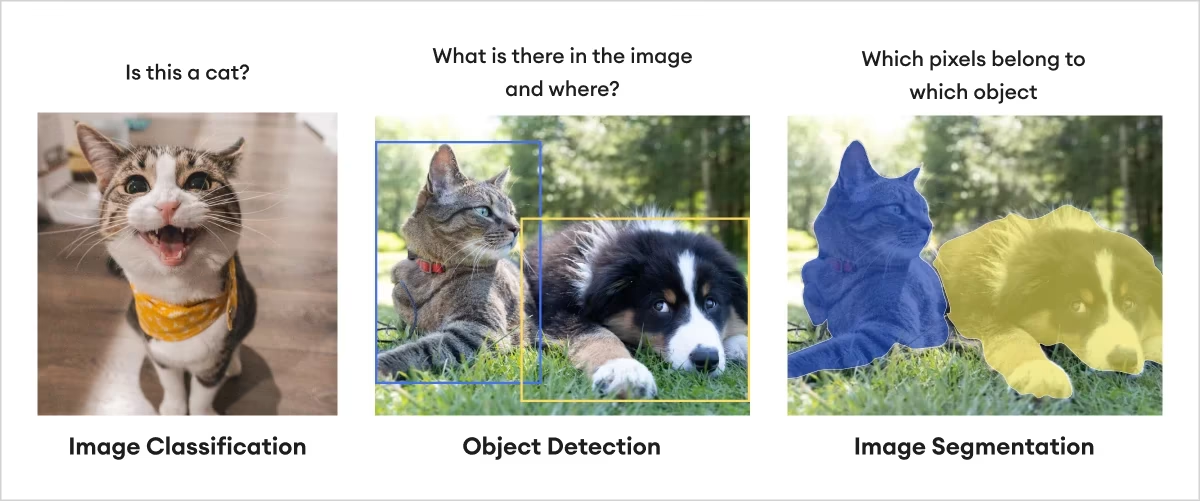
Ad esempio, se il problema consiste nel monitorare la velocità dei veicoli su un'autostrada, il task è il rilevamento degli oggetti, eseguito in modalità di tracking. Il tracking assegna a ogni veicolo rilevato un ID persistente tra i fotogrammi del video, necessario per calcolare la velocità.
Il rilevamento da solo non è sufficiente in questo caso: individua i veicoli in ogni fotogramma, ma non mantiene l'identità di ciascun veicolo tra i fotogrammi; senza tale identità, il sistema non può misurare il movimento nel tempo. La modalità di tracking aggiunge questa identità. Una volta identificato il task di computer vision appropriato, questo guida diversi aspetti fondamentali del progetto, come la selezione del modello, la preparazione del dataset e gli approcci all'addestramento del modello.
Cosa viene prima: modello, dati o approccio all'addestramento?#
L'ordine di selezione del modello, preparazione del dataset e scelta dell'approccio all'addestramento dipende dalle specificità del progetto:
| La tua situazione | Inizia da | Esempio |
|---|---|---|
| Problema e obiettivi ben definiti | Selezione del modello | Per un sistema di monitoraggio del traffico che stima la velocità dei veicoli, scegli un modello di rilevamento da eseguire in modalità di tracking, raccogli e annota video autostradali, quindi addestralo con tecniche per l'elaborazione video in tempo reale. |
| Dati unici o limitati | Preparazione del dataset | Per un sistema di riconoscimento facciale con un dataset di piccole dimensioni, annota prima i dati, quindi seleziona un modello che funzioni bene con dati limitati, come un modello preaddestrato per il transfer learning, e pianifica l'aumento dei dati per ampliare il dataset. |
| La sperimentazione è fondamentale (ricerca) | Approccio all'addestramento | In un progetto che esplora nuovi metodi per rilevare difetti di produzione, sperimenta prima su un piccolo sottoinsieme di dati. Una volta individuata una tecnica promettente, seleziona un modello adattato a tali risultati e prepara un dataset completo. |
Se inizi dai dati, la Ultralytics Platform semplifica l'organizzazione del dataset, l'annotazione e l'addestramento man mano che il progetto evolve.
In che modo le opzioni di deployment influenzano il progetto#
Le opzioni di deployment del modello influenzano significativamente le prestazioni del progetto di computer vision, quindi devi tenerne conto fin dall'inizio. L'ambiente di deployment deve essere in grado di gestire il carico computazionale del modello:
| Opzione di deployment | Ideale per | Tecnologie di esempio |
|---|---|---|
| Dispositivi edge | Smartphone e dispositivi IoT con risorse computazionali limitate; modelli leggeri | LiteRT, ONNX Runtime |
| Server cloud | Modelli complessi con maggiori esigenze computazionali; hardware scalabile in base alle necessità del progetto | AWS, Google Cloud, Azure |
| Server on-premise | Elevate esigenze di privacy dei dati e sicurezza; pieno controllo sui dati e sull'infrastruttura | Server GPU autogestiti |
| Soluzioni ibride | Equilibrio tra prestazioni, costi e latenza; elaborazione edge più analisi cloud | Combinazione di runtime edge e piattaforme cloud |
Ogni opzione offre vantaggi e sfide diversi, e la scelta dipende dai requisiti specifici del progetto, come prestazioni, costi e sicurezza.
Conclusioni#
Un progetto di computer vision efficace inizia con una dichiarazione del problema chiara, obiettivi SMART misurabili e il task di computer vision adatto; queste decisioni guidano tutto ciò che segue, dalla selezione del modello al deployment. Come passo successivo, scopri come raccogliere e annotare i dati, oppure discuti del tuo progetto con altri sviluppatori su GitHub e sul server Discord di Ultralytics.
FAQ#
Una dichiarazione del problema chiara identifica la questione centrale che il progetto deve risolvere, il suo ambito, gli utenti finali e gli stakeholder, oltre ai vincoli relativi a risorse e normative. Analizza queste quattro parti in ordine, quindi convalida la dichiarazione con gli stakeholder prima di prendere decisioni tecniche. Consulta Come scrivere una dichiarazione del problema per un progetto di computer vision per l'analisi completa e un esempio pratico.
Associa l'output richiesto dal problema al task che lo produce: una singola etichetta per immagine indica la classificazione delle immagini, le posizioni degli oggetti indicano il rilevamento degli oggetti, i confini a livello di pixel indicano la segmentazione delle immagini, mentre le identità mantenute tra i fotogrammi video richiedono lo stesso modello di rilevamento eseguito in modalità di tracking. Il monitoraggio della velocità dei veicoli, ad esempio, richiede il tracking perché la velocità viene calcolata in base al movimento di ciascun veicolo nel tempo. Consulta la pagina dei task di Ultralytics per tutti i task supportati.
Utilizza i criteri SMART: Specifico, Misurabile, Raggiungibile, Rilevante e Vincolato nel tempo. Ad esempio: "Raggiungere il 95% di accuratezza nel rilevamento della velocità entro sei mesi utilizzando un dataset di 10.000 immagini di veicoli." Questo approccio aiuta a monitorare i progressi e individua le aree di miglioramento. Scopri di più sulla definizione di obiettivi misurabili.
No, i modelli preaddestrati non "ricordano" le classi nel senso tradizionale. Apprendono pattern da dataset di grandi dimensioni e, durante l'addestramento personalizzato (fine-tuning), questi pattern vengono adattati al task specifico. La capacità del modello è limitata e la concentrazione sulle nuove informazioni può sovrascrivere parte di ciò che aveva appreso in precedenza.
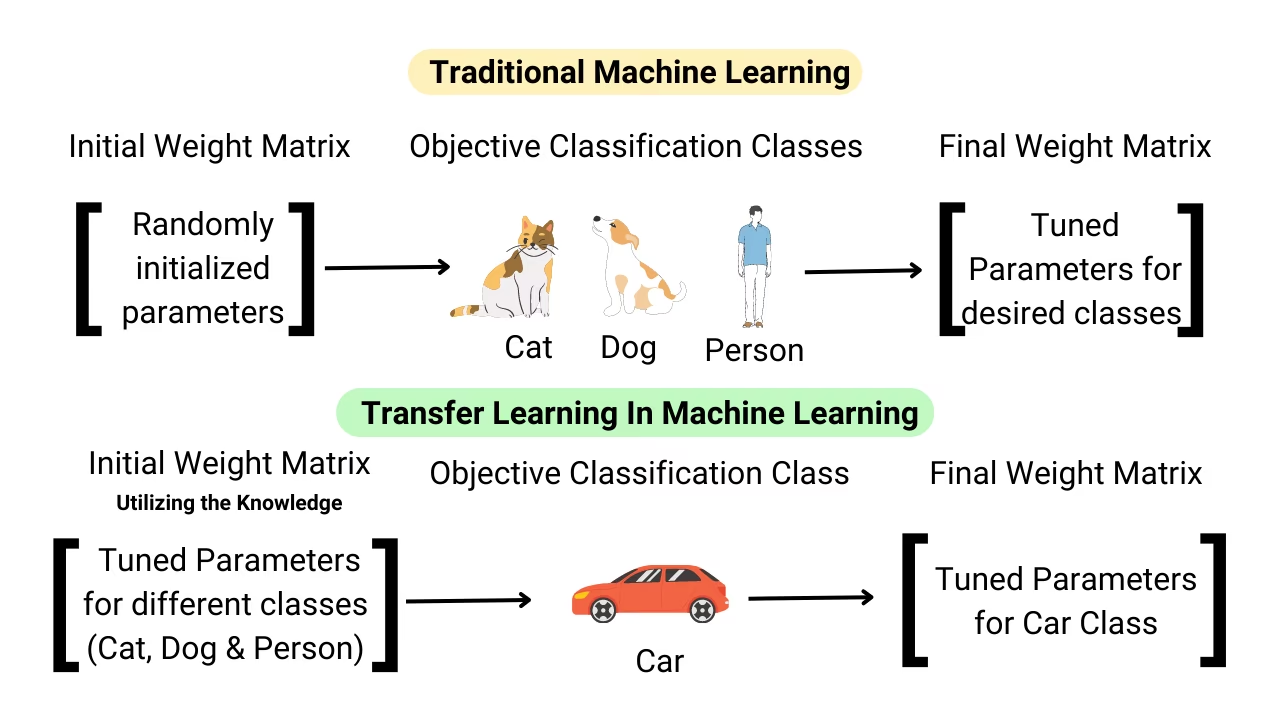
Se vuoi utilizzare le classi su cui il modello è stato preaddestrato, un approccio pratico consiste nell'utilizzare due modelli: uno conserva le prestazioni originali, mentre l'altro viene sottoposto a fine-tuning per il task specifico. In questo modo puoi combinare gli output di entrambi i modelli. Esistono altre opzioni, come il congelamento dei layer, l'utilizzo del modello preaddestrato come estrattore di caratteristiche e la suddivisione specifica per task, ma sono soluzioni più complesse che richiedono maggiore esperienza.
Le opzioni di deployment determinano quali dimensioni e formati dei modelli sono utilizzabili, quindi influenzano il progetto fin dall'inizio. I dispositivi edge richiedono modelli leggeri distribuiti tramite formati e runtime come LiteRT o ONNX Runtime; i server cloud gestiscono modelli complessi su hardware scalabile; i server on-premise offrono il pieno controllo sui dati per i progetti sensibili alla privacy; le configurazioni ibride bilanciano entrambe le soluzioni. Confrontale nella tabella delle opzioni di deployment oppure consulta la guida alle opzioni di deployment dei modelli per maggiori dettagli.
Le difficoltà comuni includono:
- Dichiarazioni del problema vaghe o eccessivamente ampie.
- Obiettivi irrealistici.
- Mancanza di allineamento tra gli stakeholder.
- Comprensione insufficiente dei vincoli tecnici.
- Sottovalutazione dei requisiti relativi ai dati.
Affronta queste difficoltà attraverso una ricerca iniziale approfondita, una comunicazione chiara con gli stakeholder e il perfezionamento iterativo della dichiarazione del problema e degli obiettivi. Per il workflow completo del progetto, consulta i passaggi chiave di un progetto di computer vision.