知識蒸留
クイックスタート#
distill_model引数を追加し、大きな教師モデルの指導を受けて小さな生徒モデルをトレーニングします。
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt")知識蒸留とは何ですか?#
知識蒸留では、大規模で高精度な教師モデルから小型の生徒モデルへ知識を転送します。生徒モデルは教師モデルの内部特徴表現を模倣するように学習し、スクラッチからトレーニングする場合より高い精度を達成できることもあります。
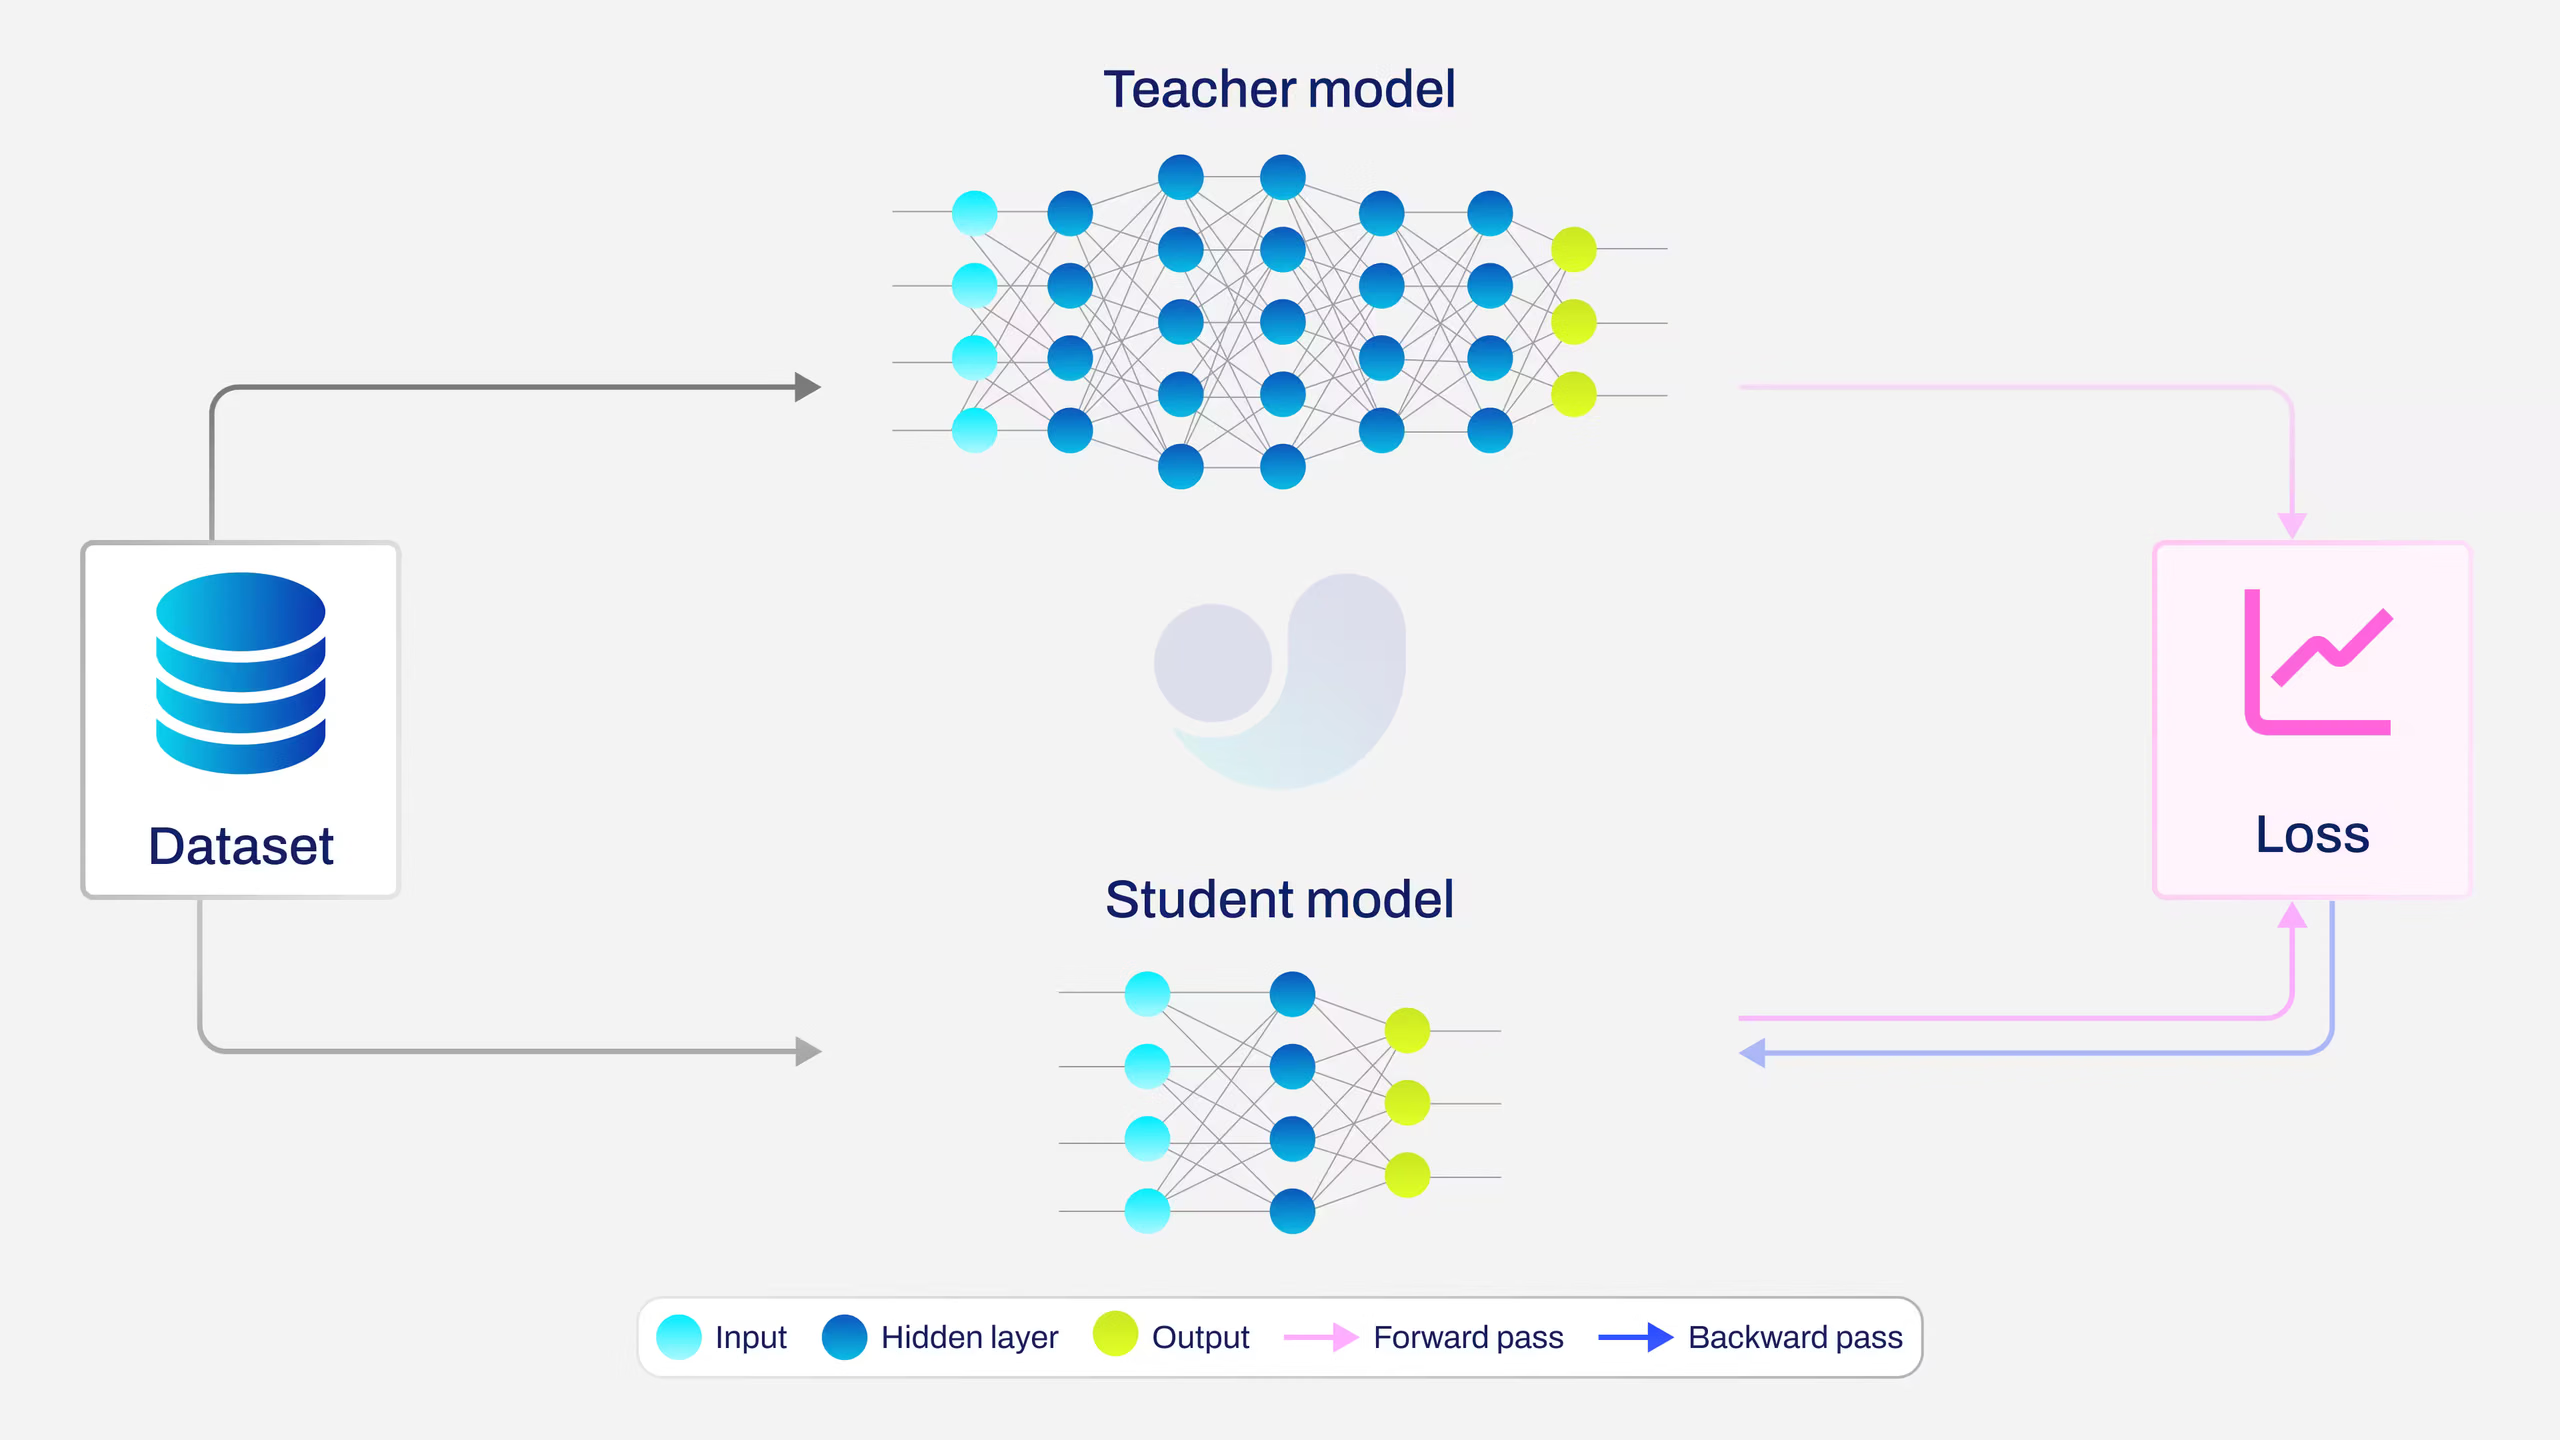
次の場合に蒸留を使用してください:
- デプロイ用に、より小さく高速なモデルが必要な場合
- 同じデータでトレーニングされた高精度の教師モデルがある場合
- 標準的なトレーニングで得られる精度をさらに高めたい場合
知識蒸留はdetect、segment、pose、obbタスクに実装されています。現時点で精度向上が実験的に検証されているのはdetectのみです。
性能#
知識蒸留により、COCO上でYOLO26ファミリー全体の生徒モデルのmAPが向上し、推論コストは増加しません。以下の表では、標準のYOLO26モデル(ベースライン)と、推奨される教師モデルを使って蒸留トレーニングした同じモデルを比較しています。
| モデル | サイズ (ピクセル) | mAPval50-95 ベースライン | mAPval50-95 蒸留済み | mAPval50-95 (e2e) ベースライン | mAPval50-95 (e2e) 蒸留済み |
|---|---|---|---|---|---|
| YOLO26n-distill | 640 | 40.9 | 41.5 | 40.1 | 40.9 |
| YOLO26s-distill | 640 | 48.6 | 49.2 | 47.8 | 48.6 |
| YOLO26m-distill | 640 | 53.1 | 53.9 | 52.5 | 53.3 |
| YOLO26l-distill | 640 | 55.0 | 56.0 | 54.4 | 55.5 |
| YOLO26x-distill | 640 | 57.5 | 57.9 | 56.9 | 57.4 |
- mAP検証の値は、COCO val2017データセットにおける単一モデル・単一スケールの結果です。
蒸留済みの行を再現するにはyolo val detect model=yolo26n-distill.pt data=coco.yaml device=0を使用してください。e2e列にはnms=Falseを追加します。 - e2eの値はNMSなしの推論経路(
nms=False)を使用し、e2e以外の値はデフォルトのNMS後処理(nms=None)を使用します。詳しくはエンドツーエンド検出をご覧ください。
前提条件#
始める前に、次の要件を満たしていることを確認してください。
- トレーニング済みの教師モデル:生徒モデルと同じYOLOファミリーの
.ptチェックポイントです。 - タスクの一致:生徒モデルと同じタスクの教師モデルを使用し、関連するデータでトレーニングしてください。
- GPUリソース:両方のモデルを格納できる十分なメモリが必要です。教師モデルは勾配やオプティマイザーの状態を使わず、順伝播のみを実行します。
推奨モデルの組み合わせ#
| 生徒モデル | 推奨される教師モデル |
|---|---|
yolo26n.pt | yolo26s.pt |
yolo26s.pt | yolo26m.pt |
yolo26m.pt | yolo26x.pt |
yolo26l.pt | yolo26x.pt |
異なるファミリー間の蒸留(例:YOLO11の教師モデルとYOLO26の生徒モデル)はサポートされていません。
主なパラメーター#
| パラメーター | 種類 | デフォルト | 説明 |
|---|---|---|---|
distill_model | str | None | 教師モデルファイルへのパス(例:yolo26x.pt)。この値を設定すると、知識蒸留が有効になります。 |
dis | float | 6.0 | 蒸留損失の重みです。蒸留損失がトレーニング全体の損失にどの程度寄与するかを制御します。 |
仕組み#
- 教師モデルは
evalモードで固定され、各バッチに対して推論を実行します - 生徒モデルは、標準的なタスク損失に蒸留による指導を加えてトレーニングされます
- Detect系ヘッドに入力される3つのネック層から、両方のモデルの特徴を抽出します
- 1×1畳み込みとReLUを2つ使うプロジェクターにより、各生徒特徴マップを教師モデルのチャンネル数に合わせます
- スコア重み付きL2損失により、投影された生徒の特徴と教師の特徴を比較し、教師モデルの分類信頼度に応じて重み付けします
- 蒸留損失は
disの重みを使って標準損失に加算されます
タスクのサポート#
蒸留の実装では、モデルのDetect系ヘッドに入力される3つのネック層から特徴を抽出します。segment、pose、obbのヘッドは同じDetectアーキテクチャを継承しているため、これらのタスクも技術的には蒸留と互換性があります。
分類、セマンティックセグメンテーション、深度推定、RT-DETRは互換性のあるDetect系ヘッドを使用しないため、サポートされていません。
実験的にベンチマークされ、検証されているのはdetectのみです。segment、pose、obbでも蒸留を実行できますが、これらのタスクにおける精度向上はまだ検証されていません。
from ultralytics import YOLO

# Segment
model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=100, distill_model="yolo26s-seg.pt")

# Pose
model = YOLO("yolo26n-pose.pt")
model.train(data="coco8-pose.yaml", epochs=100, distill_model="yolo26s-pose.pt")

# OBB
model = YOLO("yolo26n-obb.pt")
model.train(data="dota8.yaml", epochs=100, distill_model="yolo26s-obb.pt")トレーニング#
基本的なトレーニング#
蒸留を使ったトレーニングは、標準的なトレーニングと同じです。有効にするにはdistill_modelのパスを指定します。
from ultralytics import YOLO

# 生徒モデルを読み込む
student = YOLO("yolo26m.pt")

# 大きな教師モデルによる知識蒸留を使用してトレーニングする
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26x.pt")蒸留損失の重みの調整#
disパラメーター(デフォルト:6.0)は、蒸留損失の寄与度を制御します。
from ultralytics import YOLO

student = YOLO("yolo26n.pt")
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt", dis=10.0)蒸留トレーニングの再開#
蒸留トレーニングはチェックポイントからの再開に対応しています。チェックポイントに記録されたdistill_modelパスから、教師モデルが自動的に再構築されます。
from ultralytics import YOLO

student = YOLO("runs/detect/train/weights/last.pt")
results = student.train(resume=True)トレーニング出力#
蒸留を有効にすると、トレーニングログに追加のdis_loss列が表示されます。
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss   dis_loss  Instances       Size
1/80 46.2G 1.566 5.404 0.003249 6.658 231 640エクスポートされたモデルには生徒モデルの重みのみが含まれます。ファイルサイズと推論速度は、通常のトレーニングで得られる生徒モデルと同じです。
よくある質問#
- 教師モデルと生徒モデルが同じYOLO世代であることを確認してください
distill_modelのパスが正しく、ファイルを読み込めることを確認してください- 損失値が非常に小さい場合は、
disを大きくしてみてください - 教師モデルが同じデータセットでトレーニングされていることを確認してください
distill_modelパラメーターを追加するだけで、ほかはすべて同じように動作します。学習中に蒸留損失が追加で計算されますが、保存されるモデルはオーバーヘッドのない標準的なYOLOモデルです。はい。教師モデルはバッチごとに順伝播を追加するため、時間とメモリのオーバーヘッドは教師モデルと生徒モデルの組み合わせによって異なります。教師モデルは勾配やオプティマイザーの状態を使わず、
evalモードで実行されます。知識蒸留は、Detect系ヘッドに入力される3つのネック層から特徴を蒸留するため、detect、segment、pose、obbタスクで機能します。classify、semantic、depth、RT-DETRはサポートされていません。
精度向上が実験的に検証されているのは、detectのみです。segment、pose、obbは技術的には互換性がありますが、まだベンチマークされていません。
teacherとstudentは、同じYOLOファミリーに属している必要があります(例:YOLOv8、YOLO11、YOLO26)。異なるファミリー間の蒸留(例:YOLO11のteacherとYOLO26のstudent)はサポートされていません。


コメント5
質問したり、結果を共有したり、ほかの人をサポートしたりできます。
CharbelMsallem
Cool! If same dataset, can the class mapping or the number of classes differ from parent to student but using the same images and split?
I mean classes of student be a subset of parent classes
 Glenn JocherUltralytics
Same images/splits can be reused, but for the supported distillation path the teacher and student should use the same task and
data.yamlclass configuration (nc,names, and class indices), per the Knowledge Distillation guide. If the student should learn only a subset, create a subset dataset/YAML with labels remapped to contiguous IDs and train or fine-tune a teacher on that same subset/mapping before using it asdistill_model.okat thanks!
andyrey
Very interesting and useful, thank you!