デプロイ後のコンピュータービジョンモデルの保守
コンピュータービジョンモデルの監視と保守では、データドリフトや精度低下を検出するために予測を継続的に追跡し、パフォーマンスが低下したら新しいデータで再トレーニングし、作業の再現性を保つために変更をすべて記録します。これはコンピュータービジョンプロジェクトの最終段階です。要件を収集し、データにアノテーションを付け、モデルをトレーニングしてデプロイした後も、本番環境で稼働するモデルがプロジェクトの目標を達成し続けるために必要な作業です。
視聴: デプロイ後のコンピュータービジョンモデルの保守方法 | データドリフトの検出
このガイドでは、デプロイ後のコンピュータービジョンモデルの保守方法について詳しく説明します。モデルの監視が問題の早期発見にどう役立つか、モデルの精度を維持して最新の状態に保つ方法、トラブルシューティングにドキュメントが重要な理由を解説します。
モデルの監視#
デプロイ済みのコンピュータービジョンモデルを注意深く監視することが重要です。適切な監視を行わないと、モデルの精度が低下する可能性があります。よくある問題として、データ分布の変化、つまりデータドリフトがあります。これは、モデルが処理するデータがトレーニング時のデータから変化する現象です。モデルが見慣れないデータに対して予測を行うと、誤った解釈やパフォーマンスの低下につながる場合があります。外れ値や異常なデータポイントも、モデルの精度を損なう可能性があります。
モデルを定期的に監視すると、開発者はモデルの性能を追跡し、異常を検知して、データドリフトなどの問題に迅速に対処できます。また、更新が必要なタイミングを把握できるため、コストのかかる全面的な見直しを避けながら、モデルの有効性を維持できます。
モデル監視のベストプラクティス#
本番環境でコンピュータービジョンモデルを監視する際は、次のベストプラクティスを念頭に置いてください。
- 性能を定期的に追跡する: モデルの性能を継続的に監視し、時間の経過に伴う変化を検出します。
- データ品質を再確認する: データに欠損値や異常がないか確認します。
- 多様なデータソースを使用する: さまざまなソースのデータを監視し、モデルの性能を包括的に把握します。
- 監視手法を組み合わせる: ドリフト検出アルゴリズムとルールベースの手法を組み合わせ、幅広い問題を特定します。
- 入力と出力を監視する: モデルが処理するデータと生成する結果の両方に注意を払い、すべてが正しく機能していることを確認します。
- アラートを設定する: 性能の低下など、異常な動作に対するアラートを設定し、迅速に是正措置を講じられるようにします。
Ultralytics Platformでの監視#
Ultralytics Platformには、デプロイ済みYOLOエンドポイント向けのモデル監視機能が組み込まれているため、別途監視スタックを構築せずに本番環境のモデルを監視できます。Deployダッシュボードでは、主要なシグナルをリアルタイムで追跡できます。
- リクエスト指標: 各エンドポイントのリクエスト総数、エラー率、P95レイテンシを確認できます。ダッシュボードには24時間のスパークラインによる傾向が表示され、指標APIでは1時間から30日までの範囲を指定できます。
- ヘルスチェック: エンドポイントのヘルスチェックにより、正常でないデプロイを検出し、応答レイテンシを報告します。
- ログ: リクエストの失敗やレイテンシの急増を診断するため、DEBUGからCRITICALまでの重要度でフィルタリングされたリクエストログを確認できます。
- 全体表示: インタラクティブな世界地図と概要カードを使って、各地域のすべてのデプロイを1つの画面で要約できます。
監視情報は標準的なエンドポイントURLと/healthチェックを通じて利用できるため、より詳細な分析が必要な場合は、これらの指標を既存のオブザーバビリティ設定に組み込むこともできます。設定方法については、デプロイ監視ガイドを参照してください。
異常検出とアラートシステム#
異常とは、予想される状態から大きく逸脱したデータポイントやパターンです。コンピュータービジョンモデルの場合、異常にはモデルのトレーニングに使用したものと大きく異なる画像が含まれます。このような予期しない画像は、データ分布の変化、外れ値、モデルのパフォーマンスを低下させる可能性のある挙動などの問題を示す場合があります。こうした異常を検出するアラートシステムの設定は、モデル監視の重要な要素です。
主要な指標について標準的な性能レベルと上限・下限を設定すると、問題を早期に検出できます。性能がこれらの範囲を外れるとアラートが発動し、迅速な修正を促します。新しいデータでモデルを定期的に更新、再トレーニングすると、データの変化に合わせてモデルの有効性と精度を維持できます。
しきい値とアラートの設定#
アラートシステムを設定する際は、次のベストプラクティスを念頭に置いてください。
- アラートを標準化する: Slackなどのメールやメッセージングアプリを含め、すべてのアラートで一貫したツールと形式を使用します。標準化すると、アラートをすばやく理解して対応しやすくなります。
- 想定される動作を含める: アラートメッセージには、何が問題だったのか、何が想定されていたのか、どの期間を評価したのかを明記します。これにより、アラートの緊急性や背景を判断しやすくなります。
- アラートを設定可能にする: 状況の変化に合わせて簡単に設定を変更できるようにします。しきい値の編集、アラートのスヌーズ、無効化、確認をできるようにします。
データドリフトの検出#
データドリフト検出では、入力データの統計的特性が時間とともに変化し、モデルのパフォーマンスが低下する可能性のある状況を特定します。モデルの再トレーニングや調整を決める前に、この手法で問題の有無を確認できます。データドリフトは時間とともに生じるデータ全体の変化を扱う一方、異常検出は、早急な対応が必要な可能性のあるまれなデータポイントや予期しないデータポイントの特定に重点を置きます。
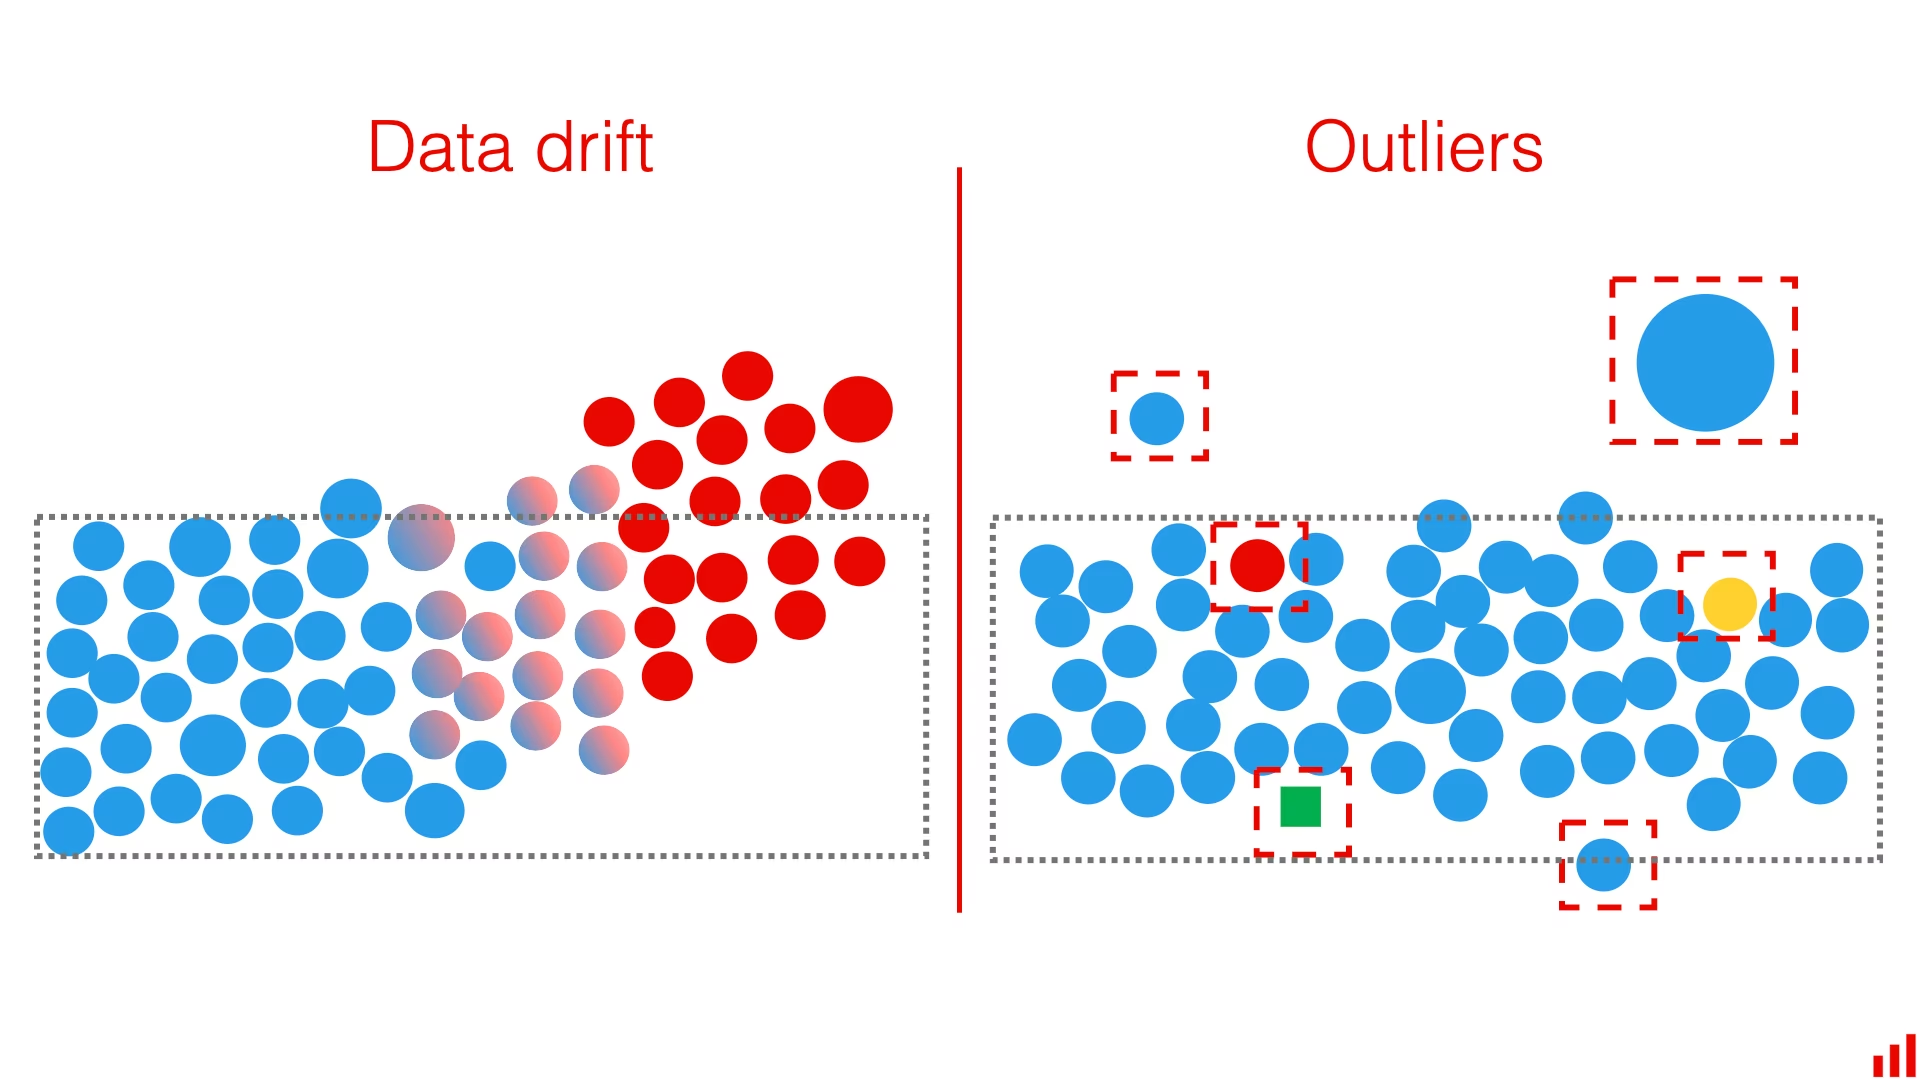
データドリフトを検出する方法をいくつか紹介します。
- 継続的な監視: モデルの入力データと出力を定期的に監視し、ドリフトの兆候を確認します。主要な指標を追跡し、過去のデータと比較して大きな変化を特定します。
- 統計的手法: Kolmogorov-Smirnov検定やPopulation Stability Index(PSI)などの手法を使い、データ分布の変化を検出します。これらの検定では、新しいデータの分布とトレーニングデータの分布を比較し、大きな差異を特定します。
- 特徴量ドリフト: 個々の特徴量を監視し、ドリフトを検出します。データ全体の分布が安定していても、個々の特徴量にはドリフトが発生する場合があります。ドリフトしている特徴量を特定すると、再トレーニングのプロセスを微調整しやすくなります。
モデルの保守#
モデルの保守では、定期的な更新と再トレーニング、データドリフトへの対処、データや環境の変化への適応を通じて、コンピュータービジョンモデルの精度と有効性を長期にわたって維持します。これは監視を補完するものです。監視がモデルの性能をリアルタイムで確認して問題を早期に検出するのに対し、保守はその問題を修正します。
定期的な更新と再トレーニング#
モデルをデプロイした後、監視を続ける中で、データパターンや性能の変化に気付き、モデルドリフトが発生していると判断することがあります。新しいパターンやシナリオにモデルが対応できるようにするには、定期的な更新と再トレーニングがモデル保守に欠かせません。データの変化に応じて、いくつかの手法を利用できます。
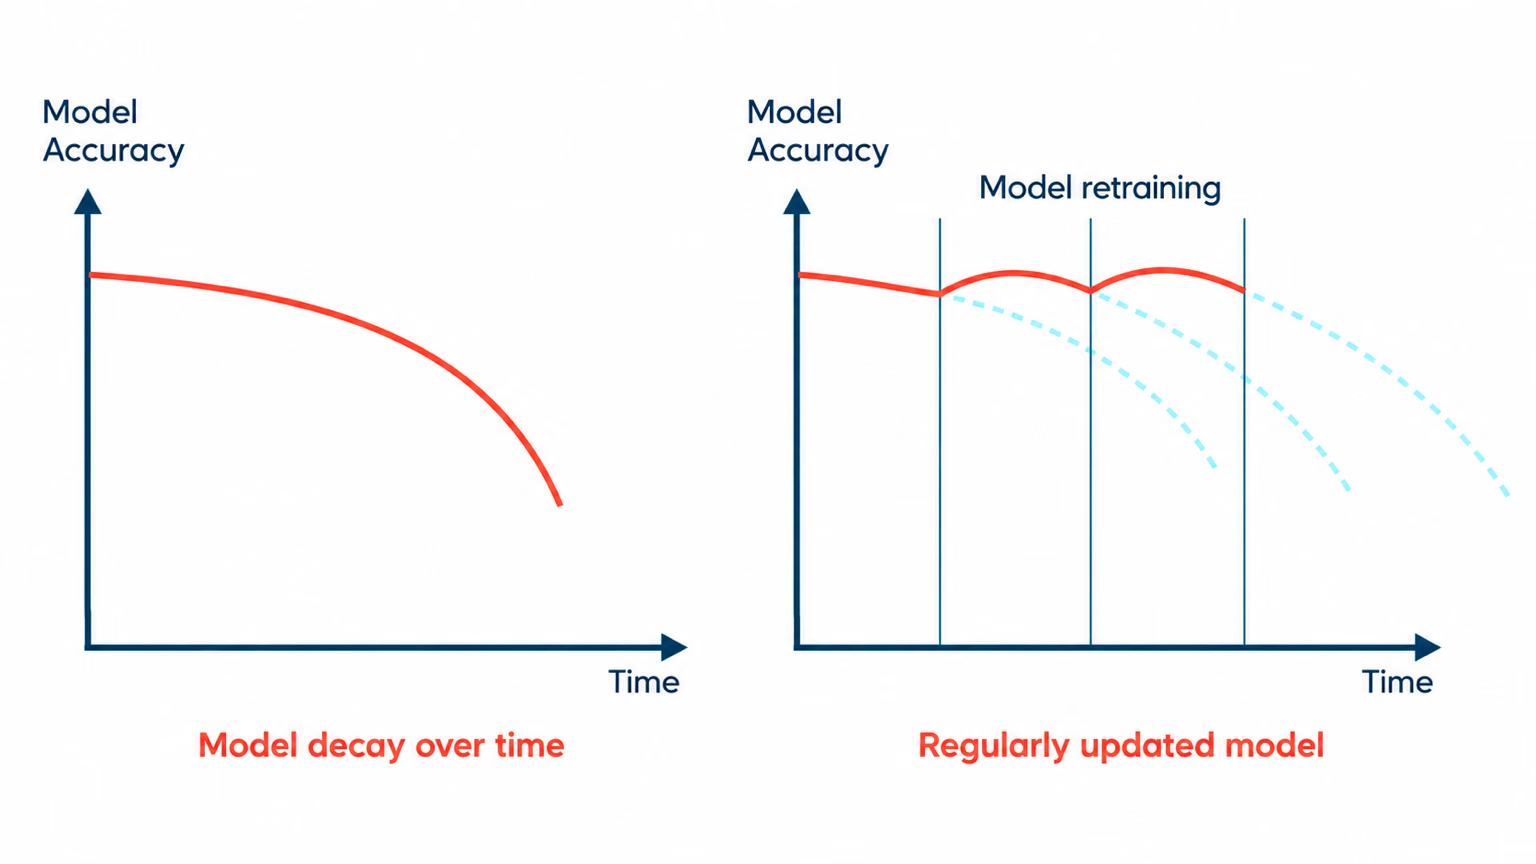
たとえば、データが時間とともに徐々に変化している場合は、増分学習が適した方法です。増分学習では、モデルをスクラッチから完全に再トレーニングすることなく、新しいデータでモデルを更新するため、計算リソースと時間を節約できます。ただし、データが大きく変化した場合は、定期的に完全な再トレーニングを行うほうが適している可能性があります。新しいデータへの過学習を防ぎながら、以前のパターンを見失わないようにするためです。
どの手法を選ぶ場合でも、更新後の検証とテストは必須です。性能が向上したか低下したかを確認するため、別のテストデータセットを使ってモデルを検証することが重要です。
モデルを再トレーニングするタイミングの判断#
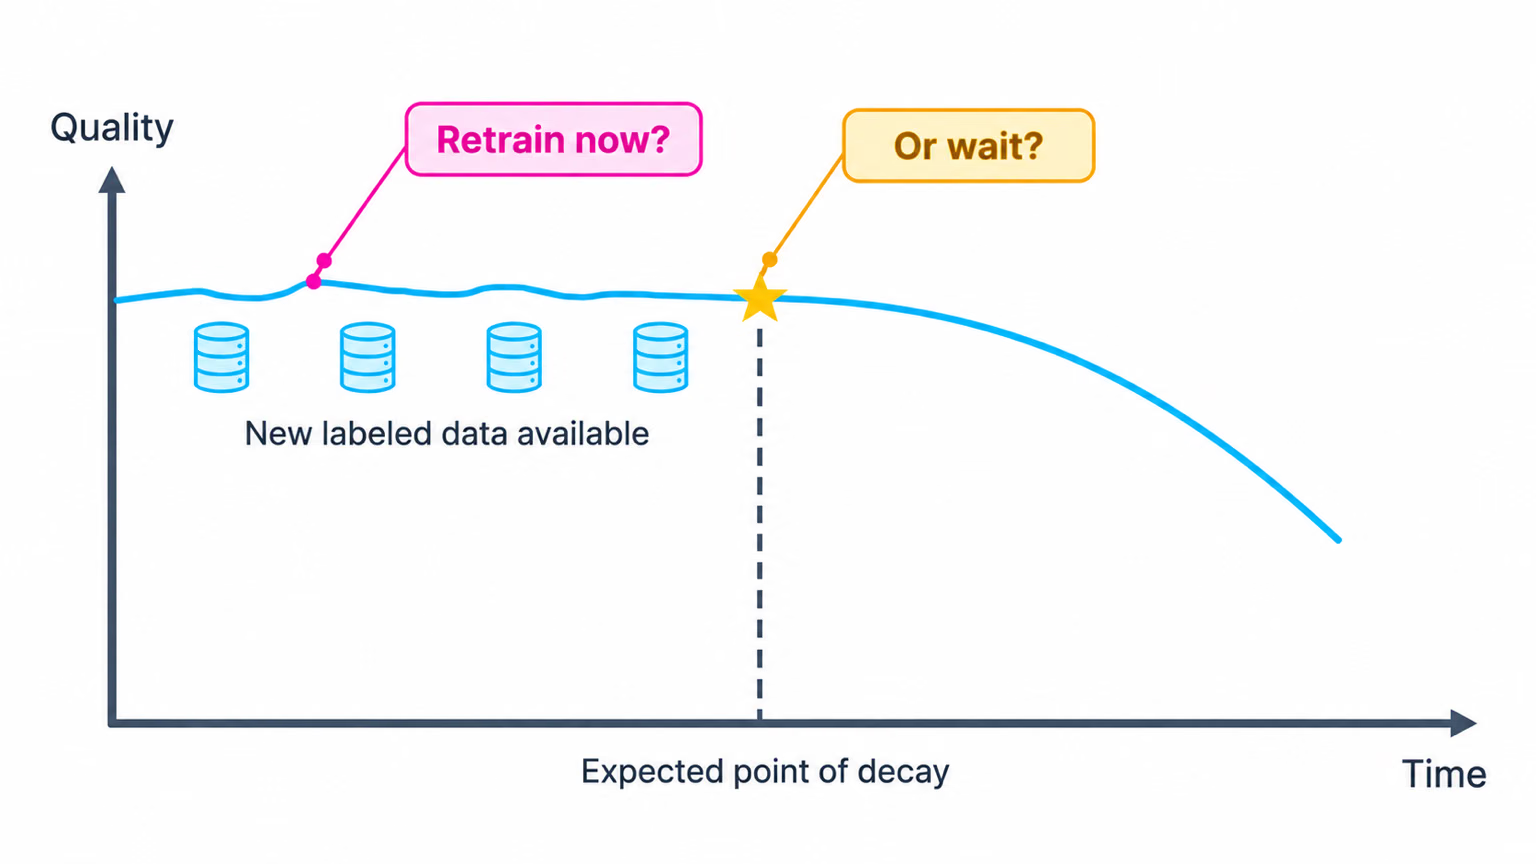
コンピュータービジョンモデルの再トレーニング頻度は、データの変化とモデルの性能によって異なります。性能の大幅な低下を確認した場合や、データドリフトを検出した場合は、モデルを再トレーニングしてください。新しいデータを使った定期的な評価を行うと、適切な再トレーニングのスケジュールを判断できます。性能指標とデータパターンを監視することで、精度を維持するために、より頻繁な更新が必要かどうかを判断できます。
ドキュメント#
コンピュータービジョンプロジェクトを文書化すると、理解、再現、共同作業が容易になります。適切なドキュメントには、モデルアーキテクチャ、ハイパーパラメーター、データセット、評価指標などを記載します。透明性を高めることで、チームメンバーや関係者が、何が行われたのか、なぜ行われたのかを理解しやすくなります。また、過去の判断や手法を明確に参照できるため、トラブルシューティング、保守、将来の機能強化にも役立ちます。
文書化すべき主な項目#
プロジェクトのドキュメントには、次の主要な要素を含める必要があります。
- プロジェクト概要: 問題の説明、解決アプローチ、期待される成果、プロジェクトの範囲など、プロジェクトの概要を説明します。問題解決におけるコンピュータービジョンの役割を説明し、各段階と成果物を示します。
- モデルアーキテクチャ: コンポーネント、レイヤー、接続など、モデルの構造と設計を詳しく説明します。選択したハイパーパラメーターと、その選択理由を説明します。
- データの準備: データソース、種類、形式、サイズ、前処理の手順を説明します。データの品質と信頼性、およびモデルのトレーニング前に適用した変換について説明します。
- トレーニングプロセス: 使用したデータセット、トレーニングパラメーター、損失関数など、トレーニング手順を記録します。モデルのトレーニング方法と、トレーニング中に直面した課題を説明します。
- 評価指標: 精度、適合率、再現率、F1スコアなど、モデルの性能評価に使用した指標を明記します。性能結果と、これらの指標の分析を含めます。
- デプロイ手順: 使用したツールやプラットフォーム、デプロイ設定、固有の課題や考慮事項など、モデルのデプロイ手順を示します。
- モニタリングとメンテナンスの手順: デプロイ後のモデル性能をモニタリングするための詳細な計画を提示します。データドリフトとモデルドリフトの検出・対処方法を含め、定期的な更新と再トレーニングのプロセスを説明します。
結論#
モデルのモニタリング、メンテナンス、ドキュメント化を続けることで、デプロイ後もコンピュータービジョンプロジェクトの成功を維持できます。継続的なモニタリングで問題を早期に発見し、定期的な再トレーニングで新しいデータやドリフトにモデルを適応させ、明確なドキュメントで今後の更新を容易にします。これらを継続的なサイクルとして捉え、データや要件の変化に応じてコンピュータービジョンプロジェクトの各段階を見直します。
よくある質問#
デプロイ済みのコンピュータービジョンモデルをモニタリングするには、本番環境でリクエスト量、エラー率、レイテンシーを追跡し、精度低下を示す異常やデータドリフトに注意します。Ultralytics PlatformのDeployダッシュボードは、リアルタイム指標、自動ヘルスチェック、重要度で絞り込めるログを標準で提供し、本番環境の指標を把握できます。入力と出力を定期的にモニタリングし、異常な動作に対するアラートを設定して、多様なデータソースを活用することで、モデル性能を包括的に把握できます。詳細は、モデルモニタリングのセクションをご覧ください。
コンピュータービジョンモデルのメンテナンスでは、精度と有用性を維持するために、定期的な更新、再トレーニング、モニタリングが必要です。ベストプラクティスは次のとおりです。
- 継続的なモニタリング: 性能指標とデータ品質を定期的に追跡します。
- データドリフトの検出: 統計的手法を使用して、データ分布の変化を特定します。
- 定期的な更新と再トレーニング: データの変化に応じて、逐次学習または定期的な全面再トレーニングを実施します。
- ドキュメント: モデルアーキテクチャ、トレーニングプロセス、評価指標を詳しく記録します。詳しくは、モデルメンテナンスのセクションをご覧ください。
データドリフトの検出は、入力データの統計的性質が時間とともに変化した際に特定するのに役立ちます。こうした変化は、モデル性能の低下につながる可能性があります。継続的なモニタリング、統計的検定(例: Kolmogorov-Smirnov検定)、特徴量ドリフト分析などの手法で、問題を早期に発見できます。データドリフトに対処することで、環境が変化してもモデルの精度と有用性を維持できます。詳しくは、データドリフト検出のセクションをご覧ください。
コンピュータービジョンモデルの異常を検知するには、主要な指標の標準的な性能レベルを設定し、値がその範囲を外れた場合にアラートを発生させます。Ultralytics Platformは、リアルタイムのエラー率とレイテンシー指標、自動ヘルスチェック、重要度で絞り込めるログによって、異常な動作をすばやく把握できます。設定可能なアラートと標準化されたメッセージにより、潜在的な問題に迅速に対応できます。詳しくは、異常検知とアラートシステムのセクションをご覧ください。
コンピュータービジョンプロジェクトの効果的なドキュメントには、次の内容を含めます。


コメント4
質問したり、結果を共有したり、ほかの人をサポートしたりできます。
SunyuKy
Hello, I am training my own dataset using yolov11. My dataset usually only contains one small target, so a large part of the image is background, which makes it easy for the model to recognize the target class as the background class. How can I modify the configuration file to improve the model performance? Will adjusting the loss gain of box and cls work?
 Glenn JocherUltralytics
@SunyuKy to improve model performance on a dataset with a small target and large background, consider adjusting the
boxandclsloss gains in the configuration file. This can help the model focus more on the target class. Additionally, experimenting with data augmentation techniques might enhance detection accuracy. For more detailed guidance, you can refer to our documentation on model monitoring and maintenance.Thank you for your reply!I would like to know in which direction the loss gain of the bounding box and classification should be adjusted. I guess I should increase the loss gain of the classification. So, should the loss gain of the bounding box be increased or decreased?
- Glenn JocherUltralytics(編集済み)
To improve performance, try increasing the classification loss gain (
cls) to emphasize the target class. For the bounding box loss (box), you might experiment with both increasing and decreasing it and compare validation results.