지식 증류#
빠른 시작#
distill_model 인수를 추가해 더 큰 교사 모델의 안내를 받아 더 작은 학생 모델을 학습시키세요.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt")
지식 증류란 무엇인가요?#
지식 증류는 크고 정확한 교사 모델의 지식을 더 작은 학생 모델로 전달합니다. 학생 모델은 교사 모델의 내부 특성 표현을 모방하도록 학습하며, 처음부터 학습하는 것보다 더 높은 정확도를 얻는 경우가 많습니다.
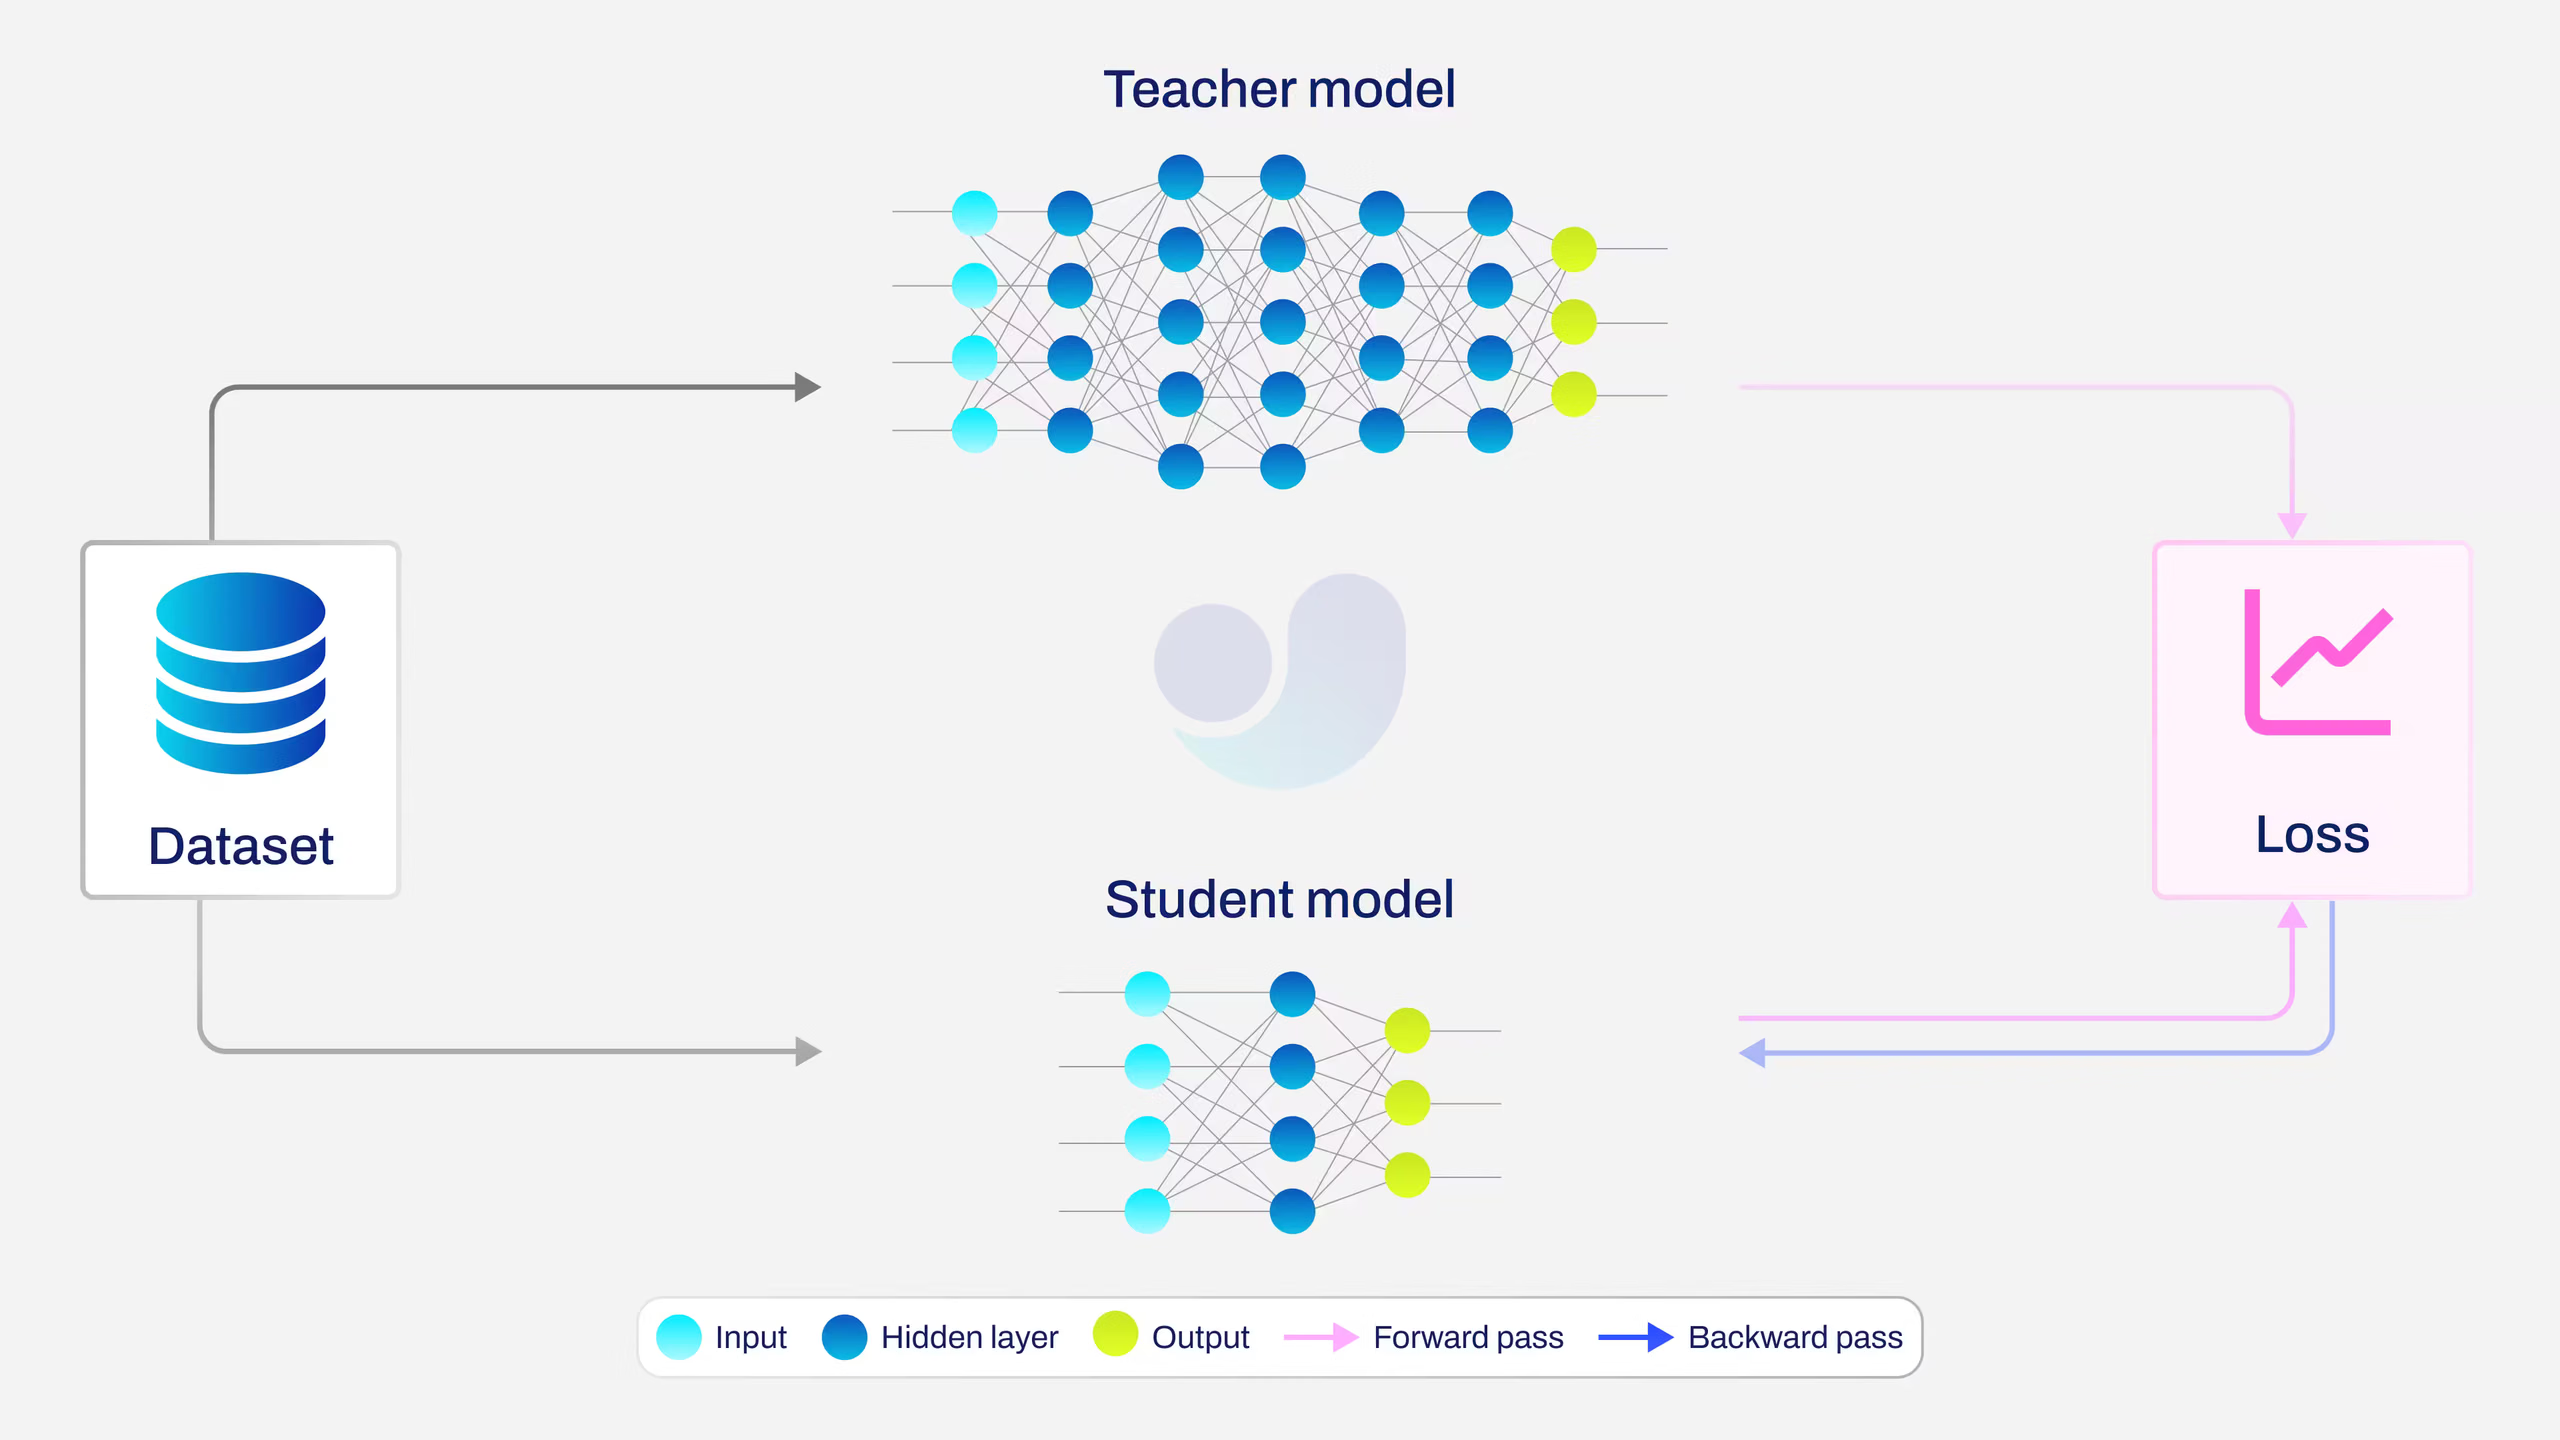
다음과 같은 경우 증류를 사용하세요.
- 배포를 위해 더 작고 빠른 모델이 필요한 경우
- 동일한 데이터로 학습한 고정확도 교사 모델이 있는 경우
- 표준 학습보다 더 높은 정확도를 원하는 경우
지식 증류는 detect, segment, pose, obb 작업에 구현되어 있습니다. 현재 정확도 향상 여부가 실험적으로 검증된 작업은 detect뿐입니다.
성능#
지식 증류를 적용하면 COCO의 전체 YOLO26 제품군에서 학생 모델의 mAP가 향상되며, 추론 비용은 추가되지 않습니다. 아래 표에서는 표준 YOLO26 모델(기준선)과 권장 교사 모델을 사용해 증류 학습한 동일 모델을 비교합니다.
| 모델 | 크기 (픽셀) | mAPval 50-95 기준선 | mAPval 50-95 증류 적용 | mAPval 50-95 (e2e) 기준선 | mAPval 50-95 (e2e) 증류 적용 |
|---|---|---|---|---|---|
| YOLO26n-distill | 640 | 40.9 | 41.5 | 40.1 | 40.9 |
| YOLO26s-distill | 640 | 48.6 | 49.2 | 47.8 | 48.6 |
| YOLO26m-distill | 640 | 53.1 | 53.9 | 52.5 | 53.3 |
| YOLO26l-distill | 640 | 55.0 | 56.0 | 54.4 | 55.5 |
| YOLO26x-distill | 640 | 57.5 | 57.9 | 56.9 | 57.4 |
- mAPval 값은 COCO val2017 데이터셋에서 단일 모델, 단일 스케일로 측정한 결과입니다.
yolo val detect model=yolo26n-distill.pt data=coco.yaml device=0로 증류 행을 재현하고, e2e 열을 확인하려면nms=False를 추가하세요. - e2e 값은 NMS가 없는 추론 경로(
nms=False)를 사용하며, e2e가 아닌 값은 기본 NMS 후처리(nms=None)를 사용합니다. 자세한 내용은 종단 간 탐지를 참조하세요.
사전 요구 사항#
시작하기 전에 다음 요구 사항을 충족하는지 확인하세요.
- 학습된 교사 모델: 학생 모델과 동일한 YOLO 제품군의
.pt체크포인트입니다. - 동일한 작업: 학생 모델과 같은 작업을 수행하고 관련 데이터로 학습한 교사 모델을 사용하세요.
- GPU 리소스: 두 모델을 모두 메모리에 올릴 수 있어야 합니다. 교사 모델은 그래디언트나 옵티마이저 상태 없이 순전파만 실행합니다.
권장 모델 조합#
| 학생 모델 | 권장 교사 모델 |
|---|---|
yolo26n.pt | yolo26s.pt |
yolo26s.pt | yolo26m.pt |
yolo26m.pt | yolo26x.pt |
yolo26l.pt | yolo26x.pt |
제품군 간 증류(예: YOLO11 교사 모델과 YOLO26 학생 모델)는 지원되지 않습니다.
주요 매개변수#
| 매개변수 | 유형 | 기본값 | 설명 |
|---|---|---|---|
distill_model | str | None | 교사 모델 파일의 경로입니다(예: yolo26x.pt). 이 값을 설정하면 지식 증류가 활성화됩니다. |
dis | float | 6.0 | 증류 손실 가중치입니다. 증류 손실이 전체 학습 손실에 반영되는 정도를 제어합니다. |
작동 방식#
- 교사 모델은
eval모드에서 고정된 상태를 유지하며 각 배치에 대해 추론을 실행합니다. - 학생 모델은 표준 작업 손실과 증류 안내를 함께 사용해 학습됩니다.
- Detect 계열 헤드에 입력되는 세 개의 넥 레이어에서 두 모델의 특성을 추출합니다.
- 두 개의 1×1 컨볼루션과 ReLU로 구성된 프로젝터가 각 학생 특성 맵의 채널을 교사 모델에 맞춥니다.
- 점수 가중 L2 손실은 프로젝터를 거친 학생 특성과 교사 특성을 비교하며, 교사 모델의 분류 신뢰도를 가중치로 사용합니다.
- 증류 손실은
dis가중치를 사용해 표준 손실과 결합됩니다.
flowchart TD
    A[Input Image Batch]:::start --> T[Teacher Model<br/>frozen, eval mode]:::extern
    A --> S[Student Model<br/>trainable]:::proc

    T --> |Detect head inputs| TF[Teacher Features]:::extern
    S --> |Detect head inputs| SF[Student Features]:::proc

    SF --> P[1×1 Conv Projector<br/>with ReLU]:::decide
    P --> AF[Aligned Student Features]:::proc

    TF --> SW[Score-weighted L2 Loss]:::proc
    AF --> SW

    S --> D[Detection Head]:::proc
    D --> DL[box_loss + cls_loss + l1_loss]:::proc

    SW --> |× dis| DIS[distillation loss]:::proc
    DL --> TOTAL[Total Loss]:::out
    DIS --> TOTAL

    TOTAL --> BP[Backpropagate<br/>Student + Projector only]:::out

    classDef start fill:#4CAF50,color:#fff
    classDef proc fill:#2196F3,color:#fff
    classDef decide fill:#FF9800,color:#fff
    classDef out fill:#9C27B0,color:#fff
    classDef extern fill:#607D8B,color:#fff
작업 지원#
증류 구현은 모델의 Detect 계열 헤드에 입력되는 세 개의 넥 레이어에서 특성을 추출합니다. segment, pose, obb 헤드는 동일한 Detect 아키텍처를 상속하므로, 증류는 이러한 작업과도 기술적으로 호환됩니다.
분류, 시맨틱 분할, 깊이 추정, RT-DETR은 호환되는 Detect 계열 헤드를 사용하지 않으므로 지원되지 않습니다.
실험적으로 벤치마크하고 검증한 작업은 detect뿐입니다. segment, pose, obb에 증류를 실행할 수 있지만, 해당 작업의 정확도 향상은 아직 검증되지 않았습니다.
from ultralytics import YOLO

# Segment
model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=100, distill_model="yolo26s-seg.pt")

# Pose
model = YOLO("yolo26n-pose.pt")
model.train(data="coco8-pose.yaml", epochs=100, distill_model="yolo26s-pose.pt")

# OBB
model = YOLO("yolo26n-obb.pt")
model.train(data="dota8.yaml", epochs=100, distill_model="yolo26s-obb.pt")학습#
기본 학습#
증류를 사용한 학습은 표준 학습과 동일합니다. 증류를 활성화하려면 distill_model 경로를 지정하세요.
from ultralytics import YOLO

# 학생 모델 불러오기
student = YOLO("yolo26m.pt")

# 더 큰 교사 모델의 지식을 증류하며 학습하기
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26x.pt")
증류 손실 가중치 조정#
dis 매개변수(기본값: 6.0)는 증류 손실이 기여하는 정도를 제어합니다.
from ultralytics import YOLO

student = YOLO("yolo26n.pt")
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt", dis=10.0)
증류 학습 재개#
증류 학습은 체크포인트에서 이어서 학습할 수 있습니다. 체크포인트에 기록된 distill_model 경로를 사용해 교사 모델을 자동으로 다시 구성합니다.
from ultralytics import YOLO

student = YOLO("runs/detect/train/weights/last.pt")
results = student.train(resume=True)
학습 출력#
증류를 활성화하면 학습 로그에 dis_loss 열이 추가됩니다.
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss   dis_loss  Instances       Size
      1/80      46.2G      1.566      5.404    0.003249      6.658        231        640
내보낸 모델에는 학생 모델의 가중치만 포함되므로, 파일 크기와 추론 속도는 일반적으로 학습한 학생 모델과 동일합니다.
자주 묻는 질문#
- 교사 모델과 학생 모델이 동일한 YOLO 세대인지 확인하세요.
distill_model경로가 올바르고 파일을 불러올 수 있는지 확인하세요.- 손실 값이 매우 작으면
dis을 늘려 보세요. - 교사 모델이 동일한 데이터셋으로 학습되었는지 확인하세요.
distill_model매개변수만 추가하면 됩니다. 나머지는 모두 동일하게 작동합니다. 학습 중 추가 증류 손실이 계산되지만, 저장된 모델은 오버헤드가 없는 표준 YOLO 모델입니다.예. 교사 모델이 각 배치마다 순전파를 추가로 수행하므로 시간 및 메모리 오버헤드는 교사 모델과 학생 모델의 조합에 따라 달라집니다. 교사 모델은 그래디언트나 옵티마이저 상태 없이
eval모드로 실행됩니다.지식 증류는 Detect 계열 헤드에 입력되는 세 개의 넥 레이어에서 특성을 증류하므로 detect, segment, pose, obb 작업에서 작동합니다. classify, semantic, depth, RT-DETR은 지원되지 않습니다.
정확도 개선이 실험적으로 검증된 작업은 detect뿐입니다. segment, pose, obb는 기술적으로 호환되지만 아직 벤치마크되지 않았습니다.
teacher와 student는 동일한 YOLO 계열에 속해야 합니다(예: YOLOv8, YOLO11 또는 YOLO26). 계열 간 distillation(예: YOLO11 teacher와 YOLO26 student 조합)은 지원되지 않습니다.