Baidu의 RT-DETR: 비전 Transformer 기반 실시간 객체 탐지기#
개요#
Baidu가 개발한 실시간 탐지 Transformer(RT-DETR)는 높은 정확도를 유지하면서 실시간 성능을 제공하는 최첨단 엔드투엔드 객체 탐지기입니다. DETR(NMS가 필요 없는 프레임워크)을 기반으로 하며, 실시간 속도를 구현하기 위해 컨볼루션 기반 백본과 효율적인 하이브리드 인코더를 도입했습니다. RT-DETR은 스케일 내 상호작용과 스케일 간 융합을 분리하여 멀티스케일 특징을 효율적으로 처리합니다. 이 모델은 재학습 없이 서로 다른 디코더 레이어를 사용해 추론 속도를 유연하게 조정할 수 있어 적응성이 뛰어납니다. RT-DETR은 TensorRT를 사용하는 CUDA와 같은 가속 백엔드에서 탁월한 성능을 발휘하며, 다른 여러 실시간 객체 탐지기를 능가합니다.
시청: 객체 감지에 Baidu의 RT-DETR을 사용하는 방법 | Ultralytics를 활용한 추론 및 벤치마킹 🚀
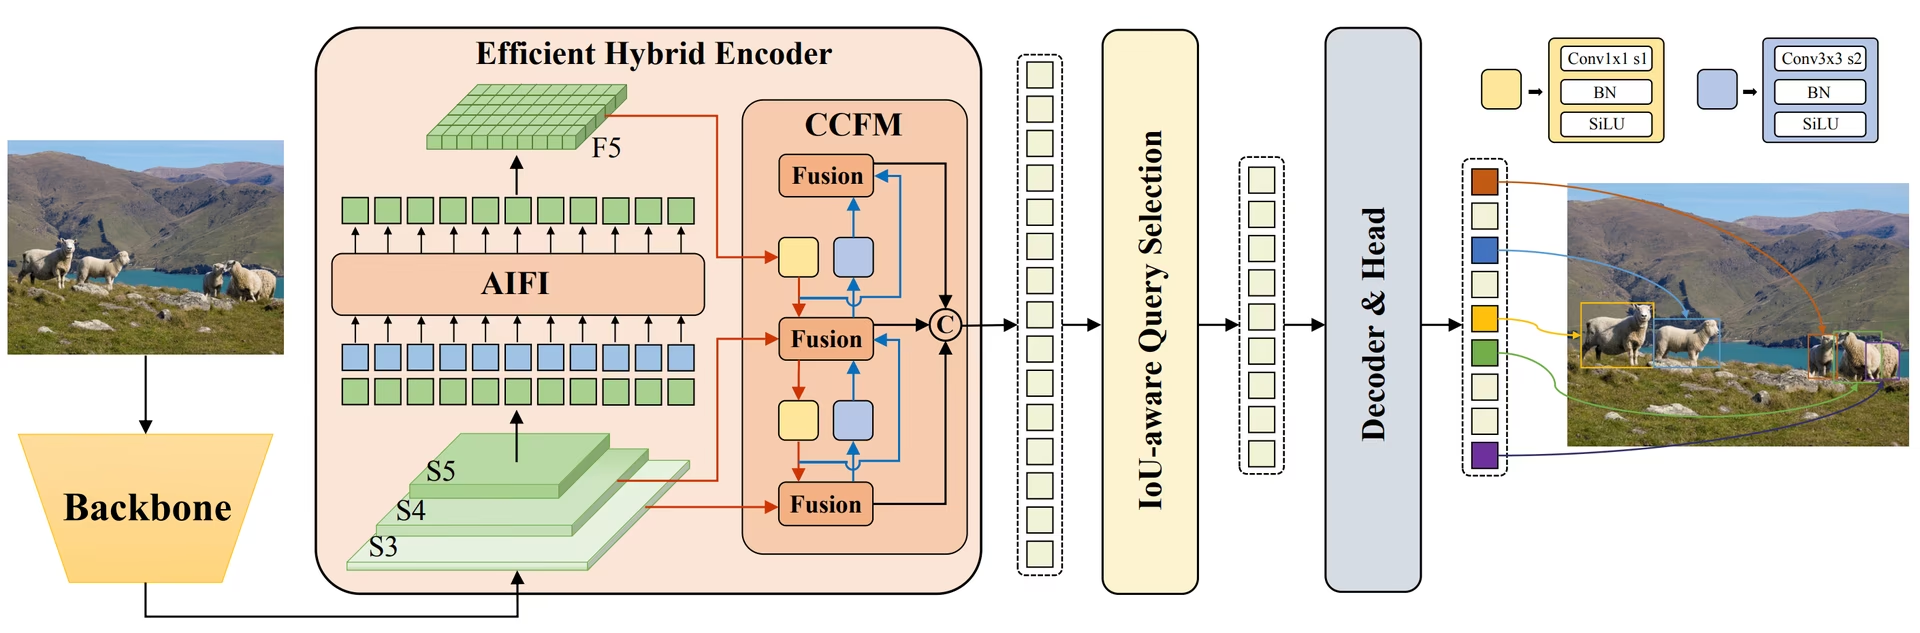 Baidu RT-DETR 개요. RT-DETR 모델 아키텍처 다이어그램은 백본의 마지막 세 단계 {S3, S4, S5}가 인코더의 입력으로 사용되는 모습을 보여줍니다. 효율적인 하이브리드 인코더는 스케일 내 특징 상호작용(AIFI)과 스케일 간 특징 융합 모듈(CCFM)을 통해 멀티스케일 특징을 이미지 특징 시퀀스로 변환합니다. IoU 인식 쿼리 선택을 사용해 디코더의 초기 객체 쿼리로 사용할 고정 개수의 이미지 특징을 선택합니다. 마지막으로, 보조 예측 헤드가 있는 디코더는 객체 쿼리를 반복적으로 최적화하여 박스와 신뢰도 점수를 생성합니다(출처).
주요 기능#
- 효율적인 하이브리드 인코더: Baidu의 RT-DETR은 스케일 내 상호작용과 스케일 간 융합을 분리하여 멀티스케일 특징을 처리하는 효율적인 하이브리드 인코더를 사용합니다. 이 독창적인 Vision Transformer 기반 설계는 연산 비용을 줄이고 실시간 객체 탐지를 가능하게 합니다.
- IoU 인식 쿼리 선택: Baidu의 RT-DETR은 IoU 인식 쿼리 선택을 활용해 객체 쿼리 초기화를 개선합니다. 이를 통해 모델은 장면에서 가장 관련성 높은 객체에 집중하여 탐지 정확도를 높입니다.
- 유연한 추론 속도: Baidu의 RT-DETR은 재학습할 필요 없이 서로 다른 디코더 레이어를 사용해 추론 속도를 유연하게 조정할 수 있습니다. 이러한 적응성은 다양한 실시간 객체 탐지 시나리오에서 실제 적용을 용이하게 합니다.
- NMS가 필요 없는 프레임워크: DETR을 기반으로 하는 RT-DETR은 비최대 억제 후처리가 필요하지 않아 탐지 파이프라인을 단순화하고 효율성을 높일 수 있습니다.
- 앵커가 필요 없는 탐지: 앵커 프리 탐지기인 RT-DETR은 탐지 과정을 단순화하고 다양한 데이터셋에 대한 일반화 성능을 향상할 수 있습니다.
사전 학습 모델#
Ultralytics Python API는 서로 다른 스케일의 사전 학습된 PaddlePaddle RT-DETR 모델을 제공합니다.
- RT-DETR-L: COCO val2017에서 AP 53.0%, T4 GPU에서 114 FPS
- RT-DETR-X: COCO val2017에서 AP 54.8%, T4 GPU에서 74 FPS
또한 Baidu는 2024년 7월에 RTDETRv2를 공개했으며, 성능 지표를 개선해 기존 아키텍처를 한층 발전시켰습니다.
사용 예시#
이 예제에서는 간단한 RT-DETR 학습 및 추론 방법을 보여줍니다. 이러한 모드와 기타 모드에 대한 전체 문서는 예측, 학습, 검증, 내보내기 문서 페이지를 참조하세요. Ultralytics Platform을 통해 클라우드 GPU에서 모델을 학습할 수도 있습니다.
from ultralytics import RTDETR

# COCO로 사전 학습된 RT-DETR-l 모델 로드
model = RTDETR("rtdetr-l.pt")

# 모델 정보 표시(선택 사항)
model.info()

# COCO8 예제 데이터셋으로 100 에포크 동안 모델 학습
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)

# 'bus.jpg' 이미지에서 RT-DETR-l 모델로 추론 실행
results = model("path/to/bus.jpg")PyTorch 2.0 이상 버전으로 CUDA에서 RT-DETR을 학습할 때 deterministic=False을 설정하세요. 변형 어텐션은 결정론적 CUDA 역전파를 지원하지 않는 F.grid_sample을 사용하므로, deterministic=True로 실행을 재현할 수 없으며 학습 처리량이 감소할 수 있습니다. seed은 가중치 초기화, 데이터 순서, 증강 샘플링을 계속 제어합니다.
RT-DETR 사전 학습 가중치는 재학습 없이 지연 시간을 줄이기 위해 추론 시 다음 두 가지 설정을 지원합니다.
eval_idx: 디코딩을 조기에 중단합니다. 기본 6개 레이어 디코더에서는 0부터 시작하는 인덱스(0–5)를 사용합니다.eval_idx=5은 모든 레이어를 사용하고eval_idx=3는 4개 레이어를 사용합니다. TensorRT v10.11을 사용하는 T4 GPU에서 RT-DETR-L은 8.0ms / 52.7 mAP에서 4개 레이어 사용 시 7.4ms / 52.5 mAP로 개선됩니다.num_queries: 객체 쿼리 수를 줄입니다(기본값: 300). 동일한 설정에서 값을 100으로 낮추면 COCO에서 7.4ms / 51.7 mAP를 달성할 수 있습니다. 이미지당 객체 수가 더 적은 데이터셋에서는 일반적으로 mAP 하락 폭이 더 작지만, 값을 이미지당 예상되는 최대 객체 수보다 높게 설정해야 합니다.
두 설정 모두 mAP를 낮출 수 있으므로 배포 전에 데이터셋에서 절충점을 검증하세요.
from ultralytics import RTDETR

rtdetr = RTDETR("rtdetr-l.pt")
head = rtdetr.model.model[-1]

# 속도와 정확도 간의 절충점을 검증한 후 설정을 하나 또는 모두 선택하세요.
head.decoder.eval_idx = 3  # 디코더 레이어 6개 중 4개를 사용합니다.
head.num_queries = 100  # 객체 쿼리 수를 줄입니다.

results = rtdetr("path/to/image.jpg")

# 내보내기 시 TensorRT 내보내기를 포함해 동일한 디코더 및 쿼리 설정이 적용됩니다.
rtdetr.export(format="engine", device=0, quantize=16)
지원 작업 및 모드#
이 표에는 모델 유형, 해당 사전 학습 가중치, 각 모델이 지원하는 작업, 지원 여부를 ✅ 이모지로 표시한 다양한 지원 모드(학습, 검증, 예측, 내보내기)가 나와 있습니다.
| 모델 유형 | 사전 학습 가중치 | 지원 작업 | 학습 | 검증 | 추론 | 내보내기 |
|---|---|---|---|---|---|---|
| RT-DETR 대형 | rtdetr-l.pt | 객체 탐지 | ✅ | ✅ | ✅ | ✅ |
| RT-DETR 초대형 | rtdetr-x.pt | 객체 탐지 | ✅ | ✅ | ✅ | ✅ |
rtdetr-resnet50.yaml 및 rtdetr-resnet101.yaml은 YAML 아키텍처만 제공됩니다. Ultralytics는 rtdetr-l 및 rtdetr-x의 사전 학습 가중치만 공개합니다. YAML에서 ResNet 변형을 인스턴스화한 다음(예: RTDETR("rtdetr-resnet50.yaml")) 필요에 따라 학습하거나 파인튜닝하세요.
적합한 사용 사례#
RT-DETR은 높은 정확도와 실시간 성능을 모두 요구하는 애플리케이션에 특히 적합합니다.
- 자율 주행: 속도와 정확도가 모두 중요한 자율 주행 시스템에서 신뢰할 수 있는 환경 인식을 구현합니다. 자율 주행 자동차의 AI에 대해 자세히 알아보기.
- 첨단 로보틱스: 동적인 환경에서 정확한 객체 인식과 상호작용이 필요한 복잡한 작업을 로봇이 수행할 수 있도록 합니다. 로보틱스에서 AI의 역할 살펴보기.
- 의료 영상: 객체 탐지의 정밀도가 진단에 매우 중요한 의료 분야의 애플리케이션에 적합합니다. 의료 분야의 AI 알아보기.
- 감시 시스템: 높은 탐지 정확도로 실시간 모니터링을 수행해야 하는 보안 애플리케이션에 적합합니다. 보안 경보 시스템 알아보기.
- 위성 이미지 분석: 전역 맥락 이해가 중요한 고해상도 이미지의 상세 분석에 적합합니다. 위성 이미지 컴퓨터 비전에 관한 글 읽기.
인용 및 감사의 글#
연구 또는 개발 작업에서 Baidu의 RT-DETR을 사용하는 경우 원본 논문을 인용해 주세요.
@misc{lv2023detrs,
      title={DETRs Beat YOLOs on Real-time Object Detection},
      author={Wenyu Lv and Shangliang Xu and Yian Zhao and Guanzhong Wang and Jinman Wei and Cheng Cui and Yuning Du and Qingqing Dang and Yi Liu},
      year={2023},
      eprint={2304.08069},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
RTDETRv2의 경우 2024년 논문을 인용할 수 있습니다.
@misc{lv2024rtdetrv2,
      title={RTDETRv2: All-in-One Detection Transformer Beats YOLO and DINO},
      author={Wenyu Lv and Yian Zhao and Qinyao Chang and Kui Huang and Guanzhong Wang and Yi Liu},
      year={2024},
      eprint={2407.17140},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
이 유용한 리소스를 만들고 유지 관리해 주신 Baidu와 PaddlePaddle 팀에 감사드립니다. 컴퓨터 비전 커뮤니티를 위해 Vision Transformer 기반 실시간 객체 탐지기 RT-DETR을 개발하여 이 분야에 기여해 주신 점에 깊이 감사드립니다.
자주 묻는 질문#
Baidu의 실시간 탐지 Transformer(RT-DETR)는 Vision Transformer 아키텍처를 기반으로 구축된 고급 실시간 객체 탐지기입니다. 효율적인 하이브리드 인코더를 통해 스케일 내 상호작용과 스케일 간 융합을 분리하여 멀티스케일 특징을 효율적으로 처리합니다. IoU 인식 쿼리 선택을 사용해 모델이 가장 관련성 높은 객체에 집중하도록 하여 탐지 정확도를 높입니다. 재학습 없이 디코더 레이어를 조정해 추론 속도를 변경할 수 있으므로 다양한 실시간 객체 탐지 시나리오에 적합합니다. RT-DETR arXiv 논문에서 RT-DETR의 기능을 자세히 알아보세요.
Ultralytics Python API를 활용하여 사전 학습된 PaddlePaddle RT-DETR 모델을 사용할 수 있습니다. 예를 들어 COCO val2017로 사전 학습된 RT-DETR-l 모델을 로드하고 T4 GPU에서 높은 FPS를 달성하려면 다음 예제를 활용할 수 있습니다.
예제from ultralytics import RTDETR # COCO로 사전 학습된 RT-DETR-l 모델 로드 model = RTDETR("rtdetr-l.pt") # 모델 정보 표시(선택 사항) model.info() # COCO8 예제 데이터셋으로 100 에포크 동안 모델 학습 results = model.train(data="coco8.yaml", epochs=100, imgsz=640) # 'bus.jpg' 이미지에서 RT-DETR-l 모델로 추론 실행 results = model("path/to/bus.jpg")Baidu의 RT-DETR은 효율적인 하이브리드 인코더와 IoU 인식 쿼리 선택을 통해 높은 정확도를 유지하면서 연산 비용을 크게 줄인다는 점에서 차별화됩니다. 재학습 없이 서로 다른 디코더 레이어를 사용해 추론 속도를 조정할 수 있는 독특한 기능은 뛰어난 유연성을 제공합니다. 따라서 TensorRT를 사용하는 CUDA와 같은 가속 백엔드에서 실시간 성능이 필요한 애플리케이션에 특히 유리하며, 다른 여러 실시간 객체 탐지기보다 뛰어난 성능을 보입니다. Transformer 아키텍처는 기존 CNN 기반 탐지기보다 전역 맥락을 더 잘 이해할 수 있습니다.
Baidu의 RT-DETR은 재학습 없이 서로 다른 디코더 레이어를 사용하여 추론 속도를 유연하게 조정할 수 있습니다. 이러한 적응성은 다양한 실시간 객체 탐지 작업에서 성능을 확장하는 데 매우 중요합니다. 더 낮은 정밀도가 요구되는 작업에서 더 빠른 처리가 필요하든, 더 느리지만 정확한 탐지가 필요하든 RT-DETR을 특정 요구 사항에 맞게 조정할 수 있습니다. 이 기능은 연산 성능이 서로 다른 기기에 모델을 배포할 때 특히 유용합니다.
아니요. RT-DETR에서
max_det은 추론 후 반환되는 예측 수를 제한하지만, 디코더가 생성하는 객체 쿼리 수를 늘리지는 않습니다. Ultralytics의 RT-DETR 사전 학습 체크포인트는 객체 쿼리 300개를 사용하므로max_det을 더 큰 값으로 설정해도 이미지당 300개가 넘는 탐지 결과를 반환할 수 없습니다.더 적은 수의 고신뢰도 예측만 필요한 경우
max_det을 사용해 반환되는 탐지 결과를 줄일 수 있습니다(예:max_det=100). 데이터셋에 이미지당 300개가 넘는 객체가 포함될 수 있다면 모델 YAML에서 디코더 쿼리 수(nq)를 늘려 사용자 지정 RT-DETR 모델을 학습하세요. 학습 후 사전 학습 체크포인트에서 이 값을 변경하는 것은 동일한 결과를 내지 않으며, 추가 쿼리를 학습하려면 재학습이 필요합니다.