Técnicas de pré-processamento de dados anotados de visão computacional#
O pré-processamento de dados transforma imagens brutas anotadas em entradas limpas e consistentes de que um modelo de visão computacional precisa para treinar bem. Com o Ultralytics YOLO26, as operações essenciais sobre píxeis — conversão para RGB, escalonamento para [0, 1] e redimensionamento — são executadas automaticamente no pipeline de treino. Assim, o trabalho restante consiste em dividir corretamente o conjunto de dados, equilibrar as classes e escolher as ampliações. Este guia aborda estas técnicas essenciais: redimensionamento, normalização, divisão do conjunto de dados, aumento de dados e análise exploratória de dados (EDA).
Assista: Como usar o pré-processamento e o aumento de dados para melhorar a precisão do modelo em cenários reais 🚀
Esta etapa ocorre depois de definires os objetivos do projeto e recolheres e anotares os dados, e integra as primeiras fases do fluxo de trabalho de um projeto de visão computacional.
Porque é que o pré-processamento é importante#
O pré-processamento coloca os dados num formato que reduz a carga computacional e melhora o desempenho do modelo. Resolve três problemas comuns dos dados brutos:
- Ruído: variações irrelevantes ou aleatórias nos dados.
- Inconsistência: variações nos tamanhos, formatos e qualidade das imagens.
- Desequilíbrio: distribuição desigual de classes ou categorias no conjunto de dados.
Técnicas de pré-processamento#
As principais técnicas são o redimensionamento, a normalização, a divisão do conjunto de dados e o aumento de dados. No YOLO26, as duas primeiras são automáticas, enquanto as escolhas mais importantes dizem respeito à divisão e ao aumento de dados.
Redimensionar imagens#
Muitos modelos exigem um tamanho de entrada consistente, por isso o redimensionamento uniformiza as imagens e reduz a complexidade computacional. Dois métodos de interpolação comuns são:
- Interpolação bilinear: suaviza os valores dos píxeis através de uma média ponderada dos quatro píxeis mais próximos.
- Vizinho mais próximo: copia o valor do píxel mais próximo sem calcular a média — é mais rápido, mas produz uma imagem mais pixelizada.
Bibliotecas como OpenCV e PIL (Pillow) disponibilizam estas funções, mas, com YOLO26, normalmente não precisas de redimensionar as imagens manualmente. O argumento imgsz trata disso. No percurso de tamanho quadrado fixo, a validação e a inferência ajustam as imagens com letterboxing para uma entrada imgsz × imgsz, como 640 × 640, preservando a proporção e adicionando margens cinzentas (valor 114). As imagens maiores são reduzidas para caber, enquanto as imagens menores não são ampliadas quando a opção de aumento de escala está desativada. No percurso de treino predefinido, mosaic=1.0 coloca, em vez disso, quatro imagens num mosaico sobre uma tela maior e recorta-a para imgsz; quando close_mosaic desativa o mosaico nas épocas finais, as imagens recebem letterboxing e continuam a ser transformadas aleatoriamente, em vez de passarem sem alterações. Os lotes retangulares (rect=True) e multi_scale usam formas de entrada diferentes.
Normalizar os valores dos píxeis#
A normalização ajusta os valores dos píxeis a um intervalo padrão, o que ajuda o modelo a convergir mais rapidamente durante o treino. Duas técnicas comuns são:
- Escalonamento min-max: ajusta os valores dos píxeis ao intervalo de 0 a 1.
- Normalização z-score: ajusta os valores dos píxeis com base na média e no desvio padrão.
O YOLO26 trata automaticamente da normalização como parte do pipeline de pré-processamento: converte as imagens para RGB e ajusta os valores dos píxeis ao intervalo [0, 1], dividindo-os por 255 (escalonamento min-max). Por predefinição, o YOLO não aplica a normalização de média/desvio padrão ao estilo ImageNet (z-score), pelo que não é necessária nenhuma etapa de normalização manual.
Dividir o conjunto de dados#
Dividir os dados em conjuntos de treino, validação e teste permite avaliar o modelo com dados que não viu e medir a sua capacidade de generalização. Uma divisão comum é 70% para treino, 20% para validação e 10% para teste. Ferramentas como scikit-learn ou TensorFlow tornam este processo simples.
Tem estes pontos em conta ao dividir os dados:
- Mantém a distribuição das classes: garante que cada classe está representada proporcionalmente nos conjuntos de treino, validação e teste.
- Equilibra as classes: em conjuntos de dados desequilibrados, considera sobreamostrar a classe minoritária ou subamostrar a classe maioritária — apenas no conjunto de treino.
Divide o conjunto de dados antes de aplicar qualquer aumento de dados ou outro pré-processamento e aplica essas transformações apenas ao conjunto de treino. Aumentar os dados antes da divisão permite que as informações das imagens de validação ou teste influenciem o treino, produzindo pontuações artificialmente elevadas que caem perante dados do mundo real.
Aumentar o conjunto de dados#
O aumento de dados aumenta artificialmente o tamanho de um conjunto de dados, criando versões modificadas das imagens existentes. Ajuda a reduzir o sobreajuste e melhora a generalização, com várias vantagens:
- Modelos mais robustos: variações na iluminação, orientação e escala tornam o modelo mais resiliente a distorções do mundo real.
- Rentável: expande o conjunto de treino sem recolher e rotular dados novos.
- Melhor aproveitamento dos dados: cada imagem anotada gera várias versões de treino.
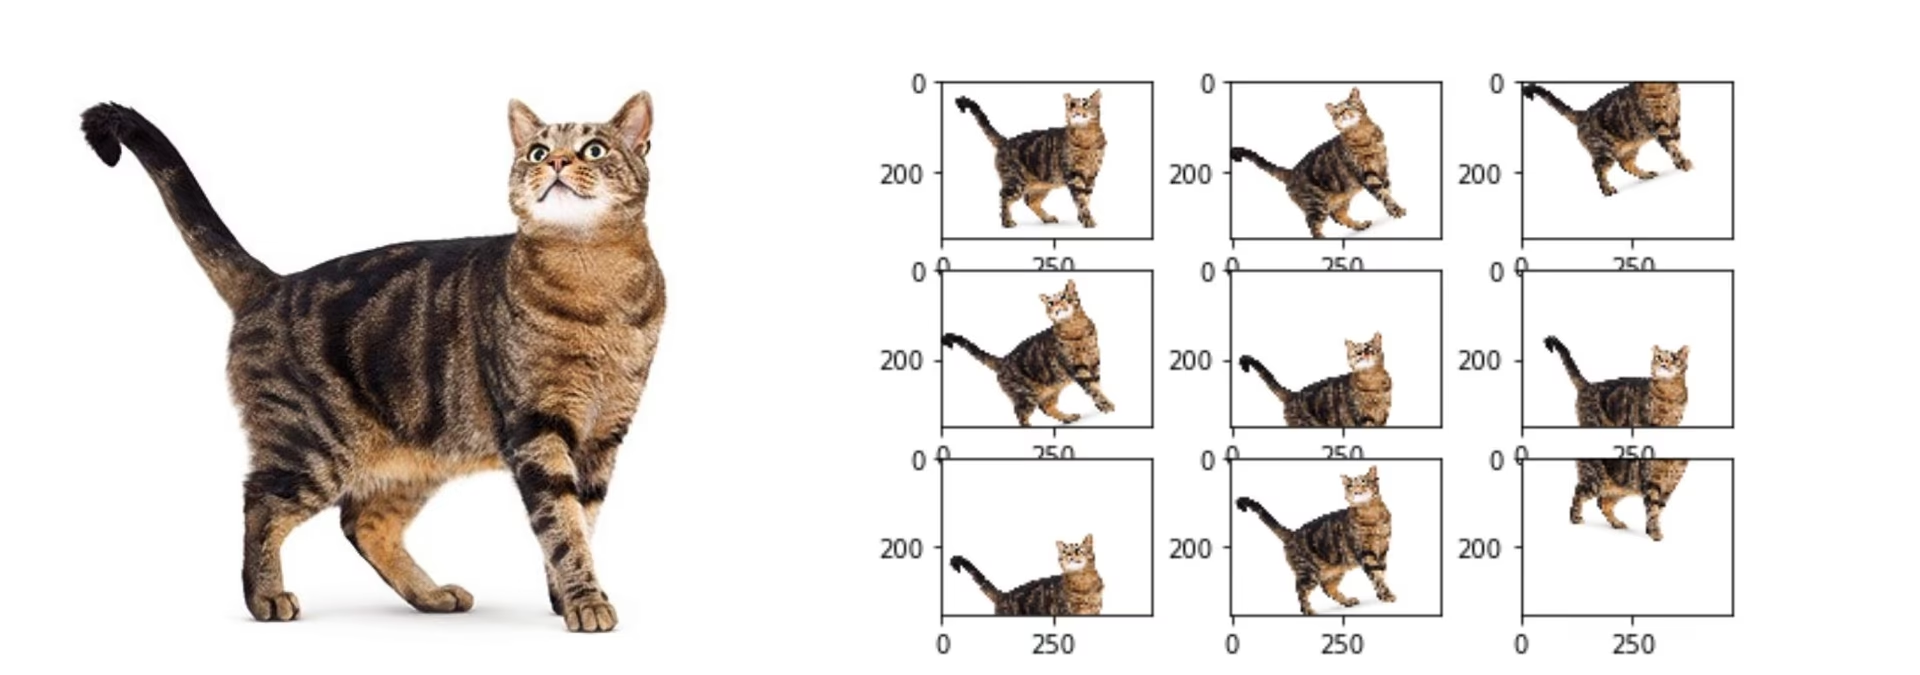
No YOLO26, a intensidade do aumento de dados é controlada através dos argumentos de treino passados a model.train() ou das flags CLI equivalentes, não através da edição do YAML do conjunto de dados, que define metadados como caminhos, nomes de classes e divisões. A única exceção é flip_idx: os conjuntos de dados de pose declaram-no no YAML do conjunto de dados para mapear pares de pontos-chave esquerdo/direito, e o YOLO desativa completamente fliplr e flipud quando esse elemento está em falta. Os aumentos integrados incluem:
- Mosaico, MixUp e CutMix (
mosaic,mixup,cutmix): combinam várias imagens numa única amostra de treino. - Inversões (
fliplr,flipud): espelham as imagens na horizontal ou na vertical. - Transformações geométricas (
degrees,translate,scale,shear,perspective): rodam, deslocam, ampliam e deformam as imagens. - Variação de cor HSV (
hsv_h,hsv_s,hsv_v): varia a tonalidade, a saturação e o brilho. - Copiar e colar (
copy_paste): cola cópias adicionais de objetos segmentados, espelhadas por predefinição na mesma imagem ou retiradas de outra imagem comcopy_paste_mode=mixup. - Troca de canais (
bgr): troca a ordem dos canais RGB para BGR. - Transformações de classificação (
auto_augment,erasing): aplica uma política de aumento automatizada e apagamento aleatório durante o treino de um classificador.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# A ampliação é configurada com argumentos de treino, não no YAML do conjunto de dados
model.train(data="coco8.yaml", epochs=10, hsv_h=0.015, fliplr=0.5, mosaic=1.0, degrees=10.0)
Para obter a lista completa dos argumentos de aumento de dados e dos respetivos valores predefinidos, consulta a referência de definições de aumento de dados e o guia de aumento de dados do YOLO dedicado. Se o pacote albumentations estiver instalado, o YOLO também ativa automaticamente os aumentos integrados baseados em Albumentations.
Estudo de caso: pré-processamento para deteção de veículos#
Considera um projeto para detetar e classificar veículos em imagens de trânsito com YOLO26, usando imagens anotadas com caixas delimitadoras e rótulos. Eis como se concretiza cada decisão de pré-processamento:
- Redimensionamento: não é necessário trabalho manual — o YOLO26 redimensiona para
imgszdurante o treino. - Normalização: não é necessário trabalho manual — o YOLO26 ajusta automaticamente os valores dos píxeis para
[0, 1]. - Divisão: divide o conjunto de dados em 70% para treino, 20% para validação e 10% para teste, mantendo a distribuição das classes consistente entre as divisões.
- Aumento de dados: define argumentos de treino adequados a cenários de trânsito — por exemplo,
fliplrpara invariância à direção,hsv_vpara iluminação diurna/noturna emosaicpara densidades de objetos variadas.
Com estas decisões tomadas, o conjunto de dados está pronto para a análise exploratória de dados (EDA).
Análise exploratória de dados (EDA)#
A EDA usa estatísticas e visualizações para revelar padrões e distribuições nos dados, ajudando a detetar problemas como o desequilíbrio de classes ou valores atípicos antes do treino.
Técnicas estatísticas de EDA#
A EDA estatística começa por métricas básicas — média, mediana, desvio padrão e amplitude — calculadas sobre propriedades como as distribuições da intensidade dos píxeis. Estas métricas dão uma visão geral rápida da qualidade do conjunto de dados e revelam irregularidades numa fase inicial.
Técnicas visuais de EDA#
As visualizações revelam padrões que as estatísticas sumárias não mostram, como o desequilíbrio de classes e os valores atípicos. Entre as ferramentas comuns estão:
- Histogramas e diagramas de caixa: mostram a distribuição dos valores dos píxeis e assinalam valores atípicos nas distribuições de intensidade ou de características.
- Gráficos de barras: revelam o desequilíbrio de classes ao comparar o número de exemplos de cada classe.
- Gráficos de dispersão: exploram relações entre características das imagens ou anotações.
- Mapas de calor: visualizam as distribuições da intensidade dos píxeis ou a distribuição espacial das anotações nas imagens.
Ultralytics Platform para EDA#
Para fazer EDA sem código, carrega o conjunto de dados para a Ultralytics Platform. O separador Charts do conjunto de dados gera automaticamente visualizações essenciais de EDA: distribuição das divisões, contagens das principais classes, histogramas da largura/altura das imagens e mapas de calor 2D das posições das anotações e das dimensões das imagens. O separador Images permite explorar os dados em grelha, numa vista compacta ou em tabela, com sobreposições das anotações, facilitando a deteção de exemplos mal rotulados ou de classes desequilibradas sem escrever código.
Conclusão#
Dados divididos, normalizados e aumentados corretamente reduzem o ruído e melhoram a generalização, transformando uma coleção bruta de imagens num conjunto de treino fiável. Com o conjunto de dados pré-processado, o passo seguinte é treinar o modelo. Se surgirem dúvidas pelo caminho, pergunta à comunidade no repositório do Ultralytics no GitHub ou no servidor do Ultralytics no Discord.
Perguntas frequentes#
O pré-processamento garante que os dados estão limpos, consistentes e num formato otimizado para o treino. Ao resolver problemas de ruído, inconsistência e desequilíbrio de classes nos dados brutos, etapas como o redimensionamento, a normalização, o aumento de dados e a divisão do conjunto de dados reduzem a carga computacional e melhoram o desempenho do modelo. Consulta as etapas de um projeto de visão computacional para perceber como se enquadra no fluxo de trabalho mais amplo.
Configura o aumento de dados através dos argumentos de treino, não do YAML do conjunto de dados. Passa argumentos como
fliplr,mosaic,hsv_hedegreesparamodel.train()(ou usa as flags CLI equivalentes) para definir a probabilidade e a intensidade de cada transformação. Estes argumentos estão definidos nas definições de aumento de dados e são explicados no guia de aumento de dados do YOLO. Os conjuntos de dados de pose são uma exceção: o mapeamento de pontos-chaveflip_idxfica no YAML do conjunto de dados e as inversões são desativadas quando esse mapeamento está em falta.As duas técnicas mais comuns são o escalonamento min-max (redimensionar os píxeis para o intervalo de 0 a 1) e a normalização z-score (redimensionar com base na média e no desvio padrão). O YOLO26 aplica automaticamente o escalonamento min-max — convertendo as imagens para RGB e dividindo os valores dos píxeis por 255 —, pelo que não precisas de uma etapa de normalização manual. Por predefinição, não aplica a normalização z-score.
Uma prática comum é reservar 70% para treino, 20% para validação e 10% para teste. Mantém a distribuição das classes nas três divisões e evita a fuga de dados, aplicando o aumento de dados apenas ao conjunto de treino, depois da divisão. Ferramentas como scikit-learn ou TensorFlow dividem os dados de forma eficiente. Consulta o guia de recolha e anotação de dados para informações sobre a preparação prévia do conjunto de dados.
Sim. O argumento
imgszcontrola o tamanho de entrada pretendido, sem necessidade de trabalho manual. No percurso de tamanho quadrado fixo, a validação e a inferência ajustam as imagens com letterboxing para a forma especificada, preservando a proporção; as imagens maiores são reduzidas para caber, enquanto as imagens menores não são ampliadas quando a opção de aumento de escala está desativada. Durante o treino, o aumento de dados de mosaico predefinido atinge o tamanho pretendido colocando quatro imagens num mosaico e recortando-as. Os lotes retangulares (rect=True) emulti_scaleusam formas de entrada diferentes. Consulta a documentação de treino de modelos para mais detalhes.