Entenda as principais etapas de um projeto de visão computacional
Desenvolver um projeto de visão computacional envolve seguir uma sequência clara de etapas: definir seus objetivos, coletar e anotar dados, treinar e avaliar um modelo e implantá-lo e mantê-lo em produção. Este guia percorre cada etapa na ordem e explica sua importância, para que você possa planejar e executar seu próprio projeto com confiança.
A visão computacional é um subcampo da inteligência artificial (AI) que ajuda os computadores a ver e entender o mundo como os seres humanos. Ela processa e analisa imagens ou vídeos para extrair informações, reconhecer padrões e tomar decisões com base nesses dados.
Assiste: Como desenvolver projetos de visão computacional | Um guia passo a passo
Técnicas de visão computacional, como detecção de objetos, classificação de imagens e segmentação de instâncias, podem ser aplicadas em vários setores, da condução autônoma à imagiologia médica, para obter insights valiosos.
Visão geral de um projeto de visão computacional#
Antes de falar dos detalhes de cada etapa de um projeto de visão computacional, vamos ver o processo geral. Se você começasse hoje um projeto de visão computacional, seguiria estas etapas:
- Sua primeira prioridade é entender os requisitos do seu projeto.
- Em seguida, você coleta e rotula com precisão as imagens que ajudarão a treinar seu modelo.
- Depois, você limpa e aumenta seus dados para prepará-los para o treinamento do modelo.
- Após o treinamento, você avalia e testa seu modelo minuciosamente para garantir que ele tenha um desempenho consistente em diferentes condições.
- Por fim, você implanta seu modelo no mundo real e o monitora e mantém com base em novos insights e feedback.
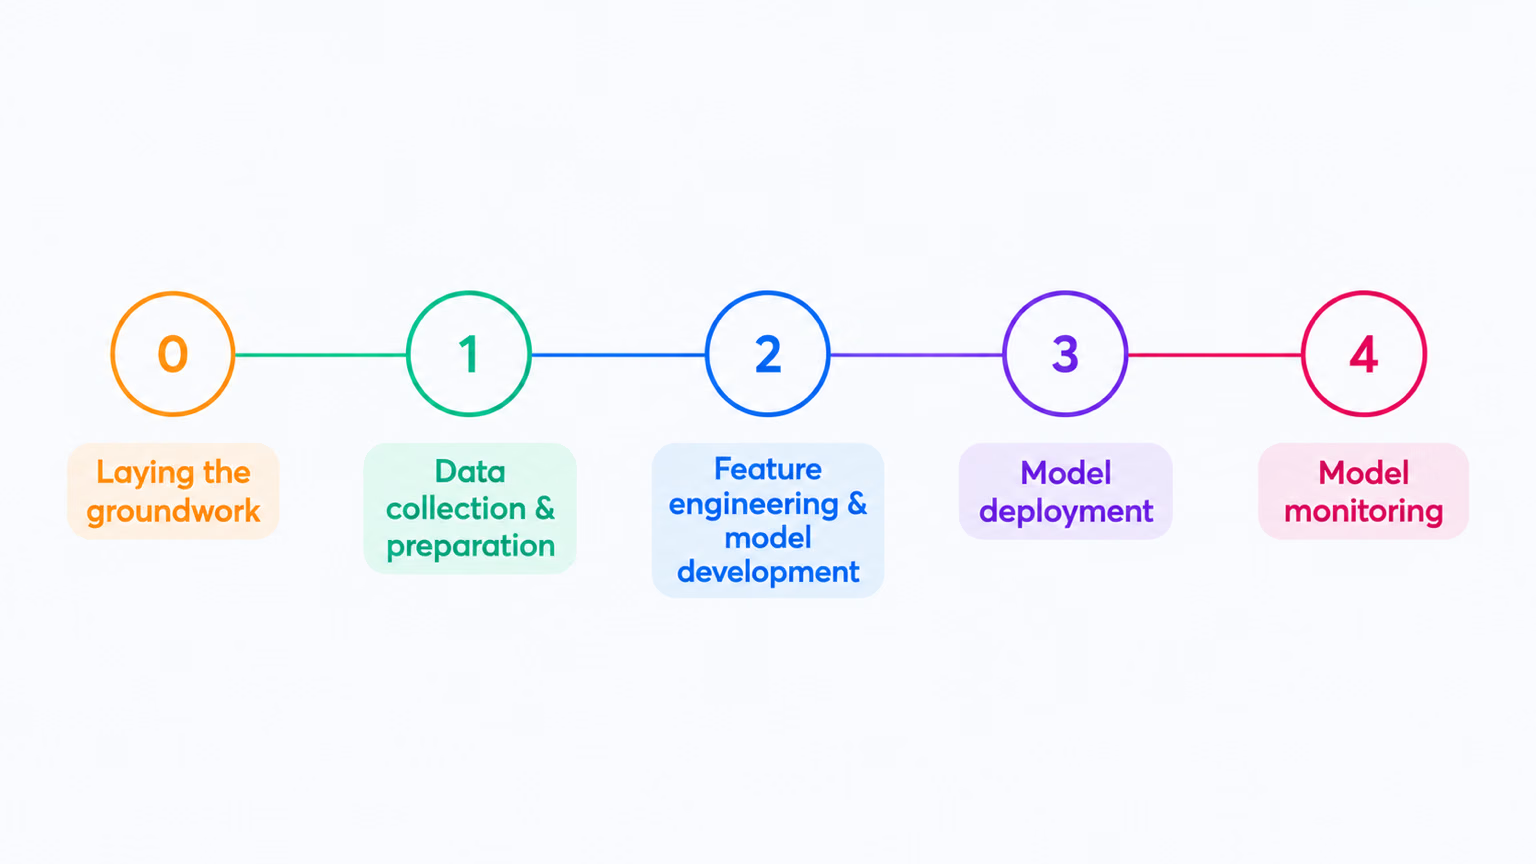
Agora que já sabes o que esperar, as secções abaixo abordam cada etapa em detalhe.
Etapa 1: definição dos objetivos do seu projeto#
O primeiro passo de qualquer projeto de visão computacional é definir claramente o problema que estás a tentar resolver. Conhecer o objetivo final ajuda-te a começar a criar uma solução. Isto é particularmente importante em visão computacional, porque o objetivo do teu projeto afeta diretamente a tarefa de visão computacional na qual deves concentrar-te.
Veja alguns exemplos de objetivos de projeto e das tarefas de visão computacional que podem ser usadas para alcançá-los:
-
Objetivo: desenvolver um sistema capaz de monitorar e gerenciar o fluxo de diferentes tipos de veículos em rodovias, melhorando a gestão do tráfego e a segurança.
- Tarefa de visão computacional: a detecção de objetos é ideal para o monitoramento do tráfego porque localiza e identifica vários veículos com eficiência. Ela exige menos recursos computacionais do que a segmentação de imagens, que fornece detalhes desnecessários para essa tarefa, garantindo uma análise mais rápida e em tempo real.
-
Objetivo: desenvolver uma ferramenta que ajude radiologistas, fornecendo contornos precisos de tumores em nível de pixel em exames de imagem médica.
- Tarefa de visão computacional: A segmentação de imagens é adequada para exames médicos porque fornece limites precisos e detalhados dos tumores, fundamentais para avaliar o tamanho e a forma, além de planejar o tratamento.
-
Objetivo: Criar um sistema digital que categorize vários documentos (por exemplo, faturas, recibos e documentos jurídicos) para melhorar a eficiência organizacional e a recuperação de documentos.
- Tarefa de visão computacional: A classificação de imagens é ideal neste caso, pois processa um documento de cada vez, sem precisar considerar a posição do documento na imagem. Essa abordagem simplifica e acelera o processo de classificação.
Selecionar o modelo e a abordagem de treinamento adequados#
Depois de compreender o objetivo do projeto e as tarefas de visão computacional adequadas, uma parte essencial da definição da meta do projeto é selecionar o modelo e a abordagem de treinamento adequados.
Dependendo do objetivo, você pode escolher o modelo primeiro ou depois de ver quais dados consegue coletar na Etapa 2. Por exemplo, suponha que seu projeto dependa muito da disponibilidade de tipos específicos de dados. Nesse caso, pode ser mais prático coletar e analisar os dados primeiro, antes de selecionar um modelo. Por outro lado, se você entende claramente os requisitos do modelo, pode escolher o modelo primeiro e, em seguida, coletar dados que atendam a essas especificações.
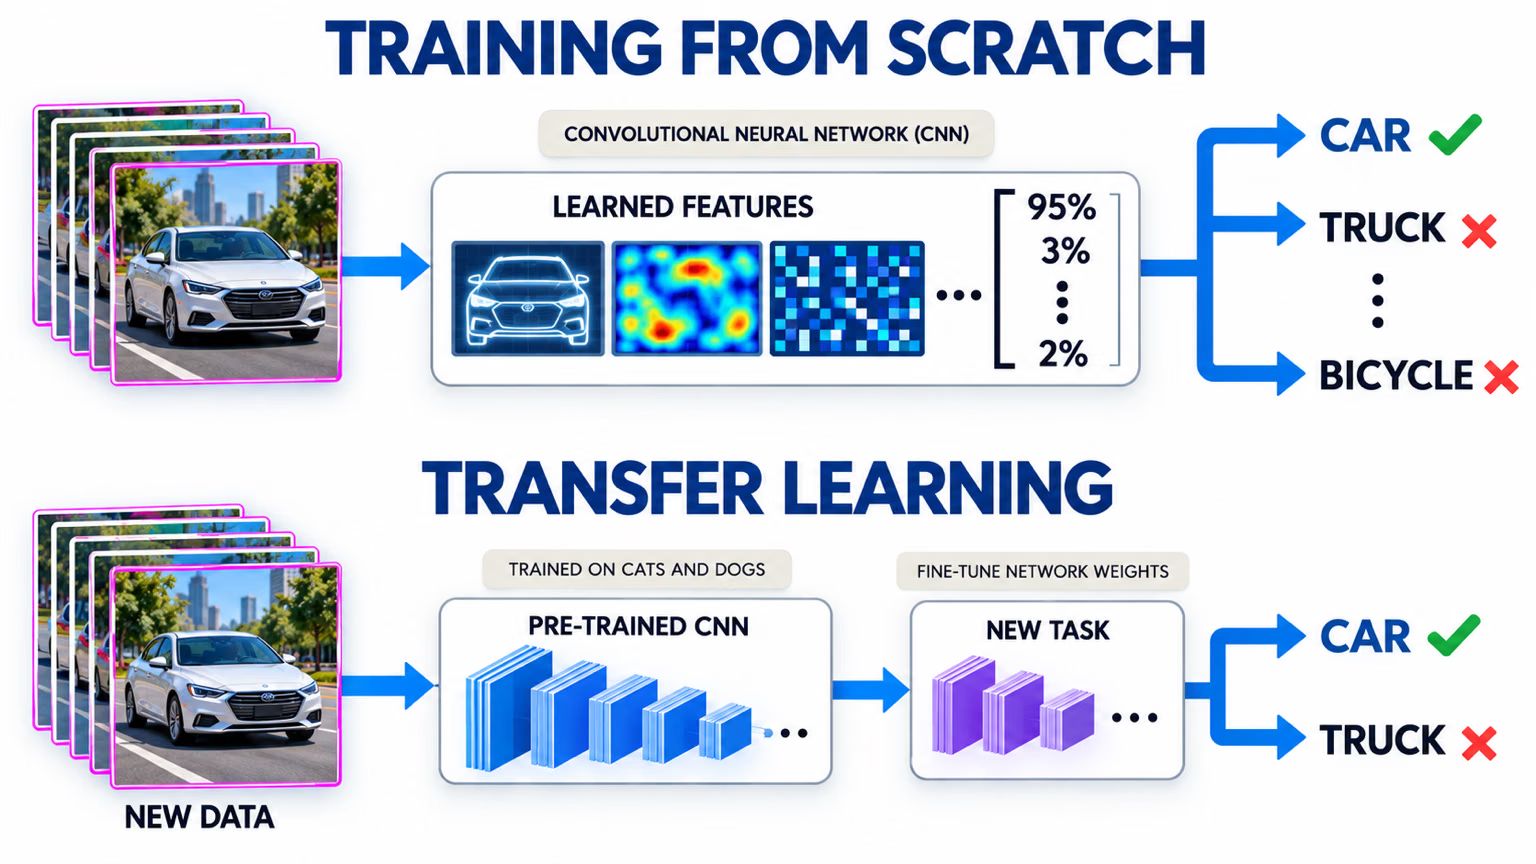
Escolher entre treinar do zero ou usar aprendizado por transferência afeta a forma como você prepara os dados. Treinar do zero exige um conjunto de dados diversificado para desenvolver o entendimento do modelo desde os princípios básicos. Já o aprendizado por transferência permite usar um modelo pré-treinado e adaptá-lo com um conjunto de dados menor e mais específico. Além disso, escolher um modelo específico para treinar determina como você precisa preparar os dados, por exemplo, redimensionando as imagens ou adicionando anotações de acordo com os requisitos específicos do modelo.
Considere o destino de implantação do modelo para garantir compatibilidade e desempenho. Por exemplo, modelos leves são ideais para computação de borda graças à eficiência em dispositivos com recursos limitados.
Para saber mais, leia nosso guia sobre como definir as metas do seu projeto e selecionar o modelo adequado.
Antes de começar o trabalho prático em um projeto de visão computacional, é importante entender claramente esses detalhes. Antes de passar para a Etapa 2, confira se você considerou o seguinte:
- Defina claramente o problema que você está tentando resolver.
- Determine o objetivo final do seu projeto.
- Identifique a tarefa específica de visão computacional necessária (por exemplo, detecção de objetos, classificação de imagens ou segmentação de imagens).
- Decida se você vai treinar um modelo do zero ou usar aprendizado por transferência.
- Selecione o modelo adequado para sua tarefa e suas necessidades de implantação.
Etapa 2: Coleta e anotação de dados#
A qualidade dos teus modelos de visão computacional depende da qualidade do teu conjunto de dados. Podes recolher imagens da Internet, tirar as tuas próprias fotografias ou usar conjuntos de dados existentes. Entre as fontes úteis de conjuntos de dados públicos estão o Google Dataset Search Engine, o UC Irvine Machine Learning Repository e os Kaggle Datasets.
Algumas bibliotecas, como Ultralytics, oferecem suporte integrado para vários conjuntos de dados, facilitando o início do trabalho com dados de alta qualidade. Estas bibliotecas incluem frequentemente utilitários para transferir e carregar conjuntos de dados populares, o que pode poupar bastante tempo e esforço nas etapas iniciais do teu projeto.
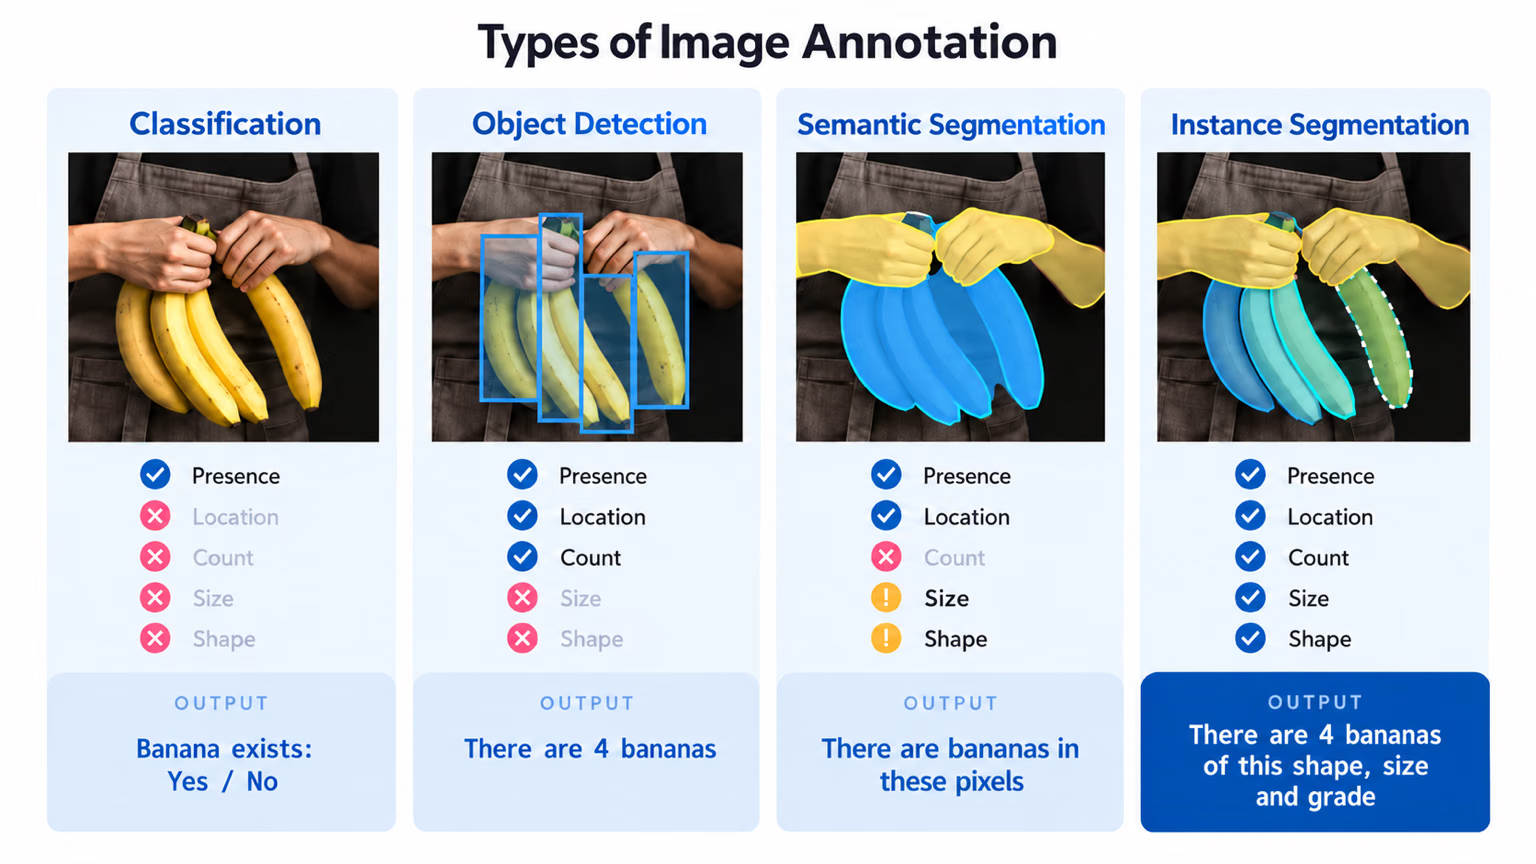
No entanto, se você optar por coletar imagens ou tirar suas próprias fotos, precisará anotar os dados. A anotação de dados é o processo de rotular os dados para ensinar o modelo. O tipo de anotação de dados que você usará depende da técnica de visão computacional específica. Confira alguns exemplos:
- Classificação de imagens: Você rotula a imagem inteira como uma única classe.
- Detecção de objetos: Você desenha caixas delimitadoras ao redor de cada objeto na imagem e rotula cada caixa.
- Segmentação de imagens: Você rotula cada pixel da imagem de acordo com o objeto ao qual pertence, criando limites detalhados dos objetos.
A coleta e anotação de dados pode exigir muito trabalho manual e demorado. Uma ferramenta de anotação dedicada agiliza esse processo: a Ultralytics Platform oferece um editor de anotações integrado com anotação inteligente baseada em SAM para dados de detecção, segmentação e OBB, salvando os rótulos diretamente no formato YOLO.
Etapa 3: Aumento de dados e divisão do conjunto de dados#
Depois de coletar e anotar os dados de imagem, é importante primeiro dividir o conjunto de dados em conjuntos de treinamento, validação e teste antes de fazer o aumento de dados. Dividir o conjunto de dados antes do aumento é fundamental para testar e validar o modelo com dados originais e inalterados. Isso ajuda a avaliar com precisão o quanto o modelo generaliza para dados novos e ainda não vistos.
Veja como dividir os dados:
- Conjunto de treinamento: É a maior parte dos dados, normalmente 70-80% do total, usada para treinar o modelo.
- Conjunto de validação: Normalmente corresponde a cerca de 10-15% dos dados; esse conjunto é usado para ajustar hiperparâmetros e validar o modelo durante o treinamento, ajudando a evitar sobreajuste.
- Conjunto de teste: Os 10-15% restantes dos dados são reservados para o conjunto de teste. Ele é usado para avaliar o desempenho do modelo em dados ainda não vistos depois que o treinamento termina.
Depois de dividir os dados, você pode fazer aumento de dados aplicando transformações como rotação, redimensionamento e inversão de imagens para aumentar artificialmente o tamanho do conjunto de dados. O aumento de dados torna o modelo mais robusto a variações e melhora o desempenho em imagens ainda não vistas.
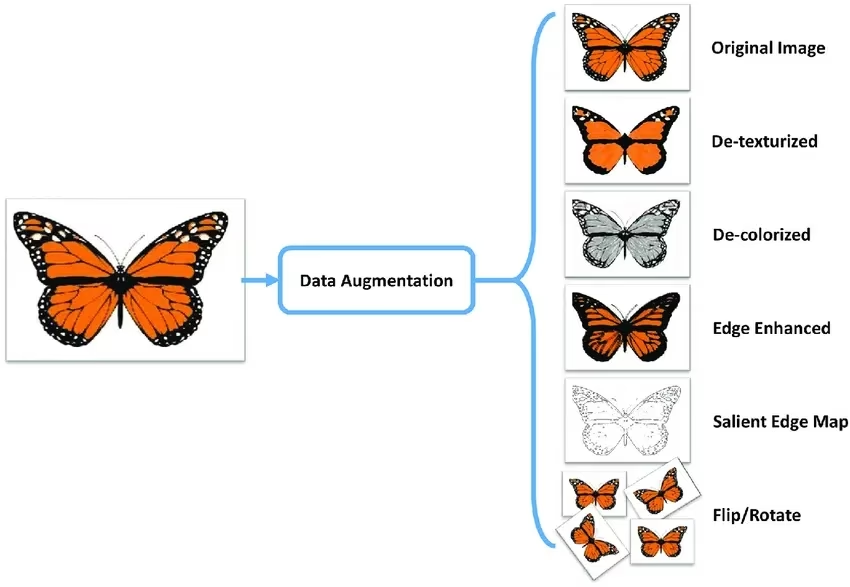
Bibliotecas como OpenCV, Albumentations e TensorFlow oferecem funções flexíveis de aumento de dados que podes usar. Além disso, algumas bibliotecas, como Ultralytics, têm definições de aumento de dados integradas diretamente na função de treino dos modelos, simplificando o processo.
Para compreender melhor os teus dados, podes usar ferramentas como Matplotlib ou Seaborn para visualizar as imagens e analisar a sua distribuição e características. Visualizar os dados ajuda a identificar padrões, anomalias e a eficácia das técnicas de aumento de dados. O separador Charts da Ultralytics Platform pode revelar muitas destas informações sem código, gerando automaticamente a distribuição das divisões, as contagens de classes, histogramas das dimensões das imagens e mapas de calor das posições das anotações para cada conjunto de dados carregado.
Ao entender, dividir e aumentar os dados corretamente, você pode desenvolver um modelo bem treinado, validado e testado, com bom desempenho em aplicações do mundo real.
Etapa 4: Treinamento do modelo#
Quando o conjunto de dados estiver pronto para o treinamento, você poderá se concentrar em configurar o ambiente necessário, gerenciar os conjuntos de dados e treinar o modelo.
Primeiro, você precisa garantir que o ambiente esteja configurado corretamente. Normalmente, isso inclui o seguinte:
- Instalar bibliotecas e frameworks essenciais, como TensorFlow, PyTorch ou Ultralytics.
- Se você estiver usando uma GPU, instalar bibliotecas como CUDA e cuDNN ajudará a habilitar a aceleração por GPU e agilizar o processo de treinamento.
Em seguida, você pode carregar os conjuntos de dados de treinamento e validação no ambiente. Normalize e pré-processe os dados redimensionando-os, convertendo o formato ou aplicando aumento de dados. Depois de selecionar o modelo, configure as camadas e especifique os hiperparâmetros. Compile o modelo definindo a função de perda, o otimizador e as métricas de desempenho.
Bibliotecas como Ultralytics simplificam o processo de treinamento. Você pode iniciar o treinamento fornecendo dados ao modelo com o mínimo de código. Essas bibliotecas ajustam os pesos, executam a retropropagação e fazem a validação automaticamente. Elas também oferecem ferramentas para acompanhar o progresso e ajustar hiperparâmetros com facilidade. Depois do treinamento, salve o modelo e seus pesos com alguns comandos.
É importante ter em mente que o gerenciamento adequado do conjunto de dados é essencial para um treinamento eficiente. Use o controle de versões dos conjuntos de dados para acompanhar alterações e garantir a reprodutibilidade. Ferramentas como DVC (Controle de versão de dados) podem ajudar a gerenciar conjuntos de dados grandes.
Etapa 5: Avaliação e ajuste fino do modelo#
É importante avaliar o desempenho do modelo usando várias métricas e refiná-lo para melhorar a precisão. A avaliação ajuda a identificar os pontos fortes do modelo e onde ele pode precisar de melhorias. O ajuste fino garante que o modelo seja otimizado para obter o melhor desempenho possível.
- Métricas de desempenho: usa métricas como precisão, precisão, revocação e pontuação F1 para avaliar o desempenho do teu modelo. Estas métricas dão-te uma ideia da qualidade das previsões do modelo.
- Ajuste de hiperparâmetros: Ajuste os hiperparâmetros para otimizar o desempenho do modelo. Técnicas como busca em grade ou busca aleatória podem ajudar a encontrar os melhores valores de hiperparâmetros.
- Ajuste fino: Faça pequenos ajustes na arquitetura do modelo ou no processo de treinamento para melhorar o desempenho. Isso pode envolver o ajuste das taxas de aprendizado, dos tamanhos de lote ou de outros parâmetros do modelo.
Para entender melhor a avaliação de modelos e as técnicas de ajuste fino, confira nosso guia de informações sobre avaliação de modelos.
Etapa 6: Teste do modelo#
O teste do modelo confirma se ele tem bom desempenho em dados completamente novos, verificando se está pronto para implantação. A diferença entre o teste e a avaliação do modelo é que o teste se concentra em verificar o desempenho do modelo final, em vez de melhorá-lo de forma iterativa.
É importante testar e depurar cuidadosamente quaisquer problemas comuns que possam surgir. Teste o modelo com um conjunto de dados de teste separado, que não tenha sido usado durante o treinamento nem a validação. Esse conjunto de dados deve representar cenários do mundo real para garantir que o desempenho do modelo seja consistente e confiável.
Além disso, resolva problemas comuns como sobreajuste, subajuste e vazamento de dados. Use técnicas como validação cruzada para identificar esses problemas. Para conhecer estratégias abrangentes de teste, consulte nosso guia de testes de modelos.
Etapa 7: Implantação do modelo#
Depois de testar o modelo a fundo, é hora de implantá-lo. A implantação de modelos consiste em disponibilizar o modelo para uso em um ambiente de produção. Veja as etapas para implantar um modelo de visão computacional:
- Configuração do ambiente: Configure a infraestrutura necessária para a opção de implantação escolhida, seja baseada na nuvem (AWS, Google Cloud, Azure) ou na borda (dispositivos locais, IoT).
- Exportação do modelo: Exporte o modelo para o formato adequado (por exemplo, ONNX, TensorRT, CoreML para YOLO26) para garantir a compatibilidade com a plataforma de implantação.
- Implantação do modelo: Implante o modelo configurando APIs ou endpoints e integrando-o à aplicação.
- Garantia de escalabilidade: Implemente balanceadores de carga, grupos de dimensionamento automático e ferramentas de monitoramento para gerenciar recursos e lidar com o aumento de dados e solicitações de usuários.
A Ultralytics Platform também oferece endpoints de implantação gerenciados em 42 regiões do mundo, com redução automática da escala a zero por padrão e configuração automática da infraestrutura.
Etapa 8: Monitoramento, manutenção e documentação#
Depois que o modelo for implantado, é importante monitorar continuamente seu desempenho, fazer a manutenção para resolver possíveis problemas e documentar todo o processo para consultas e melhorias futuras.
As ferramentas de monitorização podem ajudar-te a acompanhar os principais indicadores de desempenho (KPIs) e a detetar anomalias ou quedas de precisão. Ao monitorizares o modelo, podes identificar a deriva do modelo, quando o desempenho diminui ao longo do tempo devido a alterações nos dados de entrada. Volta a treinar o modelo periodicamente com dados atualizados para manter a precisão e a relevância.
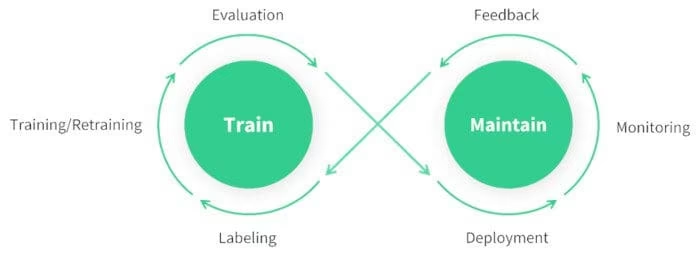
Além do monitoramento e da manutenção, a documentação também é fundamental. Documente todo o processo detalhadamente, incluindo a arquitetura do modelo, os procedimentos de treinamento, os hiperparâmetros, as etapas de pré-processamento dos dados e quaisquer alterações feitas durante a implantação e a manutenção. Uma boa documentação garante a reprodutibilidade e facilita futuras atualizações ou a solução de problemas. Ao monitorar, manter e documentar seu modelo com eficiência, você garante que ele continue preciso, confiável e fácil de gerenciar ao longo de todo o ciclo de vida.
Participação na comunidade#
Conectar-se com uma comunidade de entusiastas de visão computacional pode ajudar você a enfrentar com confiança quaisquer problemas que encontrar ao trabalhar no seu projeto de visão computacional. Veja algumas maneiras de aprender, solucionar problemas e fazer contatos com eficiência.
Recursos da comunidade#
- Problemas no GitHub: Confira o repositório do YOLO26 no GitHub e use a aba Issues para fazer perguntas, relatar bugs e sugerir novos recursos. A comunidade ativa e os responsáveis pela manutenção estão disponíveis para ajudar com problemas específicos.
- Servidor do Ultralytics no Discord: Participe do servidor do Ultralytics no Discord para interagir com outros usuários e desenvolvedores, receber suporte e compartilhar conhecimentos.
Usar esses recursos ajudará você a superar desafios e acompanhar as últimas tendências e práticas recomendadas da comunidade de visão computacional.
Próximas etapas#
Agora você tem um roteiro para cada etapa de um projeto de visão computacional, desde a definição das metas até o monitoramento de um modelo implantado. Coloque-o em prática treinando seu primeiro modelo YOLO ou explore mais a fundo qualquer etapa nos guias acima. Para executar todo o pipeline sem escrever código, conheça a Ultralytics Platform.
Perguntas frequentes#
A escolha da tarefa de visão computacional adequada depende do objetivo final do seu projeto. Por exemplo, se você quiser monitorar o trânsito, a detecção de objetos é uma opção adequada, pois localiza e identifica vários tipos de veículos em tempo real. Para imagens médicas, a segmentação de imagens é ideal para fornecer limites detalhados de tumores, contribuindo para o diagnóstico e o planejamento do tratamento.
A anotação de dados é essencial para ensinar o modelo a reconhecer padrões. O tipo de anotação varia conforme a tarefa:
- Classificação de imagens: A imagem inteira é rotulada como uma única classe.
- Detecção de objetos: São desenhadas caixas delimitadoras ao redor dos objetos.
- Segmentação de imagens: Cada pixel é rotulado de acordo com o objeto ao qual pertence.
O editor de anotações integrado à Ultralytics Platform pode ajudar nesse processo.
Dividir o conjunto de dados antes do aumento ajuda a validar o desempenho do modelo com dados originais e inalterados. Siga estas etapas:
- Conjunto de treinamento: 70-80% dos seus dados.
- Conjunto de validação: 10-15% para ajuste de hiperparâmetros.
- Conjunto de teste: Os 10-15% restantes para a avaliação final.
Depois de dividir o conjunto de dados, aplique técnicas de aumento de dados, como rotação, redimensionamento e inversão, para aumentar a diversidade. Bibliotecas como Albumentations e OpenCV podem ajudar. A Ultralytics também oferece configurações de aumento de dados integradas para facilitar o processo.
Exporte o modelo treinado usando o método
exporte escolha um formato compatível com o destino de implantação. A Ultralytics oferece suporte a vários formatos, incluindo ONNX, TensorRT e CoreML. Para exportar seu modelo YOLO26, siga estas etapas:- Use o método
exportcom o parâmetro do formato desejado. - Verifique se o modelo exportado atende às especificações do ambiente de implantação (por exemplo, dispositivos de borda ou nuvem).
Para obter mais informações, confira o guia de exportação de modelos.
- Use o método
O monitoramento e a manutenção contínuos são essenciais para o sucesso do modelo a longo prazo. Implemente ferramentas para acompanhar os principais indicadores de desempenho (KPIs) e detectar anomalias. Treine o modelo novamente com dados atualizados regularmente para combater a deriva do modelo. Documente todo o processo, incluindo a arquitetura do modelo, os hiperparâmetros e as alterações, para garantir a reprodutibilidade e facilitar futuras atualizações. Saiba mais no nosso guia de monitoramento e manutenção.


Comentários2
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
VeeranjaneyuluToka
what is the best way of verifying if the chosen model is right fit for the given dataset or problem statement. Is it just based on evaluation metrics or can we use kind of approach to verify based on the feature maps or heat map visualization if the model is really learning the features that it needs to be learnt.
 Glenn JocherUltralytics
Great question! You're absolutely right that evaluation metrics alone don't tell the whole story. Here are several approaches to verify if your model is truly learning the right features:
Beyond Evaluation Metrics:
- Feature visualization and heat maps (like Grad-CAM, LIME) help you see what regions the model focuses on during predictions
- Activation maps show which features activate at different layers, revealing what the model has learned
- Confusion matrices reveal specific class prediction patterns and potential biases
Practical Verification Approaches:
- Test on edge cases and adversarial examples to understand model robustness
- Cross-validation across different data splits to ensure consistent performance
- Error analysis by examining misclassified samples to identify systematic issues
- Domain adaptation testing on slightly different datasets to check generalization
For YOLO11 specifically:
- Use validation visualizations during training to see bounding box predictions
- Monitor training curves for signs of overfitting or underfitting
- Test inference on diverse real-world scenarios beyond your test set
The key is combining quantitative metrics with qualitative analysis - if your model achieves high accuracy but the heat maps show it's focusing on irrelevant background features instead of the actual objects, that's a red flag even with good metrics.
Would you like specific guidance on implementing any of these visualization techniques with your current project?