Inferência segura para threads com modelos YOLO
Para executar inferências do Ultralytics YOLO com segurança em threads Python, instancia um modelo YOLO separado dentro de cada thread, em vez de partilhar uma única instância entre elas. Partilhar um único modelo causa condições de corrida que corrompem o seu estado interno e produzem resultados imprevisíveis, pois o módulo threading do Python executa as threads em simultâneo sobre o mesmo objeto. Este guia explica por que motivo a partilha falha, mostra o padrão seguro com uma instância por thread e aborda o decorador ThreadingLocked para os casos em que é necessário partilhar uma instância.
Vai diretamente para o motivo pelo qual a partilha de um modelo falha, o padrão seguro para threads ou o decorador ThreadingLocked.
Assista: Como executar inferência thread-safe com modelos Ultralytics YOLO em Python | Multithreading 🚀
Compreender as threads do Python#
As threads de Python permitem que o teu programa execute várias operações em simultâneo. No entanto, o Global Interpreter Lock (GIL) do Python faz com que apenas uma thread possa executar bytecode de Python de cada vez.
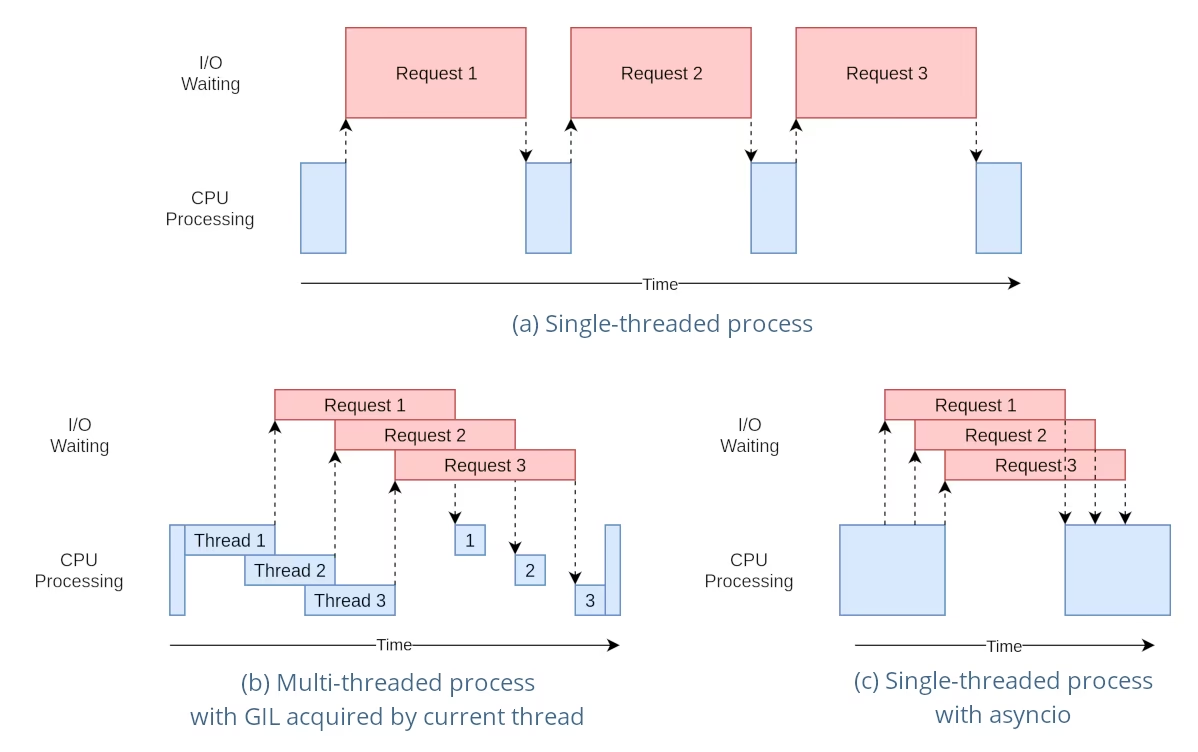
Embora isto pareça uma limitação, as threads ainda podem proporcionar concorrência, sobretudo em operações limitadas por E/S ou quando se usam operações que libertam o GIL, como as executadas pelas bibliotecas C subjacentes ao YOLO.
O perigo de partilhar instâncias de modelos#
Instanciar um modelo YOLO fora das tuas threads e partilhar essa instância entre várias threads pode causar condições de corrida, nas quais o estado interno do modelo é modificado de forma inconsistente devido a acessos simultâneos. Isto é especialmente problemático quando o modelo ou os seus componentes mantêm um estado que não foi concebido para ser seguro para threads.
Exemplo não seguro para threads: uma única instância de modelo#
Ao usar threads em Python, é importante reconhecer os padrões que podem causar problemas de concorrência. Eis o que deves evitar: partilhar uma única instância do modelo YOLO26 entre várias threads.
# Inseguro: partilhar uma única instância de modelo entre threads
from threading import Thread

from ultralytics import YOLO

# Instanciar o modelo fora da thread
shared_model = YOLO("yolo26n.pt")

def predict(image_path):
    """Predicts objects in an image using a preloaded YOLO model, take path string to image as argument."""
    results = shared_model.predict(image_path)
    # Processa os resultados

# Iniciar threads que partilham a mesma instância de modelo
Thread(target=predict, args=("image1.jpg",)).start()
Thread(target=predict, args=("image2.jpg",)).start()
No exemplo acima, ambas as threads compartilham shared_model. Cada chamada de predict mantém seus próprios argumentos, como conf, iou e imgsz, mas as chamadas que usam o mesmo preditor são executadas uma de cada vez, protegidas pelo bloqueio dele, então as threads aproveitam pouco o paralelismo. O estado que reside na instância, como o estado do rastreador, os vocabulários set_classes do YOLOE ou os prompts do SAM, FastSAM e YOLOE, continua compartilhado por todas as threads, então use uma instância própria para cada thread nesses casos.
Exemplo seguro: uma instância dedicada por thread#
É seguro ter várias instâncias de modelo separadas, desde que cada thread seja proprietária da sua instância e nunca a partilhe com outra thread. Não importa que as instâncias abaixo sejam criadas antes de as threads começarem — o único padrão inseguro é partilhar uma instância entre threads:
# Seguro: cada thread usa a sua própria instância de modelo dedicada
from threading import Thread

from ultralytics import YOLO

# Instanciar um modelo por thread
model_1 = YOLO("yolo26n.pt")
model_2 = YOLO("yolo26n.pt")

def predict(model, image_path):
    """Runs prediction on an image using a specified YOLO model, returning the results."""
    results = model.predict(image_path)
    # Processa os resultados

# Cada thread usa uma instância de modelo separada e dedicada
Thread(target=predict, args=(model_1, "image1.jpg")).start()
Thread(target=predict, args=(model_2, "image2.jpg")).start()
Como cada thread trabalha com a sua própria instância dedicada, não há estado de modelo partilhado que as threads possam corromper. Instanciar o modelo dentro de cada thread, como mostrado a seguir, é simplesmente a forma mais fácil de garantir que uma instância nunca é partilhada acidentalmente.
Inferência segura para threads#
Para executar inferências seguras para threads, deves instanciar um modelo YOLO separado dentro de cada thread. Assim, cada thread terá a sua própria instância de modelo isolada, eliminando o risco de condições de corrida.
Exemplo seguro para threads#
Eis como instanciar um modelo YOLO dentro de cada thread para executar inferências paralelas com segurança:
# Seguro: instanciar um único modelo dentro de cada thread
from threading import Thread

from ultralytics import YOLO

def thread_safe_predict(image_path):
    """Predict on an image using a new YOLO model instance in a thread-safe manner; takes image path as input."""
    local_model = YOLO("yolo26n.pt")
    results = local_model.predict(image_path)
    # Processa os resultados

# Inicia threads, cada uma com sua própria instância do modelo
Thread(target=thread_safe_predict, args=("image1.jpg",)).start()
Thread(target=thread_safe_predict, args=("image2.jpg",)).start()
Neste exemplo, cada thread cria a sua própria instância YOLO. Isto impede que uma thread interfira com o estado do modelo de outra e garante que cada thread executa inferências com segurança e sem interações inesperadas com as outras threads.
Usar o decorador ThreadingLocked#
A Ultralytics fornece um decorador ThreadingLocked que pode ser usado para garantir a execução segura para threads de funções. Este decorador usa um bloqueio para garantir que apenas uma thread de cada vez pode executar a função decorada.
from ultralytics import YOLO
from ultralytics.utils import ThreadingLocked

# Criar uma instância de modelo
model = YOLO("yolo26n.pt")

# Aplicar o decorador à função de previsão para a tornar segura para threads
@ThreadingLocked()
def thread_safe_predict(image_path):
    """Thread-safe prediction using a shared model instance."""
    results = model.predict(image_path)
    return results

# Agora podes chamar esta função com segurança a partir de várias threads
O decorador ThreadingLocked é particularmente útil quando precisas de partilhar uma instância de modelo entre threads, mas queres garantir que apenas uma thread pode aceder à instância de cada vez.
Partilhar uma instância de modelo protegida por bloqueio poupa memória em comparação com carregar um modelo em cada thread, mas reduz a concorrência, porque as threads ficam serializadas pelo bloqueio e aguardam a sua vez. Prefere o padrão de uma instância por thread quando tiveres memória disponível e quiseres o máximo paralelismo; usa ThreadingLocked quando a memória do modelo for o fator limitante.
Conclusão#
Ao usar modelos YOLO com threading do Python, atribui a cada thread a sua própria instância de modelo dedicada e nunca partilhes uma instância entre threads. Instanciar o modelo dentro da thread que o utiliza é a forma mais simples de garantir isso, evitar condições de corrida e manter a fiabilidade das tarefas de inferência.
Para cenários mais avançados e para otimizar ainda mais o desempenho das inferências multithread, considera usar paralelismo baseado em processos com multiprocessing ou recorrer a uma fila de tarefas com processos de trabalho dedicados.
Perguntas frequentes#
Para evitar condições de corrida ao usar modelos Ultralytics YOLO num ambiente Python multithread, instancia um modelo YOLO separado em cada thread. Assim, cada thread tem a sua própria instância de modelo isolada, evitando alterações simultâneas ao estado do modelo.
Exemplo:
from threading import Thread from ultralytics import YOLO def thread_safe_predict(image_path): """Predict on an image in a thread-safe manner.""" local_model = YOLO("yolo26n.pt") results = local_model.predict(image_path) # Processa os resultados Thread(target=thread_safe_predict, args=("image1.jpg",)).start() Thread(target=thread_safe_predict, args=("image2.jpg",)).start()Para executar inferências multithread com modelos YOLO em Python com segurança, segue estas práticas recomendadas:
- Instancia modelos YOLO dentro de cada thread, em vez de partilhar uma única instância entre threads.
- Usa o módulo
multiprocessingdo Python para processamento paralelo e evita problemas relacionados com o Bloqueio Global do Interpretador (GIL). - Lembra-te de que as bibliotecas C subjacentes ao YOLO (PyTorch, OpenCV) libertam automaticamente o GIL durante cálculos intensivos, pelo que as threads ainda podem executar inferências em simultâneo.
- Considera usar o decorador
ThreadingLockedpara instâncias de modelos partilhadas quando a memória for uma preocupação.
Exemplo de instanciação de modelo segura para threads:
from threading import Thread

from ultralytics import YOLO

def thread_safe_predict(image_path):
    """Runs inference in a thread-safe manner with a new YOLO model instance."""
    local_model = YOLO("yolo26n.pt")
    results = local_model.predict(image_path)
    # Processa os resultados

# Iniciar várias threads
Thread(target=thread_safe_predict, args=("image1.jpg",)).start()
Thread(target=thread_safe_predict, args=("image2.jpg",)).start()
Para mais contexto, consulta a secção sobre inferência segura para threads.
Cada thread deve ter a sua própria instância de modelo YOLO para evitar condições de corrida. Quando uma única instância de modelo é partilhada entre várias threads, os acessos simultâneos podem causar um comportamento imprevisível e modificar o estado interno do modelo. Ao usar instâncias separadas, garantes o isolamento entre threads e tornas as tarefas multithread fiáveis e seguras.
Para obter orientações detalhadas, consulta as secções Exemplo não seguro para threads: uma única instância de modelo e Exemplo seguro para threads.
O Bloqueio Global do Interpretador (GIL) do Python permite que apenas uma thread execute bytecode Python de cada vez, o que pode limitar o desempenho de tarefas multithread limitadas pela CPU. No entanto, ainda é possível obter concorrência em operações limitadas por E/S ou em processos que usam bibliotecas que libertam o GIL, como as bibliotecas C subjacentes ao YOLO. Para melhorar o desempenho, considera usar paralelismo baseado em processos com o módulo
multiprocessingdo Python.Para saber mais sobre threads em Python, consulta a secção Compreender as threads do Python.
Sim, usar o módulo
multiprocessingdo Python é mais seguro e muitas vezes mais eficiente para executar inferências com modelos YOLO em paralelo. O paralelismo baseado em processos cria espaços de memória separados, evitando o Bloqueio Global do Interpretador (GIL) e reduzindo o risco de problemas de concorrência. Cada processo funciona de forma independente e tem a sua própria instância de modelo YOLO.


Comentários12
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
amani784
I used a YOLOv8 model optimized with TensorRT on an AWS machine with a Tesla T4 GPU to detect people in multiple videos. The model is loaded once per process using an initializer function. To improve performance, I parallelized the video processing using 4 processes from the multiprocessing module, where each process handles one video and performs inference using model.predict() on frames sampled at regular intervals. However, this approach led to a decrease in overall performance, with slower processing time per frame and reduced FPS. Is this normal, and if not, what is the solution?
warptengood
I have a few questions:
- Does the rules about thread-safety apply in the same way to TensorRT/ONNX inference of YOLO?
- Should I have the shared model for all threads when using TensorRT YOLO? (In case the answer for the 1st question is 'No'.)
- Is it true that it is better to have
streamparameter to be set toFalsewhen performing inference on TensorRT (inpredict()) - How
torch.cuda.Stream()affects the performance of multi-threading/multi-processing when used onpredict()/track()functions? - Should I have any sort of warm up for TensorRT inference before utilizing a model in any thread/process? (Like making inference on dummy input)
P.S: I want to thank all the Ultralytics team for their kindness and open-mindedness when it comes to help and support their community. You guys are always eager to help. And I don't care if it is some AI agent that's replying or a real person, I am very grateful for you for what you guys doing :D
 Glenn JocherUltralytics
@KenesYerassyl Thank you for your great questions about thread safety with TensorRT/ONNX models. Let me address each one:
-
Yes, the thread-safety principles apply similarly to TensorRT/ONNX models, but with important distinctions. TensorRT engines have their own memory management which can introduce additional concurrency concerns.
-
For TensorRT models, it's generally safer to use separate engine instances per thread or use a thread locking mechanism like our
ThreadingLockeddecorator. TensorRT engines maintain internal state during inference that can cause issues with concurrent access. -
Setting
stream=Falsefor TensorRT inference is often beneficial as it ensures complete processing of each input before handling another, which can help avoid resource conflicts in multi-threaded environments. -
Using
torch.cuda.Stream()with multi-threading can improve performance by allowing parallel execution of CUDA operations across different streams. However, you need to carefully manage synchronization points to prevent race conditions. Each thread should ideally use a separate CUDA stream. -
Yes, warming up TensorRT models is highly recommended. The first inference typically takes longer due to CUDA context initialization and memory allocations. Running inference on a dummy input before deploying in production or multi-threaded environments ensures consistent performance.
Thank you for your kind words about our team! We're committed to supporting the community with helpful resources and guidance.
-
Thank you very much for such a comprehensive reply!
mrbulb
Hello, is there any example code that uses Python's multiprocessing for YOLO model inference?
 Paula DerrengerUltralytics
@mrbulb for using Python's multiprocessing with YOLO model inference, you should instantiate a separate YOLO model within each process to avoid race conditions. This ensures each process has its own isolated model instance. For detailed guidance, please refer to our Thread-Safe Inference with YOLO Models page. If you need a specific code example, feel free to ask!
farrostaufiqur
how to use results differently for each thread?
- Paula DerrengerUltralytics
To use results differently for each thread, ensure each thread instantiates its own YOLO model instance. This prevents race conditions and ensures thread safety. For more details, please refer to our Thread-Safe Inference with YOLO Models guide.
ghost
Hello. Thanks for the info. I have a question, If I run in two terminals the same python script, but to two different videos, both processes still suffer from GIL ?
- Glenn JocherUltralytics
@cawilchesp running the same Python script in two separate terminals for different videos won't suffer from GIL issues, as each process has its own Python interpreter and memory space. This effectively bypasses the GIL, allowing true parallel execution. For more details, you can check out our guide on thread-safe inference: https://docs.ultralytics.com/guides/yolo-thread-safe-inference/.
abysshal
So what is the best practice for single-threaded processing with asyncio? For example, gunicron+gevent+flask is used to deal with highly concurrent requests, and only one Yolo model instance will be created in each worker process. Here we do not handle threads manually, we only provide the predict function for callback from gevent. Then will the predict function of the same model instance be called again on the next request when it is not completed due to an I/O wait operation on the current request? How we handle this safely? Does it matter if cpu of gpu is used for inference?
- Glenn JocherUltralytics(editado)
@abysshal when using an asynchronous server like Gunicorn with Gevent and Flask, you're dealing with a cooperative multitasking environment. In such an environment, the context switches occur at well-defined points, typically I/O operations or explicit yield points. This means that your predict function will not be preempted in the middle of execution by another request unless it hits an I/O wait or a yield.
Here's how you can handle this safely:
-
Single Model Instance: Since you're creating only one YOLO model instance per worker process, you need to ensure that the predict function is designed to be re-entrant. This means that if the function is called again while a previous call is waiting for I/O, it should not cause any conflicts or unexpected behavior.
-
Asyncio Compatibility: If you're using asyncio, you should ensure that the predict function and any other code that might run concurrently are compatible with asyncio's event loop. This means using
awaitfor I/O-bound operations and ensuring that any libraries you use within the predict function are also compatible with asyncio. -
Thread Safety: Even though you're not manually handling threads, the underlying implementation of some libraries (like PyTorch) may use threads for certain operations. A single Ultralytics
YOLOmodel instance is not thread-safe, so do not share one instance across threads. Use one instance per thread or worker, or wrap the shared call with theThreadingLockeddecorator (see the thread-safe inference guide). -
Resource Locking: If there are shared resources that need to be accessed or modified during the predict function, you should use appropriate locking mechanisms to prevent race conditions. However, in an async environment, you should use async-compatible locks like
asyncio.Lock. -
CPU vs. GPU Inference: The choice between CPU and GPU can affect performance but should not affect the thread safety or the async behavior of your application. However, if you're using a GPU, you need to ensure that the library you're using for YOLO supports concurrent model inference on the GPU without conflicts.
-
Testing: Test your application under load to ensure that it behaves correctly with concurrent requests. You can use tools like
locustorab(Apache Bench) to simulate high concurrency and check for any race conditions or deadlocks.
In summary, when using Gunicorn with Gevent and Flask, you should ensure that your predict function is re-entrant and compatible with asyncio, use async-compatible locks if necessary, and test your application under load. The choice of CPU or GPU should not affect the thread safety of your application, but you should ensure that your YOLO model library supports concurrent inference on your chosen hardware.
1 -