Датасет SKU-110K
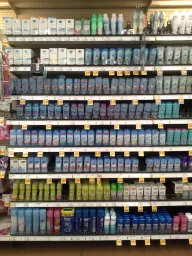
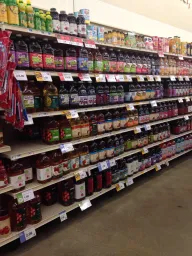
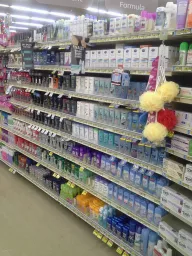
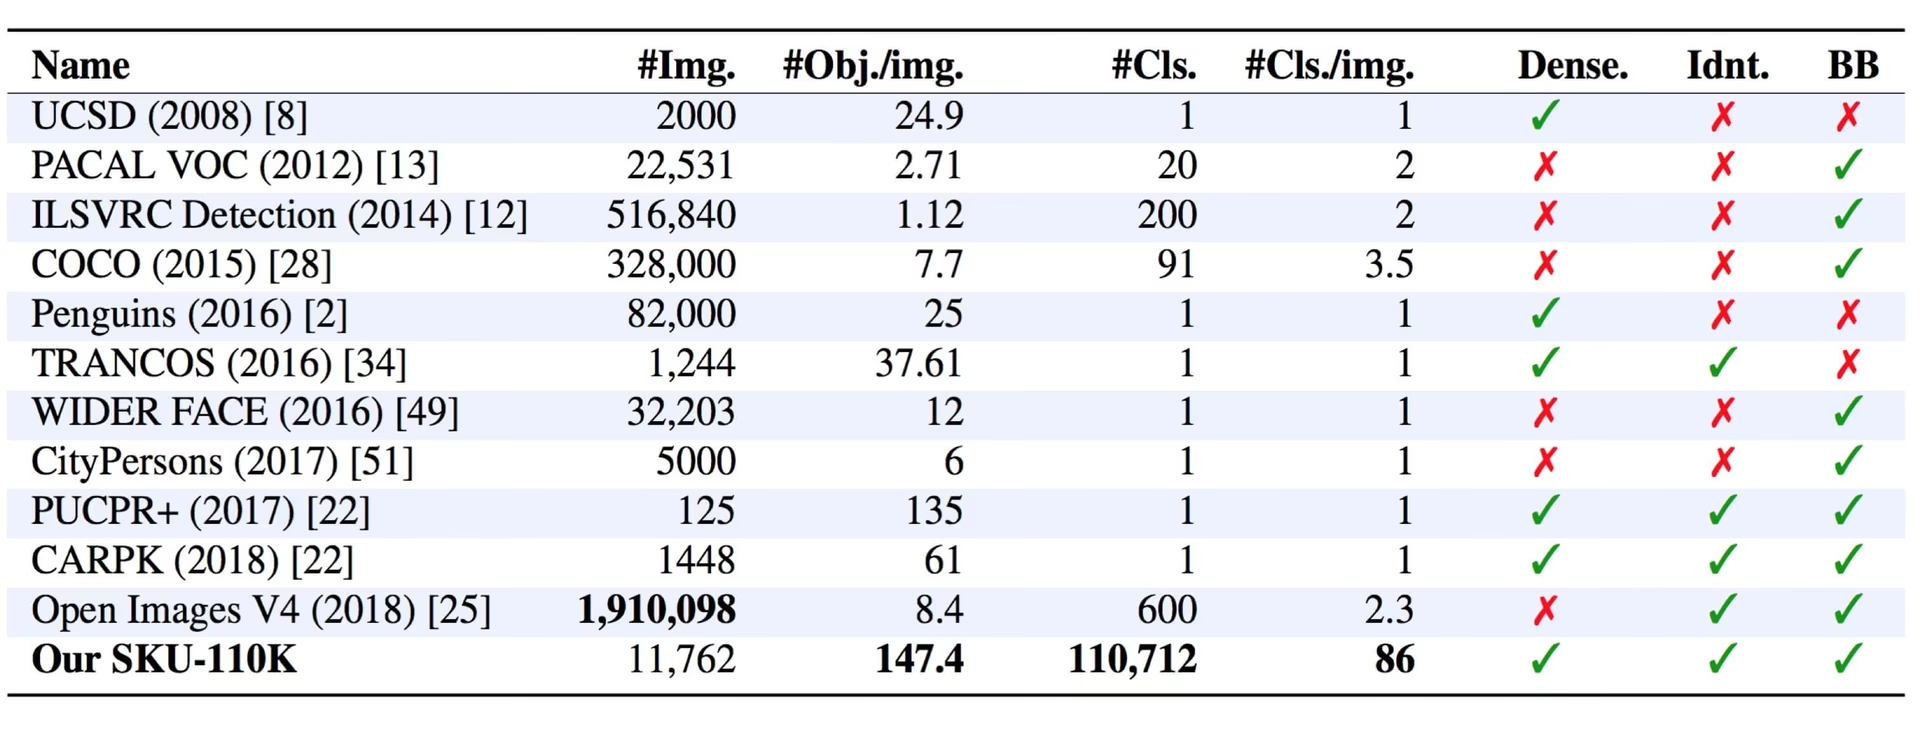
Датасет SKU-110K — это датасет для обнаружения объектов с одним классом, включающий 11 743 изображения торговых полок с высокой плотностью товаров. Он разделён на 8 219 изображений для обучения, 588 для валидации и 2 936 для тестирования. Каждый товар размечен одним ограничивающим прямоугольником в рамках единственного класса object — название отсылает к более чем 110 000 уникальных товарных единиц (SKUs), запечатлённых на изображениях, а не к 110 000 классам обнаружения. Датасет создан Эраном Голдманом и соавторами для статьи CVPR 2019 Точное обнаружение в плотно заполненных сценах. В нём более 1,7 миллиона размеченных товаров — в среднем около 147 на изображение, — что делает его сложным тестом для моделей компьютерного зрения в переполненных торговых пространствах.
Смотри: Как обучить Ultralytics YOLO26 обнаруживать все товары на полке магазина | SKU-110K 🛒
Основные особенности#
- Обнаружение объектов одного класса: Каждый товар размечен одним ограничивающим прямоугольником в рамках единственного класса
object(names: {0: object}); аннотации не содержат категорий для отдельных SKU. - Экстремальная плотность объектов: На изображениях торговых полок со всего мира в среднем около 147 плотно расположенных товаров. Часто рядом друг с другом находятся похожие или даже идентичные объекты.
- Большой масштаб: Более 110 000 уникальных SKU и свыше 1,7 миллиона размеченных ограничивающих прямоугольников на 11 743 изображениях — серьёзное испытание для современных детекторов объектов.
Структура набора данных#
Датасет SKU-110K разделён на три подмножества, в каждом из которых используется один класс object:
| Подвыборка | Изображения | Описание |
|---|---|---|
| Обучение | 8,219 | Изображения и аннотации для обучения модели |
| Валидация | 588 | Отложенные изображения для оценки во время обучения |
| Тестовая | 2,936 | Изображения для итоговой оценки обученной модели |
Применение#
Датасет SKU-110K широко используют для обучения и оценки моделей глубокого обучения в задачах обнаружения объектов, особенно в плотно заполненных сценах, например на торговых полках. Среди его применений:
- Управление товарными запасами и автоматизация розничной торговли
- Распознавание товаров на платформах электронной коммерции
- Проверка соответствия планограмме
- Системы самообслуживания в магазинах
- Роботизированный отбор и сортировка товаров на складах
Чтобы размечать собственные изображения полок, обучать модели и управлять датасетами для обнаружения товаров в рознице прямо в браузере, выполни весь рабочий процесс на платформе Ultralytics.
Файл YAML набора данных#
Файл SKU-110K.yaml задаёт конфигурацию датасета: пути к данным, названия классов и другие метаданные. Файл поддерживается в репозитории Ultralytics: https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/SKU-110K.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# SKU-110K retail items dataset https://github.com/eg4000/SKU110K_CVPR19 by Trax Retail
# Documentation: https://docs.ultralytics.com/datasets/detect/sku-110k
# Example usage: yolo train data=SKU-110K.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── SKU-110K ← downloads here (13.6 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: SKU-110K # dataset root dir
train: train.txt # train images (relative to 'path') 8219 images
val: val.txt # val images (relative to 'path') 588 images
test: test.txt # test images (optional) 2936 images

# Classes
names:
  0: object

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import shutil
  from pathlib import Path

  import numpy as np
  import polars as pl

  from ultralytics.utils import TQDM
  from ultralytics.utils.downloads import download
  from ultralytics.utils.ops import xyxy2xywh

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  parent = Path(dir.parent)  # download dir
  urls = ["http://trax-geometry.s3.amazonaws.com/cvpr_challenge/SKU110K_fixed.tar.gz"]
  download(urls, dir=parent)

  # Rename directories
  if dir.exists():
      shutil.rmtree(dir)
  (parent / "SKU110K_fixed").rename(dir)  # rename dir
  (dir / "labels").mkdir(parents=True, exist_ok=True)  # create labels dir

  # Convert labels
  names = "image", "x1", "y1", "x2", "y2", "class", "image_width", "image_height"  # column names
  for d in "annotations_train.csv", "annotations_val.csv", "annotations_test.csv":
      x = pl.read_csv(dir / "annotations" / d, has_header=False, new_columns=names, infer_schema_length=None).to_numpy()  # annotations
      images, unique_images = x[:, 0], np.unique(x[:, 0])
      with open((dir / d).with_suffix(".txt").__str__().replace("annotations_", ""), "w", encoding="utf-8") as f:
          f.writelines(f"./images/{s}\n" for s in unique_images)
      for im in TQDM(unique_images, desc=f"Converting {dir / d}"):
          cls = 0  # single-class dataset
          with open((dir / "labels" / im).with_suffix(".txt"), "a", encoding="utf-8") as f:
              for r in x[images == im]:
                  w, h = r[6], r[7]  # image width, height
                  xywh = xyxy2xywh(np.array([[r[1] / w, r[2] / h, r[3] / w, r[4] / h]]))[0]  # instance
f.write(f"{cls} {xywh[0]:.5f} {xywh[1]:.5f} {xywh[2]:.5f} {xywh[3]:.5f}\n") # write labelИспользование#
SKU-110K автоматически скачивается при первом запуске обучения. Для 11 743 изображений потребуется около 13,6 ГБ свободного места на диске. Скрипт загрузки также скачивает исходные аннотации и преобразует их в формат YOLO; процесс может занять несколько минут.
Чтобы обучить модель YOLO26n на датасете SKU-110K в течение 100 эпох с размером изображения 640, используй следующие фрагменты кода.
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n.pt")  # загрузить предварительно обученную модель (рекомендуется для обучения)

# Обучить модель
results = model.train(data="SKU-110K.yaml", epochs=100, imgsz=640)
Примеры данных и аннотаций#
На изображениях SKU-110K показаны плотно расположенные товары на настоящих магазинных полках, где рядом стоят десятки почти одинаковых предметов. Вот пример изображения с аннотациями:
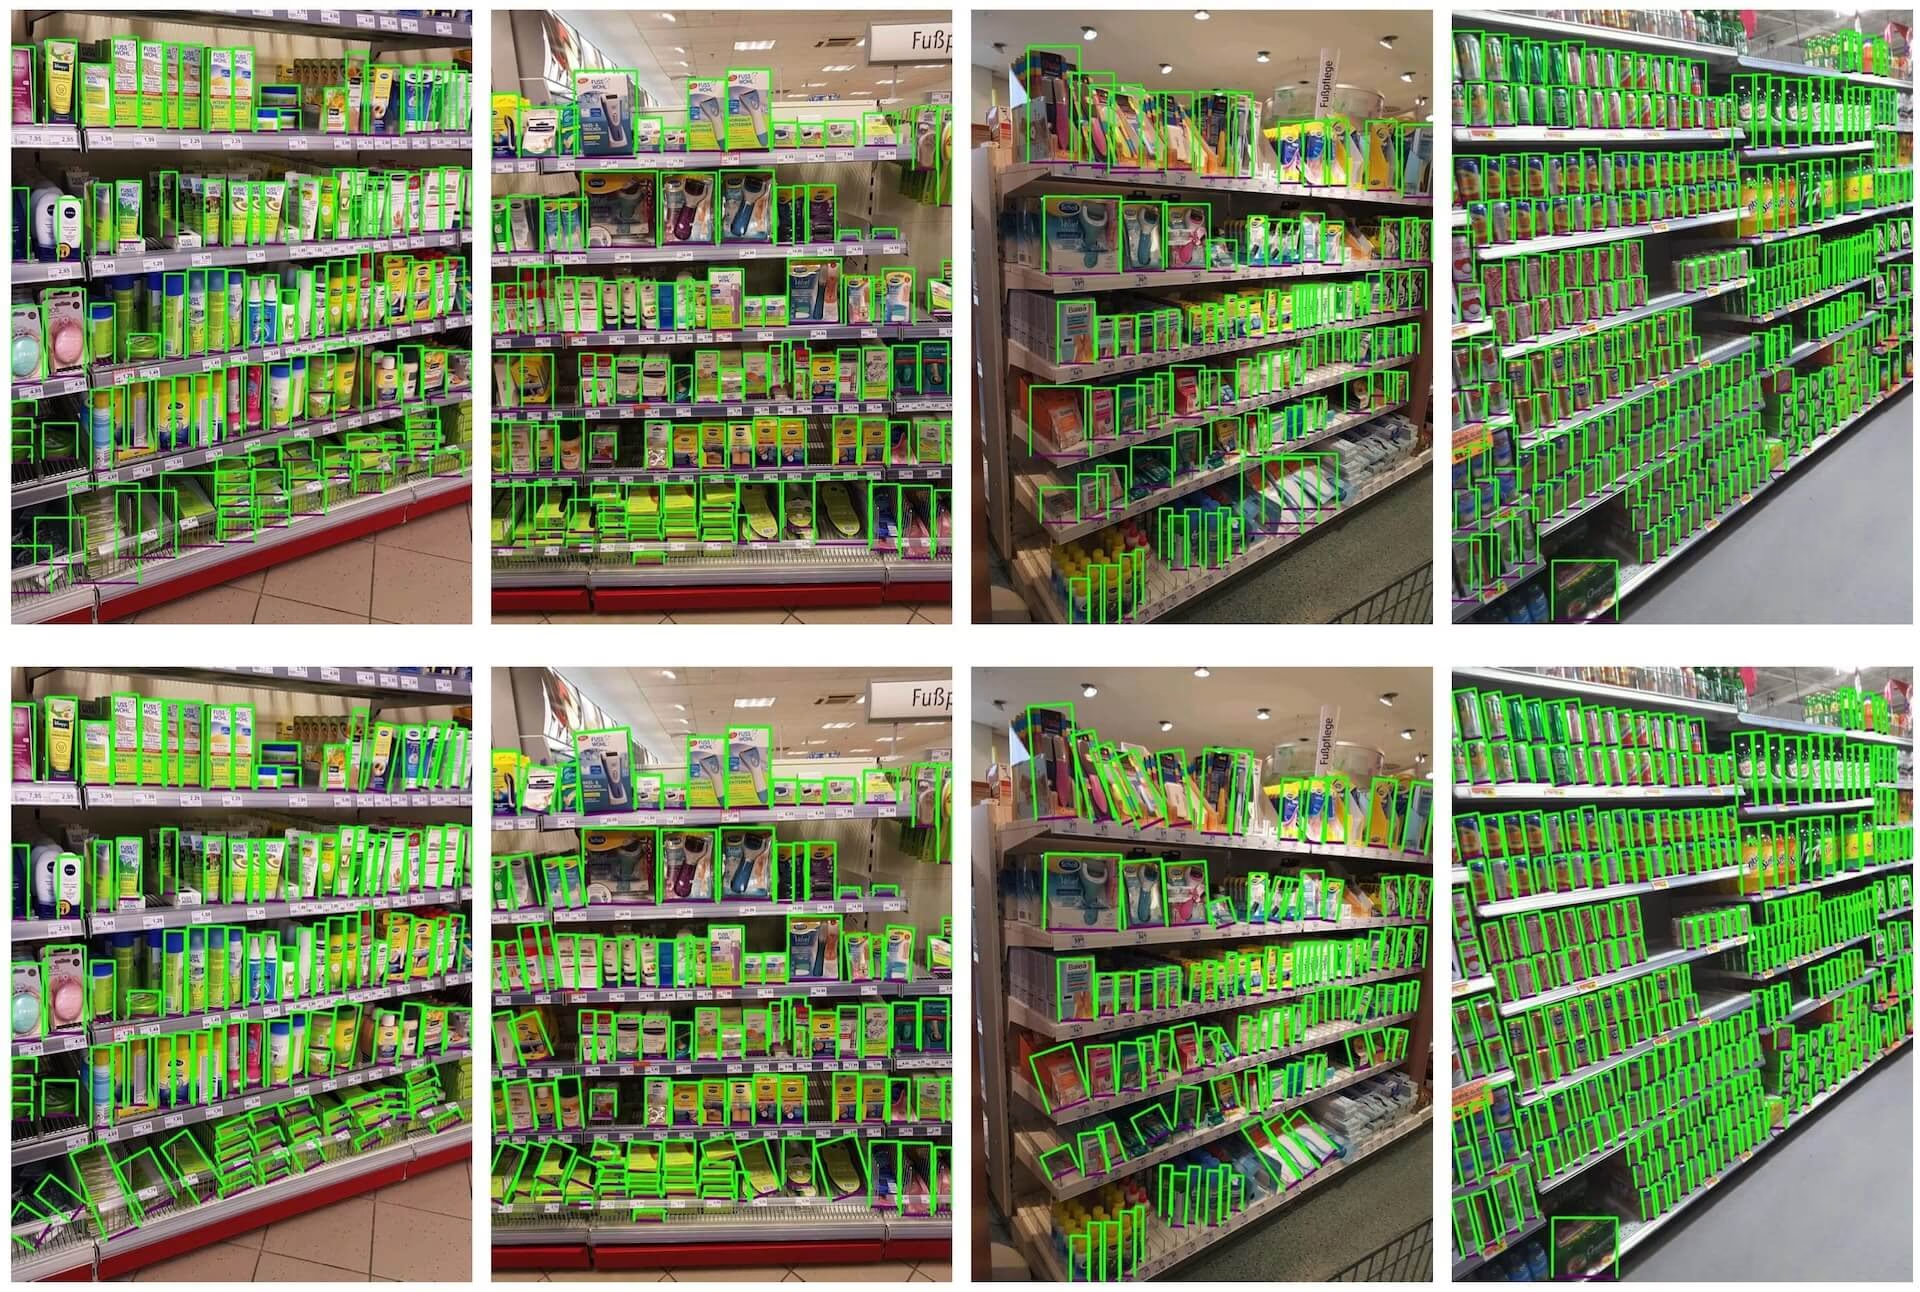
- Изображение плотно заполненной торговой полки: На этом изображении показан пример высокой плотности объектов на торговой полке. Объекты размечены ограничивающими прямоугольниками в рамках единственного класса
object.
Из-за высокой плотности товаров датасет SKU-110K особенно полезен для разработки надёжных решений компьютерного зрения для розничной торговли: большое количество объектов на изображении предъявляет к детекторам гораздо более высокие требования, чем типичные тесты.
Цитирование и благодарности#
Если ты используешь датасет SKU-110K в исследованиях или разработке, процитируй эту статью:
@inproceedings{goldman2019dense,
  author    = {Eran Goldman and Roei Herzig and Aviv Eisenschtat and Jacob Goldberger and Tal Hassner},
  title     = {Precise Detection in Densely Packed Scenes},
  booktitle = {Proc. Conf. Comput. Vision Pattern Recognition (CVPR)},
  year      = {2019}
}
Мы хотели бы поблагодарить Эрана Голдмана и соавторов за создание и поддержку датасета SKU-110K, ценного ресурса для сообщества исследователей компьютерного зрения. Подробнее о датасете SKU-110K и его создателях см. в репозитории датасета SKU-110K на GitHub.
Часто задаваемые вопросы#
SKU-110K — это набор данных для обнаружения объектов одного класса, содержащий 11 743 изображения с плотно заполненными полками магазинов. Его создал Эран Голдман и соавторы для статьи на CVPR 2019. Каждый товар размечен одной ограничивающей рамкой класса
object; на изображениях представлено более 110 000 уникальных единиц складского учета (SKU). Это отличный тест для обнаружения объектов в загруженных сценах и разработки систем компьютерного зрения для розничной торговли.Нет. В SKU-110K один класс: каждый товар размечен одним ограничивающим прямоугольником класса
object(names: {0: object}). Число «110K» в названии обозначает количество уникальных товарных единиц (SKUs), представленных на изображениях, а не количество классов обнаружения.Датасет SKU-110K содержит 11 743 изображения: 8 219 для обучения, 588 для валидации и 2 936 для тестирования. В нём один класс обнаружения —
object. Подробнее см. в разделе Структура датасета и конфигурацииSKU-110K.yaml.Датасет SKU-110K занимает около 13,6 ГБ и автоматически скачивается при первом запуске обучения с
data="SKU-110K.yaml"— вручную скачивать его не нужно. Другие, более компактные варианты см. в обзоре датасетов для обнаружения объектов.Обучить модель YOLO26 на датасете SKU-110K просто. Вот пример обучения модели YOLO26n в течение 100 эпох с размером изображения 640:
Пример обученияfrom ultralytics import YOLO # Загрузить модель model = YOLO("yolo26n.pt") # загрузить предварительно обученную модель (рекомендуется для обучения) # Обучить модель results = model.train(data="SKU-110K.yaml", epochs=100, imgsz=640)


Комментарии6
Задай вопрос, поделись результатами или помоги кому-нибудь.
syafiqmuda
Hi, newbie here, I try to use this dataset to compare and see the accuracy for this dataset with my own, but during training almost all the file were show
Corrupt JPEG data: 786 extraneous bytes before marker 0xd9and sometimesCorrupt JPEG data: premature end of data segment. can I know why? my code look like this:training.py
from ultralytics import YOLO, checks, hub checks() def main(): hub.login('something') model = YOLO('https://hub.ultralytics.com/models/ukr3hHHq88WJASNn3aUz') results = model.train(device=[0,1,2,3]) if __name__ == '__main__': main() Glenn JocherUltralytics
Those messages are PIL JPEG warnings from a handful of non-standard images in SKU-110K; Ultralytics usually auto-recovers/filters these during dataloading via
ultralytics.data.utils.verify_image()(see theverify_image()reference), so if training continues it’s safe to ignore—if it actually crashes, re-download/re-extract the dataset (or re-encode the specific bad JPGs), then delete any*.cacheunder yourlabels/folder and rerun; if you share the text output ofyolo checksplus the full traceback (not a screenshot) we can pinpoint whether it’s data corruption or an environment issue.
ApodiAlsurihi
Hi, thank you for this amazing and detailed explanation! Your work is incredibly helpful and inspiring. I would deeply appreciate it if you could share the trained model after the training process. It would make a significant difference in advancing my project and learning. Thank you so much for your generosity and support!
- Glenn JocherUltralytics
@ApodiAlsurihi thank you for your kind words! Unfortunately, we cannot share trained models directly. However, you can train your own model using the SKU-110K dataset by following the instructions provided in the documentation.
serna01
Are this warnings OK, when training? the batch=0.1 I used it to avoid a memory error. yolo detect train data=SKU-110K.yaml model=yolov8n.pt epochs=50 imgsz=640 batch=0.1
AutoBatch: Using batch-size 2 for CUDA:0 0.49G/3.81G (13%) ✅ train: Scanning /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels... 8216 train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_1797.jpg: 3 duplicate labels removed train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_4222.jpg: ignoring corrupt image/label: image file is truncated (23 bytes not processed) train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_882.jpg: ignoring corrupt image/label: image file is truncated (3 bytes not processed) train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_924.jpg: ignoring corrupt image/label: image file is truncated (10 bytes not processed)
al: Scanning /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels... 588 ima val: New cache created: /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels.cache Corrupt JPEG data: 305 extraneous bytes before marker 0xd9 Corrupt JPEG data: 786 extraneous bytes before marker 0xd9 Plotting labels to runs/detect/train5/labels.jpg... optimizer: 'optimizer=auto' found, ignoring 'lr0=0.01' and 'momentum=0.937' and determining best 'optimizer', 'lr0' and 'momentum' automatically... optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups 57 weight(decay=0.0), 64 weight(decay=0.0005), 63 bias(decay=0.0) TensorBoard: model graph visualization added ✅ Image sizes 640 train, 640 val Using 8 dataloader workers Logging results to runs/detect/train5 Starting training for 50 epochs...
  Epoch    GPU_mem   box_loss   cls_loss   dfl_loss  Instances       Size
   1/50      1.14G      2.504      3.041       1.53        378        640:   5Corrupt JPEG data: premature end of data segment
   1/50      1.15G      2.382      2.658      1.454        331        640:   7Corrupt JPEG data: 562 extraneous bytes before marker 0xd9
   1/50      1.42G      2.273      2.314      1.382        314        640:  11Corrupt JPEG data: bad Huffman code
   1/50      1.42G      2.266      2.295      1.378        578        64       1/50      1.42G      2.266      2.293      1.377        678        64       1/50      1.42G      2.266      2.293      1.377        678        64       1/50      1.42G      2.265      2.292      1.377        723        64       1/50      1.42G      2.265      2.292      1.377        723        64       1/50      1.42G      2.266       2.29      1.377        695        64       1/50      1.42G      2.266          1/50      1.42G      2.255      2.2       1/50      1.42G      2.254      2.247       1.3       1/50      1       1/50              1/50                          1/50      1.42G      2.232      2.187      1.358        608        640:  13Corrupt JPEG data: bad Huffman code
   1/50      1.42G      2.216      2.138      1.347        437        640:  14Corrupt JPEG data: premature end of data segment
   1/50      1.42G      2.164      1.993      1.318        478        640:  17Corrupt JPEG data: 41 extraneous bytes before marker 0xd9
   1/50      1.42G      2.157      1.967      1.312        308        640:  17Corrupt JPEG data: premature end of data segment
   1/50      1.42G      2.011       1.61      1.239        173        640:  30Corrupt JPEG data: premature end of data segment
   1/50      1.42G      1.987      1.556      1.227        461        640:  33Corrupt JPEG data: 96 extraneous bytes before marker 0xd9
   1/50      1.42G      1.978      1.537      1.223        214        640:  34Corrupt JPEG data: bad Huffman code
   1/50      1.42G      1.959      1.497      1.215        250        640:  37Corrupt JPEG data: bad Huffman code
   1/50      1.42G      1.915      1.403      1.197        500        640:  46Corrupt JPEG data: premature end of data segment
   1/50      1.42G      1.888      1.345      1.185        616        640:  52Corrupt JPEG data: premature end of data segment
Thanks.
- Glenn JocherUltralytics
@serna01 the warnings you see are generally okay and indicate that the training process is handling issues like duplicate labels and corrupt images. Using
batch=0.1to avoid memory errors is fine, but consider adjusting your batch size to better utilize your GPU memory. If the warnings persist or cause issues, ensure you're using the latest version of the package. For more details on the SKU-110k dataset, visit SKU-110k Dataset Documentation.