Рекомендации и лучшие практики машинного обучения для обучения моделей
Введение#
Один из важнейших этапов работы над проектом в области компьютерного зрения — обучение модели. Прежде чем перейти к нему, нужно определить цели и собрать данные и добавить к ним разметку. Затем предварительно обработай данные, чтобы убедиться в их чистоте и согласованности, и переходи к обучению модели.
Обучение модели — это процесс, в ходе которого модель учится распознавать визуальные закономерности и делать прогнозы на основе данных. Этот процесс напрямую влияет на точность приложения. В руководстве собраны рекомендации, методы оптимизации и советы по устранению неполадок, которые помогут тебе эффективно обучать модели компьютерного зрения.
Смотри: Советы по обучению моделей | Как работать с большими наборами данных | Размер батча, загрузка GPU и смешанная точность
Как обучить модель машинного обучения#
Модель компьютерного зрения обучается путём настройки внутренних параметров для минимизации ошибок. Сначала модели передают большой набор изображений с разметкой. Модель прогнозирует, что изображено на этих снимках, а затем эти прогнозы сравниваются с истинными метками или содержимым изображений, чтобы вычислить ошибки. Ошибки показывают, насколько прогнозы модели отличаются от истинных значений.
Во время обучения модель многократно строит прогнозы, вычисляет ошибки и обновляет параметры с помощью процесса, который называется обратным распространением ошибки. В ходе этого процесса модель корректирует внутренние параметры (веса и смещения), чтобы уменьшить ошибки. Многократное повторение этого цикла постепенно повышает точность модели. Со временем модель учится распознавать сложные закономерности, например формы, цвета и текстуры.
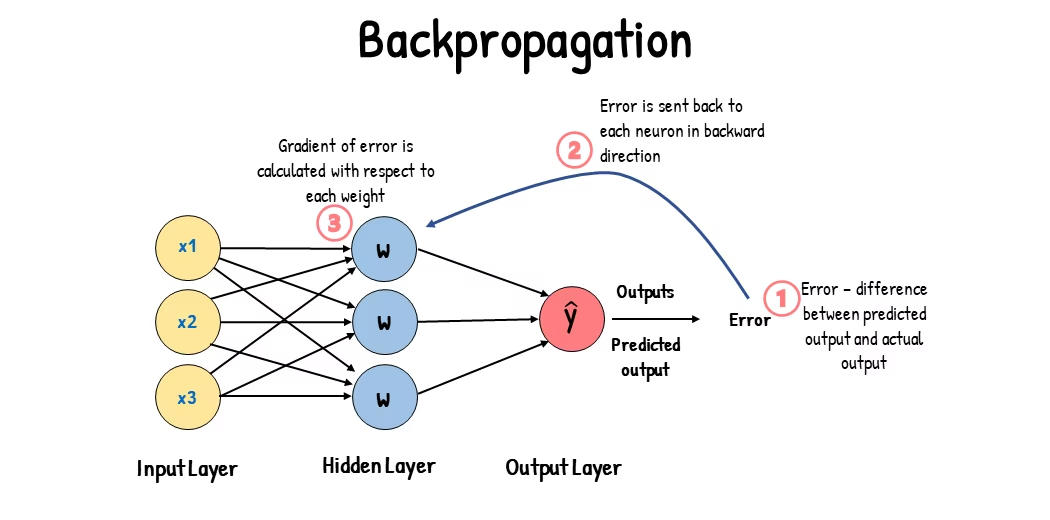
Благодаря этому процессу обучения модель компьютерного зрения может выполнять различные задачи, включая обнаружение объектов, сегментацию экземпляров, семантическую сегментацию и классификацию изображений. Конечная цель — создать модель, которая сможет обобщать полученные знания на новые, ранее не встречавшиеся изображения и точно интерпретировать визуальные данные в реальных приложениях.
Теперь, когда мы разобрались, что происходит при обучении модели, рассмотрим, что нужно учитывать во время обучения.
Обучение на больших наборах данных#
Планируя обучать модель на большом наборе данных, нужно учесть несколько аспектов. Например, можно настроить размер пакета, контролировать использование GPU, выбрать обучение с несколькими масштабами и так далее. Рассмотрим каждый из этих вариантов подробнее.
Размер пакета и использование GPU#
При обучении моделей на больших наборах данных важно эффективно использовать GPU. Один из ключевых факторов — размер пакета, то есть количество образцов данных, которые модель машинного обучения обрабатывает за одну итерацию обучения. Если выбрать максимально возможный размер пакета, GPU будет использоваться на полную мощность, а обучение модели займёт меньше времени. Однако важно не допустить нехватки памяти GPU. При ошибках памяти постепенно уменьшай размер пакета, пока модель не начнёт обучаться без сбоев.
Смотри: Как ускорить инференс Ultralytics YOLO26 в 2 раза с помощью пакетной обработки | Python и GPU | MLOps 🚀
Для YOLO26 ты можешь задать параметр batch в аргументах режима Train с учётом возможностей GPU. При использовании одного ускорителя batch=-1 профилирует модель и выбирает размер батча, рассчитанный примерно на 60% использования памяти; дробное значение, например batch=0.70, задаёт другую долю. Для запуска на нескольких GPU требуется явно указать общий размер батча, не меньший количества устройств. На CPU и Apple silicon AutoBatch выводит предупреждение и переключается на batch=16.
Обучение на подмножестве данных#
Обучение на подмножестве — практический подход, при котором модель обучается на меньшем наборе данных, представляющем весь набор. Это позволяет сэкономить время и ресурсы, особенно на начальных этапах разработки и тестирования модели. Если у тебя мало времени или ты экспериментируешь с различными конфигурациями модели, обучение на подмножестве — хороший вариант.
Для YOLO26 можно реализовать обучение на подмножестве данных с помощью параметра fraction. Используй коэффициент, например fraction=0.1, чтобы взять 10% обучающих данных, целое число, например fraction=300, чтобы выбрать ровно 300 обучающих изображений, или список [train, val, test], например fraction=[300, 100, 0], чтобы ограничить размер каждой выборки и исключить тестовые изображения. Списки из двух элементов, например [300, 100], оставляют тестовую выборку целиком. Наборы данных NDJSON выбирают равномерно распределённые записи до их скачивания, поэтому при повторных запусках используется то же самое подмножество. Наборы данных для классификации с изображениями в папках также выбирают равномерно распределённые образцы. Для других наборов данных с изображениями в папках fraction выбирает первые N изображений в отсортированном порядке путей к изображениям, а не случайную выборку, поэтому вручную формируй подмножества, если порядок может привести к исключению источников данных или классов. При подготовке выборок для обучения и валидации оставляй группы почти дублирующихся изображений целиком в одной выборке.
Обучение с несколькими масштабами#
Обучение с несколькими масштабами позволяет повысить способность модели к обобщению, обучая её на изображениях разных размеров. Модель учится обнаруживать объекты на разных масштабах и расстояниях, благодаря чему становится устойчивее.
При обучении YOLO26 можно включить аугментацию масштаба, задав параметр scale. Этот параметр изменяет размер обучающих изображений с заданным коэффициентом, имитируя объекты на разном расстоянии. Например, значение scale=0.5 случайным образом изменяет масштаб обучающих изображений в диапазоне от 0.5 до 1.5. Благодаря этому параметру модель видит изображения в разных масштабах и лучше обнаруживает объекты разных размеров в различных условиях.
Ultralytics также поддерживает обучение с несколькими размерами изображения с помощью параметра multi_scale. В отличие от scale, который масштабирует изображения, а затем дополняет их или обрезает до imgsz, multi_scale меняет сам параметр imgsz в каждом пакете (округляя значение до шага модели). Например, при значениях imgsz=640 и multi_scale=0.25 размер изображений для обучения выбирается от 480 до 800 с шагом, кратным шагу модели (например, 480, 512, 544, ..., 800), а multi_scale=0.0 сохраняет фиксированный размер.
Кэширование#
Кэширование — важный способ повысить эффективность обучения моделей машинного обучения. Хранение предварительно обработанных изображений в памяти сокращает время ожидания, пока GPU загружает данные с диска. Модель может непрерывно получать данные без задержек из-за операций ввода-вывода с диском.
При обучении YOLO26 кэшированием можно управлять с помощью параметра cache:
cache=True: хранит изображения набора данных в RAM, обеспечивая самый быстрый доступ, но увеличивая расход памяти.cache='disk': хранит изображения на диске. Это медленнее, чем в RAM, но быстрее, чем каждый раз загружать данные заново.cache=False: отключает кэширование и полностью полагается на ввод-вывод с диска — это самый медленный вариант.
Обучение со смешанной точностью#
При обучении со смешанной точностью используются числа с плавающей точкой двух форматов: 16-битного (FP16) и 32-битного (FP32). FP16 обеспечивает более быстрые вычисления, а FP32 сохраняет точность там, где это необходимо. Большинство операций нейронной сети выполняются в FP16, что ускоряет вычисления и снижает потребление памяти. При этом эталонная копия весов модели хранится в FP32, чтобы обеспечить точность при обновлении весов. Так ты сможешь работать с более крупными моделями или увеличивать размер батча в рамках тех же аппаратных ограничений.
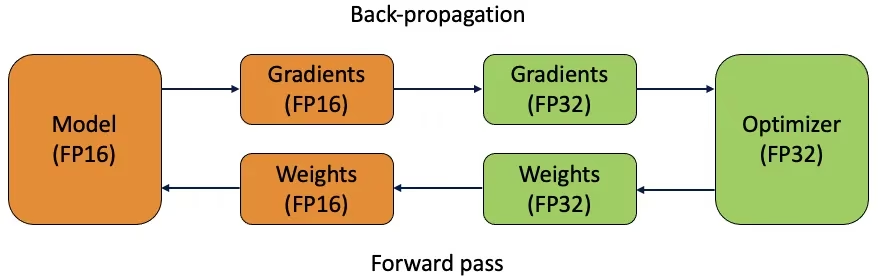
Чтобы использовать обучение со смешанной точностью, измени скрипты обучения и убедись, что твоё оборудование (например, GPU) поддерживает этот режим. Многие современные фреймворки для глубокого обучения, такие как PyTorch и TensorFlow, поддерживают смешанную точность из коробки.
Обучение со смешанной точностью в YOLO26 не требует сложной настройки: AMP включен по умолчанию (amp=True). При использовании GPU с CUDA YOLO в начале обучения однократно проверяет возможности устройства и в случае неудачи переключается на полный формат FP32; на CPU и Apple silicon AMP полностью пропускается. Задай amp=False, чтобы принудительно использовать FP32, или amp="bf16", чтобы обучать в bfloat16 на поддерживаемых GPU.
Предобученные веса#
Использование предварительно обученных весов — эффективный способ ускорить обучение модели. Такие веса получены от моделей, уже обученных на больших наборах данных, и дают твоей модели фору. Трансферное обучение адаптирует предварительно обученные модели к новым связанным задачам. При дообучении модели обучение начинается с этих весов и продолжается на твоем конкретном наборе данных. Этот метод сокращает время обучения и зачастую повышает качество, поскольку модель уже хорошо понимает базовые признаки.
Предварительно обученные веса задаются аргументом model, поэтому model=yolo26n.pt уже использует веса COCO на старте. Параметр pretrained определяет, сохраняются ли эти веса (True, значение по умолчанию), отбрасываются (False) или заменяются другой контрольной точкой (pretrained=path/to/best.pt). Если задать pretrained=True для модели *.yaml, веса не будут загружены автоматически. Полный рабочий процесс трансферного обучения описан в руководстве Как дообучить YOLO на пользовательском наборе данных.
Другие методы для работы с большими наборами данных#
При работе с большими наборами данных можно использовать ещё несколько методов:
- Планировщики скорости обучения: планировщики динамически меняют скорость обучения в ходе обучения модели. Правильно подобранная скорость обучения помогает модели не проскакивать минимумы и повышает стабильность. При обучении YOLO26 параметр
lrfуправляет планированием скорости обучения, задавая конечную скорость как долю от начальной. Если нужное поведение нельзя настроить аргументом — например, скорость обучения для отдельных слоёв или ограничение градиента, — создай подкласс тренера. - Распределенное обучение: при работе с большими наборами данных распределенное обучение сокращает время обучения, распределяя вычислительную нагрузку между несколькими GPU или машинами. Такой подход особенно ценен для проектов корпоративного масштаба с большими вычислительными ресурсами.
- Формат памяти channels-last: при обучении на CUDA автоматически используется более быстрая раскладка памяти NHWC в PyTorch 1.11 и новее, кроме Windows, где она показала более низкую скорость. Установи
channels_last=True, чтобы включить этот формат принудительно, илиchannels_last=False, чтобы оставить NCHW; в PyTorch 1.10 и более ранних версиях, на CPU и MPS по умолчанию остаётся NCHW.
Количество эпох обучения#
При обучении модели эпоха — это один полный проход по всему обучающему набору данных. За одну эпоху модель обрабатывает каждый обучающий пример и обновляет параметры в соответствии с алгоритмом обучения. Обычно требуется несколько эпох, чтобы модель успела обучиться и постепенно уточнить свои параметры.
Часто возникает вопрос: как определить, сколько эпох нужно обучать модель? Хорошая отправная точка — 300 эпох. Если модель рано переобучается, количество эпох можно уменьшить. Если после 300 эпох переобучения нет, обучение можно продлить до 600, 1200 или большего числа эпох.
Однако оптимальное количество эпох зависит от размера набора данных и целей проекта. Для эффективного обучения на больших наборах данных может потребоваться больше эпох, а для маленьких наборов данных может понадобиться меньше эпох, чтобы избежать переобучения. Для YOLO26 можно задать параметр epochs в скрипте обучения.
Ранняя остановка#
Ранняя остановка — полезный способ оптимизировать обучение модели. Следя за результатами валидации, можно остановить обучение, когда модель перестанет улучшаться. Так ты сэкономишь вычислительные ресурсы и предотвратишь переобучение.
Для этого задаётся параметр терпения: он определяет, сколько эпох ждать улучшения метрик валидации, прежде чем остановить обучение. Если за это время результаты модели не улучшатся, обучение прекратится, чтобы не тратить время и ресурсы впустую.
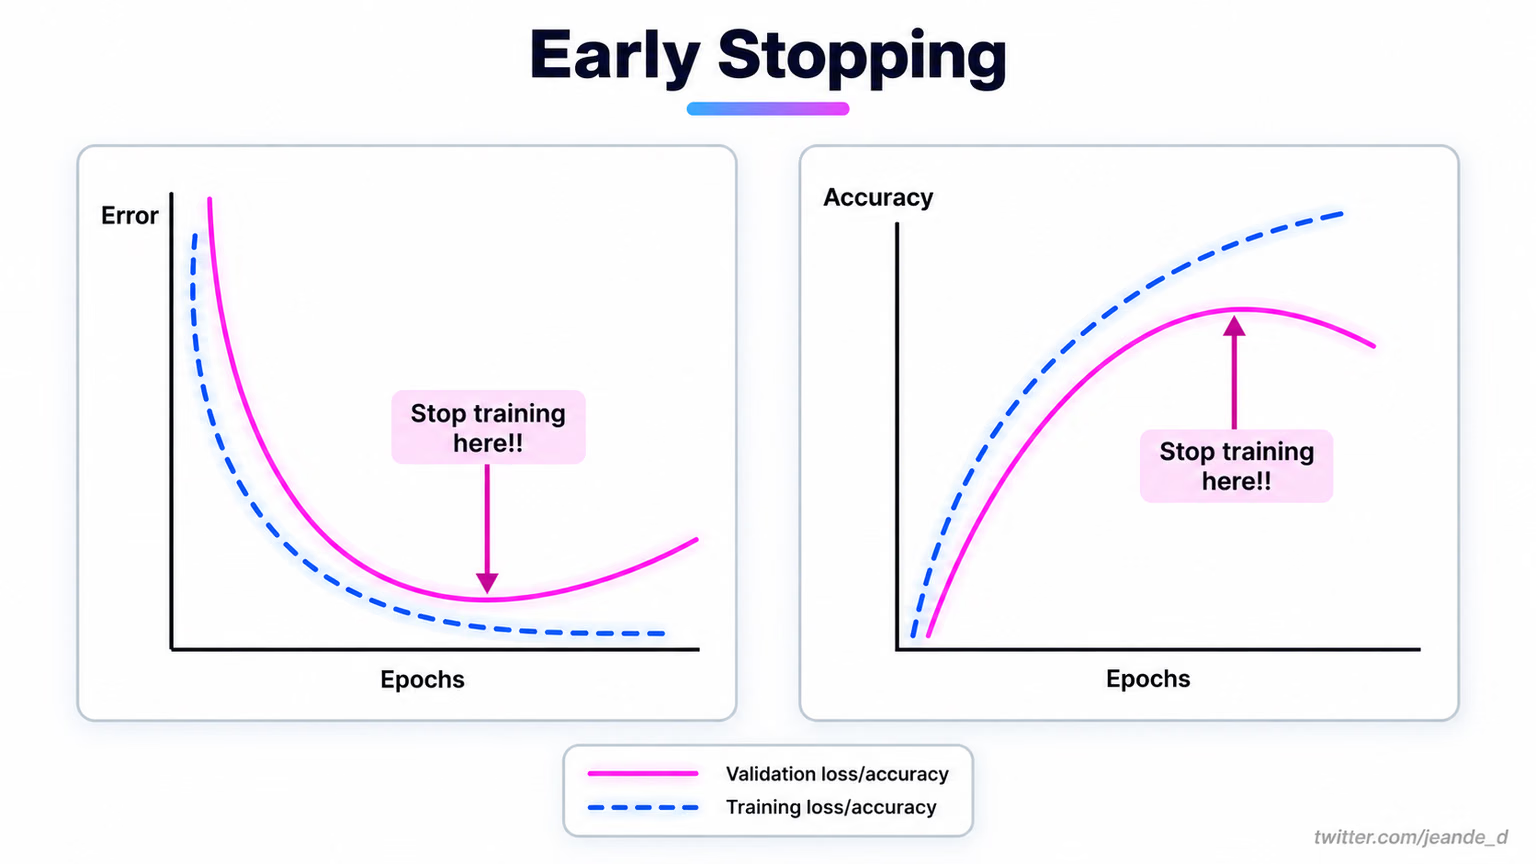
В YOLO26 можно включить раннюю остановку, задав параметр patience в конфигурации обучения. Например, patience=5 означает, что обучение остановится, если метрики валидации не улучшатся в течение 5 эпох подряд. Это делает обучение эффективнее и позволяет избежать лишних вычислений.
Облачное или локальное обучение#
Обучать модель можно двумя способами: в облаке или локально.
Облачное обучение масштабируется и предоставляет мощное оборудование, поэтому хорошо подходит для работы с большими наборами данных и сложными моделями. Такие платформы, как Google Cloud, AWS и Azure, предоставляют по запросу доступ к высокопроизводительным GPU и TPU, ускоряя обучение и позволяя экспериментировать с более крупными моделями. Ultralytics Platform также предлагает управляемое облачное обучение моделей YOLO. Однако облачное обучение может быть дорогим, особенно при длительном использовании, а передача данных увеличивает расходы и задержки.
Локальное обучение обеспечивает больший контроль и гибкость: ты можешь настроить среду под конкретные потребности и избежать регулярных расходов на облако. Для долгосрочных проектов оно может быть экономичнее, а поскольку данные остаются в локальной инфраструктуре, такой подход безопаснее. Однако ресурсы локального оборудования могут быть ограничены, а само оборудование требует обслуживания, из-за чего обучение крупных моделей может занимать больше времени.
Выбор оптимизатора#
Оптимизатор — это алгоритм, который изменяет веса нейронной сети, чтобы минимизировать функцию потерь, показывающую, насколько хорошо работает модель. Проще говоря, оптимизатор помогает модели учиться, корректируя ее параметры для уменьшения ошибок. Выбор оптимизатора напрямую влияет на скорость и точность обучения модели.
Ты также можешь настроить параметры оптимизатора, чтобы повысить качество работы модели. Изменение скорости обучения задает размер шагов при обновлении параметров. Для стабильности можно начать с умеренной скорости обучения и постепенно снижать ее со временем, чтобы улучшить обучение в долгосрочной перспективе. Кроме того, параметр импульса определяет, насколько сильно прошлые обновления влияют на текущие. Обычно значение импульса составляет около 0.9. Как правило, это обеспечивает хороший баланс.
Распространенные оптимизаторы#
У разных оптимизаторов есть свои преимущества и недостатки. Вот несколько распространенных оптимизаторов.
-
SGD (стохастический градиентный спуск):
- Обновляет параметры модели, используя градиент функции потерь по отношению к этим параметрам.
- Простой и эффективный, но может медленно сходиться и застревать в локальных минимумах.
-
Adam (адаптивная оценка моментов):
- Сочетает преимущества SGD с импульсом и RMSProp.
- Настраивает скорость обучения для каждого параметра на основе оценок первого и второго моментов градиентов.
- Хорошо подходит для зашумленных данных и разреженных градиентов.
- Эффективен и обычно требует меньше настройки. Для коротких запусков обучения
optimizer=autoв YOLO26 выбирает близкий к Adam вариант AdamW, а не сам Adam.
-
Распространение среднеквадратичного значения (RMSProp):
- Настраивает скорость обучения для каждого параметра, деля градиент на скользящее среднее величин недавних градиентов.
- Помогает справиться с проблемой затухающего градиента и эффективен для рекуррентных нейронных сетей.
-
MuSGD (гибрид Muon и SGD):
- Сочетает обновления в стиле SGD с принципами Muon, повышая стабильность обучения в большом масштабе.
- Хороший выбор, если тебе нужно обобщение, характерное для SGD, но при этом более плавная сходимость, чем у обычного SGD.
- Особенно актуален для рецептов обучения YOLO26; если сомневаешься, начни с
optimizer=autoи сравни результат с MuSGD на своем наборе данных.
В YOLO26 параметр optimizer позволяет выбрать один из нескольких оптимизаторов: SGD, MuSGD, Adam, Adamax, AdamW, NAdam, RAdam и RMSProp. Также можно задать значение auto, чтобы оптимизатор выбирался автоматически на основе числа итераций обучения (AdamW для коротких запусков, MuSGD — при числе итераций свыше 10 000).
yolo train model=yolo26n.pt data=coco8.yaml optimizer=MuSGDОбщение с сообществом#
Общение с сообществом специалистов по компьютерному зрению поможет тебе решать задачи и быстрее учиться. Вот несколько способов пообщаться, получить помощь и поделиться идеями.
Ресурсы сообщества#
- Проблемы на GitHub: зайди в репозиторий YOLO26 на GitHub и открой вкладку Issues, чтобы задать вопросы, сообщить об ошибках и предложить новые функции. Участники сообщества и сопровождающие проекта активно помогают пользователям.
- Сервер Ultralytics в Discord: присоединяйся к серверу Ultralytics в Discord, чтобы общаться с другими пользователями и разработчиками, получать поддержку и делиться опытом.
Эти ресурсы помогут тебе решать задачи и быть в курсе последних тенденций и практик сообщества компьютерного зрения.
Основные выводы#
Обучение моделей компьютерного зрения требует следования рекомендациям, оптимизации стратегий и решения возникающих проблем. Такие методы, как настройка размера батча, обучение со смешанной точностью и использование предварительно обученных весов, помогают улучшить работу моделей и ускорить обучение. Обучение на подмножестве и ранняя остановка позволяют экономить время и ресурсы. Общение с сообществом и отслеживание новых тенденций помогут тебе постоянно совершенствовать навыки обучения моделей.
Часто задаваемые вопросы#
Чтобы повысить загрузку GPU, задай параметру
batchмаксимальное значение, поддерживаемое твоим GPU. При использовании одного ускорителяbatch=-1профилирует модель и ориентируется примерно на 60% использования памяти. На CPU и Apple silicon происходит переход наbatch=16, а для запуска на нескольких GPU требуется явно указать общий размер батча, не меньший количества устройств. Подробнее см. в аргументах режима Train.Обучение со смешанной точностью использует числа с плавающей точкой двух типов — 16-битного (FP16) и 32-битного (FP32), чтобы сбалансировать скорость вычислений и точность. В YOLO26 оно включено по умолчанию с помощью
amp=True; установиamp=False, чтобы принудительно использовать FP32. AMP не используется на CPU и устройствах Apple с чипами собственной разработки.Обучение на нескольких масштабах повышает качество работы модели: она обучается на изображениях разного размера и лучше обобщает данные при разных масштабах и расстояниях. В YOLO26 для этого предусмотрено два отдельных параметра.
scale=0.5выбирает коэффициент масштабирования от 0.5 до 1.5, а затем дополняет изображение полями или обрезает его до фиксированногоimgsz;multi_scale=0.25меняет само значениеimgszв каждом пакете с шагом, кратным stride. Настройки и подробности см. в документации по режиму обучения.Предварительно обученные веса могут значительно ускорить обучение и повысить точность модели, поскольку она уже знакома с базовыми визуальными признаками. Загрузи их с помощью аргумента
model, например, указавmodel=yolo26n.pt. Затемpretrainedопределяет, оставить ли эти веса (True, значение по умолчанию), отбросить (False) или заменить другим чекпойнтом (pretrained=path/to/best.pt— так можно перенести веса в сборкуmodel=*.yaml). Подробнее см. в документации по режиму обучения.Число эпох — это количество полных проходов по обучающему набору данных. Обычно для начала выбирают 300 эпох. Если модель рано переобучается, число эпох можно уменьшить. Если признаков переобучения нет, обучение можно продлить до 600, 1200 или большего числа эпох. Чтобы задать число эпох в YOLO26, используй параметр
epochsв скрипте обучения. Дополнительные рекомендации по выбору оптимального числа эпох см. в разделе о числе эпох.


Комментарии12
Задай вопрос, поделись результатами или помоги кому-нибудь.
puzzlemindgames
Hello
I'm working on a browser-based puzzle solver that uses a custom YOLO model to detect visible objects from game screenshots.
Some examples include: Transparent ice/frost overlays on the lower part of objects Semi-transparent cloth or curtain overlays Small decorative objects inside larger objects (for example, keys inside containers) The visible objects are usually detected correctly, but these overlays often cause false negatives or incorrect class predictions.
At the moment I'm considering a few approaches: Training with many more occlusion-heavy examples Splitting the detection into multiple stages instead of one larger model
python results = model.predict( source="level_512.png", conf=0.25, iou=0.45, imgsz=1280 ) for box in results[0].boxes: print(box.cls, box.conf)
For anyone who has trained YOLO models on UI or game screenshots which approach gave you the biggest improvement? Or is there another strategy that tends to work better for partially occluded objects?
I'd really appreciate hearing about real-world experiences before I spend time retraining the dataset.
 Glenn JocherUltralytics
Start with targeted data: add representative occluded examples, keep annotations consistent for partially visible objects, and synthetically composite the actual frost/cloth overlays at realistic opacity and placement. Measure recall per class on a dedicated occlusion-heavy validation split, then tune
mosaic,mixup, orcutmixconservatively; higherimgszor tiled inference can help nested small objects. A multi-stage pipeline is usually worthwhile only if the first stage can reliably isolate containers or overlay regions. Please continue sharing results and questions here so the Ultralytics team and community can see them.1Thanks! I followed your suggestions and added more occluded samples. The main objects/tubes are much more stable as well as the colors now but I'm still struggling with very small objects.
i cant able to attach model training screenshots here for you to review.
For example, tiny keys or tags inside transparent containers are often missed or detected as the wrong class. For context the screenshots come from a puzzle game with objects similar to these shown in sample pictures embedded at product homepage: https://aimagicsortsolver.com/
results = model.predict( source="level.png", imgsz=1280, conf=0.35, iou=0.45 ) Would you recommend keep improving a single model or train a second YOLO model just for these small objects?
- Glenn JocherUltralytics(изменено)
Keep the single model first: audit tiny-object annotations, add more balanced close-up examples, and test cropped or SAHI tiled inference so keys and tags occupy more pixels; also compare
conf=0.15–0.25, since higher thresholds may suppress weak detections. Train a second specialized model only if the first model reliably detects each container, allowing its crop to be passed to the small-object model at higher effective resolution.1 Thank you for your suggestions. I'll tweak it as per the recommendations.
TSHSLU
What is the minimum Dataset Size required if i use a pretrained model for custom projects. i barely find any sources online which recommend a minimum dataset size.
- Glenn JocherUltralytics
There isn’t a fixed “minimum” dataset size when fine-tuning a pretrained model; if your domain is close to the pretrained data and labels are clean, you can often start getting useful signal with ~50–200 images per class (or a few hundred labeled object instances), but for reliably robust results across different lighting/viewpoints/backgrounds you’ll usually want 500–2000+ images per class with good diversity—one practical way to find your true minimum is to train on a small pilot subset, check validation failures, then add data specifically where the model breaks (the
fractionworkflow in the Model training tips guide helps iterate quickly).from ultralytics import YOLO model = YOLO("yolo26n.pt") model.train(data="data.yaml", epochs=100, fraction=0.1)1
VeeranjaneyuluToka
Hi, I just noticed a thing, looks like the optimizer is getting chosen based on no.of iterations, would you mind telling me the reason for the same? I mean how does iterations matter when we choose optimizer?
Imran-ml
First of all its great to have another powerful model and congratulations. I have fine tuned and trained yolo11x.pt for my custom objects but I'm facing some issues. My images data resolution is around 6000 x 2000 but while trained the model I set the imgsz=(1280, 640). It work well when I adjust the video stream by zoom in-out and detect all my 60 objects well (objects are small) but when there is some zoom or squeezed then it completely dont detect any object or few only.
Please let me know if I'm missing something or I have to do something else? I have labelled the data on my original images so resizing making any issues? any ratio issues? Please guide me properly so I can use this power yolo11 model effectively.
- Glenn JocherUltralytics
@Imran-ml it sounds like the issue might be related to image resizing affecting object detection. Consider enabling multiscale training by adjusting the
scaleparameter to help the model generalize better across different image sizes. This can improve detection performance when objects appear at varying scales. For more detailed guidance, you can refer to our model training tips at https://docs.ultralytics.com/guides/model-training-tips/.
Taufiq-Ahmed
Hi I have a question. I am using Yolov8s for trained a dataset that has four class. fire, smoke, person, animal. all the images has areal view to detect forest fire . In my dataset I have forest fire images from drone so after training it detect fire smoke quite accurately. however, I do not have any dataset that has person or animal in forest fire. so I have to collect some other dataset from roboflow that has person and animal and the n I have merged them with my own dataset ( have changed the label of animal and person accordingly so 0 means smoke, 1 means fire, 2 means person and 3 means animal and also updated the data.yaml file) . this time the problem is it could not detect the animal and person properly some times it can detect them. The main reasons seems to me is that the drone is flying in a high altitude so it does not detect person and animal properly because in the dataset of person and animal the view of the drone is not that much high. is there any technique to solve this problem and detect all the objects as many as possible?
- Glenn JocherUltralytics
@Taufiq-Ahmed it sounds like the altitude difference between your training and test datasets is causing the detection issues. To address this, consider using data augmentation techniques to simulate higher altitude views in your training data. You can also try multiscale training to help the model generalize better across different scales. Additionally, fine-tuning the model with a mix of high-altitude and low-altitude images might improve its performance. For more detailed strategies, you can refer to our model training tips.