Аугментация во время тестирования (TTA)#
📚 В этом руководстве объясняется, как использовать аугментацию во время тестирования (TTA) при тестировании и инференсе YOLOv5 🚀, чтобы повысить mAP и полноту.
Перед началом#
Клонируй репозиторий и установи зависимости из requirements.txt в окружении Python>=3.8.0, включая PyTorch>=1.8. Модели и датасеты автоматически загружаются из последнего релиза YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
Обычное тестирование#
Прежде чем использовать TTA, нужно определить базовую производительность для сравнения. Эта команда тестирует YOLOv5x на COCO val2017 с размером изображения 640 пикселей. yolov5x.pt — самая большая и точная из доступных моделей. Также можно выбрать yolov5n.pt, yolov5s.pt, yolov5m.pt и yolov5l.pt или собственную контрольную точку, полученную при обучении на пользовательском наборе данных, например runs/train/exp/weights/best.pt. Подробнее обо всех доступных моделях см. в документации YOLOv5.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --halfРезультат:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients

val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2846.03it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [02:30<00:00,  1.05it/s]
                 all       5000      36335      0.746      0.626       0.68       0.49
Speed: 0.1ms pre-process, 22.4ms inference, 1.4ms NMS per image at shape (32, 3, 640, 640)  # <--- baseline speed

Evaluating pycocotools mAP... saving runs/val/exp/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.504  # <--- baseline mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.688
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.546
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.351
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.551
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.644
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.382
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.628
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.681  # <--- baseline mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.524
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.735
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.826
Тестирование с TTA#
Добавь --augment к любой существующей команде val.py, чтобы включить TTA, и увеличь размер изображения примерно на 30% для улучшения результатов. Учти, что инференс с включенной TTA обычно занимает в 2–3 раза больше времени, чем обычный: изображения отражаются слева направо и обрабатываются в трех разрешениях, а затем результаты объединяются перед NMS. Замедление частично связано с увеличением размера изображений (832 вместо 640), а частично — с самими операциями TTA. Поэтому перед увеличением --img убедись, что у твоего GPU достаточно свободной памяти.
python val.py --weights yolov5x.pt --data coco.yaml --img 832 --augment --halfРезультат:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=832, conf_thres=0.001, iou_thres=0.6, task=val, device=, single_cls=False, augment=True, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
/usr/local/lib/python3.7/dist-packages/torch/nn/functional.py:718: UserWarning: Named tensors and all their associated APIs are an experimental feature and subject to change. Please do not use them for anything important until they are released as stable. (Triggered internally at  /pytorch/c10/core/TensorImpl.h:1156.)
  return torch.max_pool2d(input, kernel_size, stride, padding, dilation, ceil_mode)
Model Summary: 476 layers, 87730285 parameters, 0 gradients
val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2885.61it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [07:29<00:00,  2.86s/it]
                 all       5000      36335      0.718      0.656      0.695      0.503
Speed: 0.2ms pre-process, 80.6ms inference, 2.7ms NMS per image at shape (32, 3, 832, 832)  # <--- TTA speed

Evaluating pycocotools mAP... saving runs/val/exp2/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.516  # <--- TTA mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.701
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.562
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.361
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.564
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.656
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.388
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.640
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.696  # <--- TTA mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.553
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.744
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.833
Инференс с TTA#
Инференс с TTA через detect.py работает так же, как инференс с TTA через val.py: просто добавь --augment к любой существующей команде detect.py:
python detect.py --weights yolov5s.pt --img 832 --source data/images --augmentРезультат:
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Downloading https://github.com/ultralytics/yolov5/releases/download/v5.0/yolov5s.pt to yolov5s.pt...
100% 14.1M/14.1M [00:00<00:00, 81.9MB/s]

Fusing layers...
Model Summary: 224 layers, 7266973 parameters, 0 gradients
image 1/2 /content/yolov5/data/images/bus.jpg: 832x640 4 persons, 1 bus, 1 fire hydrant, Done. (0.029s)
image 2/2 /content/yolov5/data/images/zidane.jpg: 480x832 3 persons, 3 ties, Done. (0.024s)
Results saved to runs/detect/exp
Done. (0.156s)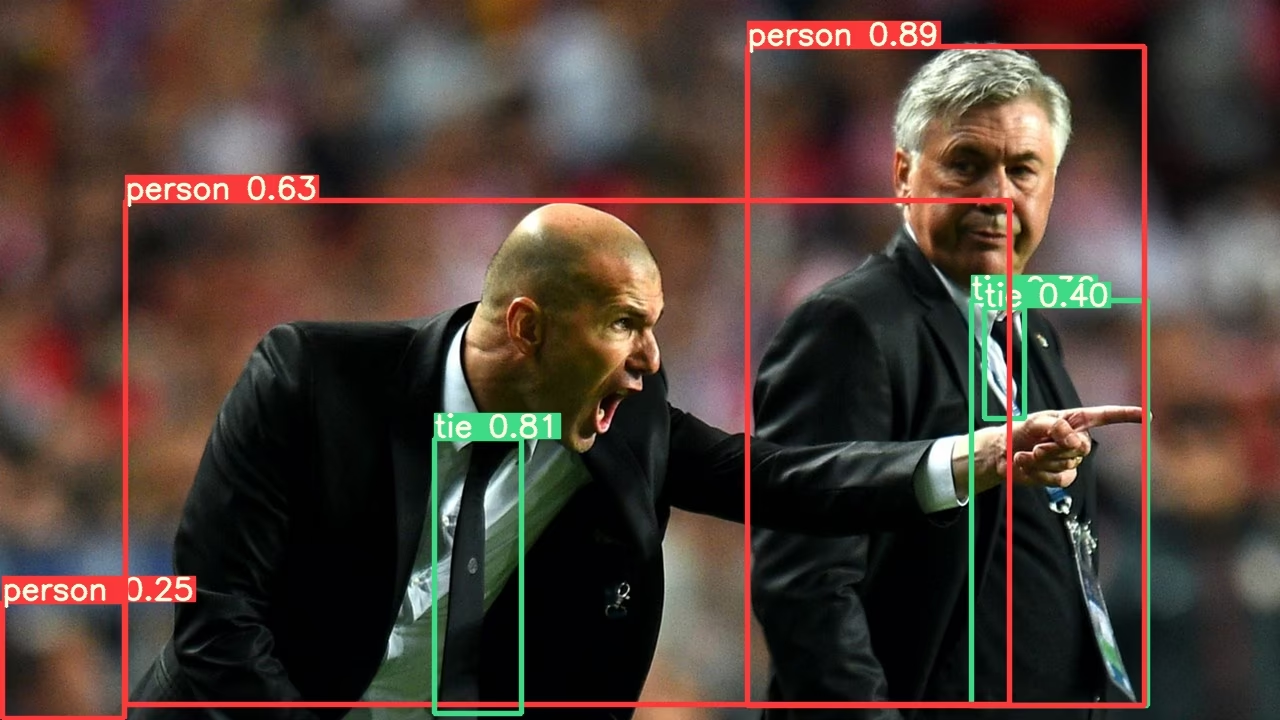
TTA через PyTorch Hub#
TTA автоматически встроена во все модели YOLOv5 PyTorch Hub. Чтобы использовать TTA во время инференса, передай augment=True.
import torch

# Model
model = torch.hub.load("ultralytics/yolov5", "yolov5s")  # или yolov5m, yolov5x, custom

# Images
img = "https://ultralytics.com/images/zidane.jpg"  # или файл, PIL, OpenCV, numpy, несколько

# Inference
results = model(img, augment=True)  # <--- инференс с TTA

# Results
results.print() # или .show(), .save(), .crop(), .pandas() и т. д.Настройка#
Ты можешь настроить операции TTA, выполняемые в методе forward_augment() YOLOv5.
Преимущества аугментации во время тестирования#
Аугментация во время тестирования дает несколько важных преимуществ для задач обнаружения объектов:
- Повышение точности: как показывают приведенные выше результаты, TTA повышает mAP с 0.504 до 0.516, а mAR — с 0.681 до 0.696.
- Более точное обнаружение мелких объектов: TTA особенно повышает качество обнаружения мелких объектов: AP для объектов небольшой площади увеличивается с 0.351 до 0.361.
- Повышение устойчивости: проверка нескольких вариантов каждого изображения снижает влияние угла обзора, освещения и других факторов окружающей среды.
- Простота реализации: достаточно добавить флаг
--augmentк существующим командам.
Компромисс заключается в увеличении времени инференса, поэтому TTA лучше подходит для приложений, где точность важнее скорости.
Поддерживаемые среды#
Ultralytics предлагает готовые среды, в каждой из которых предварительно установлены необходимые зависимости, такие как CUDA, CUDNN, Python и PyTorch, чтобы ты мог сразу приступить к работе над проектами.
- Бесплатные ноутбуки с GPU:


- Google Cloud: краткое руководство по GCP
- Amazon: краткое руководство по AWS
- Azure: краткое руководство по AzureML
- Docker: краткое руководство по Docker

Статус проекта#

Этот значок означает, что все тесты YOLOv5 GitHub Actions для непрерывной интеграции (CI) проходят успешно. Эти тесты CI тщательно проверяют функциональность и производительность YOLOv5 по ряду ключевых направлений: обучение, валидация, инференс, экспорт и сравнительное тестирование. Они обеспечивают стабильную и надёжную работу в macOS, Windows и Ubuntu. Тестирование проводится каждые 24 часа и после каждого нового коммита.
Часто задаваемые вопросы#
Каждое изображение обрабатывается в трех масштабах и с отражением слева направо, а прогнозы объединяются перед NMS. Дополнительные варианты изображения повышают полноту, особенно для мелких объектов, но требуют больше вычислительных ресурсов.
Инференс займет примерно в 2–3 раза больше времени, чем обычно. Часть затрат связана с увеличенным размером
--img, поэтому перед его увеличением убедись, что у твоего GPU достаточно памяти.Разрешение примерно на 30% выше — например, 832 вместо 640 — дает проходам с разными масштабами больше деталей для обработки и, как показали приведенные выше тесты, обеспечивает лучшие результаты.
Нет. Дополненный прямой проход реализован в PyTorch
DetectionModel, поэтому--augmentвлияет только на чекпойнты.pt. Экспортированные модели в форматах ONNX, TensorRT и других его игнорируют.