Ансамблирование моделей YOLOv5#
📚 В этом руководстве объясняется, как использовать 🚀 ансамблирование моделей Ultralytics YOLOv5 при тестировании и инференсе, чтобы повысить mAP и полноту.
Ансамблирование моделей — это процесс создания нескольких разнообразных моделей для прогнозирования результата с помощью множества разных алгоритмов моделирования или разных наборов обучающих данных. Затем ансамбль объединяет прогнозы каждой базовой модели в один итоговый прогноз для ранее не встречавшихся данных. Ансамблирование моделей помогает снизить ошибку обобщения прогноза. Если базовые модели разнообразны и независимы, при использовании ансамблевого подхода ошибка прогноза модели уменьшается. Этот подход опирается на мудрость толпы при построении прогноза. Хотя ансамбль состоит из нескольких базовых моделей, он действует и работает как единая модель.
Перед началом#
Клонируй репозиторий и установи зависимости из requirements.txt в окружении Python>=3.8.0, включая PyTorch>=1.8. Модели и датасеты автоматически загружаются из последнего релиза YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
Обычное тестирование#
Перед ансамблированием определи базовую производительность одной модели. Эта команда тестирует YOLOv5x на COCO val2017 с размером изображения 640 пикселей. yolov5x.pt — самая большая и точная из доступных моделей. Также можно использовать yolov5n.pt, yolov5s.pt, yolov5m.pt и yolov5l.pt либо собственный чекпойнт, полученный при обучении на пользовательском наборе данных, например runs/train/exp/weights/best.pt. Подробнее обо всех доступных моделях см. в таблице предварительно обученных чекпойнтов.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --halfРезультат:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients

val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2846.03it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [02:30<00:00,  1.05it/s]
                 all       5000      36335      0.746      0.626       0.68       0.49
Speed: 0.1ms pre-process, 22.4ms inference, 1.4ms NMS per image at shape (32, 3, 640, 640)  # <--- baseline speed

Evaluating pycocotools mAP... saving runs/val/exp/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.504  # <--- baseline mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.688
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.546
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.351
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.551
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.644
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.382
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.628
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.681  # <--- baseline mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.524
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.735
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.826
Тестирование ансамбля#
Чтобы объединить несколько предварительно обученных моделей в ансамбль для тестирования и инференса, достаточно добавить их к аргументу --weights в любой существующей команде val.py или detect.py. В этом примере тестируется ансамбль из двух моделей:
- YOLOv5x
- YOLOv5l6
python val.py --weights yolov5x.pt yolov5l6.pt --data coco.yaml --img 640 --halfМожно перечислить сколько угодно чекпойнтов, в том числе пользовательские веса, например runs/train/exp5/weights/best.pt. YOLOv5 автоматически запустит каждую модель и объединит их прогнозы для каждого изображения перед выполнением NMS.
Результат:
val: data=./data/coco.yaml, weights=['yolov5x.pt', 'yolov5l6.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.6, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients  # Model 1
Fusing layers...
Model Summary: 501 layers, 77218620 parameters, 0 gradients  # Model 2
Ensemble created with ['yolov5x.pt', 'yolov5l6.pt']  # Ensemble notice

val: Scanning '../datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:00<00:00, 49695545.02it/s]
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [03:58<00:00,  1.52s/it]
                 all       5000      36335      0.747      0.637      0.692      0.502
Speed: 0.1ms pre-process, 39.5ms inference, 2.0ms NMS per image at shape (32, 3, 640, 640)  # <--- ensemble speed

Evaluating pycocotools mAP... saving runs/val/exp3/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.515  # <--- ensemble mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.699
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.557
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.356
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.563
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.668
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.387
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.638
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.689  # <--- ensemble mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.526
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.743
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.844
Инференс с ансамблем#
Добавь модели к аргументу --weights, чтобы выполнить инференс с ансамблем:
python detect.py --weights yolov5x.pt yolov5l6.pt --img 640 --source data/imagesРезультат:
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients
Fusing layers...
Model Summary: 501 layers, 77218620 parameters, 0 gradients
Ensemble created with ['yolov5x.pt', 'yolov5l6.pt']

image 1/2 /content/yolov5/data/images/bus.jpg: 640x512 4 persons, 1 bus, 1 tie, Done. (0.063s)
image 2/2 /content/yolov5/data/images/zidane.jpg: 384x640 3 persons, 2 ties, Done. (0.056s)
Results saved to runs/detect/exp2
Done. (0.223s)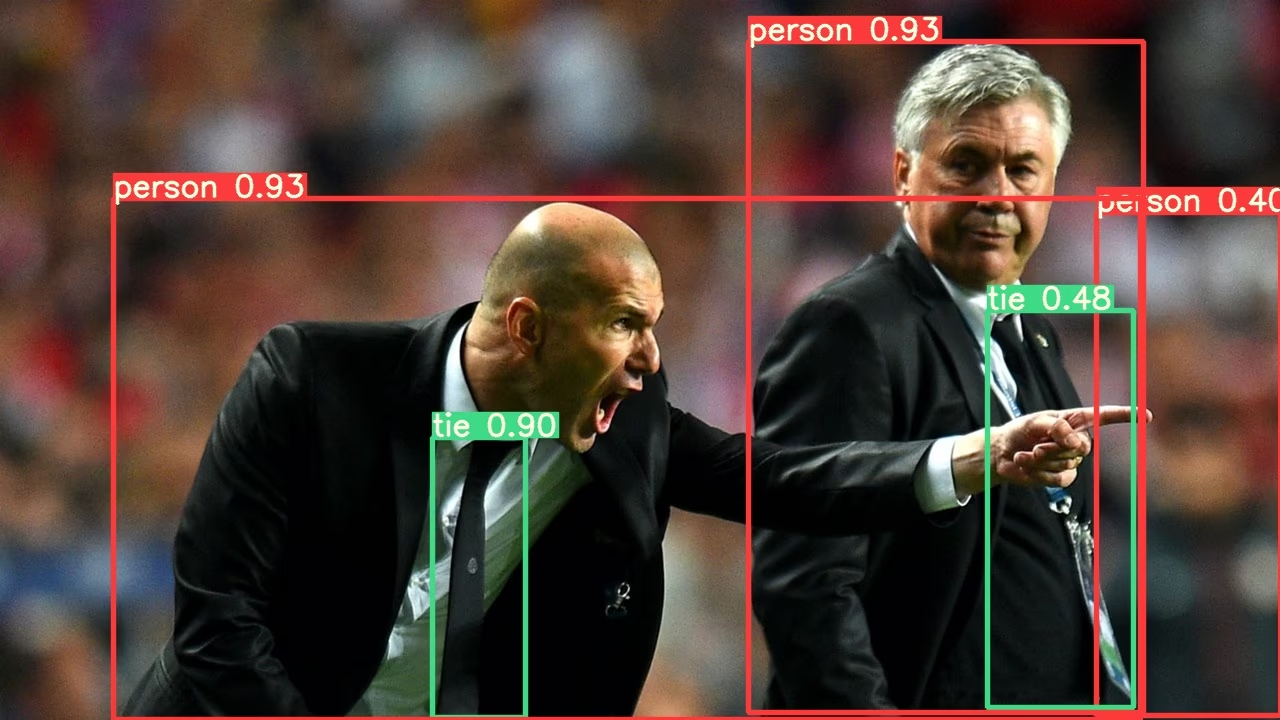
Преимущества ансамблирования моделей#
Ансамблирование моделей с YOLOv5 даёт несколько преимуществ:
- Повышение точности: как показано в примерах выше, ансамблирование нескольких моделей повышает mAP с 0.504 до 0.515, а mAR — с 0.681 до 0.689.
- Лучшее обобщение: объединение разнообразных моделей помогает уменьшить переобучение и повысить производительность на разных данных.
- Повышение устойчивости: ансамбли, как правило, лучше справляются с шумом и выбросами в данных.
- Взаимодополняющие преимущества: разные модели могут лучше распознавать разные типы объектов или работать в различных условиях окружающей среды.
Главный компромисс — увеличение времени инференса, как показывают метрики скорости: 22.4 мс для одной модели против 39.5 мс для ансамбля.
Когда использовать ансамблирование моделей#
Рассмотри ансамблирование моделей в следующих сценариях:
- Когда точность важнее скорости инференса
- В критически важных приложениях, где необходимо свести к минимуму ложноотрицательные результаты
- При обработке сложных изображений с разным освещением, перекрытиями или масштабом объектов
- На соревнованиях или при сравнительном тестировании, где нужна максимальная производительность
Для приложений реального времени со строгими требованиями к задержке лучше подойдёт инференс с одной моделью.
Поддерживаемые среды#
Ultralytics предлагает готовые среды, в каждой из которых предварительно установлены необходимые зависимости, такие как CUDA, CUDNN, Python и PyTorch, чтобы ты мог сразу приступить к работе над проектами.
- Бесплатные ноутбуки с GPU:


- Google Cloud: краткое руководство по GCP
- Amazon: краткое руководство по AWS
- Azure: краткое руководство по AzureML
- Docker: краткое руководство по Docker

Статус проекта#

Этот значок означает, что все тесты YOLOv5 GitHub Actions для непрерывной интеграции (CI) проходят успешно. Эти тесты CI тщательно проверяют функциональность и производительность YOLOv5 по ряду ключевых направлений: обучение, валидация, инференс, экспорт и сравнительное тестирование. Они обеспечивают стабильную и надёжную работу в macOS, Windows и Ubuntu. Тестирование проводится каждые 24 часа и после каждого нового коммита.
Часто задаваемые вопросы#
Сколько угодно. Перечисли все чекпойнты после
--weights, например--weights yolov5x.pt yolov5l6.pt runs/train/exp/weights/best.pt. Время инференса увеличивается примерно пропорционально количеству моделей.Да. Прогнозы объединяются перед NMS, поэтому все модели должны быть обучены на одном и том же списке классов в одинаковом порядке. Размеры входных данных и архитектуры могут различаться.
Да. Добавь
--augmentк той же командеval.pyилиdetect.py, чтобы применить TTA ко всем моделям ансамбля.Ансамблированием управляет модуль PyTorch
Ensembleвmodels/experimental.py, поэтому оно работает только с чекпойнтами.pt. Если нужны файлы ONNX или TensorRT, экспортируй каждую модель отдельно.