Советы для достижения наилучших результатов при обучении YOLOv5
В этом руководстве объясняется, как получить наилучшие показатели mAP и результаты обучения с помощью YOLOv5.
В большинстве случаев хороших результатов можно добиться, не меняя модели и параметры обучения, если набор данных достаточно большой и хорошо размечен. Если сразу получить хороший результат не удалось, можно предпринять несколько шагов для его улучшения, но мы всегда рекомендуем сначала обучить модель со всеми настройками по умолчанию и только потом что-либо менять. Это поможет определить исходный уровень производительности и найти возможности для улучшения.
Если у тебя есть вопросы о результатах обучения, предоставь как можно больше информации, чтобы получить полезный ответ. Добавь графики результатов (потери при обучении и валидации, P, R, mAP), PR-кривую, матрицу ошибок, мозаики обучения, результаты тестирования и изображения со статистикой набора данных, например labels.png. Всё это находится в каталоге project/name, обычно yolov5/runs/train/exp.
В разделах ниже рассмотрены основные факторы, влияющие на результаты обучения YOLOv5.
Датасет#
- Изображения на класс. Рекомендуется не менее 1500 изображений на класс
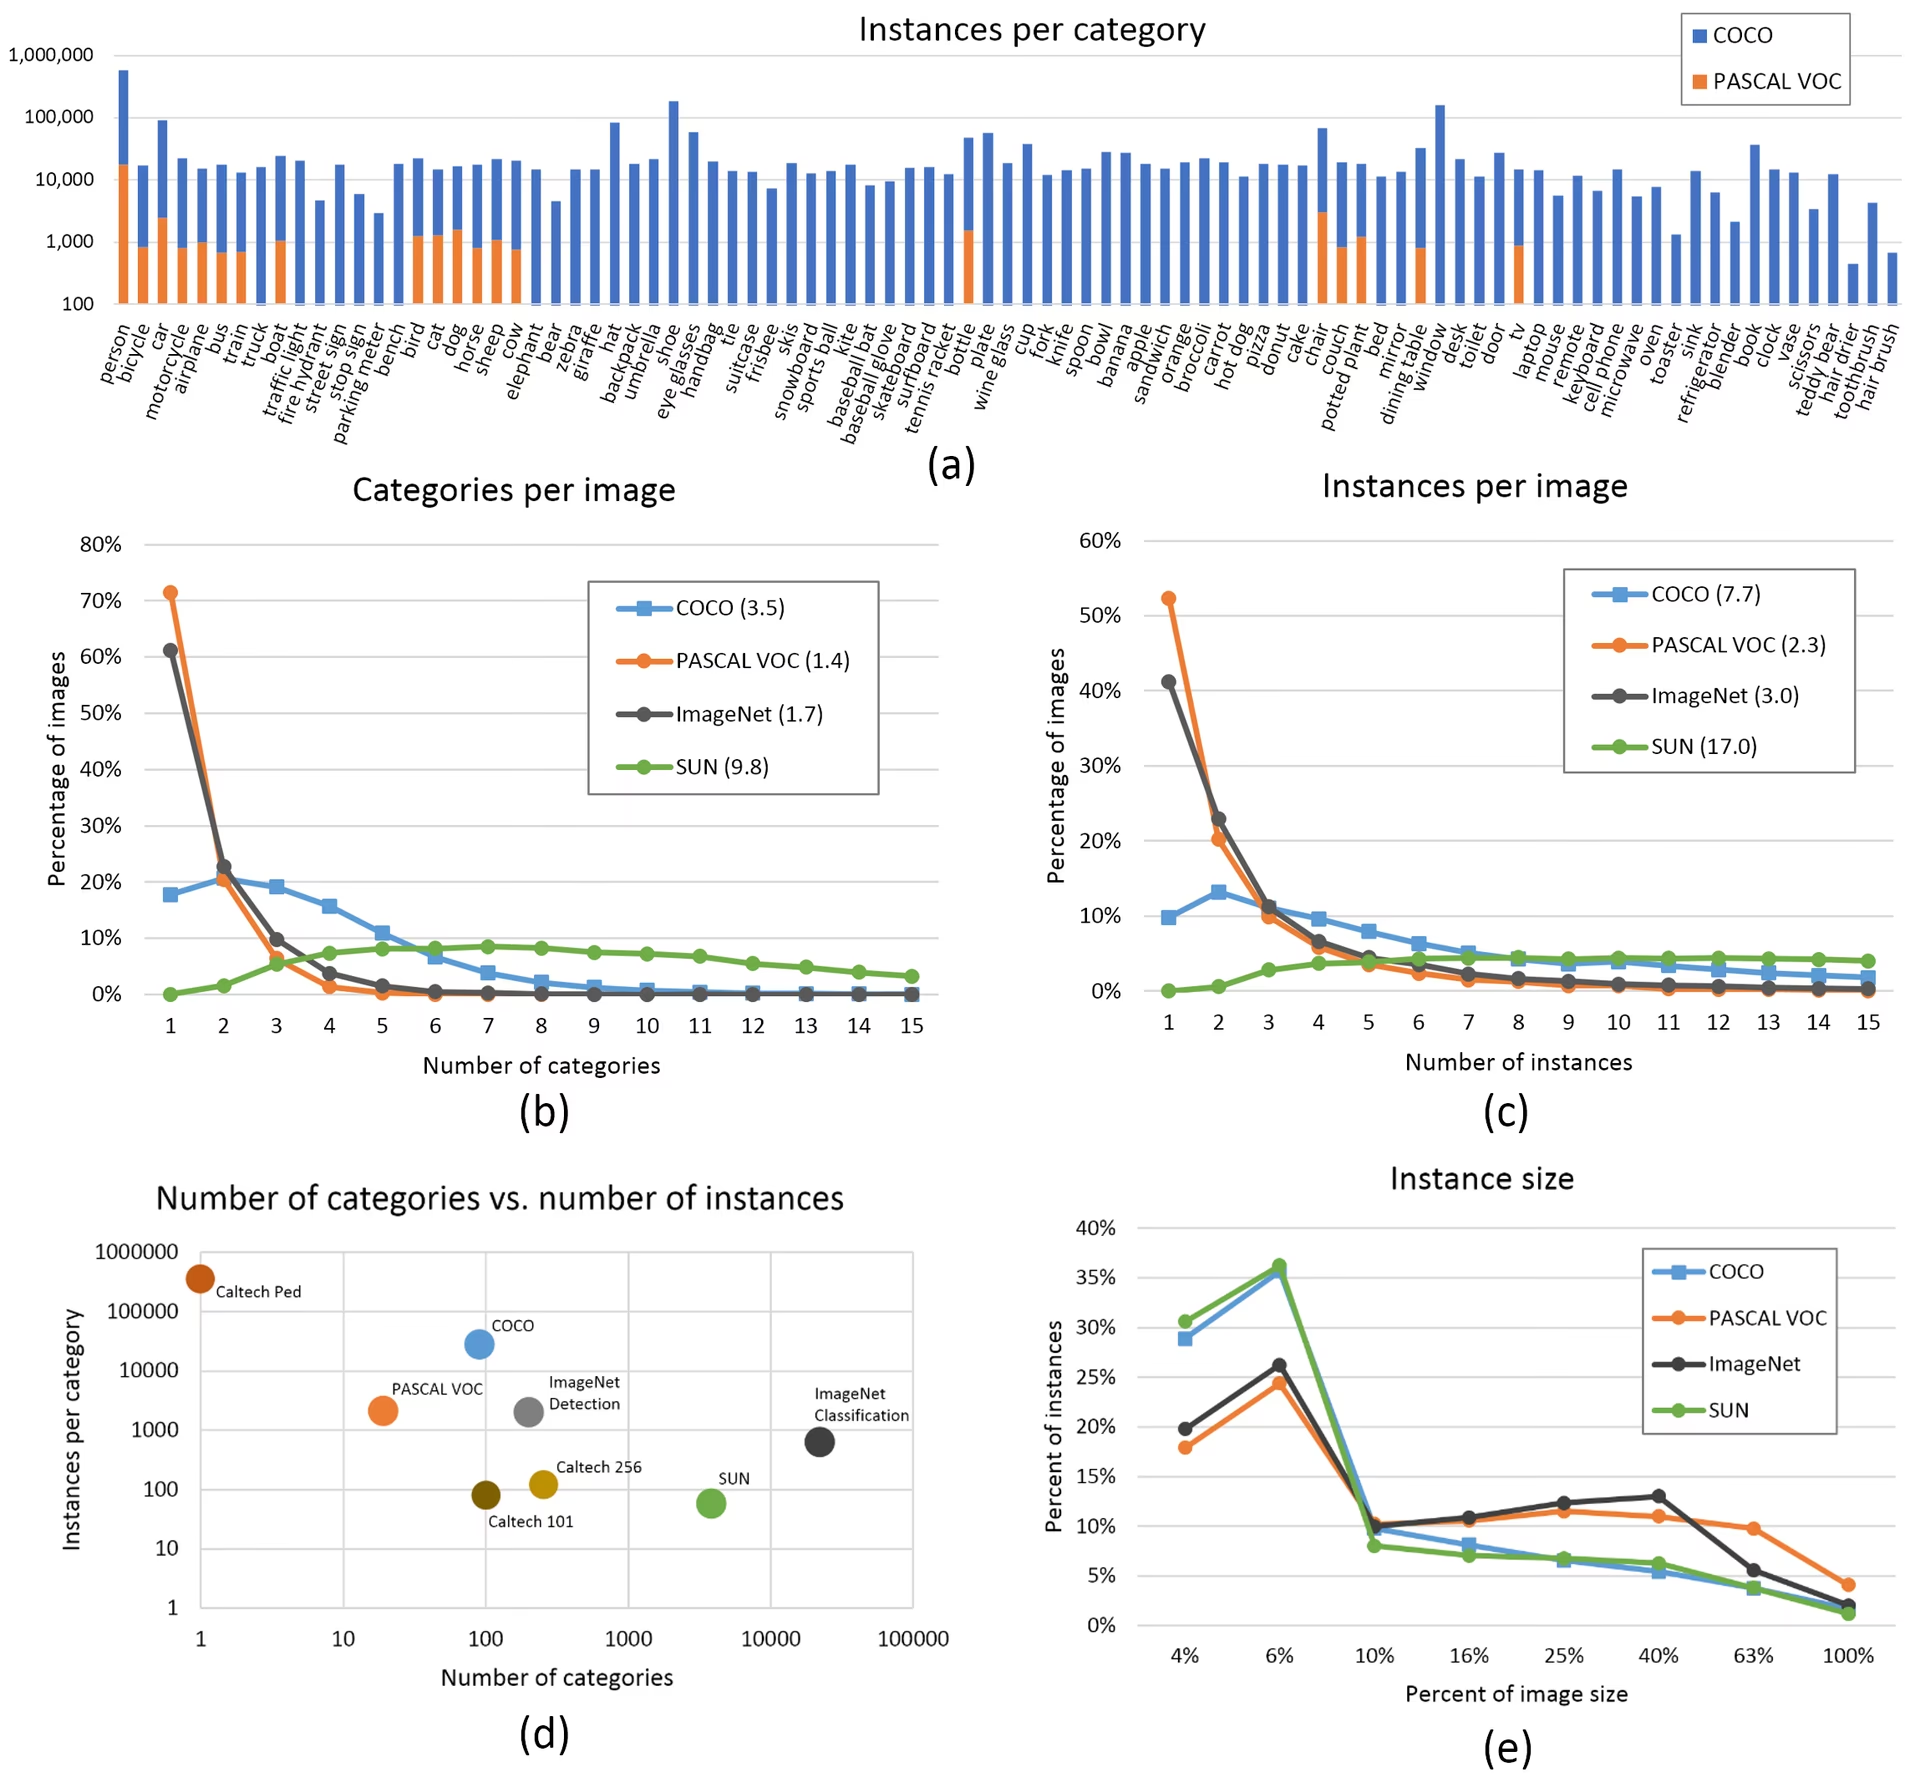
- Экземпляры на класс. Рекомендуется не менее 10000 экземпляров (размеченных объектов) на класс
- Разнообразие изображений. Датасет должен соответствовать условиям среды, в которой будет развернута модель. Для реальных сценариев использования рекомендуем изображения, снятые в разное время суток, в разные сезоны и при разной погоде, освещении и с разных ракурсов, а также полученные из разных источников (собранные в интернете, локально, с разных камер) и т. д.
- Единообразие разметки. На всех изображениях должны быть размечены все экземпляры всех классов. Частичная разметка не подойдет.
- Точность разметки. Метки должны точно охватывать каждый объект. Между объектом и его ограничивающей рамкой не должно быть пустого пространства. У каждого объекта должна быть метка.
- Корректное разделение на обучающую и валидационную выборки. Чтобы избежать чрезмерно оптимистичных метрик, не включай изображения для валидации и тестирования в обучающую выборку. Сохраняй похожее распределение классов во всех выборках.
- Проверка меток. В начале обучения просмотри мозаики
train_batch*.jpg, чтобы убедиться, что метки отображаются правильно. - Фоновые изображения. Это изображения без объектов, которые добавляют в датасет, чтобы уменьшить число ложноположительных срабатываний (FP). Для снижения количества ложноположительных срабатываний рекомендуем добавлять около 0–10% фоновых изображений (для сравнения: в COCO их 1000, или 1% от общего количества изображений). Для фоновых изображений разметка не требуется.
Выбор модели#
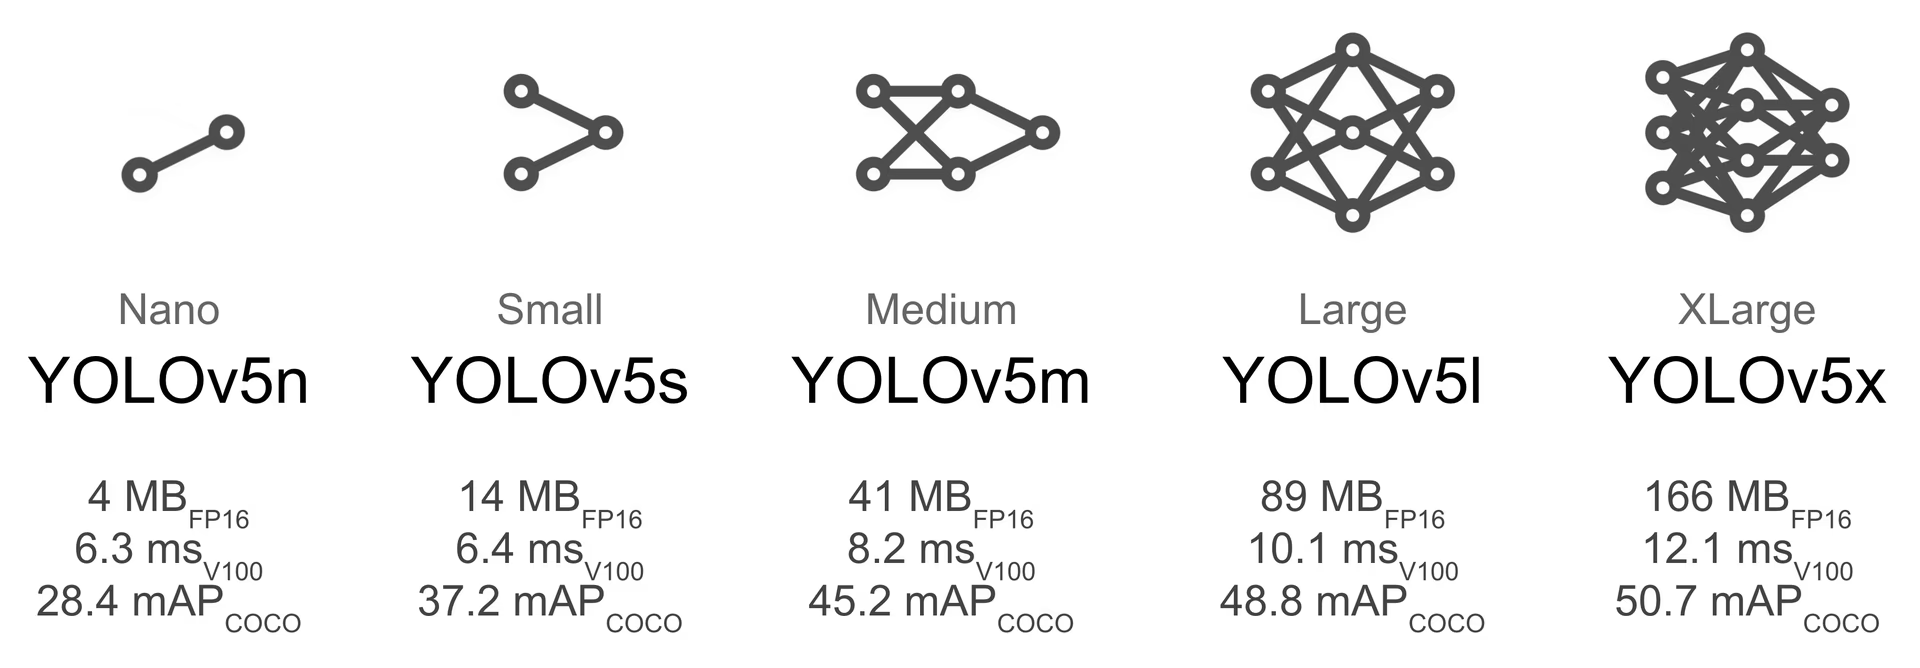
Более крупные модели, такие как YOLOv5x и YOLOv5x6, почти всегда дают лучшие результаты, но содержат больше параметров, требуют больше памяти CUDA для обучения и медленнее выполняются. Для развёртывания на мобильных устройствах рекомендуем YOLOv5s/m, а для облака — YOLOv5l/x.
-
Начни с предварительно обученных весов. Рекомендуется для наборов данных малого и среднего размера (например, VOC, VisDrone, GlobalWheat). Передай название модели аргументу
--weights. Модели автоматически скачиваются из последнего релиза YOLOv5.python train.py --data custom.yaml --weights yolov5s.pt python train.py --data custom.yaml --weights yolov5m.pt python train.py --data custom.yaml --weights yolov5l.pt python train.py --data custom.yaml --weights yolov5x.pt python train.py --data custom.yaml --weights custom_pretrained.pt -
Начни с нуля. Рекомендуется для больших наборов данных (например, COCO, Objects365, OIv6). Передай YAML-файл архитектуры модели, которую хочешь использовать, и пустой аргумент
--weights '':python train.py --data custom.yaml --weights '' --cfg yolov5s.yaml python train.py --data custom.yaml --weights '' --cfg yolov5m.yaml python train.py --data custom.yaml --weights '' --cfg yolov5l.yaml python train.py --data custom.yaml --weights '' --cfg yolov5x.yaml
Настройки обучения#
Прежде чем что-либо менять, сначала обучи модель с настройками по умолчанию, чтобы определить базовый уровень производительности. Полный список настроек train.py доступен в парсере аргументов train.py.
- Эпохи. Начни с 300 эпох. Если модель рано переобучается, сократи их количество. Если переобучение не возникает после 300 эпох, продолжай обучение, например до 600 или 1200 эпох.
- Размер изображения. COCO обучается на исходном разрешении
--img 640, однако из-за большого количества мелких объектов в наборе данных обучение на более высоком разрешении, например--img 1280, может дать лучший результат. Если в пользовательском наборе данных много мелких объектов, обучай модель на исходном или более высоком разрешении. Наилучшие результаты инференса достигаются при том же--img, которое использовалось при обучении: например, если ты обучал модель на--img 1280, тестируй её и запускай обнаружение объектов на--img 1280. - Размер пакета. Используй максимально возможный для твоего оборудования
--batch-size. При небольшом размере пакета статистика пакетной нормализации получается неудовлетворительной, поэтому таких значений следует избегать. Чтобы автоматически подобрать оптимальный размер пакета для GPU, используй--batch-size -1. - Скорость обучения. Расписание скорости обучения по умолчанию хорошо работает в большинстве случаев. Чтобы ускорить сходимость, можно использовать флаг
--cos-lr, который включает косинусное расписание скорости обучения: она постепенно снижается по косинусной кривой на протяжении эпох. - Аугментация данных. YOLOv5 использует различные методы аугментации, например мозаику, которая объединяет несколько обучающих изображений. Измени интенсивность аугментации с помощью гиперпараметра
mosaicв файле--hyp, чтобы стабилизировать обучение. - Гиперпараметры. Гиперпараметры по умолчанию указаны в hyp.scratch-low.yaml. Рекомендуем сначала обучить модель с гиперпараметрами по умолчанию и только потом рассматривать их изменение. В целом увеличение гиперпараметров аугментации уменьшает и откладывает переобучение, что позволяет дольше обучать модель и добиваться более высокого итогового mAP. Снижение гиперпараметров, задающих вес компонентов функции потерь, например
hyp['obj'], помогает уменьшить переобучение по соответствующим компонентам потерь. Автоматическую оптимизацию этих гиперпараметров описывает наше руководство по эволюционному подбору гиперпараметров. - Обучение с пониженной точностью. YOLOv5 автоматически включает автоматическое обучение со смешанной точностью (AMP) при обнаружении поддерживаемого GPU. Это ускоряет обучение и снижает потребление памяти без потери точности модели.
- Обучение на нескольких GPU. Если у тебя несколько GPU, запусти распределённое обучение DistributedDataParallel с помощью
python -m torch.distributed.run --nproc_per_node 4 train.py ... --device 0,1,2,3, чтобы значительно сократить время обучения. - Ранняя остановка. Используй
--patience 50, чтобы остановить обучение, если метрики валидации не улучшаются в течение 50 эпох. Это сэкономит время и поможет предотвратить переобучение.
Продвинутые методы оптимизации#
- Трансферное обучение. Для специализированных датасетов начни с предварительно обученных весов и при необходимости заморозь слои с помощью
--freeze, чтобы адаптировать модель к конкретной задаче. - Разреживание модели. После обучения можно разредить модель, обнулив избыточные веса с минимальной потерей точности, а затем развернуть её в среде выполнения с поддержкой разреженности, чтобы ускорить выполнение.
- Ансамблирование моделей. Для критически важных приложений обучи несколько моделей с разными конфигурациями и объедини их предсказания в ансамбль, чтобы повысить точность.
- Аугментация во время тестирования. Включи TTA во время инференса с помощью
--augment, чтобы повысить точность предсказаний, объединив предсказания для отражённых и масштабированных версий входного изображения.
Дополнительные материалы#
Если хочешь узнать больше, начни со статьи Karpathy Рецепт обучения нейронных сетей: в ней собраны идеи обучения, применимые практически во всех областях ML.
Удачи! Если у тебя появятся вопросы, дай нам знать.
Часто задаваемые вопросы#
Возможно, твоя модель переобучается, если ошибка на обучении продолжает снижаться, а ошибка на валидации начинает расти. Следи за mAP на валидации: если показатель выходит на плато или снижается, пока ошибка на обучении продолжает уменьшаться, это признак переобучения. Решения включают добавление обучающих данных, усиление аугментации данных или применение методов регуляризации.
Оптимальный размер пакета зависит от объема памяти GPU. Большие пакеты обычно обеспечивают более точную статистику пакетной нормализации и стабильность обучения. Используй максимально возможный для твоего оборудования размер пакета, не допуская нехватки памяти. Чтобы автоматически определить оптимальный размер пакета для твоей конфигурации, используй
--batch-size -1.Чтобы ускорить обучение, попробуй использовать несколько GPU с DDP, кэшировать датасет с помощью
--cacheи оптимизировать размер батча (на поддерживаемых GPU смешанная точность включается автоматически). Также можно использовать вариант модели меньшего размера, например YOLOv5s, если абсолютная точность не критична.


Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.