Интеграция с ClearML#

О ClearML#
ClearML — это платформа с открытым исходным кодом для MLOps, созданная для оптимизации рабочих процессов машинного обучения и экономии времени инженеров.
- 🔨 Отслеживай каждый запуск обучения YOLOv5 в менеджере экспериментов.
- 🔧 Версионируй свои данные для обучения и управляй доступом к ним с помощью встроенного инструмента версионирования данных ClearML.
- 🔦 Обучай модели и следи за запусками удалённо с помощью ClearML Agent.
- 🔬 Находи лучшие значения mAP с помощью оптимизации гиперпараметров в ClearML.
- 🔭 Преврати обученную модель YOLOv5 в API с помощью ClearML Serving — для этого достаточно нескольких команд.
Используй столько инструментов, сколько нужно: начни только с менеджера экспериментов или объедини все инструменты в полноценный конвейер.
🦾 Настройка#
Для отслеживания экспериментов и данных ClearML должен взаимодействовать с сервером. У тебя есть два варианта:
- Зарегистрируйся в бесплатном размещённом сервисе ClearML или
- Разверни собственный сервер ClearML — это проект с открытым исходным кодом, поэтому он подойдёт и для работы с конфиденциальными данными.
Затем установи пакет Python clearml и подключи SDK к своему серверу:
pip install clearmlСоздай учётные данные в разделе Настройки → Рабочая область → Создать учётные данные (в правом верхнем углу интерфейса ClearML), затем выполни команду:
clearml-initСледуй инструкциям. Готово — настройка завершена.
🚀 Обучение YOLOv5 с ClearML#
Чтобы включить отслеживание экспериментов, установи пакет ClearML для pip, если ещё этого не сделал:
pip install clearmlЭто включит интеграцию со скриптом обучения YOLOv5. Теперь каждый запуск обучения будет фиксироваться и сохраняться в менеджере экспериментов ClearML.
Чтобы настроить названия проекта и задачи, передай --project и --name в train.py. По умолчанию используются YOLOv5 и Training. ClearML использует / как разделитель подпроектов, поэтому не используй / в названиях пользовательских проектов.
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cacheИли укажи собственные названия:
python train.py --project my_project --name my_training --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cacheВ каждом запуске фиксируются:
- Исходный код и незакоммиченные изменения
- Установленные пакеты
- Гиперпараметры
- Контрольные точки модели (используй
--save-period n, чтобы сохранять их каждыеnэпох) - Вывод консоли
- Числовые метрики (mAP_0.5, mAP_0.5:0.95, точность, полнота, потери, скорости обучения)
- Сведения о машине, время выполнения и дата создания
- Построенные графики, например коррелограмма меток и матрица ошибок
- Изображения с ограничивающими рамками для каждой эпохи
- Визуализации мозаик для каждой эпохи
- Изображения для валидации каждой эпохи
Все данные отображаются в интерфейсе ClearML, поэтому ты можешь отслеживать обучение в одном месте. Добавь пользовательские столбцы (например, mAP_0.5), чтобы сортировать модели по результатам, или выбери несколько экспериментов, чтобы сравнить их бок о бок.
Продолжай чтение, чтобы узнать об оптимизации гиперпараметров и удалённом выполнении.
🔗 Управление версиями наборов данных#
Версионирование данных отдельно от кода позволяет легко получать последнюю версию и обеспечивает полную воспроизводимость. Этот репозиторий принимает идентификатор версии набора данных, автоматически загружает данные, если их нет, и записывает идентификатор как параметр задачи. Так ты всегда будешь знать, какие данные использовались в каждом эксперименте.
Подготовка набора данных#
Репозиторий YOLOv5 поддерживает множество наборов данных через конфигурационные YAML-файлы. По умолчанию наборы данных скачиваются в папку ../datasets относительно корневой папки репозитория. После скачивания coco128 структура папок выглядит так:
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ LICENSE
        |_ README.txt
Подойдёт любой набор данных, если сохранить эту структуру.
Затем скопируй YAML-файл набора данных в его корневую папку — ClearML читает этот файл, чтобы корректно использовать набор данных. Ты можешь создать собственный YAML-файл по образцу, указав в нём path, train, test, val, nc и names.
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ coco128.yaml  # <---- HERE
        |_ LICENSE
        |_ README.txt
Загрузка набора данных#
Чтобы зарегистрировать набор данных как версионируемый набор данных ClearML, перейди в его корневую папку и выполни команду:
cd ../datasets/coco128
clearml-data sync --project YOLOv5 --name coco128 --folder .
clearml-data sync — это сокращённая запись следующей последовательности команд, которую также можно выполнить явно:
# Add --parent <parent_dataset_id> to base this version on a previous one.
# Duplicate files are not re-uploaded.
clearml-data create --name coco128 --project YOLOv5
clearml-data add --files .
clearml-data close
Обучение на наборе данных ClearML#
После регистрации набора данных укажи его идентификатор при запуске обучения:
python train.py --img 640 --batch 16 --epochs 3 --data clearml://YOUR_DATASET_ID --weights yolov5s.pt --cache👀 Оптимизация гиперпараметров#
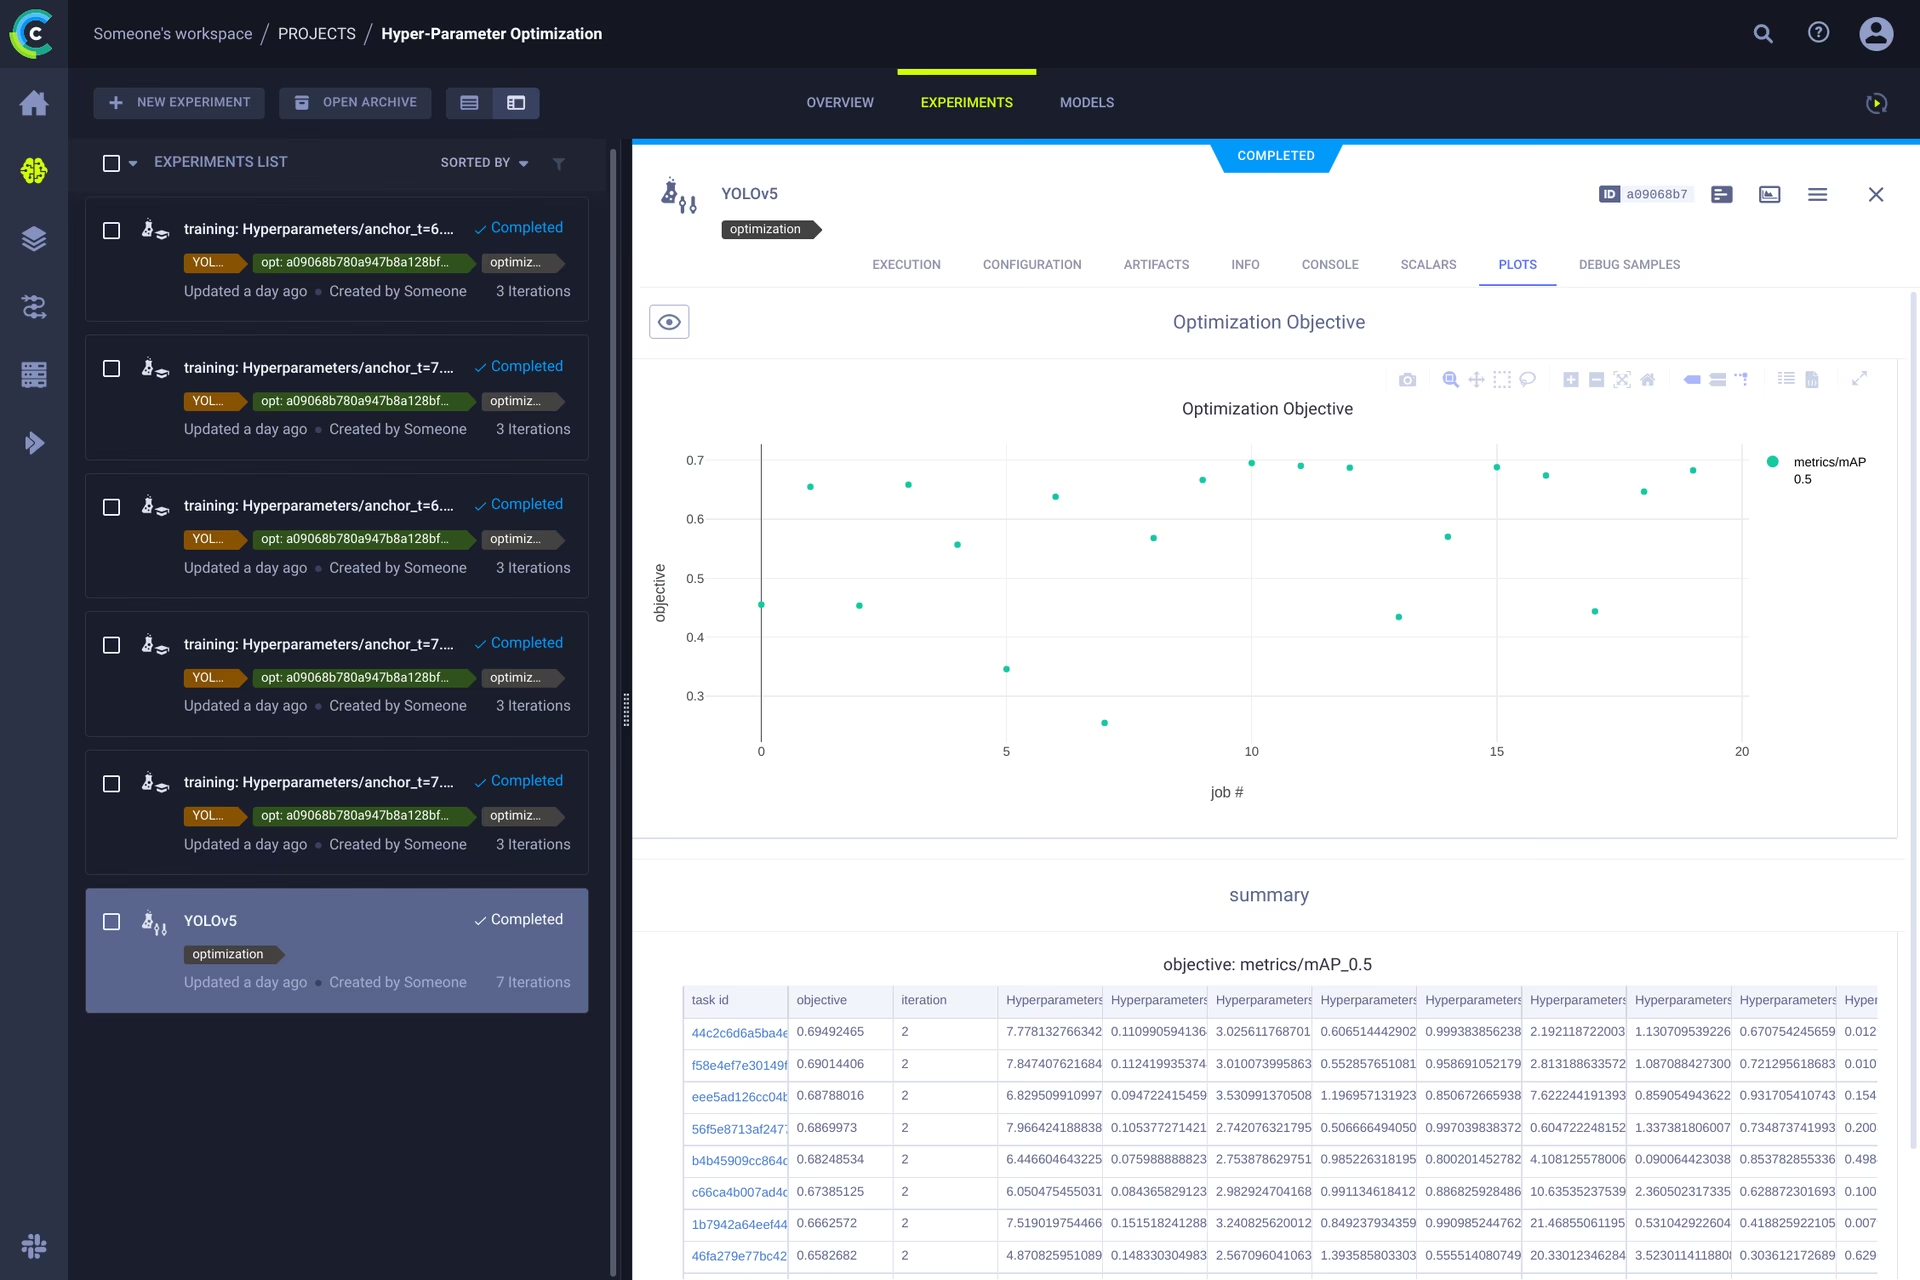
Когда эксперименты и данные версионированы, можно использовать их как основу для дальнейшей работы. Поскольку каждый отслеживаемый эксперимент содержит полное описание окружения — код, установленные пакеты и конфигурацию, — запуски полностью воспроизводимы. ClearML позволяет клонировать эксперимент, менять его параметры и автоматически запускать его повторно — это основа оптимизации гиперпараметров (HPO).
Чтобы запускать HPO локально, используй встроенный скрипт. Сначала убедись, что в менеджере экспериментов есть задача обучения: скрипт клонирует её и меняет гиперпараметры.
Укажи ID шаблонной задачи в utils/loggers/clearml/hpo.py, затем выполни команду:
# Install Optuna or change the optimizer to RandomSearch.
pip install optuna
python utils/loggers/clearml/hpo.py
Чтобы запускать испытания на удалённых агентах, замени optimizer.start_locally() на optimizer.start() и задай execution_queue в вызове HyperParameterOptimizer, указав очередь, которую отслеживают агенты.
🤯 Удалённое выполнение (расширенный уровень)#
Локальный запуск HPO удобен, но часто эксперименты нужно проводить на более мощном оборудовании — например, на локальном GPU-сервере или в облаке. Для этого и нужен ClearML Agent:
Каждый отслеживаемый эксперимент содержит всё необходимое для воспроизведения на другой машине: установленные пакеты, незакоммиченные изменения и конфигурацию. Агент ClearML отслеживает очередь, получает поступающие задачи, воссоздаёт окружение, запускает задачу и передаёт числовые метрики и графики обратно в менеджер экспериментов.
Преврати любую машину — облачную виртуальную машину, локальную машину с GPU или ноутбук — в агент ClearML с помощью команды:
clearml-agent daemon --queue QUEUES_TO_LISTEN_TO [--docker]Клонирование, редактирование и добавление в очередь#
После запуска агента ты можешь назначать ему задачи прямо из интерфейса:
- 🪄 Щёлкни по эксперименту правой кнопкой мыши и клонируй его.
- 🎯 Измени гиперпараметры.
- ⏳ Щёлкни правой кнопкой мыши по клонированной задаче и добавь её в целевую очередь.
Удалённое выполнение задачи#
Также можно программно отметить выполняющийся скрипт для удалённого запуска, добавив task.execute_remotely() после создания логгера ClearML. Добавь выделенную строку в train.py:
# ...
# Loggers
data_dict = None
if RANK in {-1, 0}:
    loggers = Loggers(save_dir=save_dir, weights=weights, opt=opt, hyp=hyp, logger=LOGGER)
    if loggers.clearml:
        loggers.clearml.task.execute_remotely(queue="my_queue")  # <------ ДОБАВЬ ЭТУ СТРОКУ
    # ...
    # Обработка ссылки на артефакт пользовательского набора данных
    data_dict = loggers.remote_dataset
# ...
После этого изменения скрипт обучения выполнится до указанной строки, упакует код и отправит его в очередь.
Автоматическое масштабирование рабочих узлов#
В ClearML есть инструменты автоматического масштабирования, которые запускают удалённые машины в AWS, GCP или Azure, когда в очереди ожидают эксперименты, превращают их в агенты ClearML и выключают после завершения работы. Так ты платишь только за вычислительные ресурсы, которые действительно используются.
Посмотри видео для начала работы ниже:
Подробнее#
Чтобы узнать больше об интеграции ClearML с моделями Ultralytics, ознакомься с нашим руководством по интеграции ClearML и посмотри, как можно улучшить рабочий процесс MLOps с помощью других инструментов отслеживания экспериментов.
Часто задаваемые вопросы#
Нет. Бесплатный облачный сервис на app.clear.ml сразу готов к работе после
clearml-init. Самостоятельное размещение необязательно и обычно выбирается, когда данные не могут покидать твою сеть.YOLOv5 активирует интеграцию, если пакет
clearmlдоступен для импорта, поэтому удали его командойpip uninstall clearml, чтобы отключить отслеживание во время запуска.Зарегистрируй набор данных с помощью
clearml-data sync, затем передай его ID в качестве аргумента data:python train.py --data clearml://YOUR_DATASET_ID --weights yolov5s.pt. ID записывается в задачу, чтобы каждый эксперимент точно знал, какие данные использовались.Да. Запусти
clearml-agent daemonна каждой машине, затем либо поставь клонированные эксперименты в очередь через интерфейс, либо измениutils/loggers/clearml/hpo.py, чтобы он вызывалoptimizer.start()с заданнымexecution_queue, и оптимизатор отправлял испытания в очередь.