Прунинг и разреженность в YOLOv5#
📚 В этом руководстве объясняется, как применять прунинг к моделям YOLOv5 🚀, чтобы создавать более эффективные сети без потери производительности.
Что такое прунинг моделей?#
Прунинг моделей — это метод уменьшения размера и сложности нейронных сетей за счёт удаления менее важных параметров (весов и связей). Это позволяет создавать более эффективные модели и даёт несколько преимуществ:
- Уменьшение размера модели для упрощения развёртывания на устройствах с ограниченными ресурсами
- Ускорение инференса с минимальным влиянием на точность
- Снижение потребления памяти и энергии
- Повышение общей эффективности приложений реального времени
При прунинге выявляются и удаляются параметры, которые почти не влияют на производительность модели. В результате получается более компактная модель с сопоставимой точностью.
Перед началом#
Клонируй репозиторий и установи зависимости из requirements.txt в окружении Python>=3.8.0, включая PyTorch>=1.8. Модели и датасеты автоматически загружаются из последнего релиза YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
Проверка базовой производительности#
Перед прунингом определи базовую производительность для сравнения. Эта команда тестирует YOLOv5x на COCO val2017 с размером изображения 640 пикселей. yolov5x.pt — самая большая и точная из доступных моделей. Также можно использовать yolov5s.pt, yolov5m.pt и yolov5l.pt либо собственный чекпойнт, полученный при обучении на пользовательском наборе данных, например runs/train/exp/weights/best.pt. Подробнее обо всех доступных моделях см. в таблице в README.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --halfРезультат:
val: data=/content/yolov5/data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, workers=8, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True, dnn=False
YOLOv5 🚀 v6.0-224-g4c40933 torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)

Fusing layers...
Model Summary: 444 layers, 86705005 parameters, 0 gradients
val: Scanning '/content/datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupt: 100% 5000/5000 [00:00<?, ?it/s]
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [01:12<00:00,  2.16it/s]
                 all       5000      36335      0.732      0.628      0.683      0.496
Speed: 0.1ms pre-process, 5.2ms inference, 1.7ms NMS per image at shape (32, 3, 640, 640)  # <--- base speed

Evaluating pycocotools mAP... saving runs/val/exp2/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.507  # <--- base mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.689
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.552
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.345
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.559
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.652
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.381
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.630
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.682
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.526
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.731
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.829
Results saved to runs/val/exp2
Применение прунинга к YOLOv5x (разреженность 30%)#
Для прунинга модели можно использовать функцию prune(), определённую в utils/torch_utils.py. Чтобы проверить модель после прунинга, изменим val.py и применим к YOLOv5x разреженность 0.3 (30% весов будут обнулены):
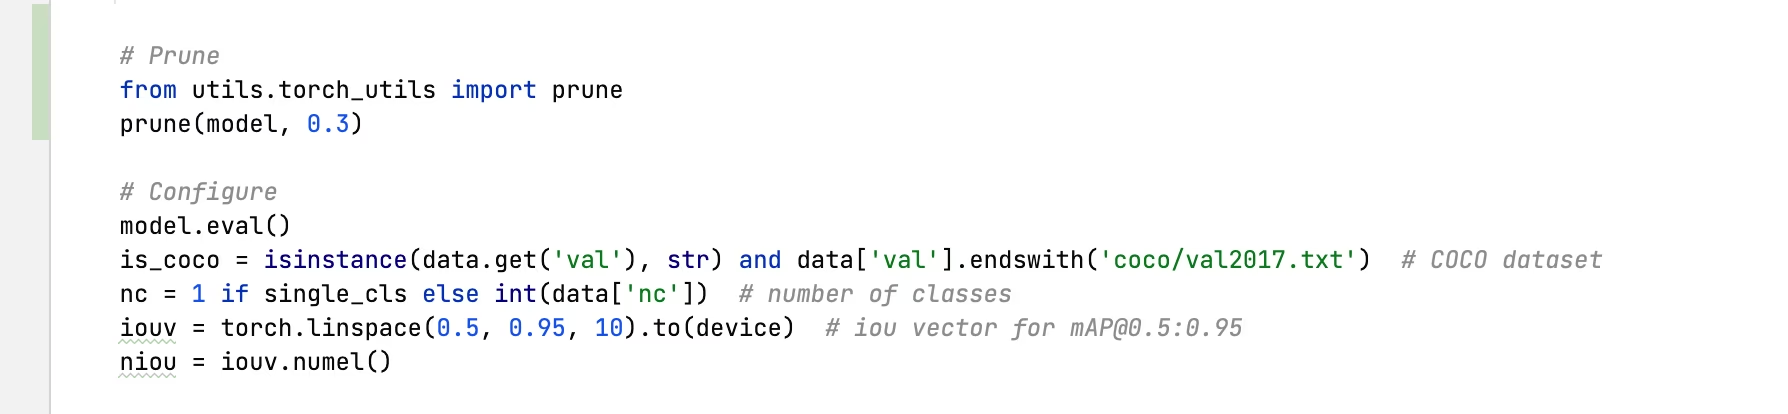
Результат после прунинга на 30%:
val: data=/content/yolov5/data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, workers=8, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True, dnn=False
YOLOv5 🚀 v6.0-224-g4c40933 torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)

Fusing layers...
Model Summary: 444 layers, 86705005 parameters, 0 gradients
Pruning model...  0.3 global sparsity
val: Scanning '/content/datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupt: 100% 5000/5000 [00:00<?, ?it/s]
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [01:11<00:00,  2.19it/s]
                 all       5000      36335      0.724      0.614      0.671      0.478
Speed: 0.1ms pre-process, 5.2ms inference, 1.7ms NMS per image at shape (32, 3, 640, 640)  # <--- prune speed

Evaluating pycocotools mAP... saving runs/val/exp3/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.489  # <--- prune mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.677
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.537
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.334
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.542
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.635
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.370
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.612
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.664
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.496
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.722
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.803
Results saved to runs/val/exp3
Анализ результатов#
По результатам можно сделать следующие выводы:
- Достигнута разреженность 30%: теперь 30% параметров весов в слоях
nn.Conv2dмодели равны нулю - Время инференса не изменилось: несмотря на прунинг, скорость обработки осталась практически такой же
- Минимальное влияние на производительность: mAP немного снизился с 0.507 до 0.489 (всего на 3.6%)
- Размер модели не изменился: нулевые веса по-прежнему хранятся в плотном виде, поэтому размер файла уменьшается только при использовании форматов с поддержкой разреженности или сжатия
Это показывает, что прунинг может значительно снизить сложность модели, лишь незначительно повлияв на производительность. Поэтому это эффективный метод оптимизации для развёртывания в средах с ограниченными ресурсами.
Дообучение моделей после прунинга#
Для достижения наилучших результатов после прунинга модели следует дообучить, чтобы восстановить точность. Для этого можно:
- Применить прунинг с нужным уровнем разреженности
- Обучать модель после прунинга несколько эпох с меньшей скоростью обучения
- Сравнить дообученную модель после прунинга с базовой моделью
Этот процесс помогает оставшимся параметрам адаптироваться и компенсировать удалённые связи, что часто позволяет восстановить большую часть или всю исходную точность.
Поддерживаемые среды#
Ultralytics предлагает готовые среды, в каждой из которых предварительно установлены необходимые зависимости, такие как CUDA, CUDNN, Python и PyTorch, чтобы ты мог сразу приступить к работе над проектами.
- Бесплатные ноутбуки с GPU:


- Google Cloud: краткое руководство по GCP
- Amazon: краткое руководство по AWS
- Azure: краткое руководство по AzureML
- Docker: краткое руководство по Docker

Статус проекта#

Этот значок означает, что все тесты YOLOv5 GitHub Actions для непрерывной интеграции (CI) проходят успешно. Эти тесты CI тщательно проверяют функциональность и производительность YOLOv5 по ряду ключевых направлений: обучение, валидация, инференс, экспорт и сравнительное тестирование. Они обеспечивают стабильную и надёжную работу в macOS, Windows и Ubuntu. Тестирование проводится каждые 24 часа и после каждого нового коммита.
Часто задаваемые вопросы#
При неструктурированном прунинге веса обнуляются, но формы тензоров не меняются, поэтому плотные ядра PyTorch выполняют тот же объём работы. Для ускорения нужна среда выполнения с поддержкой разреженности, например DeepSparse, или структурированный прунинг, удаляющий целые каналы.
Вызови вспомогательную функцию из
utils/torch_utils.pyперед проверкой или экспортом:from utils.torch_utils import prune prune(model, amount=0.3) # 30% глобальная разреженность для весов nn.Conv2dНачни с 0.3 и измерь mAP. Без дообучения YOLOv5x потеряла около 3.6% mAP при разреженности 30%; для более высоких уровней разреженности обычно требуется несколько эпох повторного обучения с низкой скоростью обучения, чтобы восстановить точность.
Да. Обнулённые веса сохраняются так же, как и остальные, поэтому
export.pyработает без изменений. Размер файла уменьшится, только если целевой формат или среда выполнения сжимает разреженные тензоры.