Эволюционный подбор гиперпараметров для YOLOv5#
📚 В этом руководстве рассматривается эволюционный подбор гиперпараметров для YOLOv5 🚀. Эволюционный подбор гиперпараметров — это метод оптимизации гиперпараметров с использованием генетического алгоритма (GA).
Гиперпараметры в машинном обучении управляют различными аспектами обучения, и подобрать для них оптимальные значения бывает непросто. Традиционные методы, такие как поиск по сетке, быстро становятся непрактичными из-за:
- Большого пространства поиска
- Неизвестных корреляций между измерениями
- Высокой стоимости оценки целевой функции в каждой точке
Поэтому генетические алгоритмы хорошо подходят для поиска гиперпараметров.
Перед началом#
Клонируй репозиторий и установи зависимости из requirements.txt в окружении Python>=3.8.0, включая PyTorch>=1.8. Модели и датасеты автоматически загружаются из последнего релиза YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
1. Инициализация гиперпараметров#
В YOLOv5 используется около 30 гиперпараметров для различных настроек обучения. Они определены в файлах *.yaml в каталоге /data/hyps. Более удачные начальные значения приведут к лучшим итоговым результатам, поэтому важно правильно задать эти значения перед эволюционным подбором. Если не знаешь, с чего начать, просто используй значения по умолчанию: они оптимизированы для обучения YOLOv5 на COCO с нуля.
# YOLOv5 🚀 by Ultralytics, AGPL-3.0 license
# Hyperparameters for low-augmentation COCO training from scratch
# python train.py --batch 64 --cfg yolov5n6.yaml --weights '' --data coco.yaml --img 640 --epochs 300 --linear
# See tutorials for hyperparameter evolution https://github.com/ultralytics/yolov5#tutorials

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.01 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
2. Определение целевой функции#
Целевая функция — это значение, которое мы стремимся максимизировать. В YOLOv5 по умолчанию используется целевая функция, представляющая собой взвешенную комбинацию метрик: mAP@0.5 составляет 10% веса, а mAP@0.5:0.95 — оставшиеся 90%; точность (P) и полнота (R) не учитываются. При необходимости можно изменить эти значения или использовать определение целевой функции по умолчанию в utils/metrics.py (рекомендуется). Эта целевая функция определяет, какой результат будет сохранён в hyp_evolve.yaml; сам генетический алгоритм ранжирует родительские особи и элиту только по mAP@0.5, поэтому изменение этих весов не влияет на выбор родительских особей.
def fitness(x):
    """Return model fitness as the sum of weighted metrics [P, R, mAP@0.5, mAP@0.5:0.95]."""
    w = [0.0, 0.0, 0.1, 0.9]  # веса для [P, R, mAP@0.5, mAP@0.5:0.95]
    return (x[:, :4] * w).sum(1)
3. Развитие#
Развитие выполняется относительно базового сценария, который мы стремимся улучшить. В этом примере базовый сценарий — дообучение COCO128 в течение 10 эпох с использованием предварительно обученной YOLOv5s. Команда для обучения в базовом сценарии:
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cacheЧтобы эволюционно оптимизировать гиперпараметры, характерные для этого сценария, начиная с исходных значений, заданных в разделе 1., и максимизируя целевую функцию, определённую в разделе 2., добавь --evolve:
# Single-GPU
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --evolve

# Multi-GPU with delay
for i in {0..7}; do
  sleep $((30 * i)) # 30-second delay (optional)
  echo "Starting GPU $i..."
  nohup python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log" &
done

# Continuous training (use with caution)
# for i in {0..7}; do
#   sleep $((30 * i))  # 30-second delay (optional)
#   echo "Starting continuous training on GPU $i..."
#   (
#     while true; do
#       python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log"
#     done
#   ) &
# done
По умолчанию эволюционный поиск выполняется в течение 300 поколений, и в каждом поколении базовый сценарий обучается один раз для каждого из 50 особей в популяции. Количество поколений можно изменить с помощью аргумента --evolve, например python train.py --evolve 1000.
Основные генетические операторы — скрещивание и мутация. В каждом поколении обучается каждая особь и оценивается по mAP@0.5, родители выбираются турнирным отбором, а наиболее приспособленные элитные особи добавляются в пул родителей. Следующее поколение формируется с помощью скрещивания и мутации, частота которых адаптируется по мере развития эволюции. Результаты записываются в runs/evolve/exp/evolve.csv, а потомок с наибольшей приспособленностью сохраняется в каждом поколении как runs/evolve/exp/hyp_evolve.yaml:
# YOLOv5 Hyperparameter Evolution Results
# Best generation: 287
# Last generation: 300
#    metrics/precision,       metrics/recall,      metrics/mAP_0.5, metrics/mAP_0.5:0.95,         val/box_loss,         val/obj_loss,         val/cls_loss
#              0.54634,              0.55625,              0.58201,              0.33665,             0.056451,             0.042892,             0.013441

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.2 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
Для достижения наилучших результатов мы рекомендуем проводить эволюционный поиск не менее чем в течение 300 поколений. Учти, что эволюционный поиск обычно требует много времени и ресурсов: базовый сценарий обучается тысячи раз, что может потребовать сотни или тысячи часов работы GPU.
После завершения эволюционного поиска используй найденные настройки, указав сохранённый файл при запуске обучения, например python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt.
4. Визуализация#
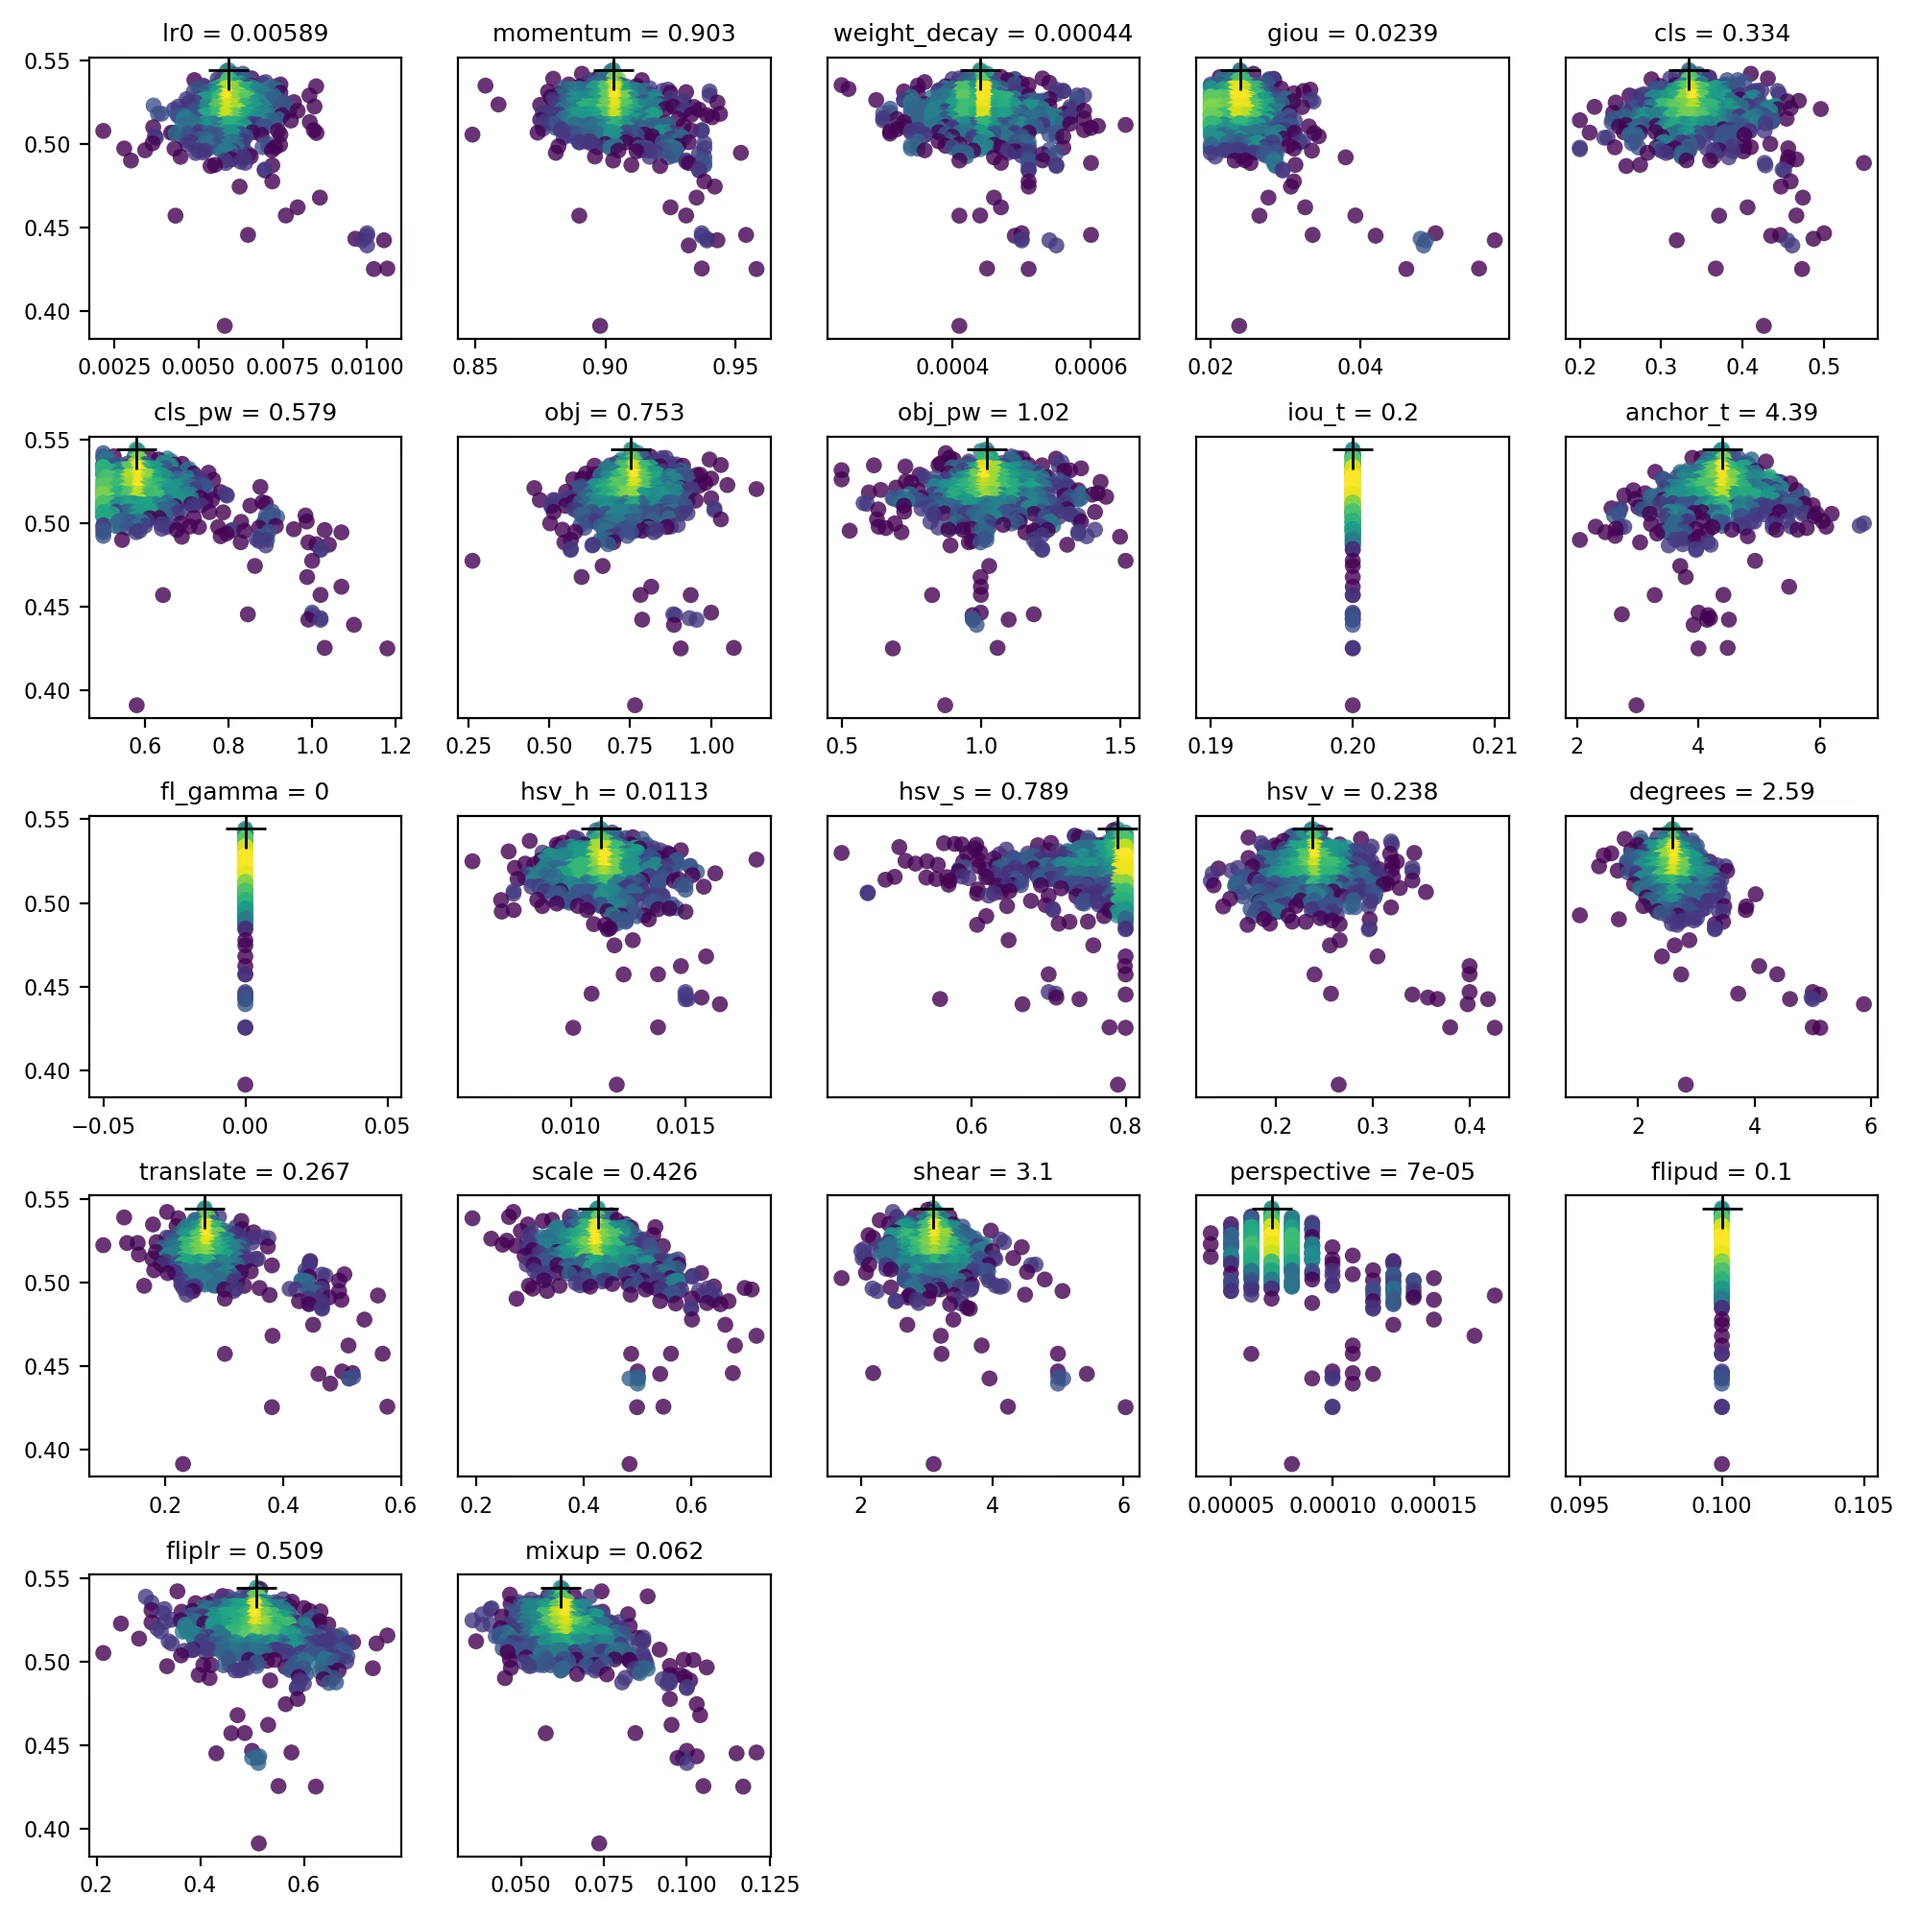
После завершения эволюционного поиска evolve.csv строится как evolve.png с помощью utils.plots.plot_evolve(): для каждого гиперпараметра отображается отдельный график зависимости приспособленности (ось y) от значений гиперпараметра (ось x). Жёлтый цвет обозначает более высокую концентрацию. Вертикальные распределения указывают, что параметр отключён и не мутирует. Это можно настроить в словаре meta в файле train.py; такая настройка полезна для фиксации параметров и предотвращения их эволюционного изменения.
Поддерживаемые среды#
Ultralytics предлагает готовые среды, в каждой из которых предварительно установлены необходимые зависимости, такие как CUDA, CUDNN, Python и PyTorch, чтобы ты мог сразу приступить к работе над проектами.
- Бесплатные ноутбуки с GPU:


- Google Cloud: краткое руководство по GCP
- Amazon: краткое руководство по AWS
- Azure: краткое руководство по AzureML
- Docker: краткое руководство по Docker

Статус проекта#

Этот значок означает, что все тесты YOLOv5 GitHub Actions для непрерывной интеграции (CI) проходят успешно. Эти тесты CI тщательно проверяют функциональность и производительность YOLOv5 по ряду ключевых направлений: обучение, валидация, инференс, экспорт и сравнительное тестирование. Они обеспечивают стабильную и надёжную работу в macOS, Windows и Ubuntu. Тестирование проводится каждые 24 часа и после каждого нового коммита.
Часто задаваемые вопросы#
В каждом поколении базовый сценарий обучается один раз для каждой особи в популяции из 50 особей, поэтому 300 поколений с запуском COCO128 на 10 эпох требуют примерно в 15 000 раз больше ресурсов, чем один такой запуск. Выбирай короткий и репрезентативный базовый сценарий. Приведённый выше цикл для нескольких GPU запускает независимый поиск на каждом GPU, а не распределяет один поиск между ними, поэтому уменьши
--evolveдля каждого процесса, если работаешь в рамках фиксированного бюджета.Да. По умолчанию
--evolveравно 300 поколениям; укажи, например,--evolve 1000, чтобы запустить больше.Задай первое значение для этого параметра в словаре
metaвtrain.pyравнымFalse. Исключённые параметры сохраняют исходное значение и отображаются вертикальными линиями на графикеevolve.png.Передай сохранённый файл обычному запуску обучения:
python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt.