Обучение YOLOv5 на пользовательских данных#
В этом руководстве объясняется, как обучить собственную модель на пользовательском наборе данных с помощью YOLOv5. Обучение собственных моделей — важный шаг для адаптации решений компьютерного зрения к конкретным реальным задачам, выходящим за рамки обычного обнаружения объектов.
Перед началом#
Сначала подготовь необходимую среду. Клонируй репозиторий YOLOv5 и установи необходимые зависимости из requirements.txt. Для работы необходима среда Python>=3.8.0 с PyTorch>=1.8. Если модели и наборы данных не найдены локально, они автоматически загружаются из последнего релиза YOLOv5.
git clone https://github.com/ultralytics/yolov5 # Clone the repository
cd yolov5
pip install -r requirements.txt # Install dependencies
Обучение на пользовательских данных#
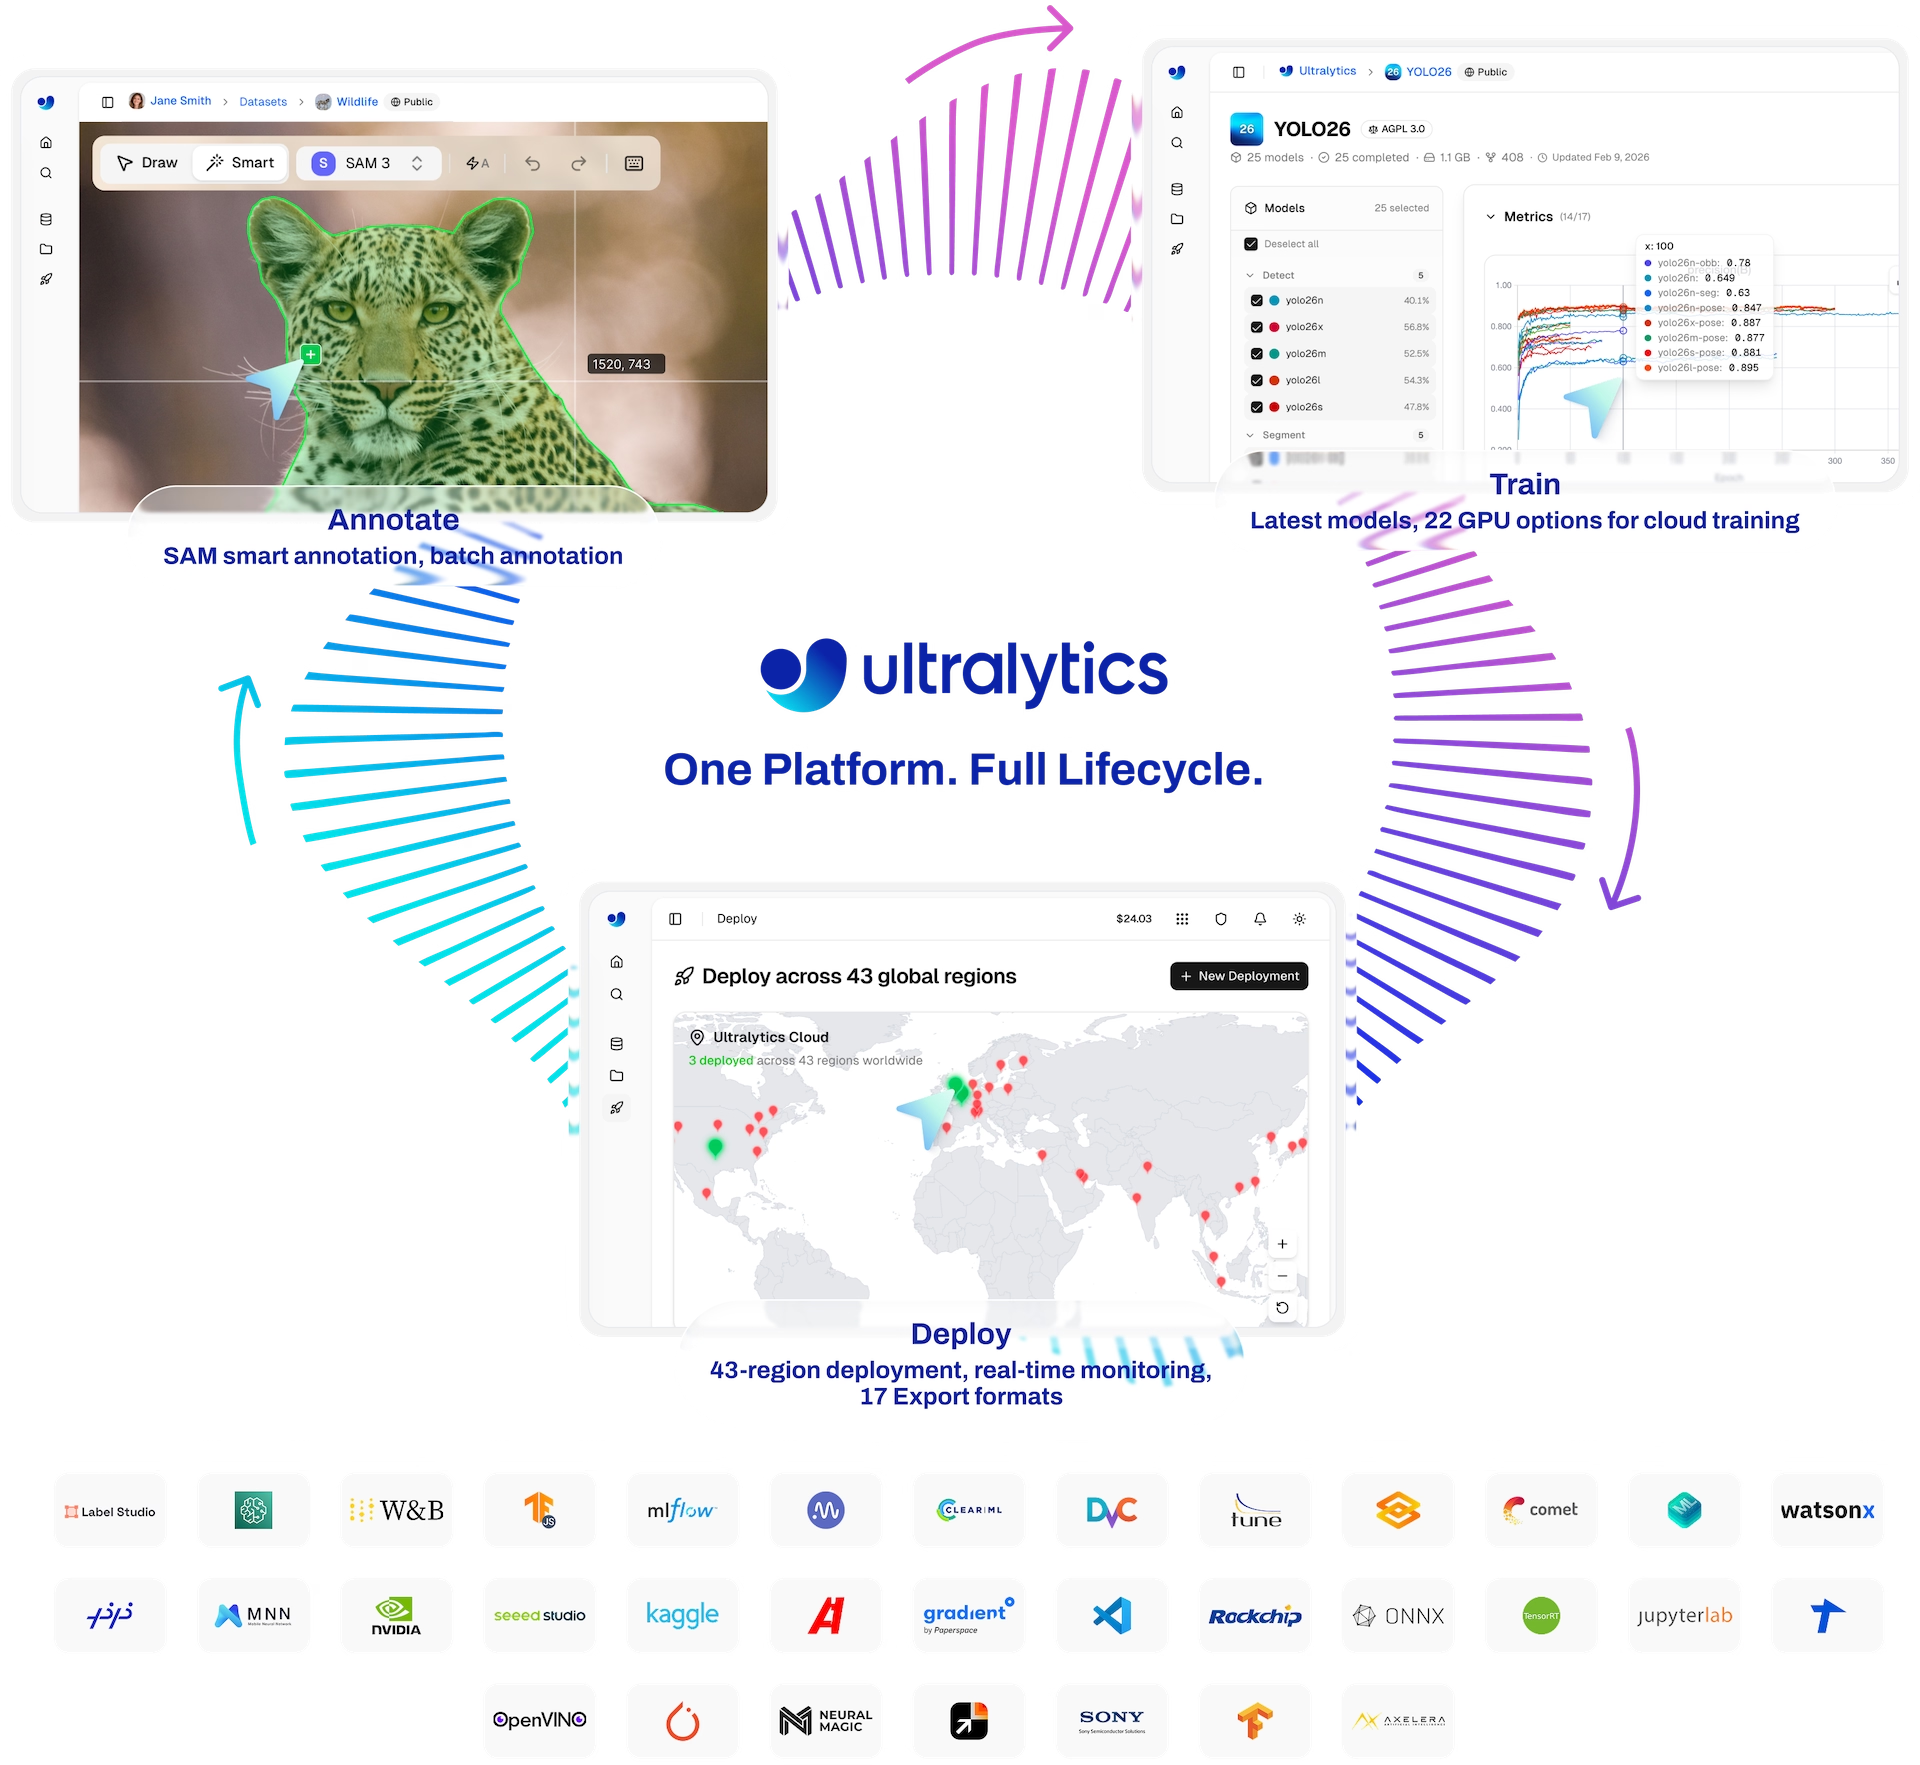
Разработка пользовательской модели обнаружения объектов — итеративный процесс:
- Собери и упорядочь изображения: собери изображения, относящиеся к конкретной задаче. Важны качественные и разнообразные данные. Ознакомься с нашим руководством по сбору и аннотированию данных.
- Разметь объекты: точно аннотируй интересующие объекты на изображениях.
- Обучи модель: используй размеченные данные для обучения модели YOLOv5. Воспользуйся переносом обучения, начав с предварительно обученных весов.
- Развёртывание и предсказание: используй обученную модель для инференса на новых, ранее не встречавшихся данных.
- Собери сложные примеры: найди ситуации, в которых модель работает плохо (сложные случаи), и добавь в набор данных похожие примеры, чтобы повысить устойчивость модели. Повтори цикл.
Платформа Ultralytics предлагает решение без кода для всего цикла операций машинного обучения (MLOps), включая управление наборами данных, обучение и развёртывание моделей.
Ultralytics предлагает два варианта лицензирования для разных сценариев использования:
- Лицензия AGPL-3.0: эта лицензия с открытым исходным кодом, одобренная OSI, идеально подходит студентам, исследователям и энтузиастам, заинтересованным в открытом сотрудничестве и обмене знаниями. Она требует распространять производные работы на тех же условиях лицензии. Подробности см. в файле LICENSE.
- Корпоративная лицензия: эта лицензия предназначена для разработки и использования в production. Она позволяет интегрировать программное обеспечение и модели ИИ Ultralytics в коммерческие продукты и услуги, включая внутренние инструменты, автоматизированные рабочие процессы и развёртывания в production, без выполнения требований открытой лицензии AGPL-3.0. Чтобы начать работу, свяжись с нами через раздел Лицензирование Ultralytics.
Подробнее о вариантах лицензирования читай на странице лицензирования Ultralytics.
Перед началом обучения необходимо подготовить набор данных.
1. Создай набор данных#
Моделям YOLOv5 нужны размеченные данные, чтобы изучать визуальные характеристики классов объектов. Важно правильно организовать набор данных.
1.1 Создай dataset.yaml#
Файл конфигурации набора данных (например, coco128.yaml) описывает структуру набора данных, имена классов и пути к каталогам с изображениями. COCO128 — небольшой пример набора данных, состоящий из первых 128 изображений большого набора данных COCO. Он подходит для быстрой проверки процесса обучения и выявления возможных проблем, например переобучения.
Структура файла dataset.yaml включает:
path: корневой каталог с набором данных.train,val,test: относительные пути отpathк каталогам с изображениями или текстовыми файлами со списками путей к изображениям для обучающей, валидационной и тестовой выборок.names: словарь, связывающий индексы классов (начиная с 0) с соответствующими именами классов.
Для path можно задать абсолютный путь к каталогу (например, /home/user/datasets/coco128) или относительный путь, например ../datasets/coco128, если запускать обучение из корневого каталога репозитория YOLOv5.
Ниже показана структура coco128.yaml (посмотреть на GitHub:)
# Dataset root directory relative to the yolov5 directory
path: ../datasets/coco128

# Train/val/test sets: specify directories, *.txt files, or lists
train: images/train2017 # 128 images for training
val: images/train2017 # 128 images for validation
test: # Optional path to test images

# Classes (example using 80 COCO classes)
names:
    0: person
    1: bicycle
    2: car
    # ... (remaining COCO classes)
    77: teddy bear
    78: hair drier
    79: toothbrush
1.2 Использование моделей для автоматической разметки#
Обычно данные размечают вручную, но это занимает много времени. Базовые модели могут автоматизировать или частично автоматизировать аннотирование и ускорить создание набора данных. Вот несколько моделей, которые помогут с разметкой:
- Google Gemini: большие мультимодальные модели, такие как Gemini, эффективно распознают изображения. С помощью запросов их можно научить находить и определять местоположение объектов на изображениях и генерировать ограничивающие рамки или описания, которые можно преобразовать в метки формата YOLO, как показано в связанном блокноте с руководством. В рейтинге VLM Ultralytics сравнивается точность автоматической разметки реальных наборов данных для обнаружения объектов у Gemini и других визуально-языковых моделей.
- SAM2 (Segment Anything Model 2): базовые модели для сегментации, такие как SAM2, могут точно находить объекты и определять их границы. Хотя такие модели в первую очередь предназначены для сегментации, полученные маски часто можно преобразовать в аннотации ограничивающих рамок для задач обнаружения объектов.
- YOLO-World: эта модель поддерживает обнаружение объектов с открытым словарём классов. Укажи текстовое описание нужных объектов, и YOLO-World найдёт их на изображениях без предварительного обучения на этих классах. Это можно использовать как отправную точку для создания начальных меток, которые затем можно доработать.
Использование таких моделей в качестве этапа предварительной разметки сокращает объём ручной работы. Умная разметка на платформе Ultralytics позволяет выполнять предварительную разметку с помощью SAM, YOLO и визуально-языковых моделей прямо в браузере, без кода. Однако важно проверять и уточнять автоматически созданные метки, чтобы обеспечить их точность и единообразие: качество разметки напрямую влияет на производительность обученной модели YOLOv5. Создав (и, возможно, уточнив) метки, убедись, что они соответствуют формату YOLO: для каждого изображения — отдельный файл *.txt, в каждой строке которого объект представлен в формате class_index x_center y_center width height (нормализованные координаты, индекс класса начинается с нуля). Если на изображении нет интересующих объектов, соответствующий файл *.txt не нужен.
Требования к файлам *.txt в формате YOLO точны:
- Одна строка на каждую ограничивающую рамку.
- Каждая строка должна содержать:
class_index x_center y_center width height. - Координаты необходимо нормализовать до диапазона от 0 до 1. Для этого раздели значения пикселей
x_centerиwidthна полную ширину изображения, а значенияy_centerиheight— на полную высоту изображения. - Индексы классов начинаются с нуля (то есть первый класс обозначается как
0, второй — как1и так далее).
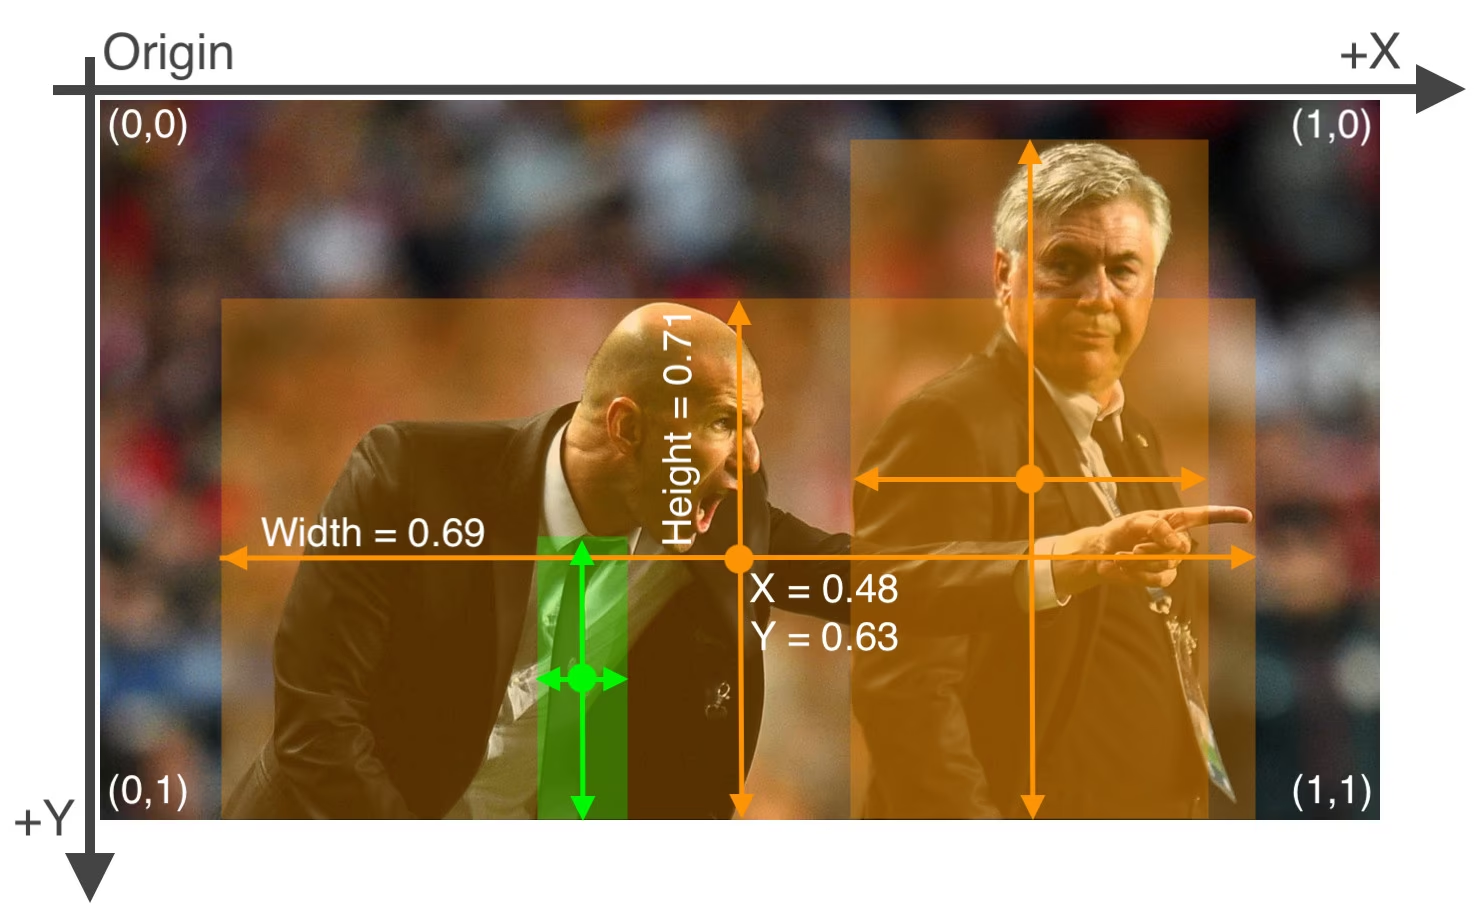
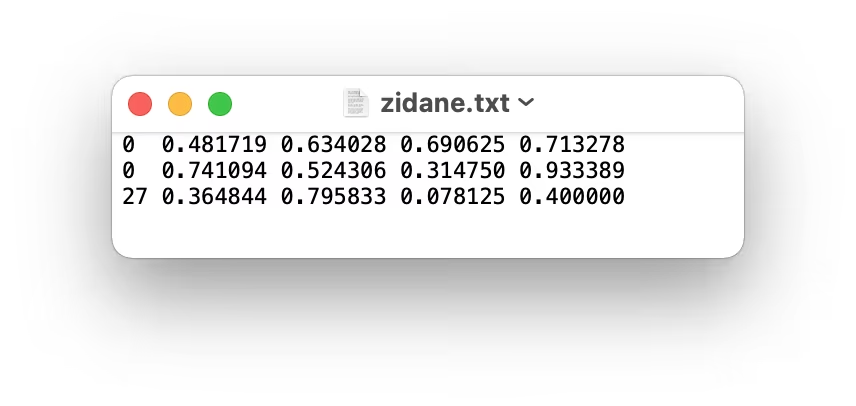
Файл меток для изображения выше с двумя объектами «person» (индекс класса 0) и одним объектом «tie» (индекс класса 27) будет выглядеть так:
1.3 Организация каталогов#
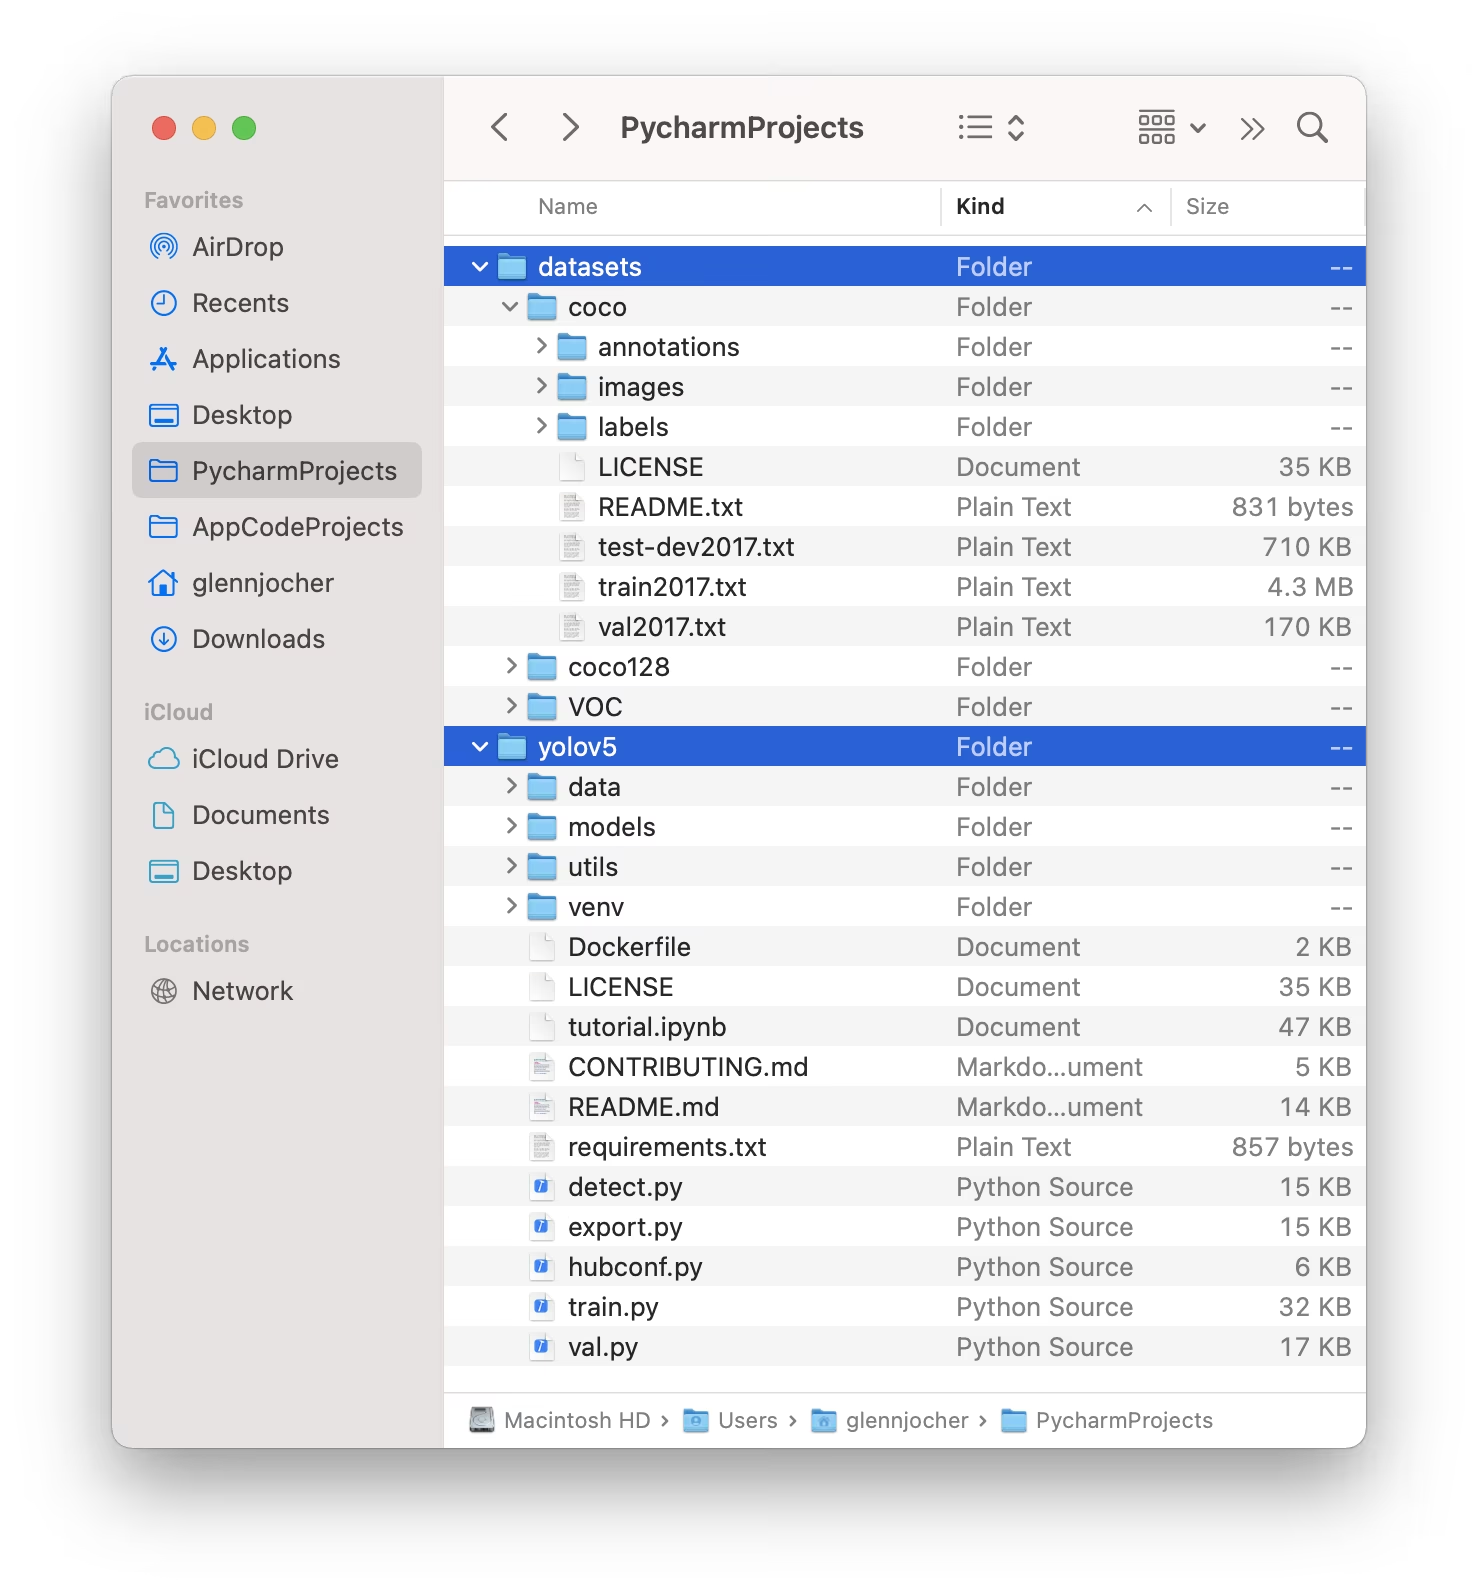
Организуй каталог наборов данных, как показано ниже. По умолчанию YOLOv5 ожидает, что каталог набора данных (например, /coco128) находится в папке /datasets, расположенной рядом с каталогом репозитория /yolov5.
YOLOv5 автоматически находит метки для каждого изображения, заменяя последнее вхождение /images/ в пути к изображению на /labels/. Например:
../datasets/coco128/images/im0.jpg # Path to the image file
../datasets/coco128/labels/im0.txt # Path to the corresponding label file
Рекомендуемая структура каталогов:
/datasets/
└── coco128/  # Dataset root
    ├── images/
    │   ├── train2017/  # Training images
    │   │   ├── 000000000009.jpg
    │   │   └── ...
    │   └── val2017/    # Validation images (optional if using same set for train/val)
    │       └── ...
    └── labels/
        ├── train2017/  # Training labels
        │   ├── 000000000009.txt
        │   └── ...
        └── val2017/    # Validation labels (optional if using same set for train/val)
            └── ...
2. Выбери модель#
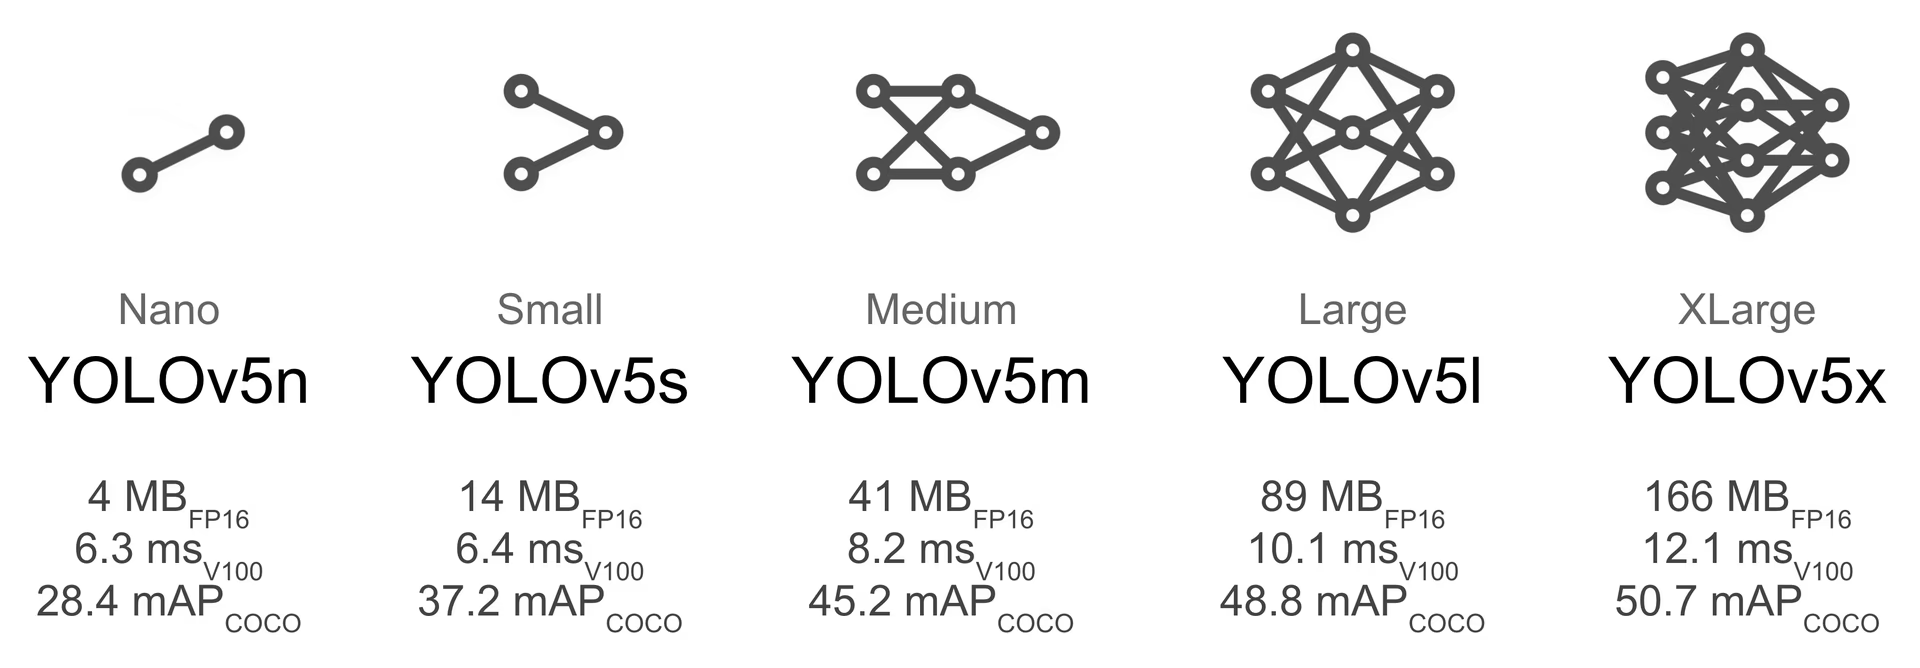
Выбери предварительно обученную модель, чтобы запустить процесс обучения. Использование предварительно обученных весов значительно ускоряет обучение и улучшает качество модели по сравнению с обучением с нуля. YOLOv5 предлагает модели разных размеров, в которых по-разному сочетаются скорость и точность. Например, YOLOv5s — вторая по компактности и вторая по скорости модель, подходящая для сред с ограниченными ресурсами.
3. Обучение#
Запусти обучение модели с помощью скрипта train.py. Основные аргументы:
--img: задает размер входного изображения (например,--img 640). Больший размер обычно повышает точность, но требует больше памяти GPU.--batch: задает размер пакета (например,--batch 16). Выбери наибольший размер, который поддерживает твой GPU.--epochs: задает общее количество эпох обучения (например,--epochs 100). Одна эпоха — это полный проход по всему обучающему набору данных.--data: путь к файлуdataset.yaml(например,--data coco128.yaml).--weights: путь к файлу начальных весов. Для более быстрой сходимости и лучших результатов рекомендуются предварительно обученные веса (например,--weights yolov5s.pt). Чтобы обучить модель с нуля (не рекомендуется, если только у тебя нет очень большого набора данных и особых требований), используй--weights '' --cfg yolov5s.yaml.
Если предварительно обученные веса не найдены локально, они автоматически загружаются из последнего релиза YOLOv5.
# Example: Train YOLOv5s on the COCO128 dataset for 3 epochs
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.ptИспользуй --cache ram или --cache disk, чтобы кэшировать изображения набора данных в RAM или на локальном диске соответственно. Это может значительно ускорить обучение, особенно если узким местом являются операции ввода-вывода (I/O) с набором данных. Учти, что для этого потребуется большой объём RAM или места на диске.
Всегда обучай модели на локально сохранённых наборах данных. Доступ к данным на сетевых дисках (например, Google Drive) или удалённых хранилищах может быть значительно медленнее и снижать производительность обучения. Обычно лучше всего скопировать набор данных на локальный SSD.
Все результаты обучения, включая веса и журналы, сохраняются в каталоге runs/train/. Для каждого сеанса обучения создается новый подкаталог (например, runs/train/exp, runs/train/exp2 и т. д.). Чтобы получить практический опыт, изучи раздел об обучении в наших официальных учебных блокнотах: 

4. Визуализация#
YOLOv5 интегрируется с различными инструментами для визуализации хода обучения, оценки результатов и мониторинга производительности в реальном времени.
Логирование и визуализация в Comet#
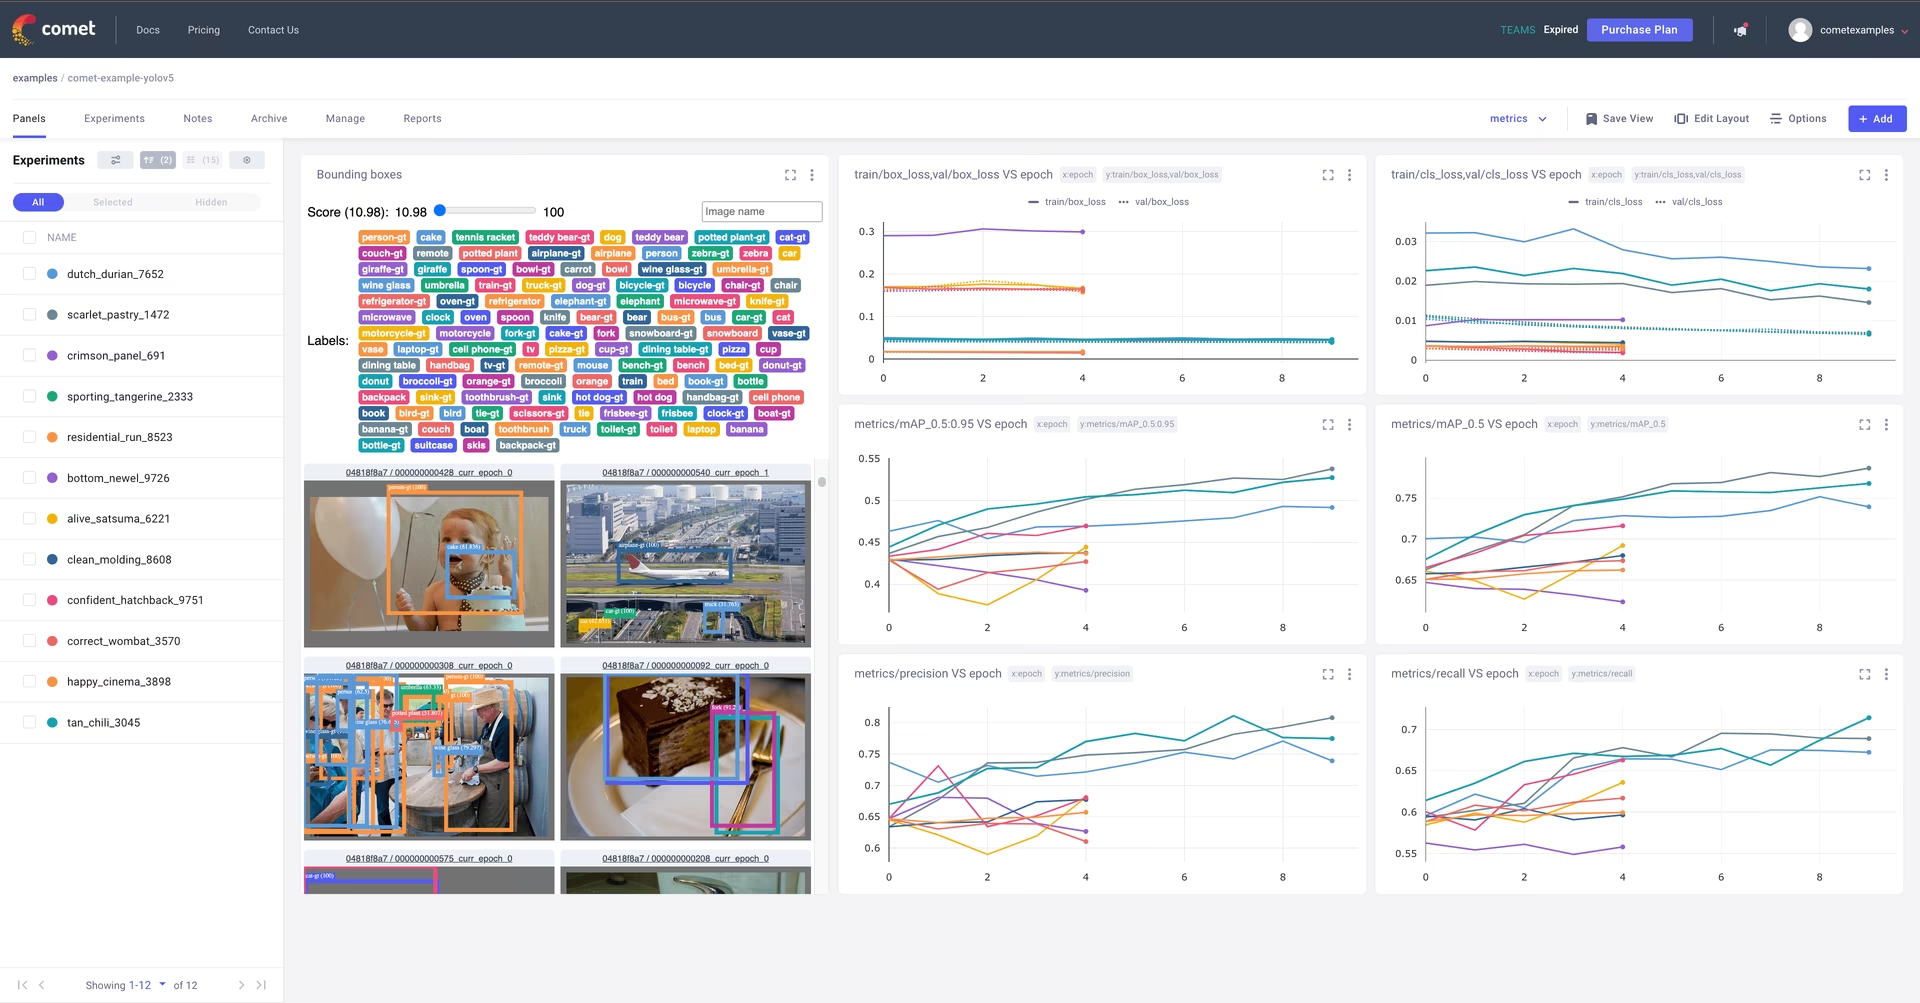
Comet интегрирована для полноценного отслеживания экспериментов. Визуализируй метрики в реальном времени, сохраняй гиперпараметры, управляй наборами данных и контрольными точками моделей, а также анализируй предсказания с помощью интерактивных пользовательских панелей Comet.
Начать работу просто:
pip install comet_ml                                                          # 1. Install Comet library
export COMET_API_KEY=YOUR_API_KEY_HERE                                        # 2. Set your Comet API key (create a free account at Comet.ml)
python train.py --img 640 --epochs 3 --data coco128.yaml --weights yolov5s.pt # 3. Train your model - Comet automatically logs everything!
Попробуй интерактивную демонстрацию в блокноте Comet Colab:
Логирование и автоматизация в ClearML#
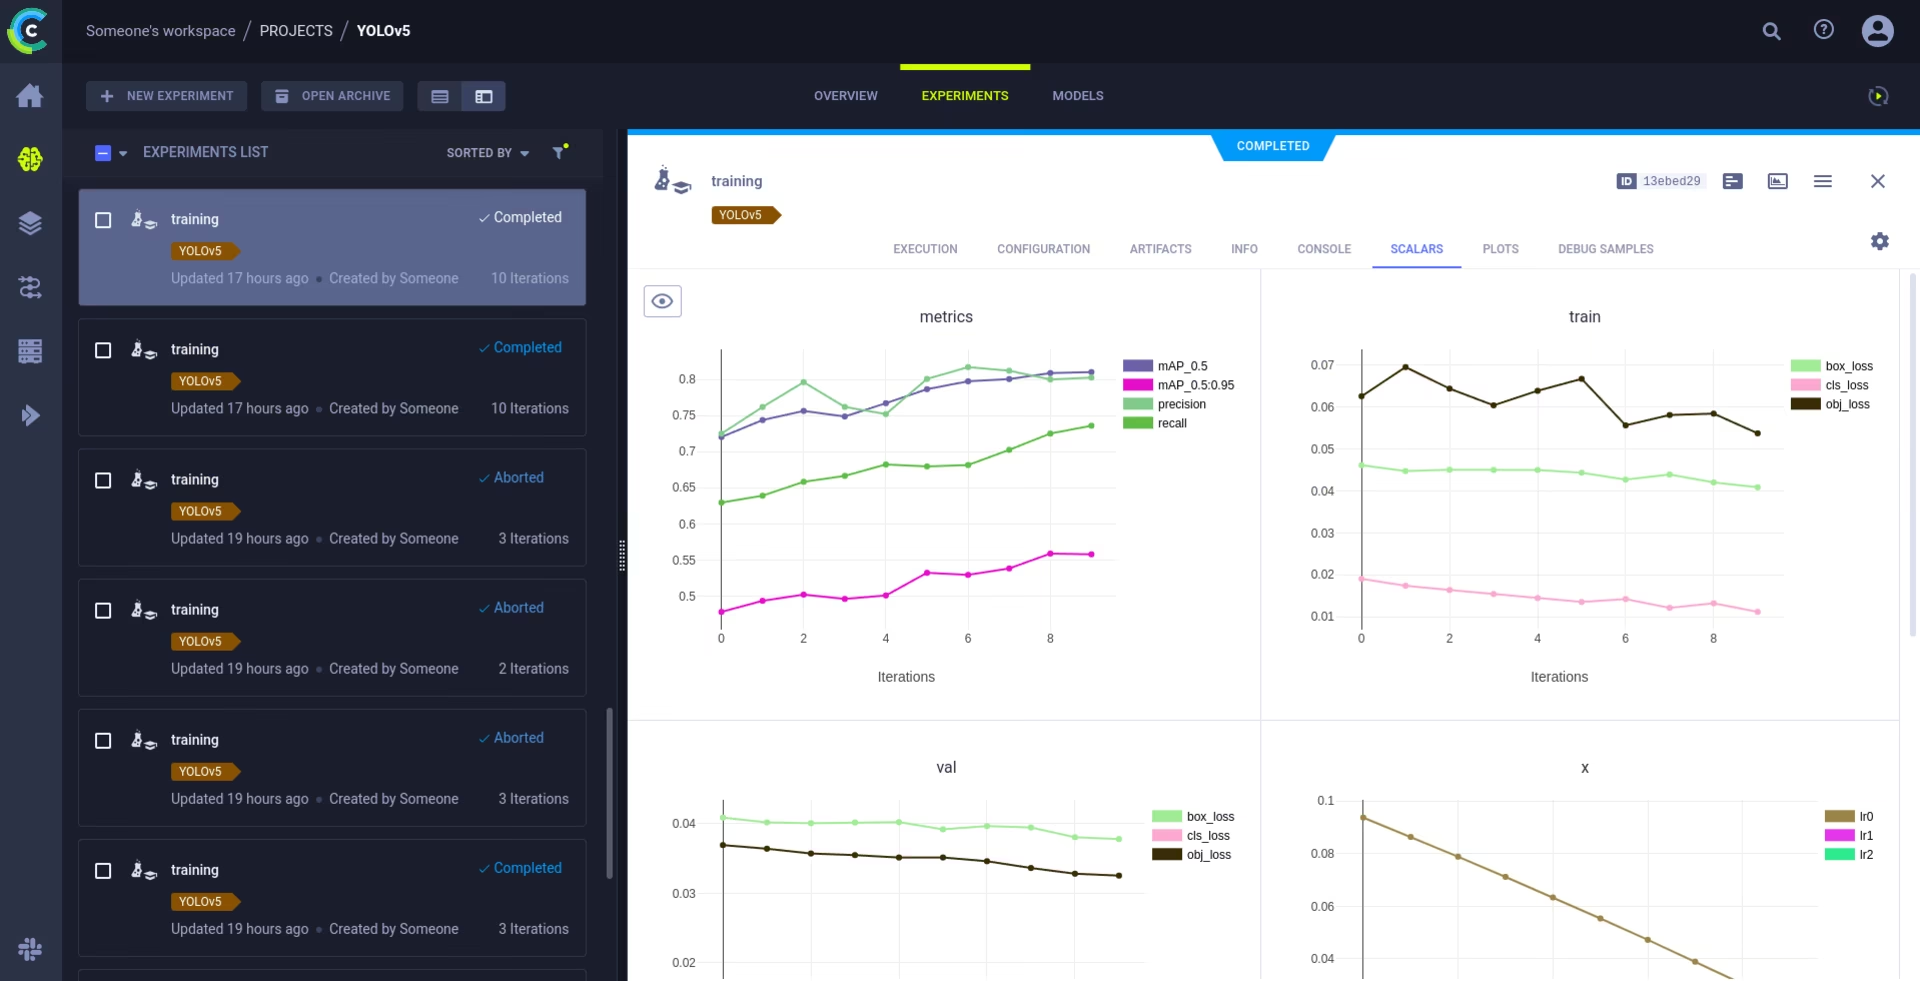
Интеграция с ClearML обеспечивает подробное отслеживание экспериментов, управление версиями наборов данных и даже удалённый запуск обучения. Чтобы активировать ClearML, выполни следующие действия:
- Установи пакет:
pip install clearml - Инициализируй ClearML: один раз запусти
clearml-init, чтобы подключиться к своему серверу ClearML (собственному или бесплатному тарифу).
ClearML автоматически сохраняет сведения об эксперименте, загруженные модели, сравнения, незакоммиченные изменения кода и установленные пакеты, обеспечивая полную воспроизводимость. Ты можешь планировать задачи обучения на удалённых агентах и управлять версиями наборов данных с помощью ClearML Data.
Локальное логирование#
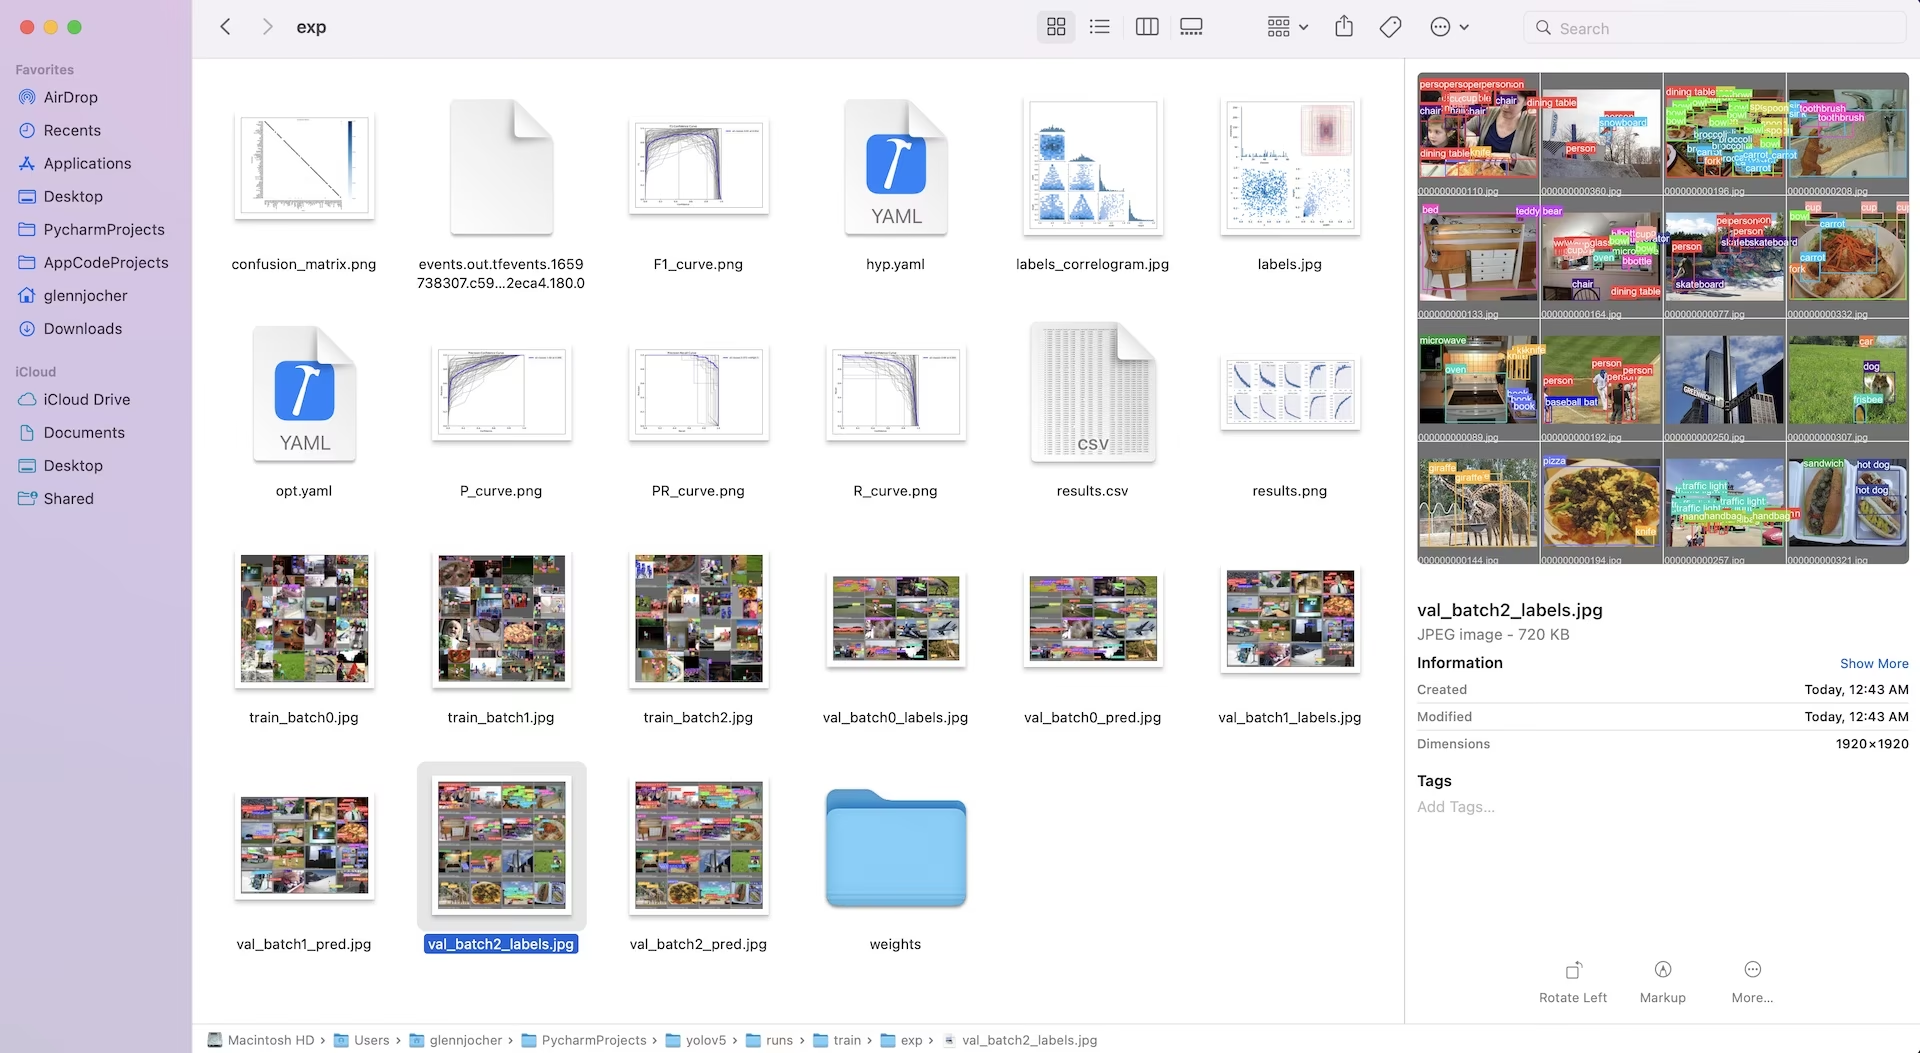
Результаты обучения автоматически записываются с помощью TensorBoard и сохраняются в файлах CSV в каталоге соответствующего эксперимента (например, runs/train/exp). В журнал записываются:
- Потери и метрики производительности на обучающей и валидационной выборках.
- Примеры изображений с примененными аугментациями (например, мозаичными).
- Эталонные метки и предсказания модели для визуальной проверки.
- Основные метрики оценки, например кривые точности-полноты (PR).
- Матрицы ошибок для подробного анализа результатов по классам.
Файл results.csv обновляется после каждой эпохи, а по завершении обучения по нему строится график results.png. Кроме того, можно вручную построить график по любому файлу results.csv с помощью предоставленной служебной функции:
from utils.plots import plot_results

# Построить график результатов из каталога конкретного запуска обучения
plot_results("runs/train/exp/results.csv")  # В этом же каталоге будет создан файл 'results.png'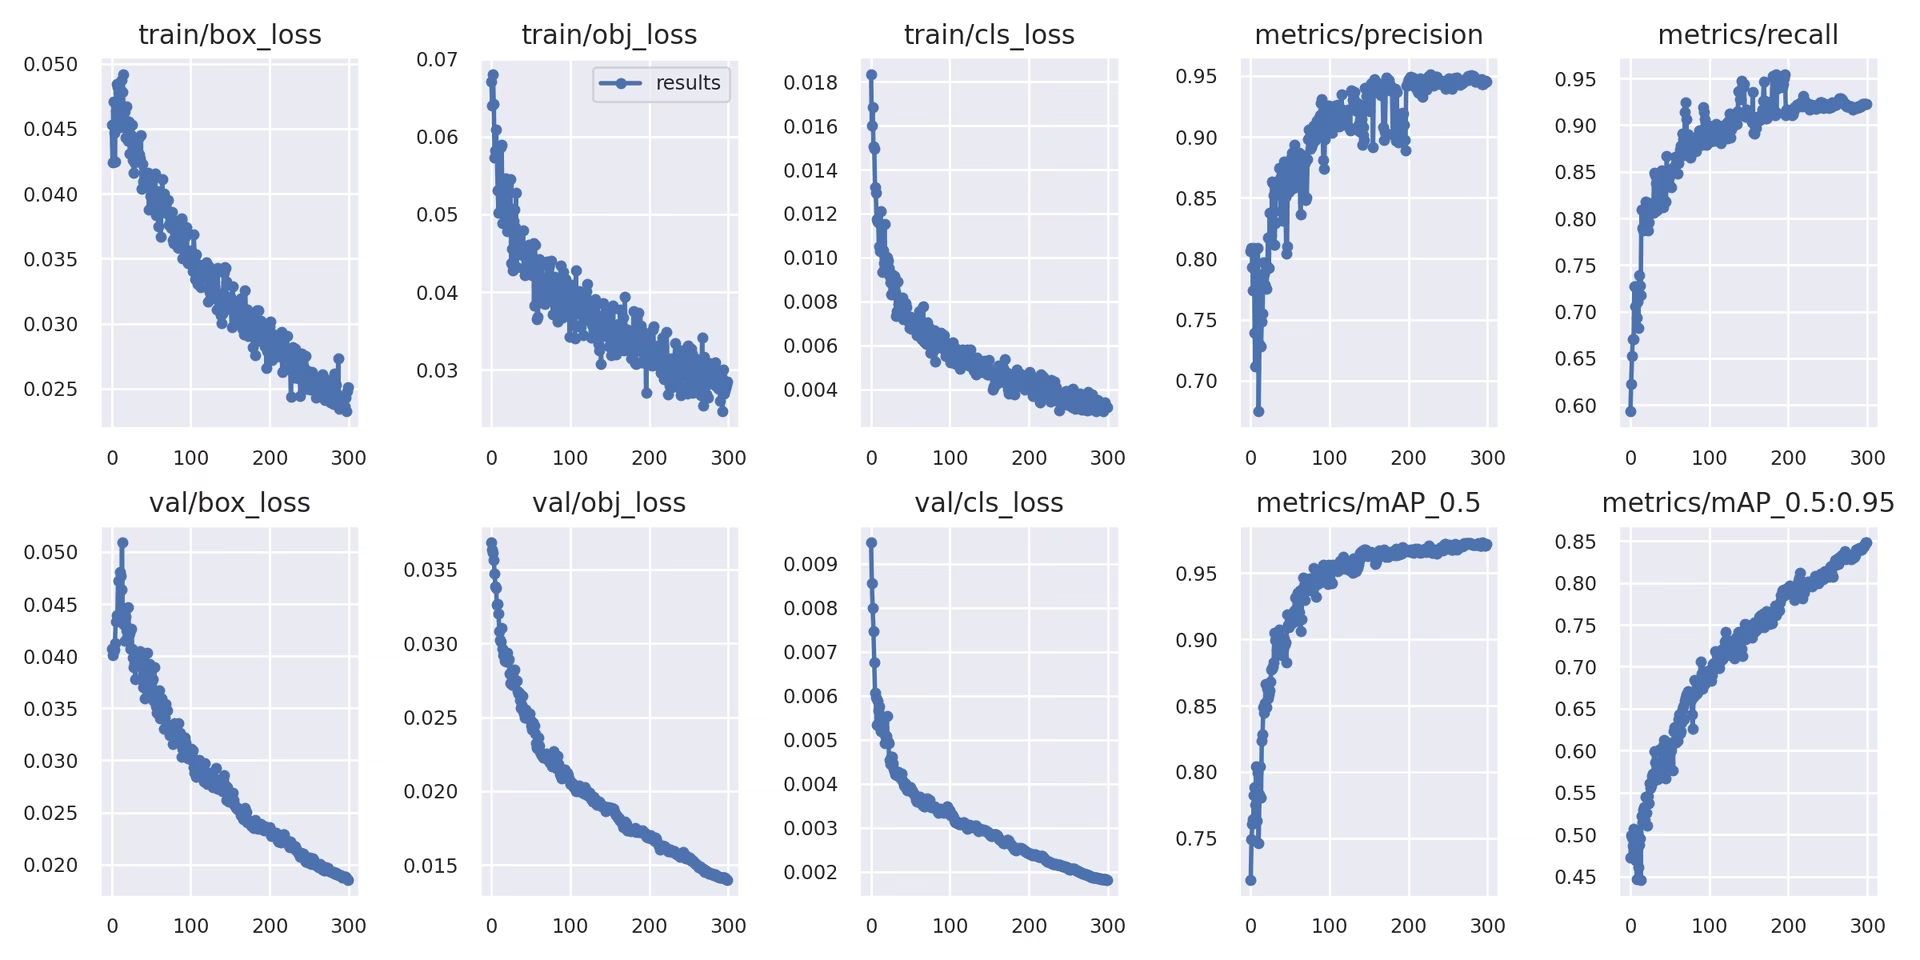
5. Дальнейшие шаги#
После успешного завершения обучения сохраняется контрольная точка лучшей модели (best.pt), готовая к развертыванию или дальнейшей доработке. Возможные следующие шаги:
- Запусти инференс на новых изображениях или видео с помощью обученной модели через CLI или Python.
- Запусти
val.py, чтобы оценить точность модели и ее способность к обобщению на разных выборках данных (например, на отложенной тестовой выборке). - Экспортируй модель в различные форматы развертывания, например ONNX, TensorFlow SavedModel или TensorRT, чтобы оптимизировать инференс на разных платформах.
- Используй эволюционный подбор гиперпараметров, чтобы добиться дополнительного прироста производительности.
- Продолжай улучшать модель, следуя нашим советам для достижения лучших результатов обучения и постепенно добавляя более разнообразные и сложные данные на основе анализа производительности.
Поддерживаемые среды#
Ultralytics предоставляет готовые среды с необходимыми зависимостями, такими как CUDA, cuDNN, Python и PyTorch, чтобы ты мог быстро начать работу.
- Бесплатные блокноты с GPU:
- Облачные платформы:
- Google Cloud: краткое руководство по GCP
- Amazon AWS: краткое руководство по AWS
- Microsoft Azure: краткое руководство по AzureML
- Локальная настройка:
- Docker: краткое руководство по Docker
- Docker: краткое руководство по Docker


Статус проекта#

Этот значок означает, что все тесты GitHub Actions непрерывной интеграции (CI) YOLOv5 успешно пройдены. Эти тесты CI проверяют основные функции, включая обучение, валидацию, инференс, экспорт и бенчмарки в macOS, Windows и Ubuntu. Тесты автоматически запускаются каждые 24 часа и при каждом коммите кода.
Часто задаваемые вопросы#
Обучение YOLOv5 на собственном датасете включает несколько основных этапов:
- Подготовь набор данных: собери изображения и добавь к ним аннотации. Убедись, что аннотации соответствуют требуемому формату YOLO. Размести изображения и метки в каталогах
train/иval/(и, при необходимости,test/). Для помощи или автоматизации разметки рассмотри такие модели, как Google Gemini, SAM2 или YOLO-World (см. раздел 1.2). - Настрой окружение: клонируй репозиторий YOLOv5 и установи зависимости с помощью
pip install -r requirements.txt.git clone https://github.com/ultralytics/yolov5 cd yolov5 pip install -r requirements.txt - Создай конфигурацию датасета: укажи пути к датасету, количество классов и их названия в файле
dataset.yaml. - Начни обучение: запусти скрипт
train.py, указав пути кdataset.yaml, нужные предварительно обученные веса (например,yolov5s.pt), размер изображения, размер пакета и количество эпох.python train.py --img 640 --batch 16 --epochs 100 --data path/to/your/dataset.yaml --weights yolov5s.pt
- Подготовь набор данных: собери изображения и добавь к ним аннотации. Убедись, что аннотации соответствуют требуемому формату YOLO. Размести изображения и метки в каталогах
Платформа Ultralytics охватывает весь жизненный цикл разработки моделей YOLO, зачастую без необходимости писать код. Ключевые преимущества:
- Упрощённое обучение: обучай модели в предварительно настроенных облачных средах через веб-интерфейс.
- Встроенное управление данными: загружай наборы данных, управляй их версиями и работай с ними прямо на платформе.
- Мониторинг в реальном времени: отслеживай ход обучения и визуализируй метрики производительности по мере их поступления.
- Инструменты для совместной работы: работай в команде с помощью общих ресурсов, инструментов управления проектами и удобного обмена моделями.
- Развертывание без кода: развертывай обученные модели непосредственно на различных целевых платформах.
Практическое пошаговое руководство смотри в нашей статье в блоге: Как обучать собственные модели с помощью Ultralytics Platform.
Размечаешь ли ты данные вручную или используешь автоматизированные инструменты (например, упомянутые в разделе 1.2), итоговые метки должны соответствовать специальному формату YOLO, который требуется YOLOv5:
- Создай файл
.txtдля каждого изображения. Имя файла должно совпадать с именем изображения (например,image1.jpgсоответствуетimage1.txt). Помести эти файлы в каталогlabels/, расположенный рядом с каталогомimages/(например,../datasets/mydataset/labels/train/). - Каждая строка в файле
.txtописывает один размеченный объект и должна соответствовать формату:class_index center_x center_y width height. - Координаты (
center_x,center_y,width,height) должны быть нормализованы (значения от 0.0 до 1.0) относительно размеров изображения. - Индексы классов начинаются с нуля (первый класс —
0, второй —1и т. д.).
Многие инструменты ручной разметки позволяют экспортировать данные непосредственно в формат YOLO. При использовании автоматизированных моделей тебе понадобятся скрипты или процессы для преобразования их выходных данных (например, координат ограничивающих рамок или масок сегментации) в этот специальный нормализованный текстовый формат. Убедись, что итоговая структура датасета соответствует примеру из руководства. Подробнее см. в нашем руководстве по сбору и разметке данных.
- Создай файл
Ultralytics предлагает гибкие условия лицензирования для разных задач:
- Лицензия AGPL-3.0: эта лицензия с открытым исходным кодом подходит для академических исследований, личных проектов и случаев, когда соблюдение требований открытого ПО приемлемо. Она требует, чтобы модификации и производные работы также распространялись с открытым исходным кодом по лицензии AGPL-3.0. Ознакомься с подробностями лицензии AGPL-3.0.
- Корпоративная лицензия: коммерческая лицензия для компаний, которые интегрируют YOLOv5 в собственные продукты или сервисы. Эта лицензия отменяет обязательства по открытию исходного кода, предусмотренные AGPL-3.0, и позволяет распространять ПО с закрытым исходным кодом. Подробности и возможность запросить корпоративную лицензию смотри на нашей странице лицензирования.
Выбери лицензию, которая лучше всего соответствует требованиям твоего проекта и модели распространения.
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.