Датасет COCO#
Датасет COCO (COCO) — это крупномасштабный датасет для обнаружения и сегментации объектов, а также создания описаний изображений. Он предназначен для стимулирования исследований широкого спектра категорий объектов и широко используется для тестирования моделей компьютерного зрения. Это важный датасет для исследователей и разработчиков, работающих над задачами обнаружения и сегментации объектов, а также оценки позы.
Watch: Ultralytics COCO Dataset Overview
Предобученные модели COCO#
| Модель | размер (пиксели) | mAPval 50-95 | mAPval 50-95(e2e) | Скорость CPU ONNX (мс) | Скорость T4 TensorRT10 (мс) | параметры (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|
| YOLO26n | 640 | 40.9 | 40.1 | 38.9 ± 0.7 | 1.7 ± 0.0 | 2.4 | 5.5 |
| YOLO26s | 640 | 48.6 | 47.8 | 87.2 ± 0.9 | 2.5 ± 0.0 | 9.5 | 20.9 |
| YOLO26m | 640 | 53.1 | 52.5 | 220.0 ± 1.4 | 4.7 ± 0.1 | 20.4 | 68.4 |
| YOLO26l | 640 | 55.0 | 54.4 | 286.2 ± 2.0 | 6.2 ± 0.2 | 24.8 | 86.8 |
| YOLO26x | 640 | 57.5 | 56.9 | 525.8 ± 4.0 | 11.8 ± 0.2 | 55.7 | 194.4 |
Ключевые особенности#
- COCO содержит 330 тыс. изображений, из которых 200 тыс. имеют аннотации для задач обнаружения и сегментации объектов, а также создания описаний.
- Датасет включает 80 категорий объектов: от распространённых объектов, таких как автомобили, велосипеды и животные, до более специфичных категорий, таких как зонты, сумки и спортивный инвентарь.
- Аннотации включают ограничивающие рамки объектов, маски сегментации и описания для каждого изображения.
- COCO предоставляет стандартизированные метрики оценки, такие как средняя точность (mAP) для обнаружения объектов и средняя полнота (mAR) для задач сегментации, что делает его подходящим для сравнения производительности моделей.
Структура датасета#
Датасет COCO разделён на три подмножества:
- Train2017: 118 287 изображений для обучения моделей обнаружения и сегментации объектов, а также создания описаний.
- Val2017: 5 000 изображений, используемых для валидации во время обучения модели.
- Test2017: 20 288 изображений test-dev, используемых для тестирования обученных моделей. Эталонные аннотации для этого подмножества недоступны публично, а результаты отправляются на сервер оценки COCO для оценки производительности.
Применения#
Датасет COCO широко используется для обучения и оценки моделей глубокого обучения в задачах обнаружения объектов (например, Ultralytics YOLO, Faster R-CNN и SSD), сегментации экземпляров (например, Mask R-CNN) и обнаружения ключевых точек (например, OpenPose). Разнообразие категорий объектов, большое количество размеченных изображений и стандартизированные метрики оценки делают этот датасет важным ресурсом для исследователей и практиков в области компьютерного зрения.
Аннотации, экспортированные из инструментов разметки в формате COCO JSON, имеют такую же структуру. Чтобы обучаться на собственных данных в формате COCO, см. Преобразование аннотаций COCO в YOLO.
YAML датасета#
Для определения конфигурации датасета используется YAML-файл. Он содержит сведения о путях к данным, классах и другую необходимую информацию. Для датасета COCO файл coco.yaml поддерживается по адресу https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO 2017 dataset https://cocodataset.org by Microsoft
# Documentation: https://docs.ultralytics.com/datasets/detect/coco
# Example usage: yolo train data=coco.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco ← downloads here (20.3 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco # dataset root dir
train: train2017.txt # train images (relative to 'path') 118287 images
val: val2017.txt # val images (relative to 'path') 5000 images
test: test-dev2017.txt # 20288 of 40670 images, submit via https://cocodataset.org/#detection-eval

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: |
  from pathlib import Path

  from ultralytics.utils import ASSETS_URL
  from ultralytics.utils.downloads import download

  # Download labels
  segments = True  # segment or box labels
  dir = Path(yaml["path"])  # dataset root dir
  urls = [ASSETS_URL + ("/coco2017labels-segments.zip" if segments else "/coco2017labels.zip")]  # labels
  download(urls, dir=dir.parent)

  # Download data (test2017.zip excluded: ground truth is withheld, only used for the eval-server test-dev split)
  urls = [
      "http://images.cocodataset.org/zips/train2017.zip",  # 19G, 118k images
      "http://images.cocodataset.org/zips/val2017.zip",  # 1G, 5k images
  ]
download(urls, dir=dir / "images", threads=3)Использование#
Данные COCO2017 для обучения и валидации (20,3 ГБ) автоматически загружаются при первом запуске обучения. Чтобы обучить модель YOLO26n на COCO в течение 100 эпох с размером изображения 640, можно использовать следующие фрагменты кода. Полный список доступных аргументов приведён на странице обучения модели. Также можно запустить обучение на COCO в облаке с помощью Ultralytics Platform.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="coco.yaml", epochs=100, imgsz=640)
Примеры изображений и аннотаций#
Датасет COCO содержит разнообразные изображения с различными категориями объектов и сложными сценами. Ниже приведены примеры изображений из датасета вместе с соответствующими аннотациями:
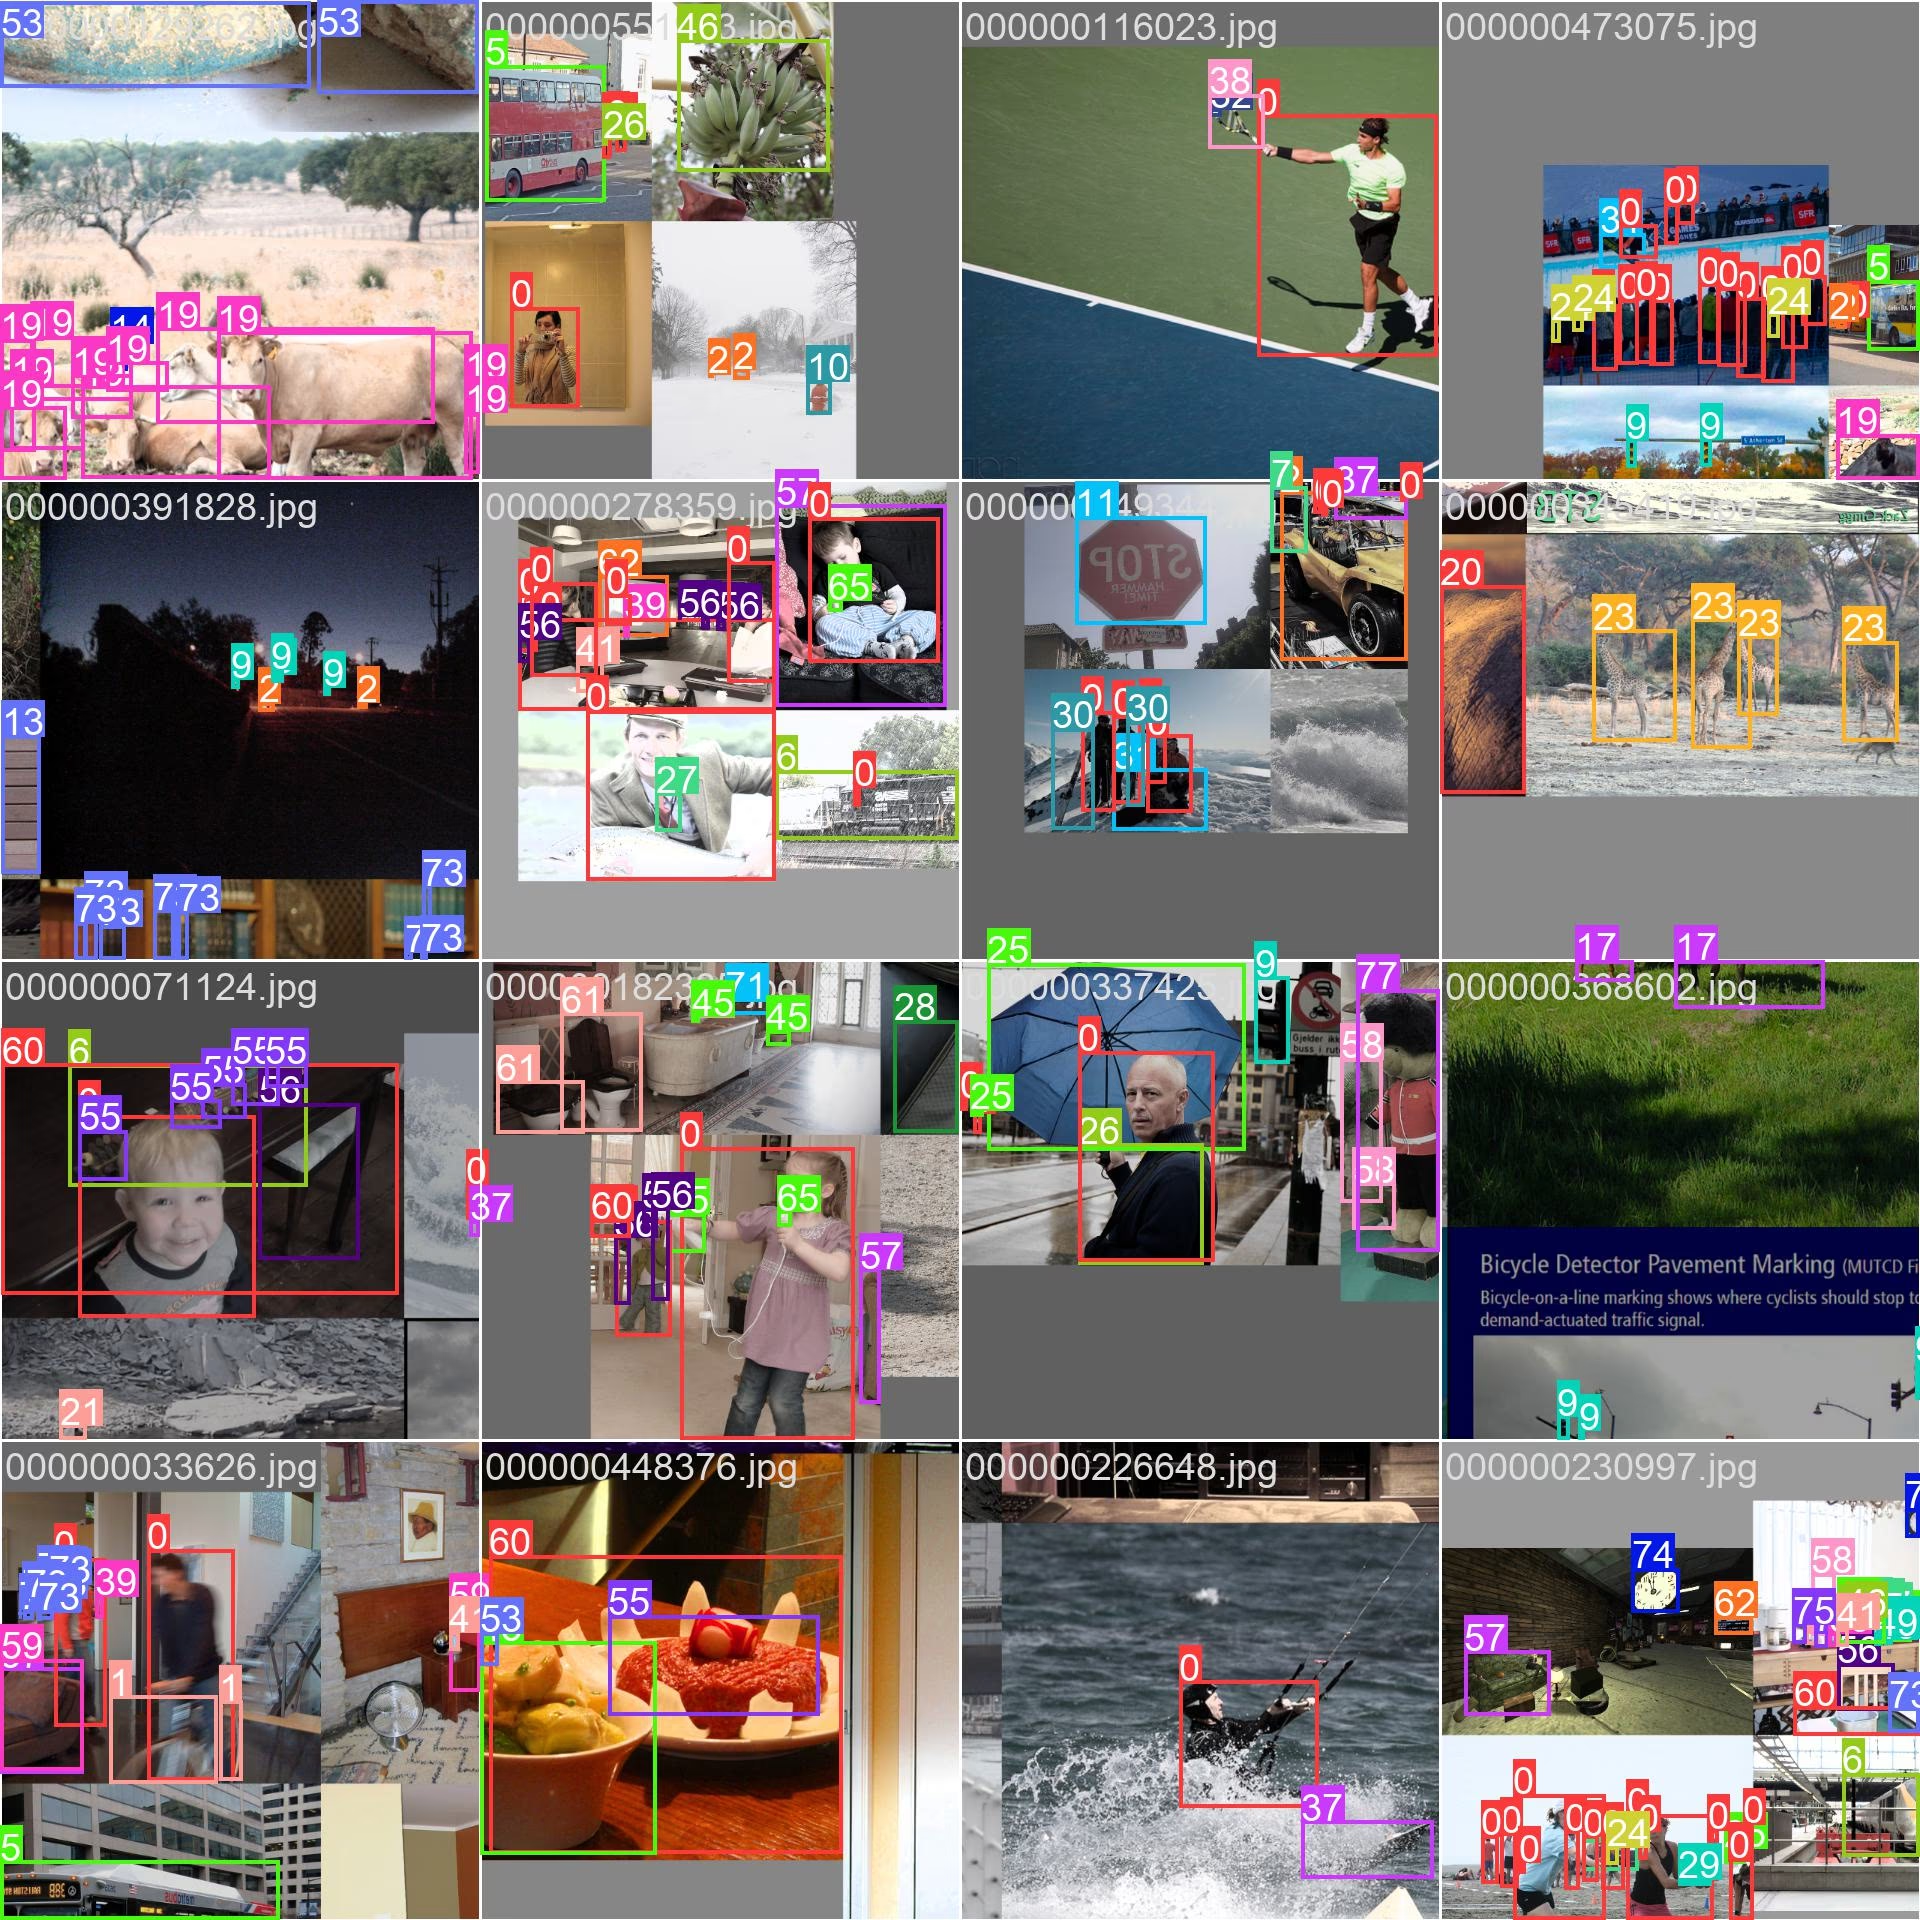
- Мозаичное изображение: на этом изображении показан обучающий батч, составленный из мозаичных изображений датасета. Мозаицирование — это применяемая во время обучения техника, которая объединяет несколько изображений в одно, чтобы увеличить разнообразие объектов и сцен в каждом обучающем батче. Это помогает улучшить способность модели обобщать данные для объектов разных размеров, с разными соотношениями сторон и в разных контекстах.
Этот пример демонстрирует разнообразие и сложность изображений в датасете COCO, а также преимущества использования мозаицирования во время обучения.
Цитирование и благодарности#
Если ты используешь датасет COCO в исследовательской или разработческой работе, пожалуйста, процитируй следующую статью:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Мы хотели бы поблагодарить COCO Consortium за создание и поддержку этого ценного ресурса для сообщества компьютерного зрения. Дополнительную информацию о датасете COCO и его создателях можно найти на сайте датасета COCO.
Часто задаваемые вопросы#
Датасет COCO (COCO) — это крупномасштабный датасет, используемый для обнаружения объектов, сегментации и создания описаний изображений. Он содержит 330 тыс. изображений с подробными аннотациями для 80 категорий объектов, что делает его важным инструментом для тестирования и обучения моделей компьютерного зрения. Исследователи используют COCO благодаря разнообразию категорий и стандартизированным метрикам оценки, таким как средняя точность (mAP).
Чтобы обучить модель YOLO26 с использованием датасета COCO, можно воспользоваться следующими фрагментами кода:
Пример обученияfrom ultralytics import YOLO # Load a model model = YOLO("yolo26n.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="coco.yaml", epochs=100, imgsz=640)Подробнее о доступных аргументах см. на странице обучения.
Датасет COCO включает:
- 330 тыс. изображений, из которых 200 тыс. имеют аннотации для обнаружения и сегментации объектов, а также создания описаний.
- 80 категорий объектов: от распространённых предметов, таких как автомобили и животные, до специфичных объектов, таких как сумки и спортивный инвентарь.
- Стандартизированные метрики оценки для обнаружения объектов (mAP) и сегментации (средняя полнота, mAR).
- Технику мозаицирования в обучающих батчах для улучшения обобщающей способности модели при работе с объектами разных размеров и в различных контекстах.
Предобученные модели YOLO26, обученные на датасете COCO, можно скачать по ссылкам, приведённым в документации. Например:
Эти модели различаются размером, показателем mAP и скоростью вывода, поэтому можно выбрать вариант с учётом требований к производительности и ресурсам.
Датасет COCO разделён на три подмножества:
- Train2017: 118 287 изображений для обучения.
- Val2017: 5 000 изображений для валидации во время обучения.
- Test2017: 20 288 изображений test-dev для тестирования обученных моделей. Результаты необходимо отправить на сервер оценки COCO для оценки производительности.
YAML-файл конфигурации датасета доступен по адресу coco.yaml; в нём определены пути, классы и сведения о датасете.