YOLO Modelleriyle İş Parçacığı Güvenli Çıkarım
Ultralytics YOLO çıkarımını Python iş parçacıklarında güvenli biçimde çalıştırmak için tek bir örneği iş parçacıkları arasında paylaşmak yerine her iş parçacığının içinde ayrı bir YOLO model örneği oluştur. Tek bir modelin paylaşılması, iç durumunu bozarak öngörülemeyen sonuçlar doğuran yarış koşullarına neden olur; çünkü Python'un threading modülü iş parçacıklarını aynı nesne üzerinde eş zamanlı çalıştırır. Bu kılavuz, paylaşımın neden başarısız olduğunu açıklar, iş parçacığı başına güvenli kullanım biçimini gösterir ve bir örneği paylaşman gereken durumlarda ThreadingLocked dekoratörünü ele alır.
Model paylaşımının neden başarısız olduğuna, iş parçacığı güvenli kullanım biçimine veya ThreadingLocked dekoratörüne geç.
İzle: Python'da Ultralytics YOLO modelleriyle iş parçacığı güvenli çıkarım nasıl yapılır | Çoklu iş parçacığı 🚀
Python'da İş Parçacıklarını Anlamak#
Python iş parçacıkları programının birden fazla işlemi eşzamanlı yürütmesini sağlar. Ancak Python'ın Global Interpreter Lock (GIL) özelliği, aynı anda yalnızca bir iş parçacığının Python bayt kodunu çalıştırabilmesi anlamına gelir.
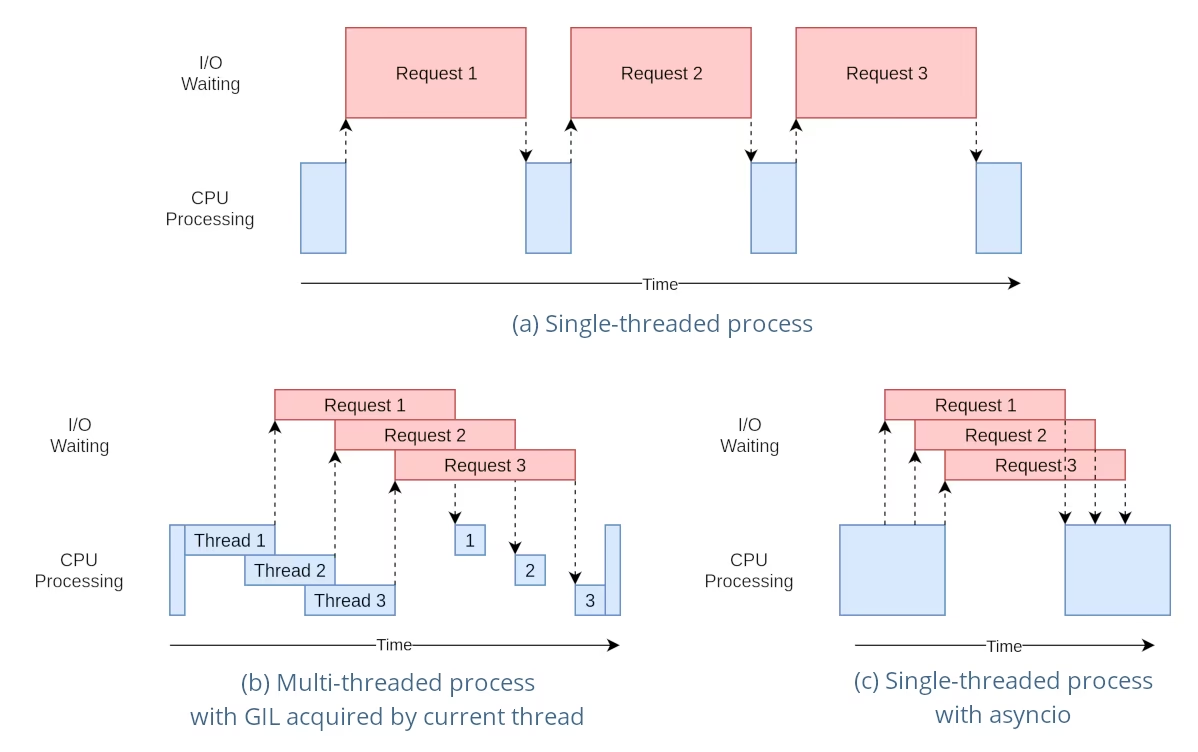
Bu bir kısıtlama gibi görünse de iş parçacıkları, özellikle G/Ç ağırlıklı işlemlerde veya YOLO'nun temelindeki C kütüphanelerinin gerçekleştirdikleri gibi GIL'i serbest bırakan işlemler kullanıldığında eş zamanlılık sağlayabilir.
Paylaşılan Model Örneklerinin Tehlikesi#
Bir YOLO modelini iş parçacıklarının dışında oluşturup bu örneği birden fazla iş parçacığı arasında paylaşmak, eş zamanlı erişimler nedeniyle modelin iç durumunun tutarsız biçimde değiştirilmesine yol açan yarış koşullarına neden olabilir. Bu durum, modelin veya bileşenlerinin iş parçacığı güvenli olacak şekilde tasarlanmamış bir durumu koruduğu zaman özellikle sorun yaratır.
İş Parçacığı Güvenli Olmayan Örnek: Tek Model Örneği#
Python'da iş parçacıkları kullanırken eş zamanlılık sorunlarına yol açabilecek kalıpları fark etmek önemlidir. İşte kaçınman gereken durum: tek bir YOLO26 model örneğini birden fazla iş parçacığında paylaşmak.
# Güvenli değil: Tek bir model örneğini iş parçacıkları arasında paylaşma
from threading import Thread

from ultralytics import YOLO

# Modeli iş parçacığının dışında oluştur
shared_model = YOLO("yolo26n.pt")

def predict(image_path):
    """Predicts objects in an image using a preloaded YOLO model, take path string to image as argument."""
    results = shared_model.predict(image_path)
    # Sonuçları işle

# Aynı model örneğini paylaşan iş parçacıklarını başlat
Thread(target=predict, args=("image1.jpg",)).start()
Thread(target=predict, args=("image2.jpg",)).start()
Yukarıdaki örnekte her iki iş parçacığı da shared_model öğesini paylaşır. Her predict çağrısı, conf, iou ve imgsz gibi kendi bağımsız argümanlarını kullanır; ancak aynı tahminleyiciyi kullanan çağrılar, tahminleyicinin kilidi arkasında sırayla çalışır, bu nedenle iş parçacıkları fazla paralellik sağlayamaz. İzleyici durumu, YOLOE set_classes söz varlıkları veya SAM, FastSAM ve YOLOE istemleri gibi örneğe bağlı durumlar yine tüm iş parçacıkları tarafından paylaşılır; bu nedenle bu durumlar için her iş parçacığına ayrı bir örnek ver.
Güvenli Örnek: Her İş Parçacığına Özel Bir Örnek#
Her iş parçacığı kendi örneğine sahip olduğu ve bu örneği başka bir iş parçacığıyla paylaşmadığı sürece birden fazla ayrı model örneği kullanmak sorun oluşturmaz. Aşağıdaki örneklerin iş parçacıkları başlamadan önce oluşturulmuş olması önemli değildir; güvenli olmayan tek kalıp, bir örneğin iş parçacıkları arasında paylaşılmasıdır:
# Güvenli: her iş parçacığı kendine özel model örneğini kullanır
from threading import Thread

from ultralytics import YOLO

# Her iş parçacığı için bir model örneği oluştur
model_1 = YOLO("yolo26n.pt")
model_2 = YOLO("yolo26n.pt")

def predict(model, image_path):
    """Runs prediction on an image using a specified YOLO model, returning the results."""
    results = model.predict(image_path)
    # Sonuçları işle

# Her iş parçacığı ayrı ve kendine özel bir model örneği kullanır
Thread(target=predict, args=(model_1, "image1.jpg")).start()
Thread(target=predict, args=(model_2, "image2.jpg")).start()
Her iş parçacığı kendine özel bir örnekle çalıştığından, iş parçacıklarının bozabileceği paylaşılan bir model durumu yoktur. Sonraki bölümde gösterildiği gibi modeli her iş parçacığının içinde oluşturmak, bir örneğin yanlışlıkla paylaşılmasını önlemenin en kolay yoludur.
İş Parçacığı Güvenli Çıkarım#
İş parçacığı güvenli çıkarım yapmak için her iş parçacığının içinde ayrı bir YOLO modeli oluşturmalısın. Böylece her iş parçacığının kendine ait, yalıtılmış bir model örneği olur ve yarış koşulları riski ortadan kalkar.
İş Parçacığı Güvenli Örnek#
İş parçacığı güvenli paralel çıkarım için her iş parçacığının içinde bir YOLO modelini şu şekilde oluşturabilirsin:
# Güvenli: Her iş parçacığının içinde tek bir model örneği oluşturma
from threading import Thread

from ultralytics import YOLO

def thread_safe_predict(image_path):
    """Predict on an image using a new YOLO model instance in a thread-safe manner; takes image path as input."""
    local_model = YOLO("yolo26n.pt")
    results = local_model.predict(image_path)
    # Sonuçları işle

# Her biri kendi model örneğine sahip iş parçacıklarını başlat
Thread(target=thread_safe_predict, args=("image1.jpg",)).start()
Thread(target=thread_safe_predict, args=("image2.jpg",)).start()
Bu örnekte her iş parçacığı kendi YOLO örneğini oluşturur. Böylece hiçbir iş parçacığı diğerinin model durumuna müdahale edemez; her iş parçacığı çıkarımı güvenli biçimde ve diğer iş parçacıklarıyla beklenmedik etkileşimler olmadan gerçekleştirir.
ThreadingLocked Dekoratörünü Kullanma#
Ultralytics, işlevlerin iş parçacığı güvenli biçimde çalışmasını sağlamak için kullanılabilecek bir ThreadingLocked dekoratörü sunar. Bu dekoratör, aynı anda yalnızca bir iş parçacığının süslenen işlevi çalıştırabilmesi için kilit kullanır.
from ultralytics import YOLO
from ultralytics.utils import ThreadingLocked

# Bir model örneği oluştur
model = YOLO("yolo26n.pt")

# Tahmin işlevini iş parçacığı güvenli olacak şekilde süsle
@ThreadingLocked()
def thread_safe_predict(image_path):
    """Thread-safe prediction using a shared model instance."""
    results = model.predict(image_path)
    return results

# Artık bu işlevi birden fazla iş parçacığından güvenle çağırabilirsin
ThreadingLocked dekoratörü, bir model örneğini iş parçacıkları arasında paylaşman gerektiğinde ancak aynı anda ona yalnızca bir iş parçacığının erişmesini istediğinde özellikle kullanışlıdır.
Kilitli tek bir model örneğini paylaşmak, her iş parçacığında bir model yüklemeye kıyasla bellek tasarrufu sağlar; ancak iş parçacıkları kilit üzerinde sıraya girip sıralarını beklediğinden eş zamanlılığı azaltır. Yeterli belleğin varsa ve en yüksek paralellik düzeyini istiyorsan iş parçacığı başına örüntüyü tercih et; model belleği darboğaz olduğunda ThreadingLocked kullan.
Sonuç#
YOLO modellerini Python'un threading özelliğiyle kullanırken her iş parçacığına kendine özel bir model örneği ver ve hiçbir örneği iş parçacıkları arasında paylaşma. Bunu sağlamanın en kolay yolu, modeli kullanan iş parçacığının içinde oluşturmaktır; böylece yarış koşullarını önler ve çıkarım görevlerinin güvenilir kalmasını sağlarsın.
Daha gelişmiş senaryolar ve çok iş parçacıklı çıkarım performansını daha da iyileştirmek için multiprocessing ile süreç tabanlı paralelliği veya özel çalışan süreçleri olan bir görev kuyruğunu kullanmayı düşünebilirsin.
Sık Sorulan Sorular#
Çok iş parçacıklı Python ortamında Ultralytics YOLO modellerini kullanırken yarış durumlarını önlemek için her iş parçacığı içinde ayrı bir YOLO modeli örneği oluştur. Böylece her iş parçacığı kendi yalıtılmış model örneğine sahip olur ve model durumunun eşzamanlı değiştirilmesi önlenir.
Örnek:
from threading import Thread

from ultralytics import YOLO

def thread_safe_predict(image_path):
    """Predict on an image in a thread-safe manner."""
    local_model = YOLO("yolo26n.pt")
    results = local_model.predict(image_path)
    # Sonuçları işle

Thread(target=thread_safe_predict, args=("image1.jpg",)).start()
Thread(target=thread_safe_predict, args=("image2.jpg",)).start()
Python'da çok iş parçacıklı YOLO modeli çıkarımını güvenle çalıştırmak için şu en iyi uygulamaları izle:
- Tek bir model örneğini iş parçacıkları arasında paylaşmak yerine YOLO modellerini her iş parçacığının içinde oluştur.
- Global Yorumlayıcı Kilidi (GIL) ile ilgili sorunları önlemek için paralel işlemede Python'un
multiprocessingmodülünü kullan. - YOLO'nun temelindeki C kütüphanelerinin (PyTorch, OpenCV) yoğun hesaplama sırasında GIL'i otomatik olarak serbest bıraktığını ve bu sayede iş parçacıklarının eş zamanlı çıkarım yapabildiğini unutma.
- Bellek sorun olduğunda paylaşılan model örnekleri için
ThreadingLockeddekoratörünü kullanmayı düşün.
İş parçacığı güvenli model oluşturma örneği:
from threading import Thread

from ultralytics import YOLO

def thread_safe_predict(image_path):
    """Runs inference in a thread-safe manner with a new YOLO model instance."""
    local_model = YOLO("yolo26n.pt")
    results = local_model.predict(image_path)
    # Sonuçları işle

# Birden fazla iş parçacığı başlat
Thread(target=thread_safe_predict, args=("image1.jpg",)).start()
Thread(target=thread_safe_predict, args=("image2.jpg",)).start()
Ek bilgi için İş Parçacığı Güvenli Çıkarım bölümüne bak.
Yarış koşullarını önlemek için her iş parçacığının kendine ait bir YOLO model örneği olmalıdır. Tek bir model örneği birden fazla iş parçacığı arasında paylaşıldığında eş zamanlı erişimler öngörülemeyen davranışlara ve modelin iç durumunun değiştirilmesine yol açabilir. Ayrı örnekler kullanarak iş parçacıklarını yalıtır, çok iş parçacıklı görevlerini güvenilir ve güvenli hâle getirirsin.
Ayrıntılı yönergeler için İş Parçacığı Güvenli Olmayan Örnek: Tek Model Örneği ve İş Parçacığı Güvenli Örnek bölümlerine göz at.
Python'un Global Yorumlayıcı Kilidi (GIL), aynı anda yalnızca bir iş parçacığının Python bayt kodunu çalıştırmasına izin verir; bu da CPU ağırlıklı çok iş parçacıklı görevlerin performansını sınırlayabilir. Ancak G/Ç ağırlıklı işlemlerde veya YOLO'nun temelindeki C kütüphaneleri gibi GIL'i serbest bırakan kütüphaneleri kullanan işlemlerde eş zamanlılık sağlayabilirsin. Performansı artırmak için Python'un
multiprocessingmodülüyle süreç tabanlı paralelliği değerlendirebilirsin.Python'da iş parçacıkları hakkında daha fazla bilgi için Python'da İş Parçacıklarını Anlamak bölümüne bak.
Evet, YOLO modeli çıkarımını paralel çalıştırırken Python'un
multiprocessingmodülünü kullanmak daha güvenlidir ve çoğu zaman daha verimlidir. Süreç tabanlı paralellik ayrı bellek alanları oluşturur; böylece Global Yorumlayıcı Kilidi (GIL) devre dışı kalır ve eş zamanlılık sorunlarının riski azalır. Her süreç, kendine ait bir YOLO model örneğiyle bağımsız olarak çalışır.


Yorumlar12
Bir soru sor, sonuçlarını paylaş veya başka birine yardım et.
amani784
I used a YOLOv8 model optimized with TensorRT on an AWS machine with a Tesla T4 GPU to detect people in multiple videos. The model is loaded once per process using an initializer function. To improve performance, I parallelized the video processing using 4 processes from the multiprocessing module, where each process handles one video and performs inference using model.predict() on frames sampled at regular intervals. However, this approach led to a decrease in overall performance, with slower processing time per frame and reduced FPS. Is this normal, and if not, what is the solution?
warptengood
I have a few questions:
- Does the rules about thread-safety apply in the same way to TensorRT/ONNX inference of YOLO?
- Should I have the shared model for all threads when using TensorRT YOLO? (In case the answer for the 1st question is 'No'.)
- Is it true that it is better to have
streamparameter to be set toFalsewhen performing inference on TensorRT (inpredict()) - How
torch.cuda.Stream()affects the performance of multi-threading/multi-processing when used onpredict()/track()functions? - Should I have any sort of warm up for TensorRT inference before utilizing a model in any thread/process? (Like making inference on dummy input)
P.S: I want to thank all the Ultralytics team for their kindness and open-mindedness when it comes to help and support their community. You guys are always eager to help. And I don't care if it is some AI agent that's replying or a real person, I am very grateful for you for what you guys doing :D
 Glenn JocherUltralytics
@KenesYerassyl Thank you for your great questions about thread safety with TensorRT/ONNX models. Let me address each one:
-
Yes, the thread-safety principles apply similarly to TensorRT/ONNX models, but with important distinctions. TensorRT engines have their own memory management which can introduce additional concurrency concerns.
-
For TensorRT models, it's generally safer to use separate engine instances per thread or use a thread locking mechanism like our
ThreadingLockeddecorator. TensorRT engines maintain internal state during inference that can cause issues with concurrent access. -
Setting
stream=Falsefor TensorRT inference is often beneficial as it ensures complete processing of each input before handling another, which can help avoid resource conflicts in multi-threaded environments. -
Using
torch.cuda.Stream()with multi-threading can improve performance by allowing parallel execution of CUDA operations across different streams. However, you need to carefully manage synchronization points to prevent race conditions. Each thread should ideally use a separate CUDA stream. -
Yes, warming up TensorRT models is highly recommended. The first inference typically takes longer due to CUDA context initialization and memory allocations. Running inference on a dummy input before deploying in production or multi-threaded environments ensures consistent performance.
Thank you for your kind words about our team! We're committed to supporting the community with helpful resources and guidance.
-
Thank you very much for such a comprehensive reply!
mrbulb
Hello, is there any example code that uses Python's multiprocessing for YOLO model inference?
 Paula DerrengerUltralytics
@mrbulb for using Python's multiprocessing with YOLO model inference, you should instantiate a separate YOLO model within each process to avoid race conditions. This ensures each process has its own isolated model instance. For detailed guidance, please refer to our Thread-Safe Inference with YOLO Models page. If you need a specific code example, feel free to ask!
farrostaufiqur
how to use results differently for each thread?
- Paula DerrengerUltralytics
To use results differently for each thread, ensure each thread instantiates its own YOLO model instance. This prevents race conditions and ensures thread safety. For more details, please refer to our Thread-Safe Inference with YOLO Models guide.
ghost
Hello. Thanks for the info. I have a question, If I run in two terminals the same python script, but to two different videos, both processes still suffer from GIL ?
- Glenn JocherUltralytics
@cawilchesp running the same Python script in two separate terminals for different videos won't suffer from GIL issues, as each process has its own Python interpreter and memory space. This effectively bypasses the GIL, allowing true parallel execution. For more details, you can check out our guide on thread-safe inference: https://docs.ultralytics.com/guides/yolo-thread-safe-inference/.
abysshal
So what is the best practice for single-threaded processing with asyncio? For example, gunicron+gevent+flask is used to deal with highly concurrent requests, and only one Yolo model instance will be created in each worker process. Here we do not handle threads manually, we only provide the predict function for callback from gevent. Then will the predict function of the same model instance be called again on the next request when it is not completed due to an I/O wait operation on the current request? How we handle this safely? Does it matter if cpu of gpu is used for inference?
- Glenn JocherUltralytics(düzenlendi)
@abysshal when using an asynchronous server like Gunicorn with Gevent and Flask, you're dealing with a cooperative multitasking environment. In such an environment, the context switches occur at well-defined points, typically I/O operations or explicit yield points. This means that your predict function will not be preempted in the middle of execution by another request unless it hits an I/O wait or a yield.
Here's how you can handle this safely:
-
Single Model Instance: Since you're creating only one YOLO model instance per worker process, you need to ensure that the predict function is designed to be re-entrant. This means that if the function is called again while a previous call is waiting for I/O, it should not cause any conflicts or unexpected behavior.
-
Asyncio Compatibility: If you're using asyncio, you should ensure that the predict function and any other code that might run concurrently are compatible with asyncio's event loop. This means using
awaitfor I/O-bound operations and ensuring that any libraries you use within the predict function are also compatible with asyncio. -
Thread Safety: Even though you're not manually handling threads, the underlying implementation of some libraries (like PyTorch) may use threads for certain operations. A single Ultralytics
YOLOmodel instance is not thread-safe, so do not share one instance across threads. Use one instance per thread or worker, or wrap the shared call with theThreadingLockeddecorator (see the thread-safe inference guide). -
Resource Locking: If there are shared resources that need to be accessed or modified during the predict function, you should use appropriate locking mechanisms to prevent race conditions. However, in an async environment, you should use async-compatible locks like
asyncio.Lock. -
CPU vs. GPU Inference: The choice between CPU and GPU can affect performance but should not affect the thread safety or the async behavior of your application. However, if you're using a GPU, you need to ensure that the library you're using for YOLO supports concurrent model inference on the GPU without conflicts.
-
Testing: Test your application under load to ensure that it behaves correctly with concurrent requests. You can use tools like
locustorab(Apache Bench) to simulate high concurrency and check for any race conditions or deadlocks.
In summary, when using Gunicorn with Gevent and Flask, you should ensure that your predict function is re-entrant and compatible with asyncio, use async-compatible locks if necessary, and test your application under load. The choice of CPU or GPU should not affect the thread safety of your application, but you should ensure that your YOLO model library supports concurrent inference on your chosen hardware.
1 -