Tổng quan về các dataset Hộp giới hạn xoay (OBB)#
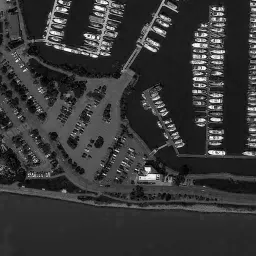
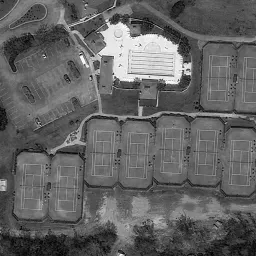
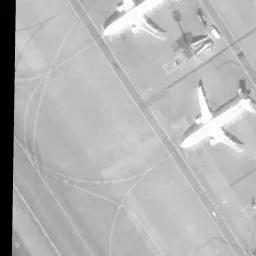
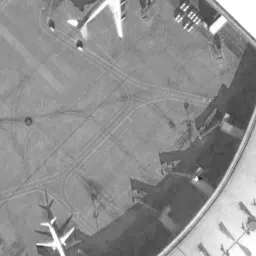
Việc training một model phát hiện đối tượng chính xác với các hộp giới hạn xoay (OBB) đòi hỏi một dataset kỹ lưỡng. Hướng dẫn này giải thích các định dạng dataset OBB khác nhau tương thích với các model Ultralytics YOLO, đồng thời cung cấp thông tin về cấu trúc, ứng dụng và phương pháp chuyển đổi định dạng.
Các định dạng dataset OBB được hỗ trợ#
Định dạng YOLO OBB#
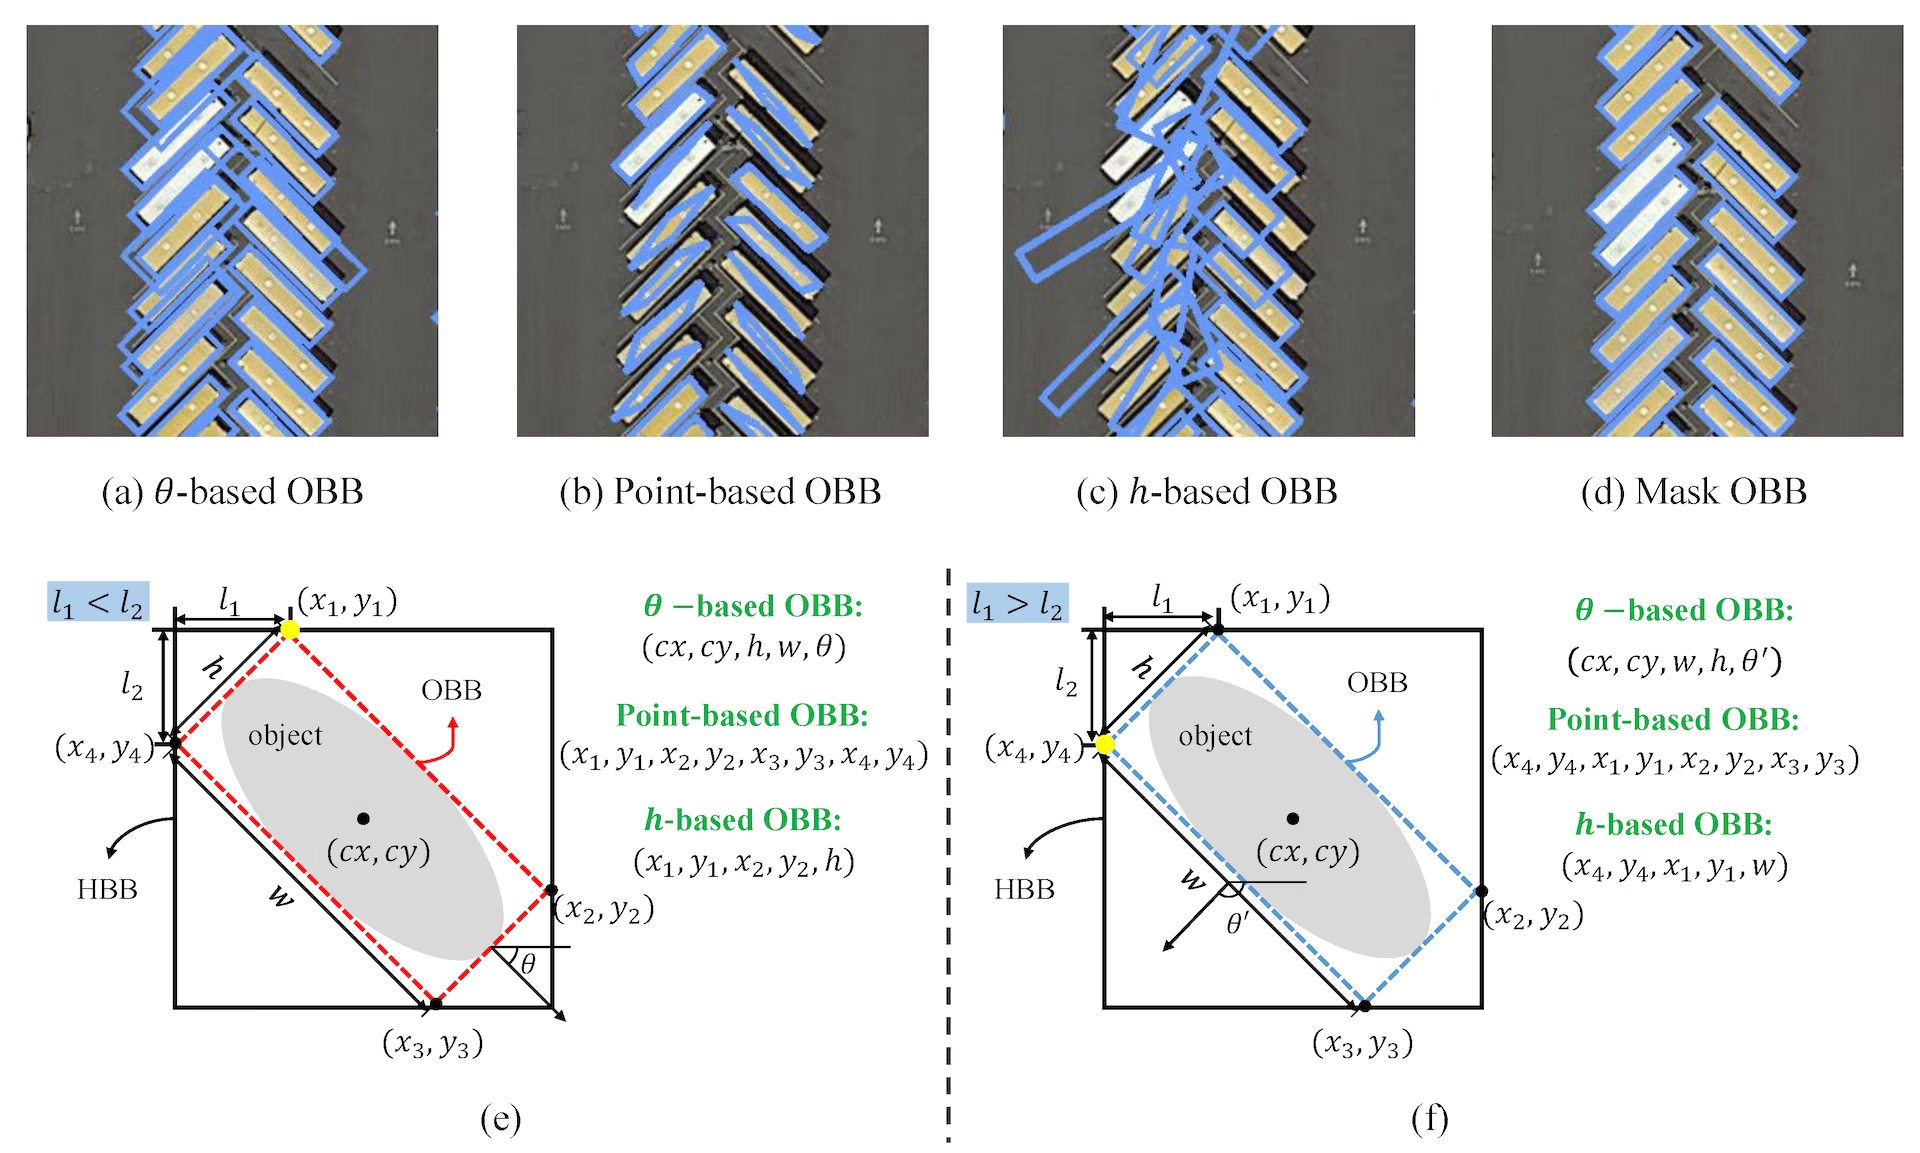
Định dạng YOLO OBB xác định các hộp giới hạn bằng bốn điểm góc, với tọa độ được chuẩn hóa trong khoảng từ 0 đến 1. Định dạng này tuân theo cấu trúc sau:
class_index x1 y1 x2 y2 x3 y3 x4 y4Nội bộ, YOLO xử lý loss và output theo định dạng xywhr, biểu diễn điểm tâm (xy), chiều rộng, chiều cao và phép xoay của bounding box.
Ví dụ về file label *.txt cho ảnh trên, chứa một đối tượng thuộc class 0 ở định dạng OBB, có thể như sau:
0 0.780811 0.743961 0.782371 0.74686 0.777691 0.752174 0.776131 0.749758Định dạng YAML của dataset#
Framework Ultralytics sử dụng định dạng file YAML để xác định cấu hình dataset và model cho quá trình training model OBB. Dưới đây là ví dụ về định dạng YAML dùng để xác định một dataset OBB:
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# DOTA8 dataset (8 images from the DOTAv1 split) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/obb/dota8
# Example usage: yolo train model=yolov8n-obb.pt data=dota8.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── dota8 ← downloads here (1 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: dota8 # dataset root dir
train: images/train # train images (relative to 'path') 4 images
val: images/val # val images (relative to 'path') 4 images

# Classes for DOTA 1.0
names:
  0: plane
  1: ship
  2: storage tank
  3: baseball diamond
  4: tennis court
  5: basketball court
  6: ground track field
  7: harbor
  8: bridge
  9: large vehicle
  10: small vehicle
  11: helicopter
  12: roundabout
  13: soccer ball field
  14: swimming pool

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/dota8.zip
Mỗi mục trong train, val và test chấp nhận một thư mục, một danh sách thư mục hoặc file *.txt liệt kê một đường dẫn ảnh trên mỗi dòng (các đường dẫn bắt đầu bằng ./ được phân giải tương đối so với file *.txt). File *.txt hữu ích khi huấn luyện trên một tập con của thư mục, bỏ qua các ảnh không có label hoặc kết hợp ảnh từ nhiều nguồn vào một split.
path: datasets/dota8 # dataset root
train: train.txt # a directory, a list e.g. [images/a, images/b], or a *.txt file
val: val.txt
names:
  0: plane
Cách sử dụng#
Để train một model bằng các định dạng OBB này:
from ultralytics import YOLO

# Load a pretrained YOLO26n-OBB model
model = YOLO("yolo26n-obb.pt")

# Train the model on the DOTAv1 dataset
results = model.train(data="DOTAv1.yaml", epochs=100, imgsz=1024)
Các dataset được hỗ trợ#
Hiện tại, các tập dữ liệu sau đây với hộp bao định hướng (OBB) được hỗ trợ. Hầu hết các tập dữ liệu này cũng được lưu trữ trên Ultralytics Platform, nơi bạn có thể duyệt qua hình ảnh và chú thích, xem số liệu thống kê tập dữ liệu và nhân bản chúng để huấn luyện trên đám mây.
- DOTA-v1: Phiên bản đầu tiên của dataset DOTA, cung cấp một tập hợp toàn diện các ảnh trên không với các hộp giới hạn xoay cho bài toán phát hiện đối tượng.
- DOTA-v1.5: Một phiên bản trung gian của dataset DOTA, cung cấp thêm các annotation và cải tiến so với DOTA-v1 cho các tác vụ phát hiện đối tượng nâng cao.
- DOTA-v2: Phiên bản 2 của DOTA (một dataset quy mô lớn cho phát hiện đối tượng trong ảnh trên không), tập trung vào việc phát hiện từ góc nhìn trên không và chứa các hộp giới hạn xoay với 1,7 triệu instance trong 11.268 ảnh.
- DOTA8: Một subset nhỏ gồm 8 ảnh của dataset DOTA đầy đủ, phù hợp để kiểm thử workflow và các kiểm tra Tích hợp liên tục (CI) cho quá trình training OBB trong repository
ultralytics. - DOTA8 Multispectral: Một subset TIFF gồm 8 ảnh và 10 kênh để kiểm thử quá trình training OBB đa phổ trên Ultralytics Platform.
- DOTA128: Một subset gồm 128 ảnh của dataset DOTA, trong đó tất cả ảnh nằm trong thư mục train (được sử dụng cho cả train và val), mang lại sự cân bằng tốt giữa kích thước và tính đa dạng để kiểm thử các model OBB.
Tích hợp dataset OBB của riêng bạn#
Nếu muốn đưa vào sử dụng dataset có hộp giới hạn xoay của riêng mình, hãy đảm bảo dataset tương thích với "định dạng YOLO OBB" đã đề cập ở trên. Chuyển đổi các annotation của bạn sang định dạng bắt buộc này, đồng thời khai báo các đường dẫn, class và tên class trong file cấu hình YAML tương ứng.
Chuyển đổi định dạng label#
Định dạng dataset DOTA sang định dạng YOLO OBB#
Bạn có thể chuyển đổi label từ định dạng dataset DOTA sang định dạng YOLO OBB bằng script sau:
from ultralytics.data.converter import convert_dota_to_yolo_obb

convert_dota_to_yolo_obb("path/to/DOTA")
Cơ chế chuyển đổi này rất hữu ích cho các dataset ở định dạng DOTA, đảm bảo tính tương thích với định dạng OBB của Ultralytics YOLO.
Điều quan trọng là phải xác thực tính tương thích của dataset với model và tuân thủ các quy ước định dạng cần thiết. Dataset được cấu trúc đúng là yếu tố then chốt để training các model phát hiện đối tượng hiệu quả với hộp giới hạn xoay.
FAQ#
Hộp giới hạn xoay (OBB) là một loại annotation hộp giới hạn, trong đó hộp có thể được xoay để căn chỉnh gần hơn với đối tượng được phát hiện, thay vì chỉ căn theo các trục. Điều này đặc biệt hữu ích trong ảnh trên không hoặc ảnh vệ tinh, nơi các đối tượng có thể không thẳng hàng với các trục của ảnh. Trong các model Ultralytics YOLO, OBB được biểu diễn bằng bốn điểm góc theo định dạng YOLO OBB. Điều này cho phép phát hiện đối tượng chính xác hơn vì các hộp giới hạn có thể xoay để khớp với đối tượng tốt hơn.
Bạn có thể chuyển đổi label của dataset DOTA sang định dạng YOLO OBB bằng function
convert_dota_to_yolo_obbtừ Ultralytics. Việc chuyển đổi này đảm bảo khả năng tương thích với các model Ultralytics YOLO, cho phép bạn tận dụng khả năng OBB để cải thiện việc phát hiện đối tượng. Dưới đây là một ví dụ nhanh:from ultralytics.data.converter import convert_dota_to_yolo_obb convert_dota_to_yolo_obb("path/to/DOTA")Script này sẽ định dạng lại các annotation DOTA của bạn sang định dạng tương thích với YOLO.
Training một model YOLO26 với OBB yêu cầu đảm bảo dataset của bạn ở định dạng YOLO OBB, sau đó sử dụng Ultralytics API để train model. Dưới đây là ví dụ bằng cả Python và CLI:
Ví dụfrom ultralytics import YOLO # Create a new YOLO26n-OBB model from scratch model = YOLO("yolo26n-obb.yaml") # Train the model on the custom dataset results = model.train(data="your_dataset.yaml", epochs=100, imgsz=640)Điều này đảm bảo model của bạn tận dụng các annotation OBB chi tiết để cải thiện độ chính xác phát hiện.
Hiện tại, Ultralytics hỗ trợ các dataset sau cho training OBB:
- DOTA-v1: Phiên bản đầu tiên của dataset DOTA, cung cấp một tập hợp toàn diện các ảnh trên không với các hộp giới hạn xoay cho bài toán phát hiện đối tượng.
- DOTA-v1.5: Một phiên bản trung gian của dataset DOTA, cung cấp thêm các annotation và cải tiến so với DOTA-v1 cho các tác vụ phát hiện đối tượng nâng cao.
- DOTA-v2: Dataset này bao gồm 1,7 triệu instance với các hộp giới hạn xoay và 11.268 ảnh, chủ yếu tập trung vào phát hiện đối tượng trên không.
- DOTA8: Một subset nhỏ hơn gồm 8 ảnh của dataset DOTA, được sử dụng để kiểm thử và kiểm tra tích hợp liên tục (CI).
- DOTA128: Một subset gồm 128 ảnh, trong đó tất cả ảnh nằm trong thư mục train (được sử dụng cho cả train và val), cung cấp tính đa dạng cao hơn DOTA8 nhưng vẫn dễ quản lý cho quá trình phát triển và thử nghiệm ban đầu với model OBB.
Các dataset này được thiết kế cho những tình huống mà OBB mang lại lợi thế đáng kể, chẳng hạn như phân tích ảnh trên không và ảnh vệ tinh.
Có, bạn có thể sử dụng dataset có hộp giới hạn xoay của riêng mình để training YOLO26. Hãy đảm bảo các annotation của dataset được chuyển đổi sang định dạng YOLO OBB, trong đó các hộp giới hạn được xác định bằng bốn điểm góc. Sau đó, bạn có thể tạo một file cấu hình YAML chỉ định các đường dẫn dataset, class và những thông tin cần thiết khác. Để biết thêm thông tin về cách tạo và cấu hình dataset, hãy tham khảo phần Dataset được hỗ trợ.