Dataset DOTA8
Giới thiệu#
DOTA8 của Ultralytics là bộ dữ liệu phát hiện đối tượng xoay nhỏ, gồm 8 hình ảnh đầu tiên của tập DOTAv1, với 4 hình ảnh dùng cho huấn luyện và 4 hình ảnh cho validation. Bộ dữ liệu này lý tưởng để kiểm thử, gỡ lỗi model phát hiện đối tượng hoặc thử nghiệm các phương pháp phát hiện mới. Với 8 hình ảnh, bộ dữ liệu đủ nhỏ để dễ quản lý nhưng vẫn đủ đa dạng để kiểm tra lỗi trong pipeline huấn luyện và làm bước kiểm tra tính hợp lý trước khi huấn luyện trên các bộ dữ liệu lớn hơn.
Cấu trúc dataset#
-
Ảnh: 8 ô ảnh trên không (4 train, 4 val) lấy từ DOTAv1.
-
Lớp: Kế thừa 15 danh mục của DOTAv1, chẳng hạn như máy bay, tàu thủy và xe cỡ lớn.
-
Nhãn: Hộp giới hạn xoay định dạng YOLO được lưu thành các file
.txtbên cạnh từng ảnh. -
Tải xuống: 1 MB, được tự động tải từ tài nguyên GitHub của Ultralytics trong lần đầu tiên bạn huấn luyện.
-
Bố cục đề xuất:
datasets/dota8/
├── images/
│   ├── train/
│   └── val/
└── labels/
    ├── train/
    └── val/
Khám phá DOTA8 trên Ultralytics Platform để xem các ô ảnh trên không cùng lớp phủ hộp xoay, xem phân bố lớp và bản đồ nhiệt chú thích trong tab Charts, rồi sao chép dataset để huấn luyện model của riêng bạn trên cloud.
YAML của dataset#
File YAML được dùng để xác định cấu hình dataset. File này chứa thông tin về đường dẫn, lớp và các thông tin liên quan khác của dataset. Với dataset DOTA8, file dota8.yaml được duy trì tại https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dota8.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# DOTA8 dataset (8 images from the DOTAv1 split) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/obb/dota8
# Example usage: yolo train model=yolov8n-obb.pt data=dota8.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── dota8 ← downloads here (1 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: dota8 # dataset root dir
train: images/train # train images (relative to 'path') 4 images
val: images/val # val images (relative to 'path') 4 images

# Classes for DOTA 1.0
names:
  0: plane
  1: ship
  2: storage tank
  3: baseball diamond
  4: tennis court
  5: basketball court
  6: ground track field
  7: harbor
  8: bridge
  9: large vehicle
  10: small vehicle
  11: helicopter
  12: roundabout
  13: soccer ball field
  14: swimming pool

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/dota8.zip
Cách sử dụng#
Để huấn luyện model YOLO26n-obb trên bộ dữ liệu DOTA8 trong 100 epoch với kích thước ảnh 640, bạn có thể dùng các đoạn mã sau.
from ultralytics import YOLO

# Tải model
model = YOLO("yolo26n-obb.pt")  # tải model đã huấn luyện trước (được khuyến nghị khi huấn luyện)

# Huấn luyện model
results = model.train(data="dota8.yaml", epochs=100, imgsz=640)
Hình ảnh mẫu và annotation#
Sau đây là một số ảnh trong dataset DOTA8 cùng với các chú thích tương ứng:
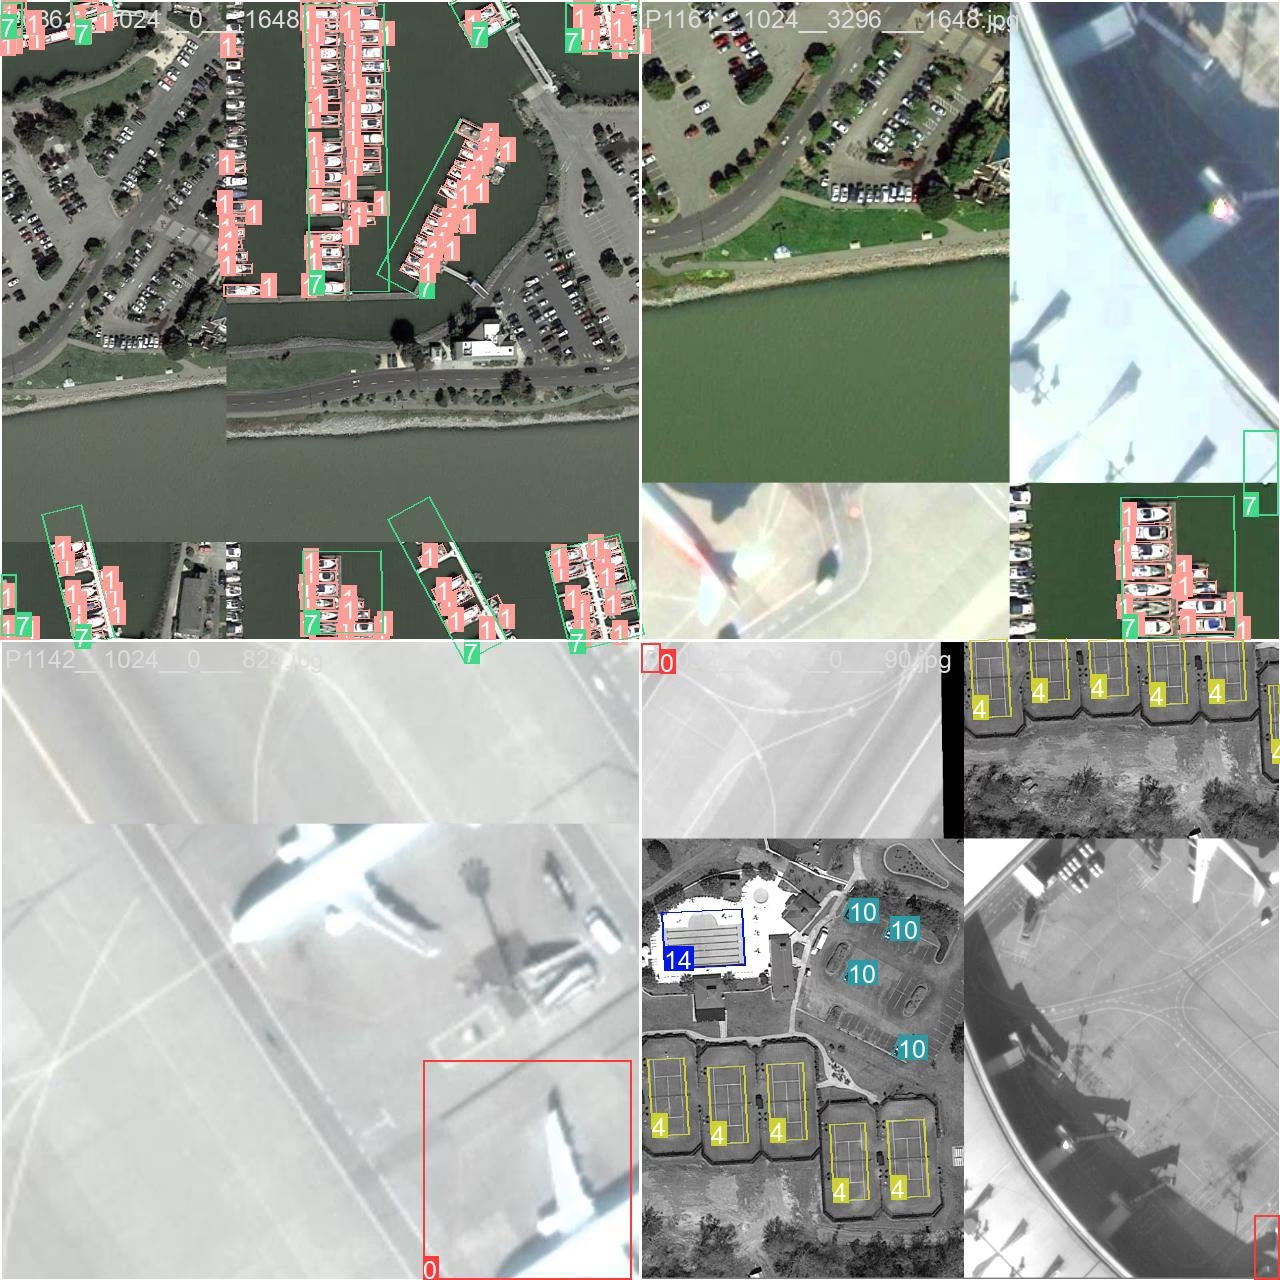
- Ảnh ghép Mosaic: Hình ảnh này minh họa một batch huấn luyện được tạo từ các ảnh mosaic của bộ dữ liệu. Mosaic là kỹ thuật được sử dụng trong quá trình huấn luyện, kết hợp nhiều hình ảnh thành một hình ảnh duy nhất để tăng sự đa dạng của đối tượng và bối cảnh trong mỗi batch huấn luyện. Kỹ thuật này giúp cải thiện khả năng tổng quát hóa của model đối với các kích thước đối tượng, tỷ lệ khung hình và ngữ cảnh khác nhau.
Ví dụ này minh họa sự đa dạng và phức tạp của ảnh trong dataset DOTA8, cũng như lợi ích của việc sử dụng ghép mosaic trong quá trình huấn luyện.
Trích dẫn và lời cảm ơn#
Nếu sử dụng dataset DOTA trong nghiên cứu hoặc phát triển, vui lòng trích dẫn bài báo sau:
@article{9560031,
  author={Ding, Jian and Xue, Nan and Xia, Gui-Song and Bai, Xiang and Yang, Wen and Yang, Michael and Belongie, Serge and Luo, Jiebo and Datcu, Mihai and Pelillo, Marcello and Zhang, Liangpei},
  journal={IEEE Transactions on Pattern Analysis and Machine Intelligence},
  title={Object Detection in Aerial Images: A Large-Scale Benchmark and Challenges},
  year={2022},
  volume={44},
  number={11},
  pages={7778-7796},
  doi={10.1109/TPAMI.2021.3117983}
}
Chúng tôi cảm ơn nhóm phát triển các bộ dữ liệu DOTA đã biên soạn những bộ dữ liệu này. Để xem thông tin đầy đủ về bộ dữ liệu, hãy truy cập trang web DOTA chính thức.
Câu hỏi thường gặp#
Bộ dữ liệu DOTA8 là bộ dữ liệu phát hiện đối tượng xoay nhỏ, gồm 8 hình ảnh đầu tiên từ tập DOTAv1, trong đó 4 hình ảnh dành cho huấn luyện và 4 hình ảnh dành cho validation. Bộ dữ liệu lý tưởng để kiểm thử và gỡ lỗi các model phát hiện đối tượng như Ultralytics YOLO26. Nhờ kích thước dễ quản lý và tính đa dạng, bộ dữ liệu giúp xác định lỗi trong pipeline và thực hiện kiểm tra tính hợp lý trước khi huấn luyện trên các bộ dữ liệu lớn hơn.
Để huấn luyện model YOLO26n-obb trên dataset DOTA8 trong 100 epoch với kích thước ảnh 640, bạn có thể dùng các đoạn mã sau. Để xem các tùy chọn tham số đầy đủ, hãy tham khảo trang Huấn luyện model.
Ví dụ huấn luyệnfrom ultralytics import YOLO # Tải model model = YOLO("yolo26n-obb.pt") # tải model đã huấn luyện trước (được khuyến nghị khi huấn luyện) # Huấn luyện model results = model.train(data="dota8.yaml", epochs=100, imgsz=640)Bộ dữ liệu DOTA nổi tiếng với benchmark quy mô lớn và những thách thức trong phát hiện đối tượng trên ảnh chụp từ trên không. Tập con DOTA8 là bộ dữ liệu nhỏ gọn, dễ quản lý, lý tưởng cho các thử nghiệm ban đầu. Tệp cấu hình
dota8.yaml, chứa đường dẫn, lớp và thông tin cấu hình, được duy trì trong repository GitHub của Ultralytics.Ghép ảnh Mosaic kết hợp nhiều hình ảnh thành một hình trong quá trình huấn luyện, làm tăng sự đa dạng của đối tượng và ngữ cảnh trong mỗi batch. Cách này cải thiện khả năng tổng quát hóa của model với các kích thước đối tượng, tỷ lệ khung hình và cảnh khác nhau.
Ultralytics YOLO26 hỗ trợ phát hiện đối tượng thời gian thực, bao gồm bounding box xoay (OBB), cùng các tác vụ khác như phân đoạn instance, tất cả thông qua một pipeline huấn luyện. Các model được huấn luyện trước giúp fine-tune hiệu quả.


Bình luận2
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.
expen6ve
How do you create a dataset for OBB? can i use the visdrone dataset to train an obb model?
 Glenn JocherUltralytics
@expen6ve yes, you can use VisDrone with YOLO OBB by converting your annotations to YOLO OBB format (four corner points with normalized coordinates). Create a dataset YAML file following our DOTA8 example structure, and ensure annotations match the required
class_index x1 y1 x2 y2 x3 y3 x4 y4format. For conversion tools and format details, see our OBB Dataset Guide.