Dataset ADE20K#
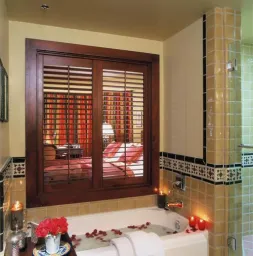
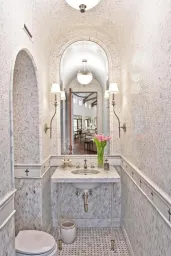
Dataset ADE20K là benchmark phân đoạn ngữ nghĩa quy mô lớn của MIT CSAIL, gồm 20.210 ảnh huấn luyện và 2.000 ảnh validation được gán nhãn dày đặc trên 150 nhóm trong nhà, ngoài trời, vật thể và vật thể nền. Đây là tài nguyên tiêu chuẩn để huấn luyện và đánh giá model hiểu cảnh dày đặc bằng Ultralytics YOLO.
Tính năng chính#
- Benchmark SceneParsing đầy đủ của ADE20K có tổng cộng 25.562 ảnh: 20.210 ảnh huấn luyện, 2.000 ảnh validation và 3.352 ảnh kiểm thử. Chú thích ảnh kiểm thử không được công bố công khai, vì vậy archive
ADEChallengeData2016có thể tải xuống và cấu hình Ultralyticsade20k.yamlchỉ sử dụng các phần tách huấn luyện và validation. - Tập dữ liệu bao gồm 150 lớp ngữ nghĩa thuộc các nhóm trong nhà, ngoài trời, đối tượng và nền.
- Các chú thích là mask phân đoạn dày đặc ở cấp pixel, phù hợp cho phân tích cảnh.
Cấu trúc dataset#
Cấu hình Ultralytics yêu cầu bố cục ADEChallengeData2016 chính thức:
ADEChallengeData2016/
├── images/
│   ├── training/
│   └── validation/
└── annotations/
    ├── training/
└── validation/ADE20K không có script tải xuống tự động. Hãy tải tệp lưu trữ ADEChallengeData2016.zip dung lượng ~1 GB và giải nén trực tiếp vào thư mục datasets/. Thư mục cấp cao nhất trong tệp lưu trữ đã có tên ADEChallengeData2016/, vì vậy thao tác này sẽ tạo ra datasets/ADEChallengeData2016/ khớp với bố cục ở trên — đừng tự tạo thư mục ADEChallengeData2016 rồi giải nén vào đó, nếu không bạn sẽ có thư mục datasets/ADEChallengeData2016/ADEChallengeData2016/ lồng bên trong mà YAML không thể tìm thấy.
Trường masks_dir được đặt thành annotations, nên mỗi ảnh trong images/ được ghép với mask tương ứng trong annotations/. Mask ADE20K gốc dùng ID nhãn nguồn, trong đó 0 được bỏ qua; phần label_mapping chuyển đổi các nhãn hợp lệ từ 1 đến 150 thành ID huấn luyện liên tục từ 0 đến 149, đồng thời ánh xạ các pixel bị bỏ qua thành 255.
Ứng dụng#
ADE20K được sử dụng rộng rãi để huấn luyện và đánh giá các model deep learning trong phân đoạn ngữ nghĩa và phân tích cảnh. Tập hợp danh mục đa dạng cùng các cảnh phức tạp khiến bộ dữ liệu này có giá trị cho những ứng dụng như điều hướng tự hành, robot, thực tế tăng cường và chỉnh sửa ảnh.
Phạm vi cảnh trong nhà và ngoài trời rộng cũng khiến ADE20K trở thành benchmark hiệu quả để đánh giá khả năng tổng quát hóa của model giữa các miền dữ liệu. Các model phân đoạn ngữ nghĩa YOLO26 được huấn luyện trước đạt mIoU tối đa 51.5 trên tập validation ADE20K — xem trang các model phân đoạn ngữ nghĩa để biết bảng benchmark đầy đủ. Các tập dữ liệu định dạng ADE20K cũng hoàn toàn tương thích với Ultralytics Platform để quản lý tập dữ liệu và huấn luyện.
YAML của dataset#
Tệp YAML của tập dữ liệu xác định đường dẫn ADE20K, các lớp, thư mục mask và ánh xạ nhãn. Tệp ade20k.yaml được duy trì tại https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/ade20k.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# ADE20K semantic segmentation dataset (150 classes)
# Documentation: https://docs.ultralytics.com/datasets/semantic/ade20k
# Example usage: yolo semantic train data=ade20k.yaml model=yolo26n-sem-ade20k.pt
# parent
# ├── ultralytics
# └── datasets
#     └── ADEChallengeData2016 ← downloads here (1 GB)
#         └── images
#         └── annotations

# Dataset root directory
path: ADEChallengeData2016
train: images/training
val: images/validation

masks_dir: annotations # semantic mask directory

# ADE20K 150-class labels
names:
  0: wall
  1: building
  2: sky
  3: floor
  4: tree
  5: ceiling
  6: road
  7: bed
  8: windowpane
  9: grass
  10: cabinet
  11: sidewalk
  12: person
  13: earth
  14: door
  15: table
  16: mountain
  17: plant
  18: curtain
  19: chair
  20: car
  21: water
  22: painting
  23: sofa
  24: shelf
  25: house
  26: sea
  27: mirror
  28: rug
  29: field
  30: armchair
  31: seat
  32: fence
  33: desk
  34: rock
  35: wardrobe
  36: lamp
  37: bathtub
  38: railing
  39: cushion
  40: base
  41: box
  42: column
  43: signboard
  44: chest of drawers
  45: counter
  46: sand
  47: sink
  48: skyscraper
  49: fireplace
  50: refrigerator
  51: grandstand
  52: path
  53: stairs
  54: runway
  55: case
  56: pool table
  57: pillow
  58: screen door
  59: stairway
  60: river
  61: bridge
  62: bookcase
  63: blind
  64: coffee table
  65: toilet
  66: flower
  67: book
  68: hill
  69: bench
  70: countertop
  71: stove
  72: palm
  73: kitchen island
  74: computer
  75: swivel chair
  76: boat
  77: bar
  78: arcade machine
  79: hovel
  80: bus
  81: towel
  82: light
  83: truck
  84: tower
  85: chandelier
  86: awning
  87: streetlight
  88: booth
  89: television receiver
  90: airplane
  91: dirt track
  92: apparel
  93: pole
  94: land
  95: bannister
  96: escalator
  97: ottoman
  98: bottle
  99: buffet
  100: poster
  101: stage
  102: van
  103: ship
  104: fountain
  105: conveyor belt
  106: canopy
  107: washer
  108: plaything
  109: swimming pool
  110: stool
  111: barrel
  112: basket
  113: waterfall
  114: tent
  115: bag
  116: minibike
  117: cradle
  118: oven
  119: ball
  120: food
  121: step
  122: tank
  123: trade name
  124: microwave
  125: pot
  126: animal
  127: bicycle
  128: lake
  129: dishwasher
  130: screen
  131: blanket
  132: sculpture
  133: hood
  134: sconce
  135: vase
  136: traffic light
  137: tray
  138: ashcan
  139: fan
  140: pier
  141: crt screen
  142: plate
  143: monitor
  144: bulletin board
  145: shower
  146: radiator
  147: glass
  148: clock
  149: flag

# Map source label IDs to train IDs; ignore_label is converted to 255.
label_mapping:
  0: ignore_label
  1: 0
  2: 1
  3: 2
  4: 3
  5: 4
  6: 5
  7: 6
  8: 7
  9: 8
  10: 9
  11: 10
  12: 11
  13: 12
  14: 13
  15: 14
  16: 15
  17: 16
  18: 17
  19: 18
  20: 19
  21: 20
  22: 21
  23: 22
  24: 23
  25: 24
  26: 25
  27: 26
  28: 27
  29: 28
  30: 29
  31: 30
  32: 31
  33: 32
  34: 33
  35: 34
  36: 35
  37: 36
  38: 37
  39: 38
  40: 39
  41: 40
  42: 41
  43: 42
  44: 43
  45: 44
  46: 45
  47: 46
  48: 47
  49: 48
  50: 49
  51: 50
  52: 51
  53: 52
  54: 53
  55: 54
  56: 55
  57: 56
  58: 57
  59: 58
  60: 59
  61: 60
  62: 61
  63: 62
  64: 63
  65: 64
  66: 65
  67: 66
  68: 67
  69: 68
  70: 69
  71: 70
  72: 71
  73: 72
  74: 73
  75: 74
  76: 75
  77: 76
  78: 77
  79: 78
  80: 79
  81: 80
  82: 81
  83: 82
  84: 83
  85: 84
  86: 85
  87: 86
  88: 87
  89: 88
  90: 89
  91: 90
  92: 91
  93: 92
  94: 93
  95: 94
  96: 95
  97: 96
  98: 97
  99: 98
  100: 99
  101: 100
  102: 101
  103: 102
  104: 103
  105: 104
  106: 105
  107: 106
  108: 107
  109: 108
  110: 109
  111: 110
  112: 111
  113: 112
  114: 113
  115: 114
  116: 115
  117: 116
  118: 117
  119: 118
  120: 119
  121: 120
  122: 121
  123: 122
  124: 123
  125: 124
  126: 125
  127: 126
  128: 127
  129: 128
  130: 129
  131: 130
  132: 131
  133: 132
  134: 133
  135: 134
  136: 135
  137: 136
  138: 137
  139: 138
  140: 139
  141: 140
  142: 141
  143: 142
  144: 143
  145: 144
  146: 145
  147: 146
  148: 147
  149: 148
  150: 149
# Download URL (manual): https://data.csail.mit.edu/places/ADEchallenge/ADEChallengeData2016.zip
Cách sử dụng#
Để huấn luyện model YOLO26n-sem trên tập dữ liệu ADE20K trong 100 epoch với kích thước ảnh 640, bạn có thể dùng các đoạn mã sau. Để xem danh sách đầy đủ các tham số hiện có, hãy tham khảo trang Huấn luyện model.
from ultralytics import YOLO

# Tải model
model = YOLO("yolo26n-sem-ade20k.pt")  # tải model đã huấn luyện trước trên ADE20K (được khuyến nghị khi huấn luyện)

# Huấn luyện model
results = model.train(data="ade20k.yaml", epochs=100, imgsz=640)
Trích dẫn, giấy phép và lời cảm ơn#
Ảnh ADE20K được phát hành chỉ dành cho nghiên cứu phi thương mại và mục đích giáo dục; phần mềm chú thích của tập dữ liệu được cấp phép riêng theo BSD-3. Việc sử dụng cho mục đích thương mại cần được MIT CSAIL cho phép.
Nếu sử dụng tập dữ liệu ADE20K trong nghiên cứu hoặc công việc phát triển, vui lòng trích dẫn bài báo sau:
@inproceedings{zhou2017scene,
  title={Scene Parsing through ADE20K Dataset},
  author={Zhou, Bolei and Zhao, Hang and Puig, Xavier and Fidler, Sanja and Barriuso, Adela and Torralba, Antonio},
  booktitle={Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition},
  year={2017}
}
Chúng tôi xin ghi nhận đóng góp của Nhóm Thị giác Máy tính MIT CSAIL trong việc tạo và duy trì tài nguyên quý giá này cho cộng đồng thị giác máy tính. Để biết thêm thông tin về tập dữ liệu ADE20K và những người tạo ra bộ dữ liệu, hãy truy cập trang web tập dữ liệu ADE20K.
Câu hỏi thường gặp#
Tập dữ liệu ADE20K là một benchmark phân tích cảnh quy mô lớn được dùng cho phân đoạn ngữ nghĩa, với 20,210 ảnh huấn luyện và 2,000 ảnh validation được phát hành công khai, thuộc 150 danh mục bao gồm các lớp trong nhà, ngoài trời, đối tượng và nền. Các nhà nghiên cứu sử dụng ADE20K nhờ cảnh đa dạng, tập danh mục chi tiết và các metric đánh giá chuẩn hóa như giao trên hợp trung bình (mIoU), phù hợp để benchmark các model dự đoán dày đặc.
Để huấn luyện model YOLO26n-sem trên tập dữ liệu ADE20K trong 100 epoch với kích thước ảnh 640, bạn có thể dùng các đoạn mã sau. Để xem danh sách chi tiết các tham số hiện có, hãy tham khảo trang Huấn luyện model.
Ví dụ huấn luyệnfrom ultralytics import YOLO # Tải model model = YOLO("yolo26n-sem-ade20k.pt") # tải model đã huấn luyện trước trên ADE20K (được khuyến nghị khi huấn luyện) # Huấn luyện model results = model.train(data="ade20k.yaml", epochs=100, imgsz=640)Tập dữ liệu ADE20K tuân theo bố cục ADEChallengeData2016 chính thức, trong đó ảnh được sắp xếp trong
images/training/vàimages/validation/, còn mask tương ứng nằm trongannotations/training/vàannotations/validation/. Tệp YAML của Ultralytics ghép từng ảnh với mask thông qua trườngmasks_dir: annotations, đồng thời dùnglabel_mappingđể chuyển ID nhãn nguồn từ1–150thành ID huấn luyện liên tục từ0–149, ánh xạ nhãn cần bỏ qua thành255.Có. Hãy tải tệp lưu trữ
ADEChallengeData2016.zip(~1 GB) và giải nén trực tiếp vào thư mụcdatasets/trước khi huấn luyện — thư mục cấp cao nhất trong tệp lưu trữ đã có tênADEChallengeData2016/, vì vậy giải nén vào đó (không phải vào thư mụcADEChallengeData2016riêng do bạn tự tạo) sẽ tạo ra bố cụcimages/vàannotations/màade20k.yamlyêu cầu.Mask chú thích ADE20K lưu ID nhãn nguồn, trong đó
0biểu thị lớp cần bỏ qua hoặc lớp nền. Phầnlabel_mappingánh xạ các nhãn hợp lệ từ1đến150thành ID huấn luyện liên tục từ0đến149, đồng thời gán255cho các pixel bị bỏ qua để loại chúng khỏi loss và metric trong quá trình huấn luyện và validation.Không. Ảnh ADE20K được phát hành theo điều khoản giới hạn việc sử dụng cho nghiên cứu phi thương mại và giáo dục; phần mềm chú thích đi kèm được cấp phép riêng theo BSD-3. Hãy liên hệ MIT CSAIL để tìm hiểu các lựa chọn cấp phép thương mại.